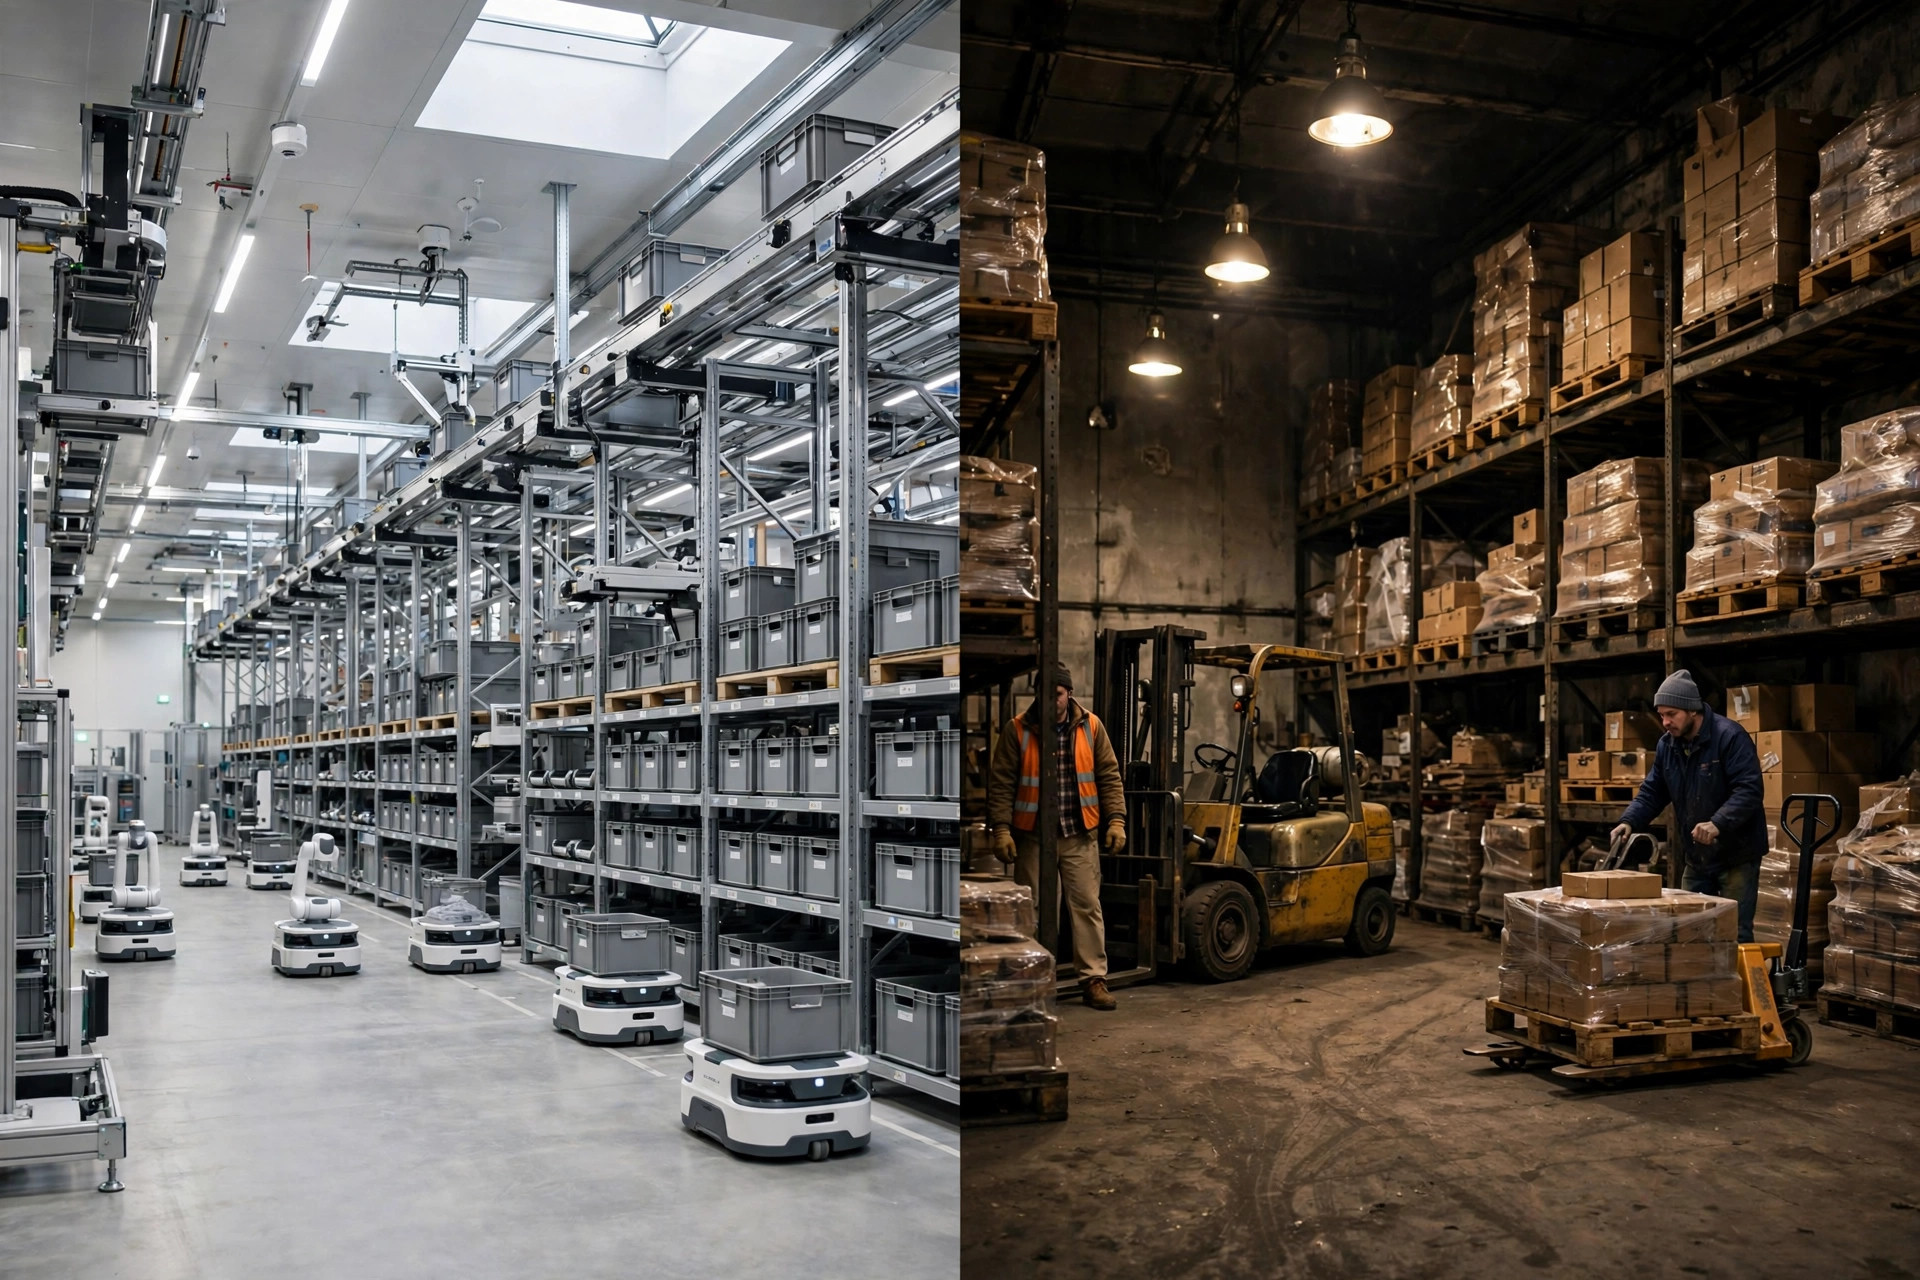
En los últimos dos años, en entrevistas con más de veinte empresas de almacenamiento y distribución minorista que han realizado pilotos de IA, he notado un patrón sorprendentemente consistente: el piloto casi siempre se ubica en la mejor instalación de la empresa — el centro de distribución insignia con la red más estable, los datos maestros de SKU más limpios, los procesos más estandarizados, la fuerza laboral más cooperativa y la gerencia más solidaria. La lógica parece impecable: poner el piloto donde el éxito es más probable, demostrar el concepto y luego replicarlo. Sin embargo, seis a doce meses después, cuando estas empresas despliegan la solución en su segundo y tercer sitio, aparece un fenómeno igualmente consistente: los impresionantes números del piloto se reducen drásticamente, y algunos proyectos se archivan discretamente durante el despliegue. El piloto "tuvo éxito", pero el despliegue fracasó. Esa paradoja merece un análisis más profundo.
Los números: una brecha entre pilotar y escalar
Según el informe del MIT Project NANDA "The GenAI Divide: State of AI in Business 2025", publicado en agosto de 2025, aproximadamente el 95% de los pilotos empresariales de IA generativa no produjeron ningún retorno medible en la cuenta de resultados; solo alrededor del 5% de las organizaciones capturaron valor real a escala. Merece una nota sobre la metodología: la cifra del 95% usa todas las organizaciones encuestadas como denominador, mientras que entre las organizaciones que realmente realizaron pilotos, aproximadamente una de cada cuatro llegó eventualmente a la escala de producción. De cualquier manera, la conclusión se mantiene — una amplia brecha separa pilotar de escalar, y la mayoría de las organizaciones nunca la cruza. Mi observación es que el primer paso de esa brecha a menudo se da en el momento en que se elige el sitio del piloto: la selección del sitio es en sí misma una forma de muestreo, y pilotar en tu mejor almacén es, en términos estadísticos, una muestra sesgada.
Por qué el mejor almacén es la peor muestra de piloto
Tres mecanismos explican la paradoja.
Primero, la confusión de dotación. Las ventajas inherentes del sitio insignia — datos limpios, procesos estandarizados, redes estables, un equipo cooperativo — hacen que cualquier solución parezca más efectiva de lo que es. Los estadísticos lo llaman sesgo de selección: crees que estás midiendo el efecto de la IA, pero en realidad estás midiendo el efecto combinado de "un gran almacén más IA", y atribuyendo todo a la IA. Una parte significativa del ROI del piloto la paga la dotación del almacén, no el algoritmo.
Segundo, la distorsión de recursos. Un periodo de piloto es inusualmente consentido: ingenieros del proveedor estacionados en el sitio, gerentes de proyecto de la sede haciendo seguimiento diario, las mejores personas del almacén reasignadas para apoyar las pruebas. Estos insumos ocultos nunca aparecen en el denominador de costos del piloto, pero son reales, e inflan genuinamente el rendimiento del piloto. Cuando los recursos se retiran durante el despliegue, el rendimiento retrocede — no porque la IA se rompió, sino porque las condiciones de invernadero desaparecieron.
Tercero, el sesgo de supervivencia en la narrativa. Los pilotos con números hermosos se convierten en casos de estudio contados una y otra vez; los pilotos mediocres se cierran discretamente y nunca se mencionan de nuevo. Las cifras de "ROI del piloto" que circulan en la industria provienen de una muestra filtrada que sistemáticamente exagera la realidad — y a su vez refuerza el instinto aparentemente obvio de pilotar en el mejor almacén.
Consideremos el primer caso. En la segunda mitad de 2024, un 3PL lanzó un piloto de auditoría basada en visión por IA en su almacén insignia cerca de Suzhou. Después de tres meses, la precisión de auditoría subió de 99.2% a 99.6%, las intercepciones de excepciones casi se duplicaron, y el equipo del proyecto estimó ahorros laborales anualizados de aproximadamente RMB 400,000. El piloto fue calificado como un "éxito por encima de las expectativas". A principios de 2025, el mismo equipo y la misma versión del algoritmo se desplegaron en almacenes regionales en Wuxi y Hefei — la precisión mejoró en menos de 0.1 puntos porcentuales, esencialmente ruido. El análisis post mortem encontró la diferencia clave: las estaciones de auditoría del insignia habían sido renovadas en 2023, con iluminación uniforme y palets y contenedores totalmente estandarizados, mientras que los sitios regionales tenían iluminación envejecida y una mezcla desordenada de tamaños de cajas. Lo que el modelo de visión había "aprendido" durante el piloto era la firma visual de un entorno estandarizado. En otras palabras, el piloto no midió la capacidad del algoritmo para generalizar, sino la amabilidad del entorno del piloto.
El segundo caso proviene del primer trimestre de 2025, cuando una cadena minorista estadounidense pilotó IA de pronóstico de demanda en su centro de distribución insignia cerca de Dallas, que sirve a unas 120 tiendas, con una integridad de datos maestros de SKU del 98%. Seis meses después, el error de pronóstico (MAPE) había caído en unos 4 puntos porcentuales y las tasas de faltantes en 1.2 puntos; el veredicto fue "éxito, se recomienda el despliegue". Replicado en dos centros de distribución del Medio Oeste — donde la integridad de datos maestros apenas superaba el 80% y los registros de promociones eran irregulares — el modelo entregó solo alrededor del 30% de las ganancias del piloto. El equipo entonces repitió el piloto en un almacén deliberadamente "promedio": brechas de datos, excepciones de proceso, cooperación tibia. Los números fueron menos favorecedores que los del primer piloto, pero la lista de verificación de gobernanza de datos y el manual de despliegue construidos a partir de ese segundo piloto aterrizaron con éxito en los cuatro almacenes siguientes al primer intento. El líder del proyecto lo dijo claramente: el primer piloto demostró que la IA podía funcionar en condiciones ideales; el segundo demostró que podía funcionar en nuestras condiciones reales. La gerencia solo necesitaba la segunda prueba.
Aquí está la incómoda inferencia: un piloto cuyo ROI supera las expectativas merece un escrutinio extra, no celebración, porque el desempeño superior puede deberse menos a la IA y más a que el sitio del piloto era inusualmente bueno. Un piloto realizado en un almacén por debajo del promedio, con números entre un 20-30% más feos, mide el piso de la solución; un piloto realizado en el insignia solo mide su techo. Lo que la gerencia realmente quiere nunca fue el "éxito del piloto" sino el "éxito del despliegue" — y la lógica de selección de sitio para esos dos objetivos apunta en direcciones opuestas: la primera busca seguridad, la segunda busca verdad.
Tres líneas para la selección del sitio del piloto
| Tipo de sitio | Perfil típico | Estrategia de piloto |
|---|---|---|
| Insignia (mejores condiciones) | Datos limpios, procesos estandarizados, sesgo de recursos | Validar solo la viabilidad técnica; no hacer compromisos de ROI; etiquetar las conclusiones como "referencia de techo" |
| Sitio representativo de nivel medio (recomendado) | Escala, mezcla de SKU y fuerza laboral cerca del promedio de la empresa | El escenario principal para medir el ROI; las conclusiones pueden apoyar directamente las decisiones de despliegue |
| Sitio arquetípico problemático | Un punto de dolor real representativo, p. ej., altos errores de auditoría o faltantes crónicos | Valida si la solución corrige problemas reales; la atribución más limpia de causa y efecto |
| Evitar: sitios nuevos, en reubicación o estresados por pico | Líneas base inestables, demasiadas variables | No aptos para pilotos; los resultados no pueden atribuirse |
Vale la pena agregar un elemento más: un control. Si es posible, designa un "control sombra" — un sitio comparable en la misma región que no recibe la IA pero registra datos de línea base durante el mismo periodo — o ejecuta comparaciones por categoría o por tiempo dentro del mismo almacén. Un ROI de piloto sin grupo de control es, en sentido estricto, un número no falsable; su poder de persuasión existe solo dentro de la presentación de diapositivas.
Un cambio ya en marcha
A medida que el gasto empresarial en IA pasa de la fase de experimentación a la fase de escala, la metodología de pilotos está cambiando. La lógica inicial era "hacerlo funcionar primero", con la selección del sitio optimizada para la seguridad y la velocidad. La lógica emergente es "hacerlo replicable primero", con la selección del sitio optimizada para la verdad y la representatividad. Mi expectativa: para alrededor de 2027, la evaluación de la representatividad del sitio del piloto se convertirá en un paso estándar en la gobernanza empresarial de la IA — no porque la industria de repente se volvió rigurosa, sino porque suficientes empresas ya han pagado la matrícula. Quien corrija primero la selección del sitio pagará la matrícula más baja en la fase de despliegue.
Finalmente, una pregunta para llevar contigo. Si una solución de IA solo produce números hermosos en tu mejor almacén y falla en todos los demás, ¿deberíamos preguntar "¿funciona la IA?" — o "¿son nuestros almacenes dignos de esta IA?" Y más aún: cuando la elección del sitio del piloto puede determinar en gran medida el resultado del piloto, ¿cuántas de las celebradas "historias de éxito de IA" de la industria en los últimos dos años midieron la tecnología, y cuántas simplemente midieron el buen gusto en la selección del sitio? No hay una respuesta estándar. Pero toda empresa a punto de lanzar un piloto haría bien en hacerse esa pregunta una vez — antes de firmar.
Por Dr. Chen, Investigador de la Cadena de Suministro
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.