点击标签,查看该标签下的文章、视频和新闻
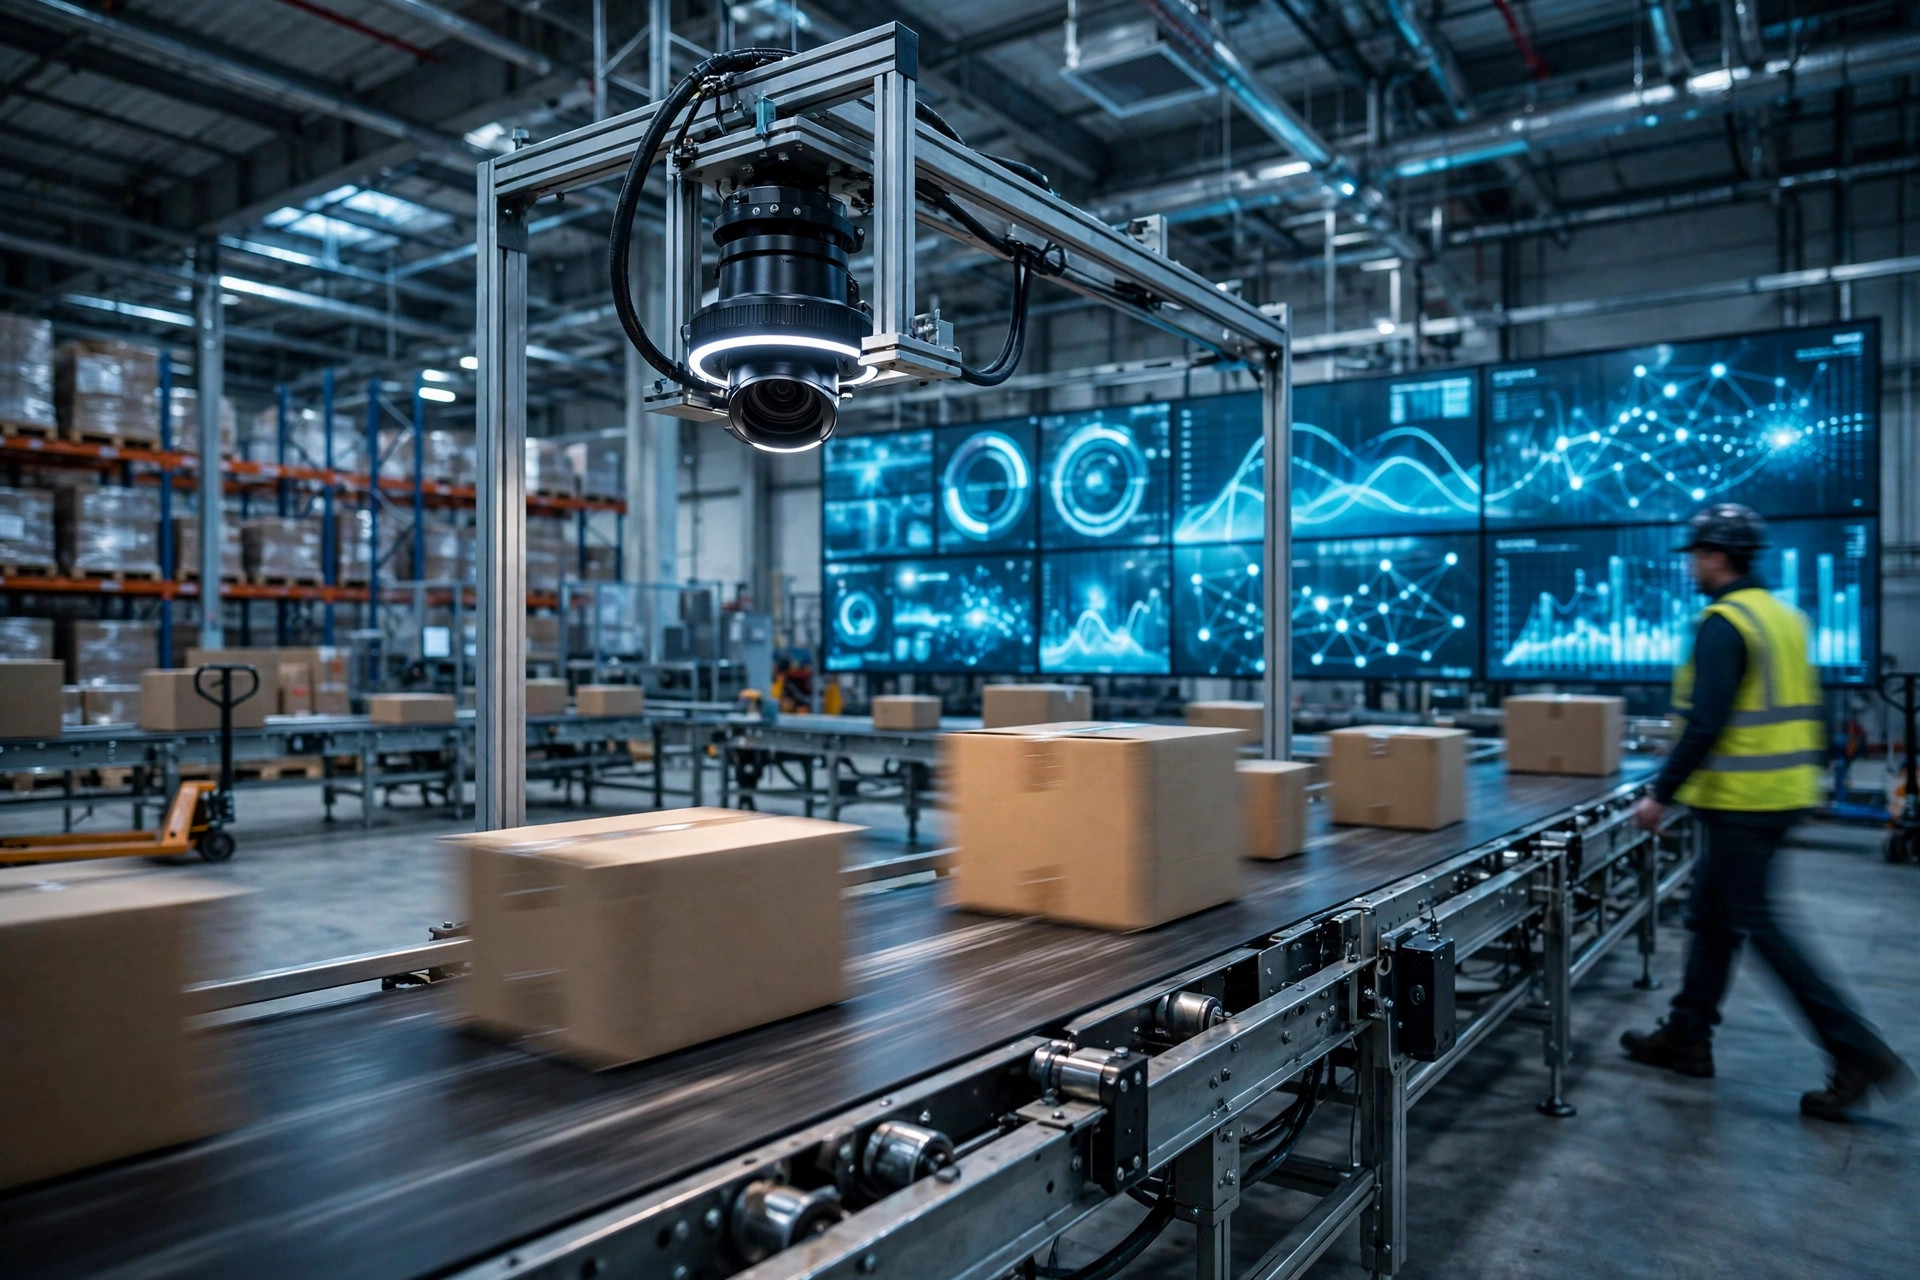
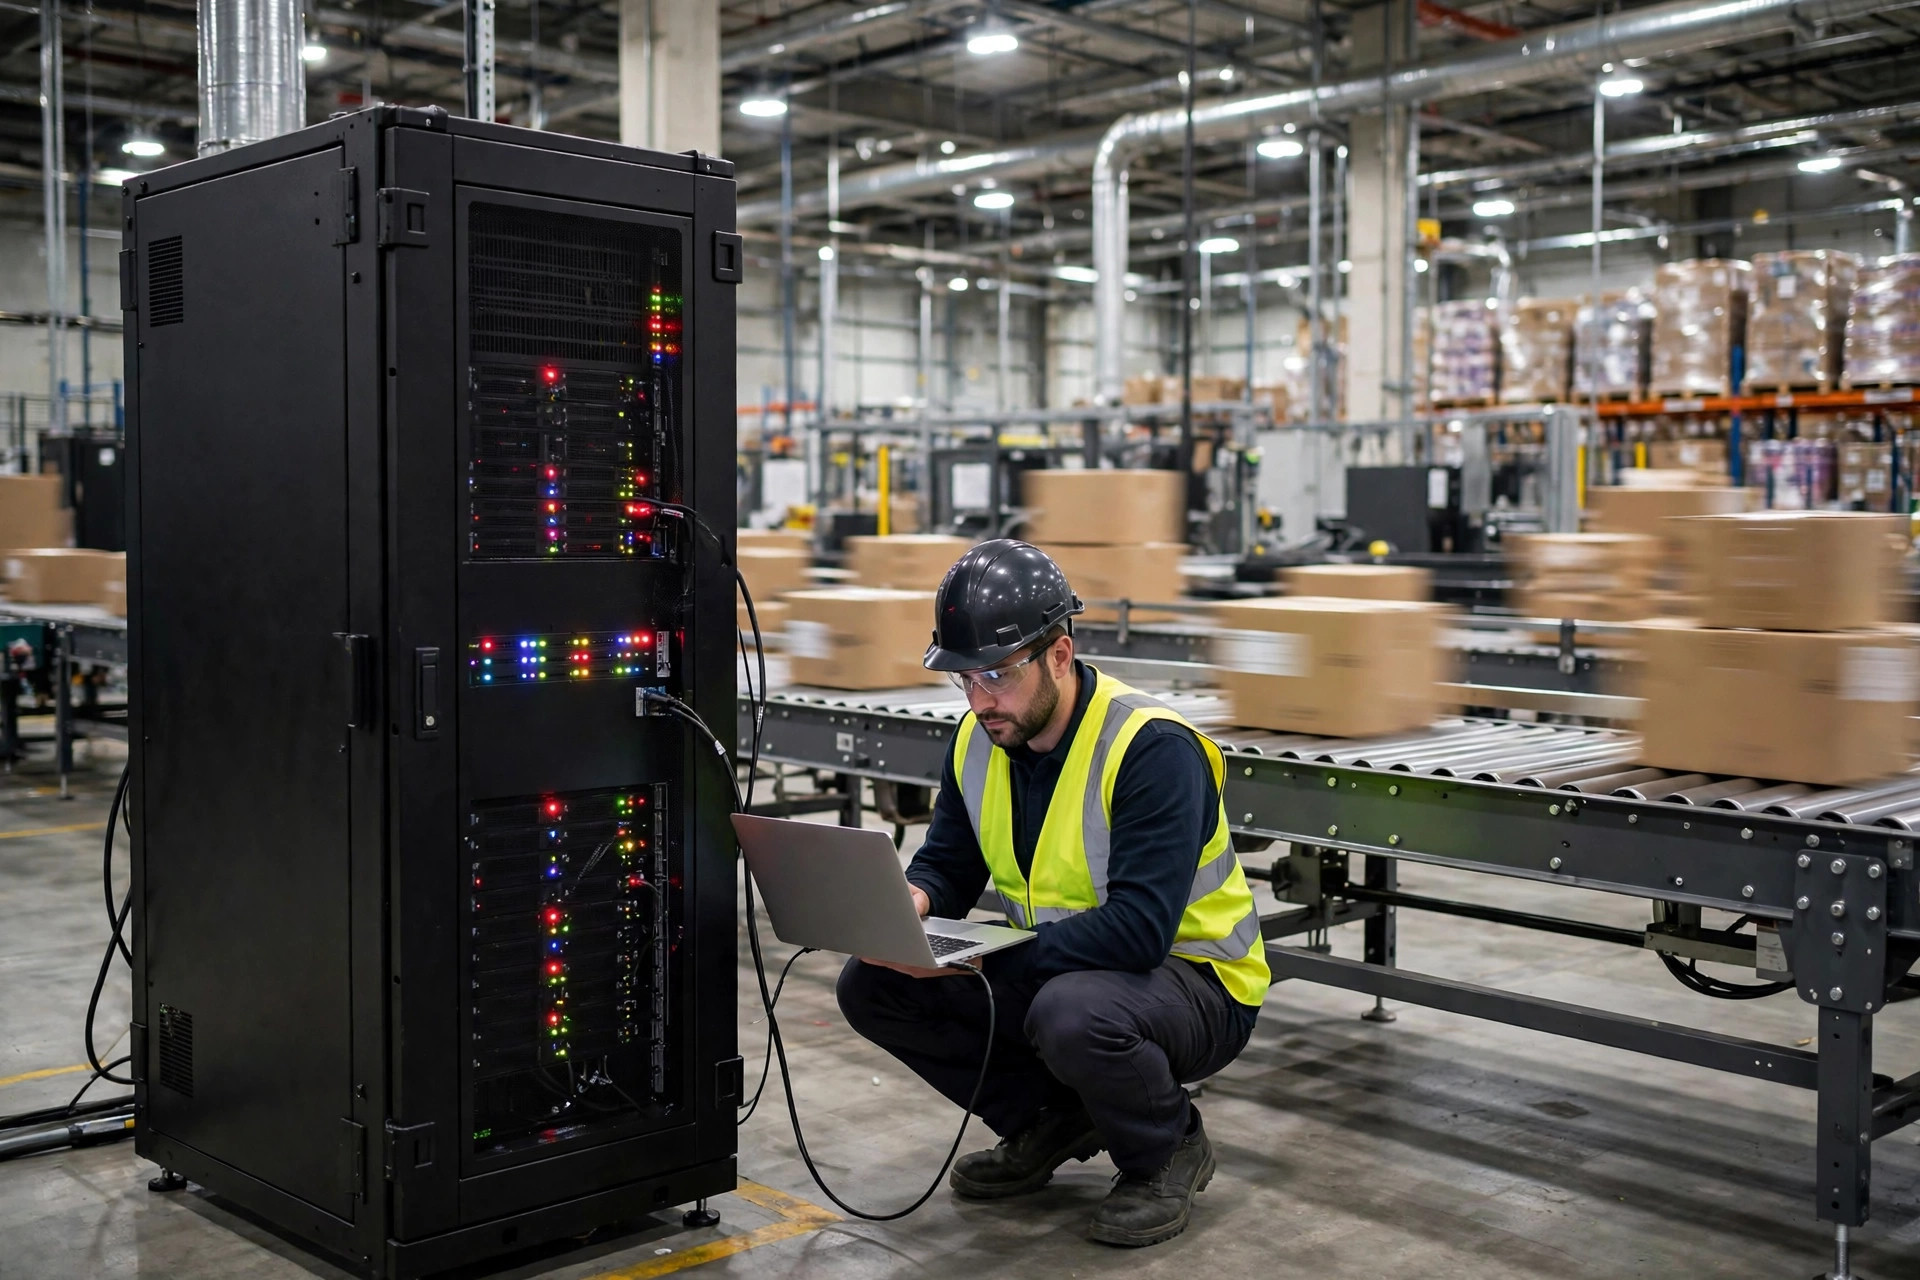
仓库里的 AI 推理放边缘还是放云端,没有标准答案。视觉检测要毫秒级响应,AMR 调度要全局视野,预测类任务对实时性要求最低——三类任务的取舍逻辑完全不同。本文按延迟、断网、成本、数据安全四个维度给出分流框架,并说明混合部署的落地路径。
分拣线 1.2 米/秒、死线 250 毫秒,云端 400 毫秒开外赶不上趟——大刘算清延迟、断网、流量三笔账,告诉你 AI 推理到底该放哪。
新文章发布时,第一时间发到你的邮箱。