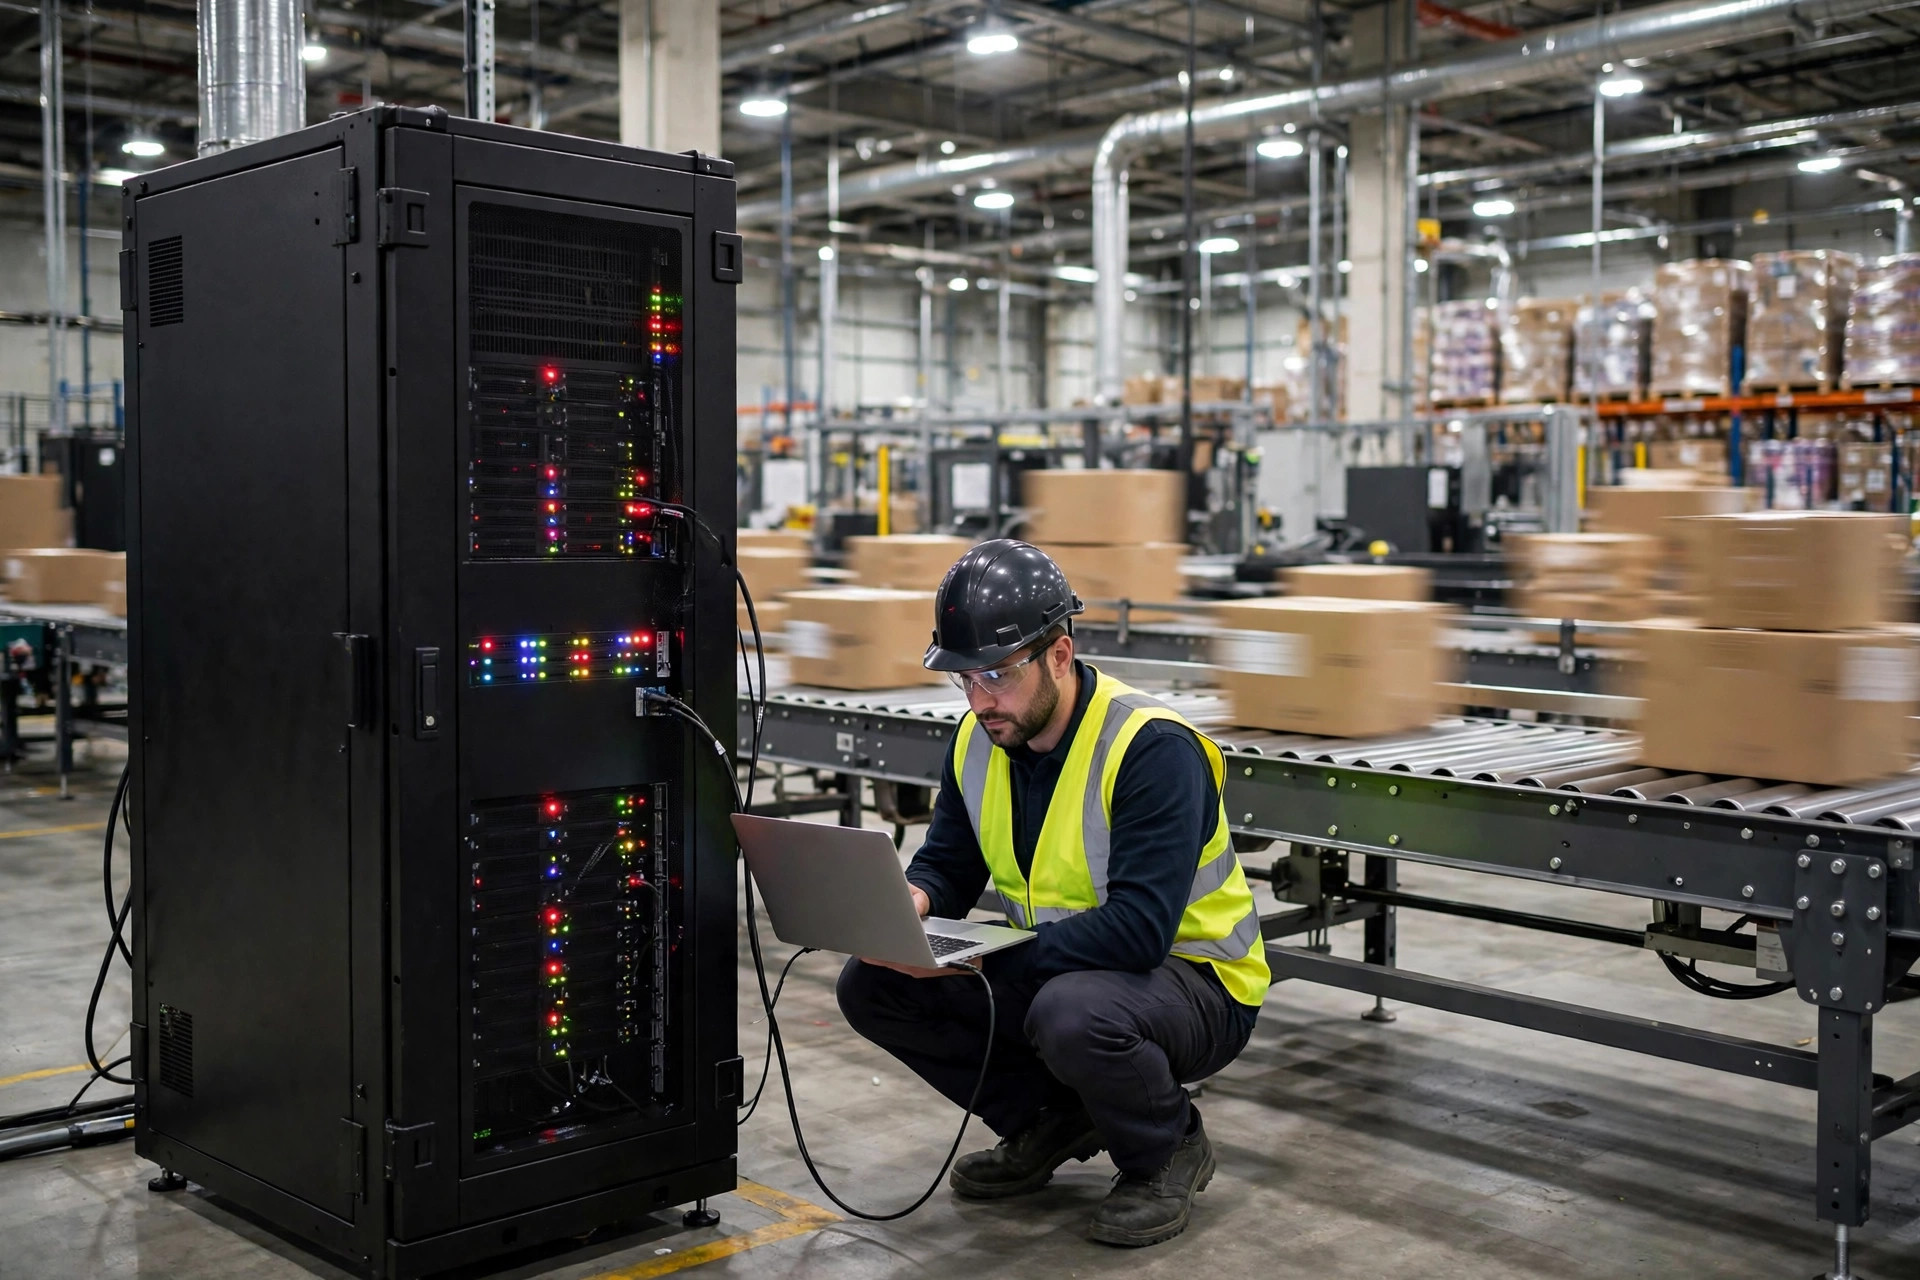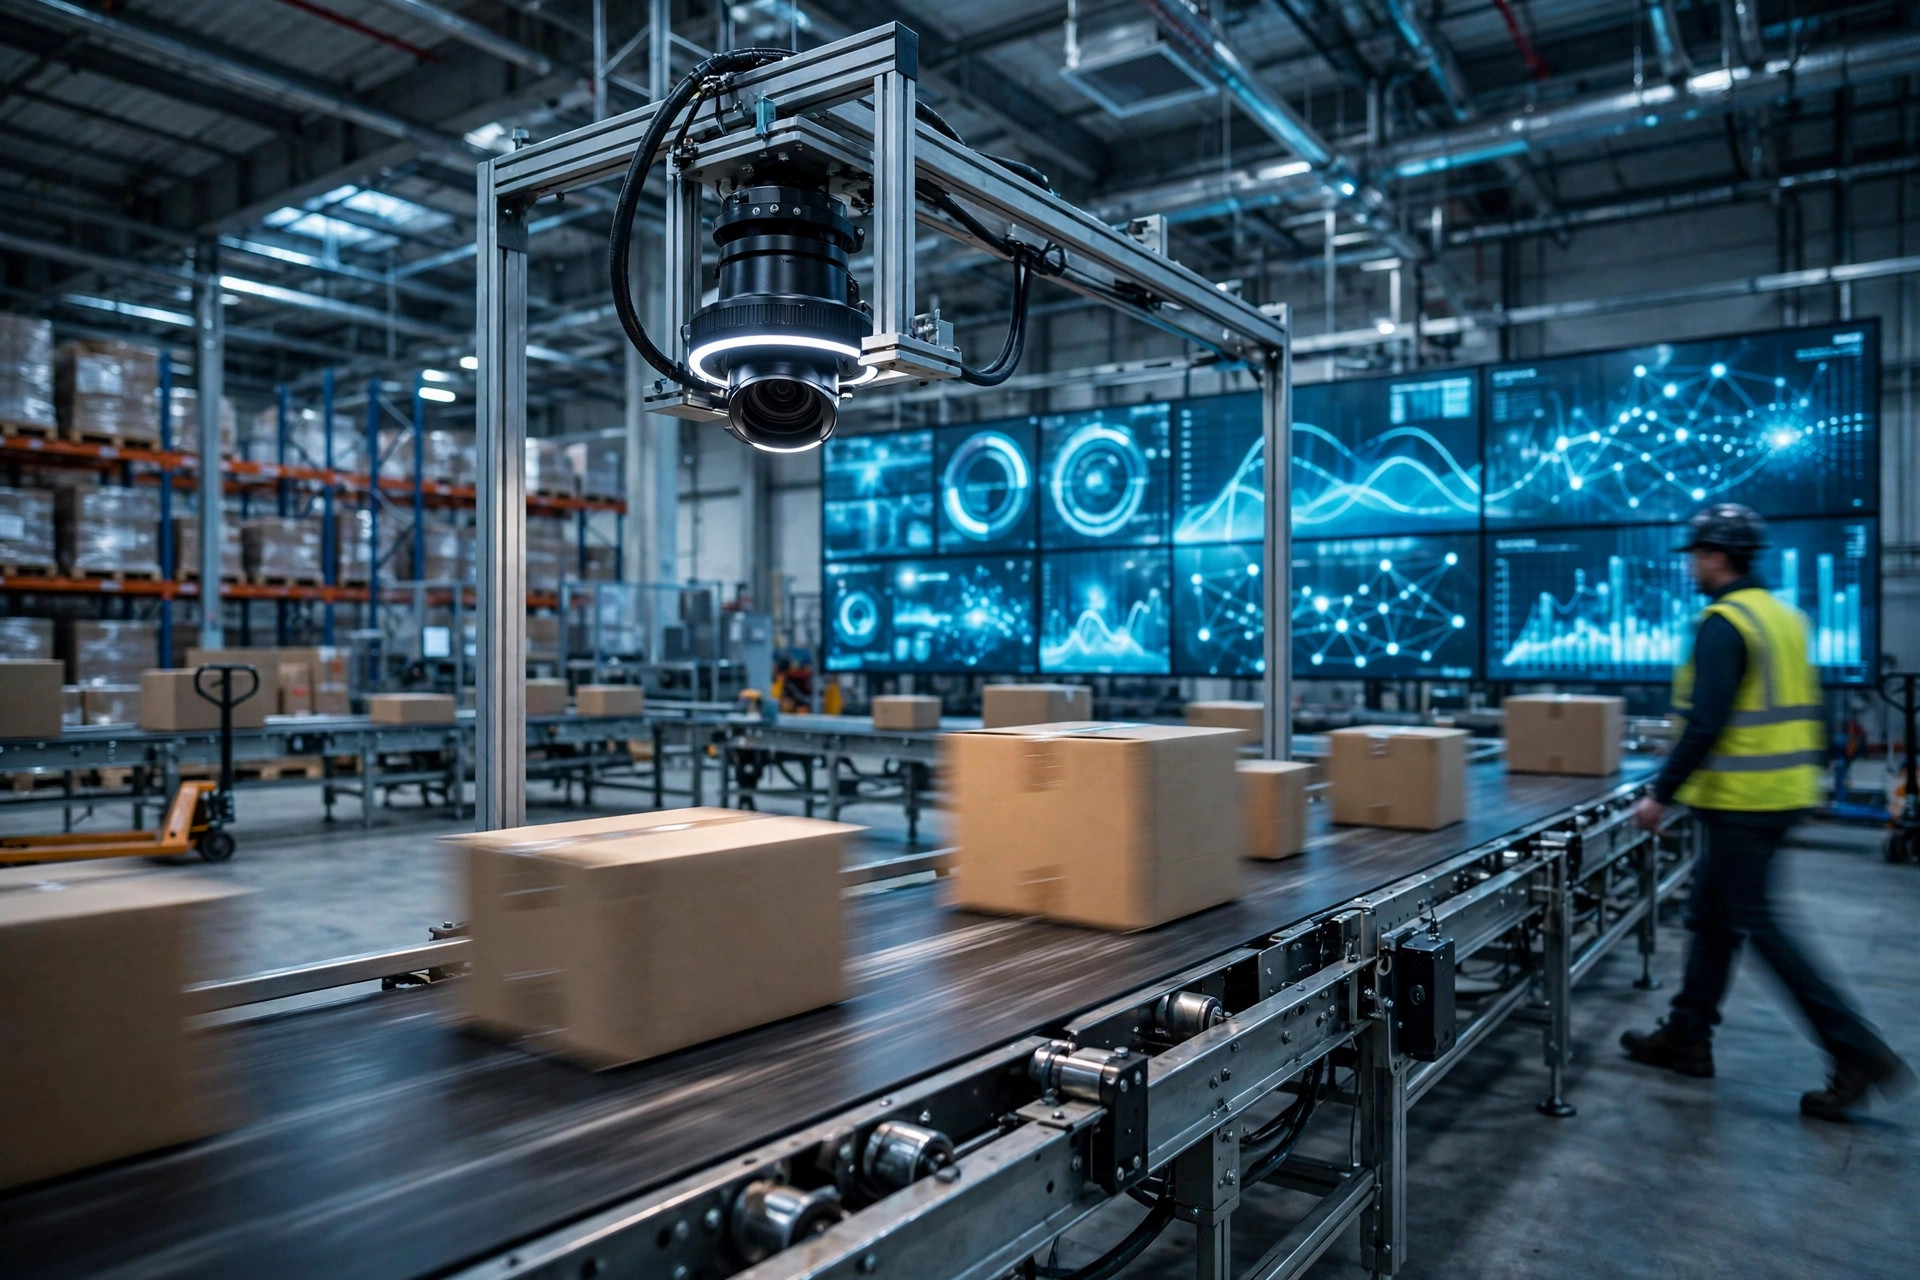
过去两年,仓库自动化厂商的宣传材料里出现了一个耐人寻味的现象:同一家厂商,既在讲"端侧 AI 实时响应",又在讲"云端大模型统一调度",而客户真正关心的问题——AI 推理放边缘还是放云端——反而很少被正面回答。根据公开的行业观察,边缘与云端之争在仓储场景里并不是一场非此即彼的技术路线之争,而是一道按任务分流的工程选择题:不同的任务对延迟、可靠性、成本和数据安全的敏感度完全不同,用同一种部署方式覆盖全部任务,本身就是取舍框架缺失的表现。
现象:三种任务,三种时间尺度
仓库里的 AI 推理任务,大致可以按时间敏感度分成三类,而时间敏感度恰恰是部署位置的第一决定因素。
第一类是视觉检测:传送带上的条码识别、破损包裹检测、体积测量、分拣口的异常拦截。这类任务的共同点是与物理动作直接耦合——相机拍到包裹的下一秒,机械臂或分流器就要动作。一旦推理延迟超过机械节拍,整条线就要降速或者停线。换句话说,视觉检测的延迟预算通常以几十毫秒计,任何跨广域网的往返都是不可接受的。
第二类是 AMR 与设备调度:路径规划、任务分配、交通管制。这类任务需要的是全局视野——几十台甚至上百台设备的实时位置、任务队列、拥堵状态——而不是单点的毫秒响应。调度决策的周期通常以秒计,这就给部署位置留出了选择空间:既可以在本地服务器上跑,也可以在云端跑,关键看系统规模和断网容忍度。
第三类是预测类任务:需求预测、补货建议、人力排班、设备故障预警。这类任务跑的是历史数据和批量数据,输出结果的有效期以小时甚至天计,对实时性几乎没有要求,但对算力和数据广度要求最高。
这三类任务的时间尺度差了好几个数量级,把它们塞进同一种部署架构,必然会在某一类任务上付出不必要的代价。
四维对比:边缘与云端在延迟、断网、成本、数据安全上的差别
在延迟维度上,边缘的优势是物理性的:数据不出仓库,推理往返可以控制在毫秒级;云端的往返则取决于网络质量,通常在几十到几百毫秒之间波动,而且存在长尾抖动。对于视觉检测这类与机械节拍耦合的任务,这个差距是决定性的;对于预测类任务,这个差距则完全不重要。
断网维度往往被低估。一个仓库的网络中断可能是光纤被施工挖断,也可能是园区网络设备故障,持续时间从几分钟到几小时不等。如果视觉检测和设备调度完全依赖云端,断网就等于停线;如果推理在本地,断网期间核心作业可以继续,只是预测类任务和报表同步会暂停。评估断网容忍度时要问一个具体问题:断网一小时,这个仓库还能出多少单?答案直接决定了哪些任务必须留在本地。
成本维度需要算总账,而不只是算力单价。云端按量付费看起来灵活,但视觉检测这种 7×24 小时连续推理的任务,长期跑下来云端推理费用加数据传输费用,往往高于一次性投入的边缘设备折旧;反过来,预测类任务是间歇性、批量性的,用云端弹性算力反而更划算,因为不需要为峰值常备硬件。反常识的一点是:很多人以为"上云就是省钱",但在连续推理场景里,云端的账单恰恰是最容易失控的一项——不是因为单价贵,而是因为用量永不停歇。
数据安全维度则取决于数据本身的性质。包裹外观图像、库内作业视频这类数据,通常不涉及商业机密,出仓传输的风险相对可控;而客户订单数据、货主库存结构、带有人员面部信息的监控画面,跨出内网就需要更严格的合规评估。欧洲和部分行业的客户对数据出境有明确限制,这类场景下边缘部署不是性能选择,而是合规前提。
| 维度 | 边缘部署 | 云端部署 |
|---|---|---|
| 延迟 | 毫秒级,稳定 | 几十到几百毫秒,有抖动 |
| 断网容忍 | 核心作业可继续 | 依赖网络,断网即停摆 |
| 成本结构 | 前期硬件投入 + 低边际成本 | 零硬件投入 + 持续用量费用 |
| 数据安全 | 数据不出内网,合规友好 | 需评估传输与存储合规 |
| 适用任务 | 视觉检测、实时控制 | 预测分析、跨仓协同 |
案例:同一座仓里的两种选择
可以设想两个真实感很强的场景。第一个是华东某 3PL 仓的分拣线改造:传送带速度下,视觉检测必须在包裹到达分流口之前完成判断,任何一次云端抖动都会导致错分。项目方最终把检测模型部署在产线旁的边缘服务器上,云端只负责模型更新和效果统计。这个选择的逻辑很简单:检测任务的时间预算不允许跨网。
第二个是某连锁零售企业的补货预测:数据来自几十个仓,模型每周重训一次,输出未来两周的补货建议。这类任务放在云端是自然的——数据本来就分散在各处,算力需求集中在训练窗口,平时几乎不消耗资源。如果为了"统一架构"硬把预测也搬到每个仓的边缘服务器上,每个仓都要为一周用一次的算力买单,显然不划算。
两个案例放在一起,结论是清晰的:部署位置应该跟着任务走,而不是跟着厂商的宣传口径走。
混合部署:边缘与云端分层的落地路径
对大多数仓库而言,现实的答案是混合部署,而混合部署的关键在于分层清晰,而不是简单地"两边都放一点"。
一个可行的分层是:边缘层跑实时推理——视觉检测、设备急停判断、单机控制;本地或区域层跑调度——AMR 任务分配、交通管制、波次优化,部署在仓内服务器或园区机房,兼顾全局视野与断网容忍;云端跑预测与协同——需求预测、跨仓调拨建议、模型训练与版本管理。
落地时有三个次序建议。第一,先把实时任务钉在边缘,保住作业连续性,这是不可妥协的底线。第二,调度层先本地后上云,等规模上来、跨仓协同需求真实出现时再迁移,不要为想象中的规模提前支付云端改造成本。第三,模型管理统一走云端:训练、版本、灰度发布由云端管,边缘只负责拉取和运行,这样既能享受云端的迭代效率,又不让推理链路依赖网络。
需要提醒的一个边界是:边缘部署并不等于"买一台服务器就完了"。模型更新机制、边缘设备的远程运维、断网期间的数据回补,都是经常被低估的工作量。如果团队没有能力维护边缘设备群,强行边缘化反而会引入新的故障点——这时候,退一步用"本地服务器 + 云端兜底"的折中方案,比纯边缘更稳妥。
归根结底,边缘与云端的取舍不是技术信仰问题,而是一道成本与风险的算术题:先按任务分流,再按四个维度打分,最后看团队的运维能力能不能兜住选定的架构。未来几年,随着边缘芯片算力继续提升和云端推理成本继续下降,这条分界线还会移动,但"按任务分流"这个框架本身,大概率会比任何具体的部署建议活得更久。
仓库的 AI 部署会不会最终走向"边缘默认、云端例外",还是反过来?这取决于下一个周期里,是实时性任务增长得更快,还是跨仓协同的需求先到来——而这个问题的答案,恐怕要到下一轮大规模改造潮之后才能看清。
作者:陈博士|供应链行业研究员