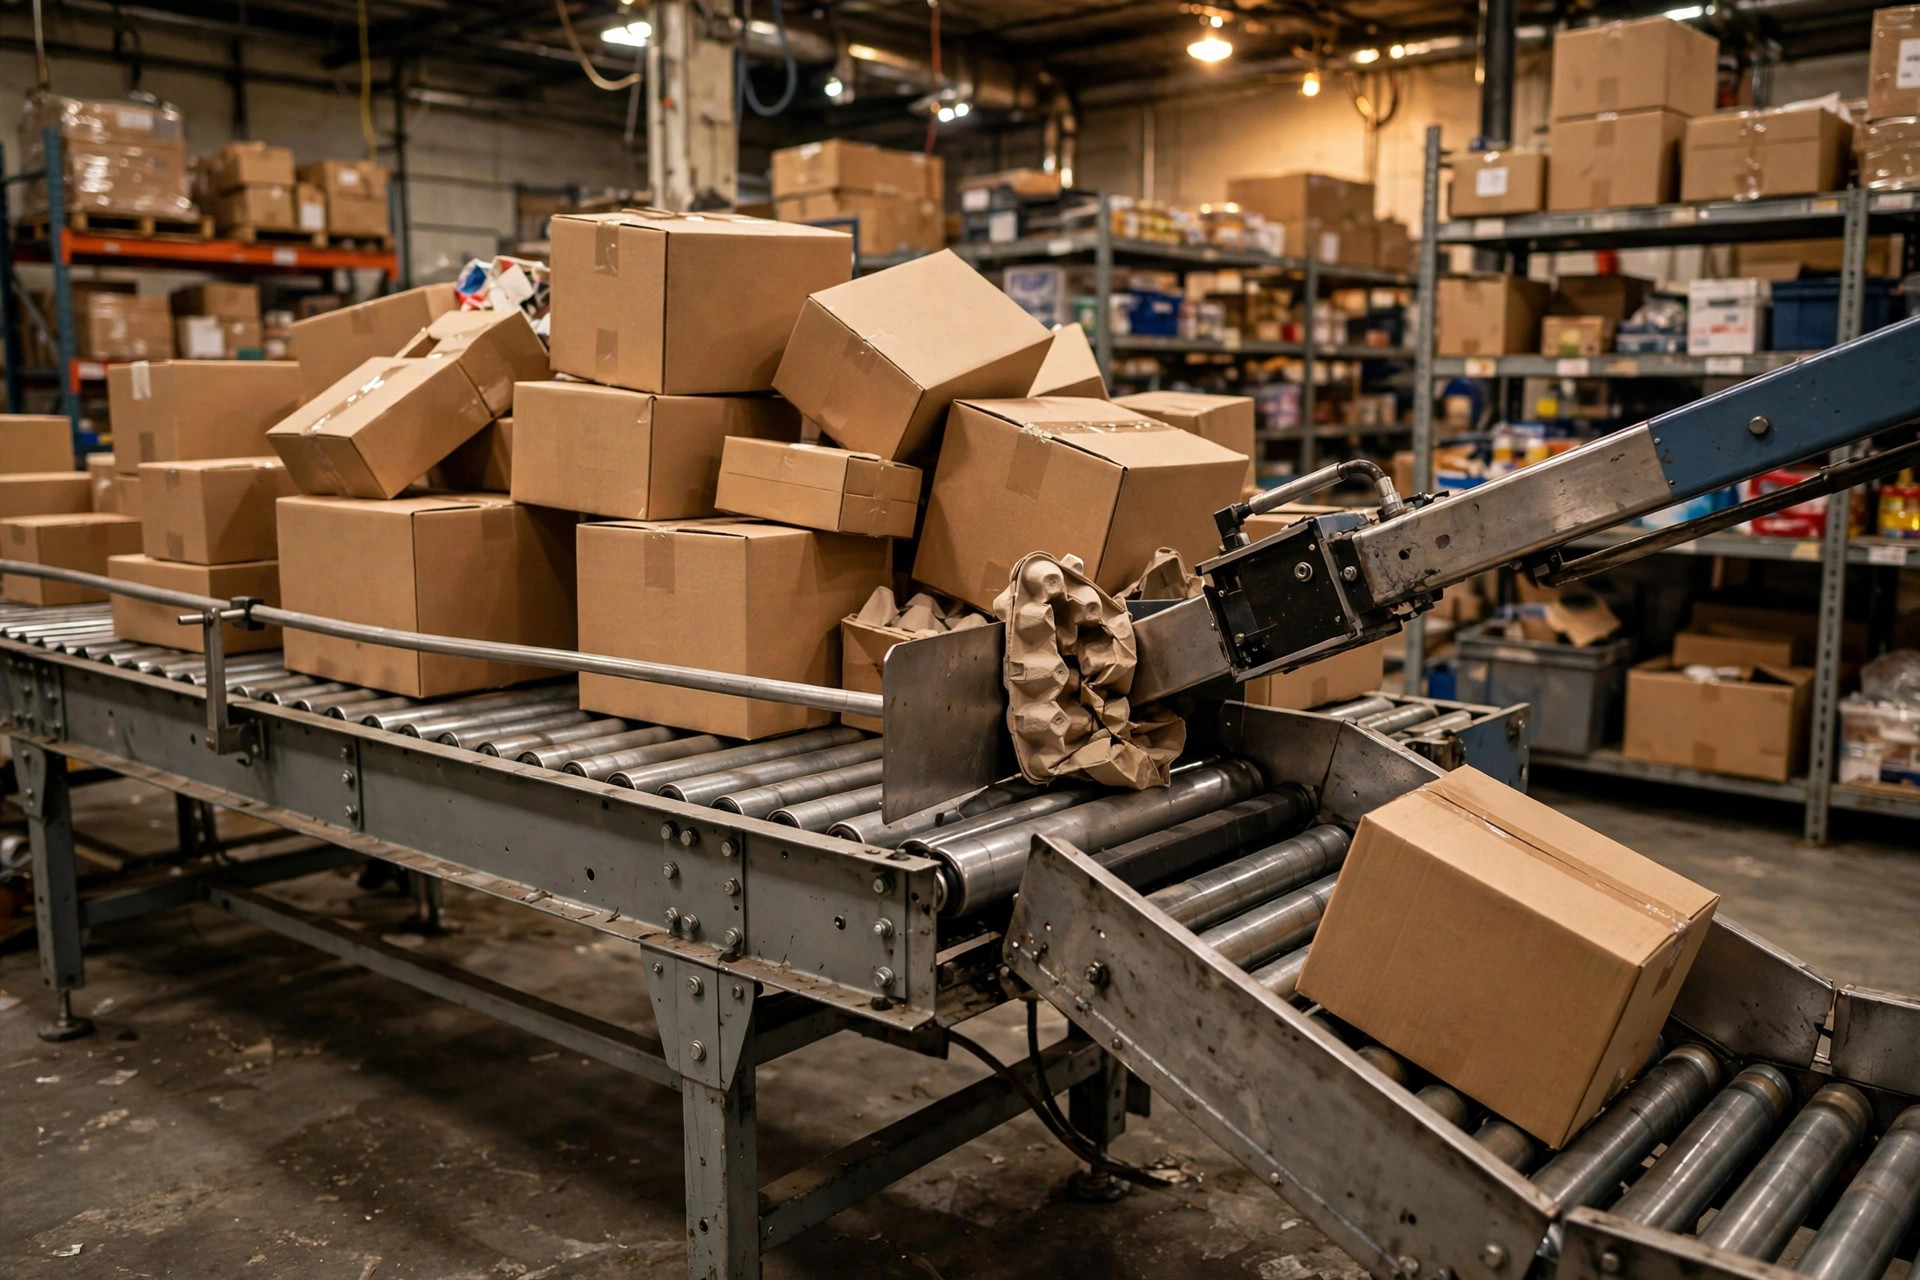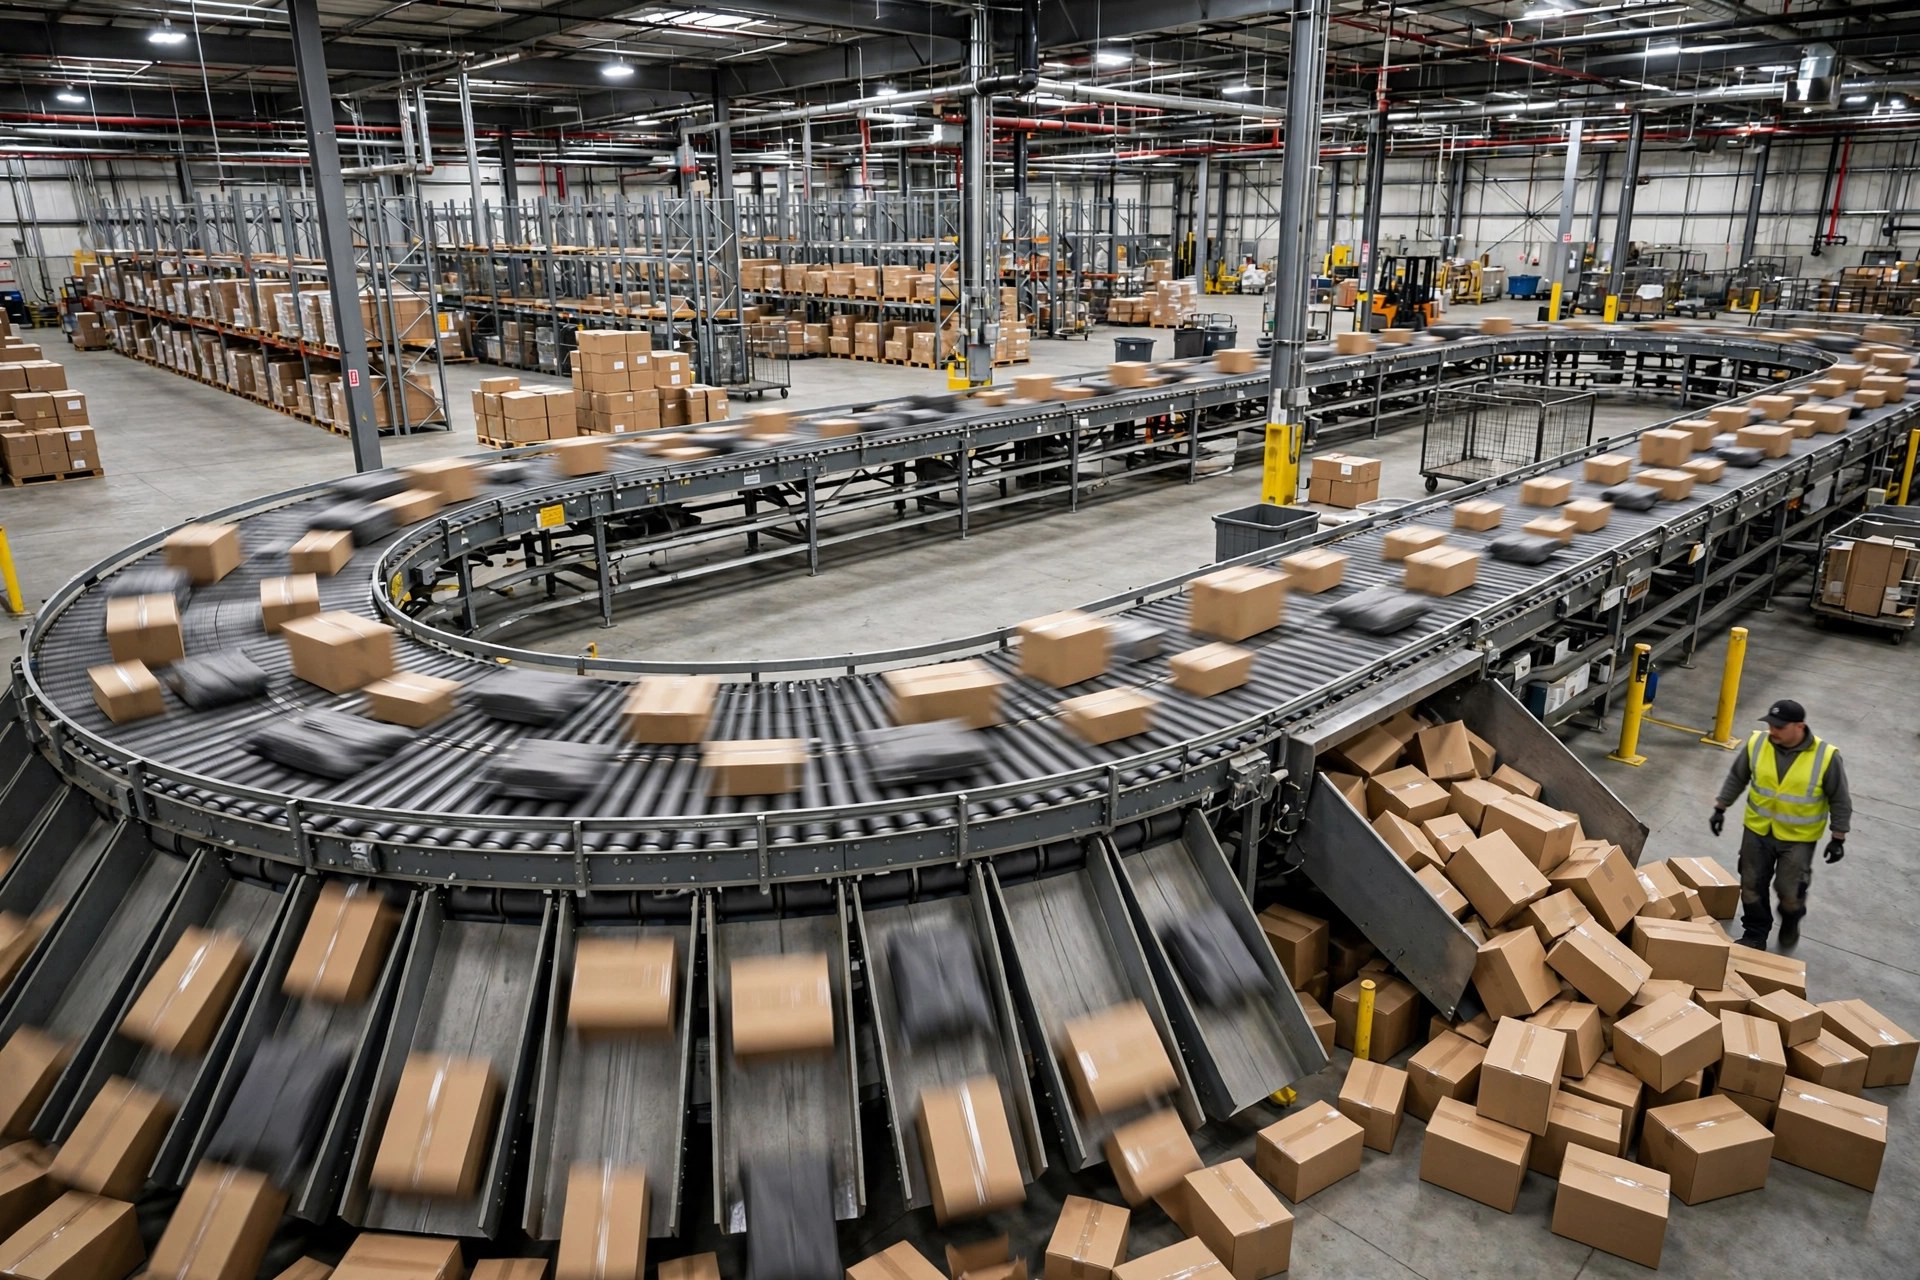
2023 年感恩节后的那个周二凌晨,我在一家 Ontario 的 3PL 仓里亲眼看了一场"分拣机罢工"。12 万平方英尺的仓,交叉带分拣机正以接近满速跑黑五的尾单。凌晨两点多,3 号格口满了,光电开关早就报警,但当班主管以为"等这拨货过去再清"。结果 WCS 继续往 3 号格口分流,包裹从格口滑道上滚下来堆在地上,堆到扫码龙门的感应区。连锁反应来了:扫码被遮挡导致读码失败,读码失败的件被打进异常格口,异常格口也满了,最后整条分拣线回流,托盘在环线上空转了四十多分钟,当晚的 UPS 截单直接错过。
事后复盘,问题不在设备,在 WCS 的异常路由压根没配对。格口满、读码失败、超规件——这三件事在任何分拣系统里每天都会发生,属于"正常异常"。配不好,一台几十万美金的设备就被几个配置项卡死。这篇把我踩过的坑和最后落定的配置逻辑讲清楚。
格口满的时候,WCS 到底听谁的
很多人的误区是:格口满 = 设备问题,派个人去清就行。但格口满本质上是 WCS 的路由决策问题——光电开关告诉系统"满了",系统必须在 1 个循环周期内做出三件事:停分(不再往这个格口分流)、改道(把原定去这个格口的件指到备用格口)、报警(告诉现场有人来清)。
实战里最常见的配错,是"停分"和"改道"之间有个时间差。有的系统格口满信号触发后,WCS 要等下一个波次才更新路由表,中间这 30~60 秒,设备照旧往满格口里塞。我见过最惨的一家,格口满信号接的是格口底部的堆高光电,而不是格口入口的光电——等底部光电被触发,格口里已经堵到滑道上了。
我最后定下来的配置原则是三条。第一,格口满检测用入口光电加占用率算法:当格口内件数达到设计容量的 85%,WCS 发预警并开始把新件改道到备用格口;到 100% 直接停分。第二,每个格口必须在 WCS 里配一个"溢出伙伴",可以是邻格口,也可以是集中式的异常格口,路由表里写死,现场不需要临时决定。第三,格口清空后,WCS 要自动恢复路由,不要靠人工点按钮——凌晨三点的人工操作,十次有九次会忘。
顺带提一个反例。2021 年我看过一个服装仓,他们的 WCS 格口满逻辑配的是"满了就停线等人工清"。听起来稳妥对吧?结果旺季一个格口平均 40 分钟满一次,一天下来分拣机启停了二十多次,电机和刹车片的损耗先不说,整条线的有效产能掉了将近三成。后来改成"满了自动改道",产能当天就回来了。停线是最贵的异常处理方式,不到万不得已不要用。
条码读不出来,最要命的是犹豫
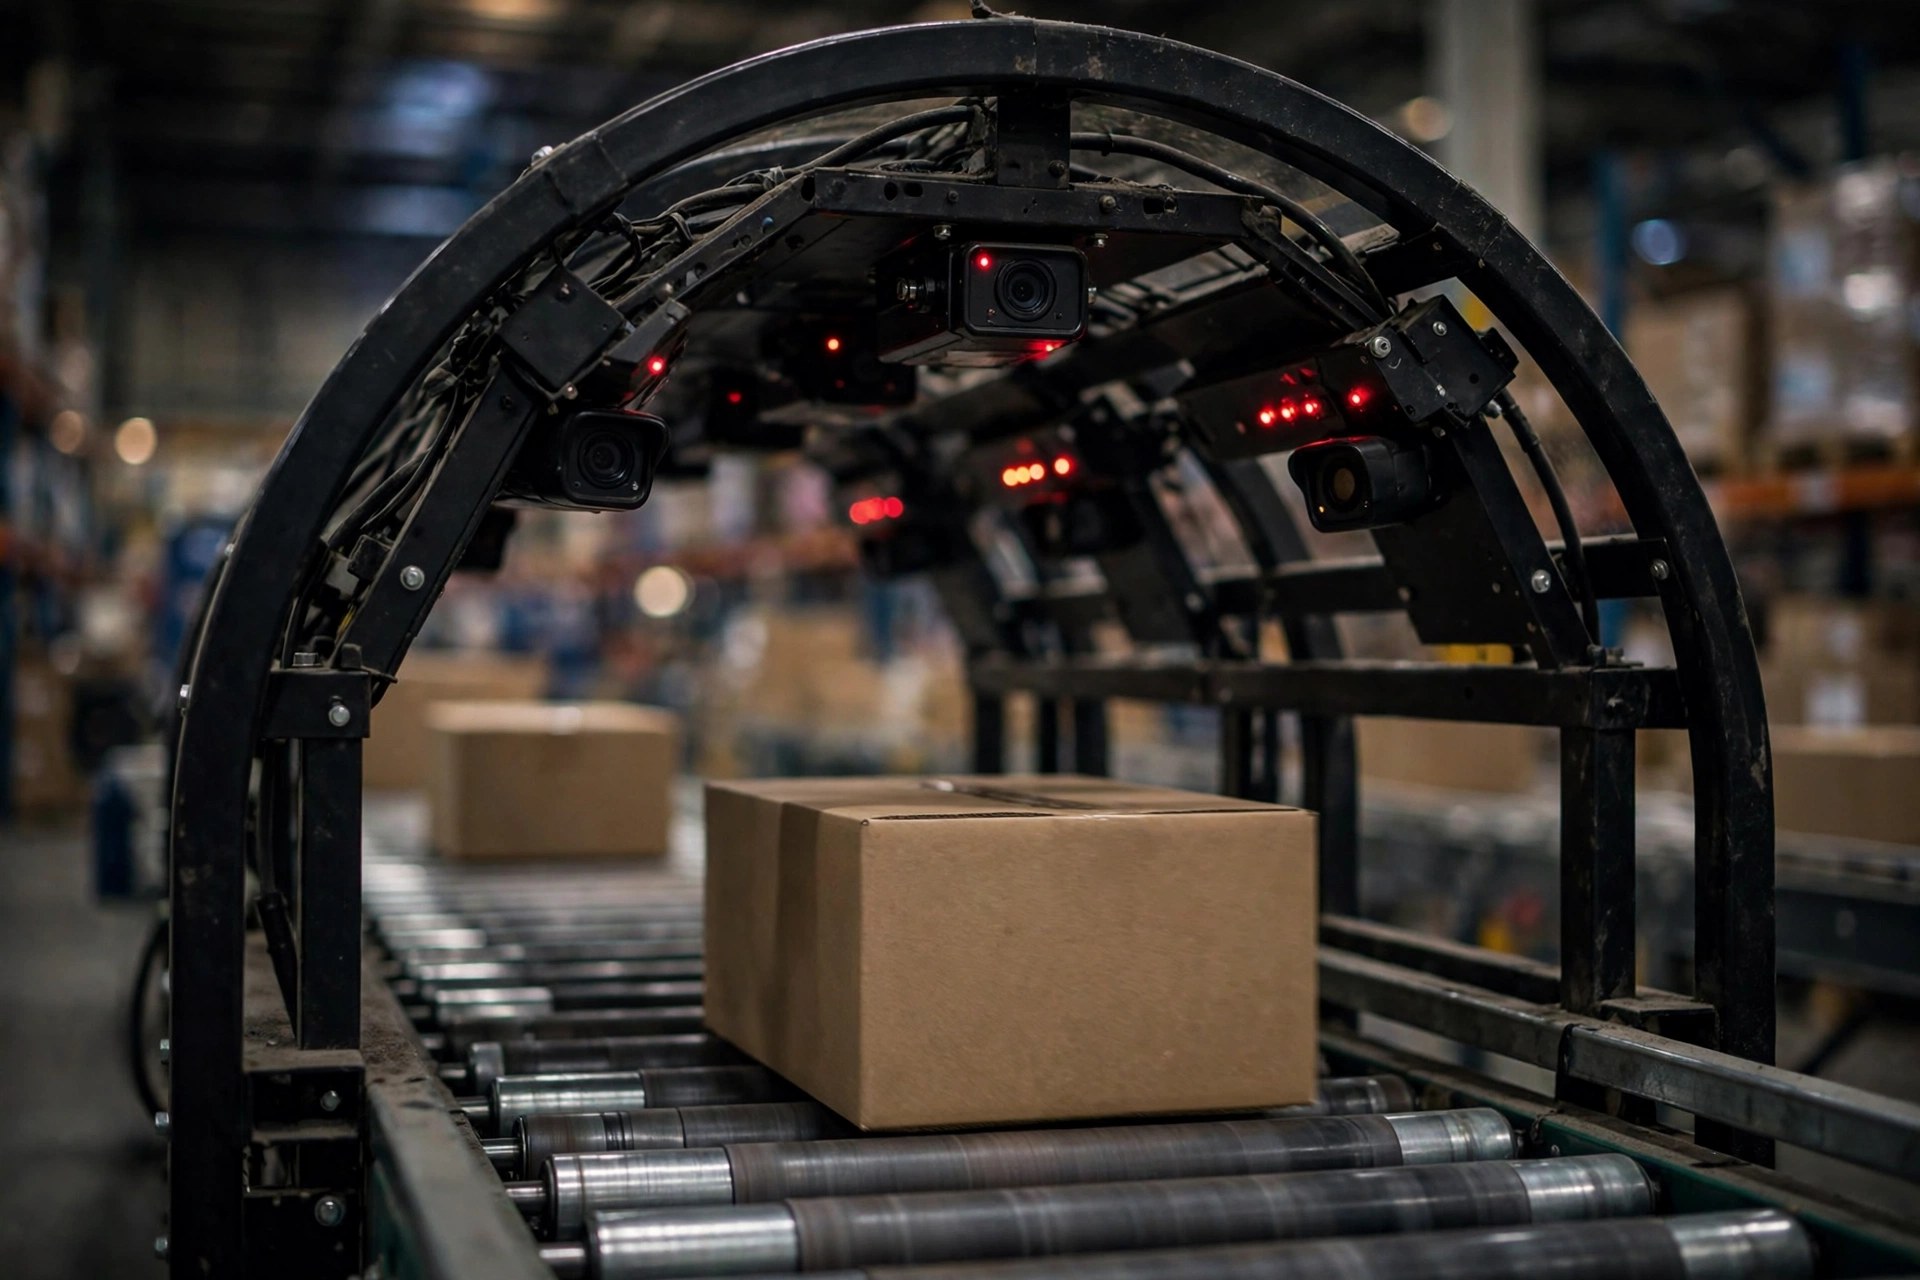
扫码隧道的读码失败率,厂商手册里都写得很漂亮:99.9%。实际现场,标签褶皱、面单被胶带盖住一半、箱子侧翻,读码失败是家常便饭。关键不在失败率,在 WCS 对失败件的处置策略。
我见过三种配法。第一种:读码失败就停线报警,等人工处理。这是最要命的——高峰期每小时上万件的线,停一次线重启加上游积压,损失按分钟算。第二种:读码失败的件直接打进异常格口,人工补录后重新上线的。这是我现在主推的:WCS 给每个失败件分配一个异常 ID,人工在异常格口的工作站上扫件、手动输入或重打面单,系统把补录结果和异常 ID 绑定,件重新上机,正常分流。第三种是读码失败件在环线上多转几圈"碰运气"——别笑,真有系统这么配的,回流圈数配成 5 圈,纯属浪费产能。
这里有个细节决定成败:异常格口的位置。一定要放在扫码隧道下游、人工够得着的地方,而且要有独立的输送机段,不要和正常格口抢滑道。我做过的一个项目,异常格口被放在分拣机另一端,人工补码后要推着小车走 80 米去重新上机——高峰期异常件一多,人工根本跑不过来,异常格口反过来成了新的瓶颈。
异常格口和人工处理位,别省这点钱
很多项目在预算评审时,第一个被砍的就是"异常格口"和"人工处理位"——"正常流程跑通就行,异常才有几件"。这话在投标现场听着有道理,在黑五凌晨听着像笑话。
我的底线配置是:整条分拣线至少 2 个异常格口(一个处理读码失败,一个处理超规/异形件),再加 1 个人工处理位。超规件要单独说:WCS 里必须配尺寸重量上限,超过上限的件在上件环节就直接剔除,走人工位,不要让它上分拣机。我见过一个 1.8 米长的地毯卷被送上交叉带,卡在分拣机弯道,整条线停了 25 分钟——就因为上件环节没做超规拦截。
人工处理位还要配一个功能:WCS 要支持"人工指定格口"。有些件读码失败且面单彻底损毁,人工查 WMS 确认目的地后,直接在工作站上指定格口,系统控制分拣机把它送过去。这个功能很多 WCS 出厂默认是关的,记得打开。
另外提醒一句:人工处理位千万别省了那台重打面单的打印机。读码失败的件里,至少三成是面单破损、补打一张就能正常上线。没有打印机,人工只能手抄单号进系统,一个班下来出错率肉眼可见地涨。打印机加碳带,一年才几百美金,这笔钱花得最值。
报警阈值:宁可扰民,不能闷声
最后说报警。WCS 的报警配置我吃过最大的亏,是阈值设得太"体贴"——怕打扰现场,格口满 5 分钟才报警。等报警响的时候,地上已经堆了一人高。
我现在的阈值配置是:格口占用率 85% 预警(只推送到现场主管的手持终端,不响铃),100% 触发改道并响铃;异常格口件数超过 20 件报警,要求 15 分钟内清空;读码失败率连续 10 分钟超过 2% 报警——这通常意味着扫码隧道脏了或者某批次面单有问题,要去查上游。报警必须分级:预警走手持终端推送,故障走声光报警加短信。分级不清的结果就是"狼来了":所有报警都响,现场最后把报警器电源拔了——我真见过。
还有一条:所有异常路由的动作,WCS 必须记日志。哪个件、几点几分、因为什么原因被改道、去了哪个格口、谁处理的、几点清空的。这份日志在旺季复盘时是金子——你能精确算出异常处理的人力成本,明年预算就有依据了。
分拣系统的正常流程,厂商的工程师比我懂。但异常路由这块,厂商的默认配置是按"理想现场"写的,而真实仓库里没有理想现场。格口会满,条码会读不出来,超规件一定会混进来。WCS 配得好不好,不看它顺风时跑多快,看它逆风时乱不乱。下次你们做 WCS 验收,别只看正常分流测试,专门做一轮异常测试:人为堵两个格口、放十个无码件、塞一个超规件进去,看系统 5 分钟之内能不能自己稳住。稳不住的,趁早改配置,别等黑五凌晨再交学费。