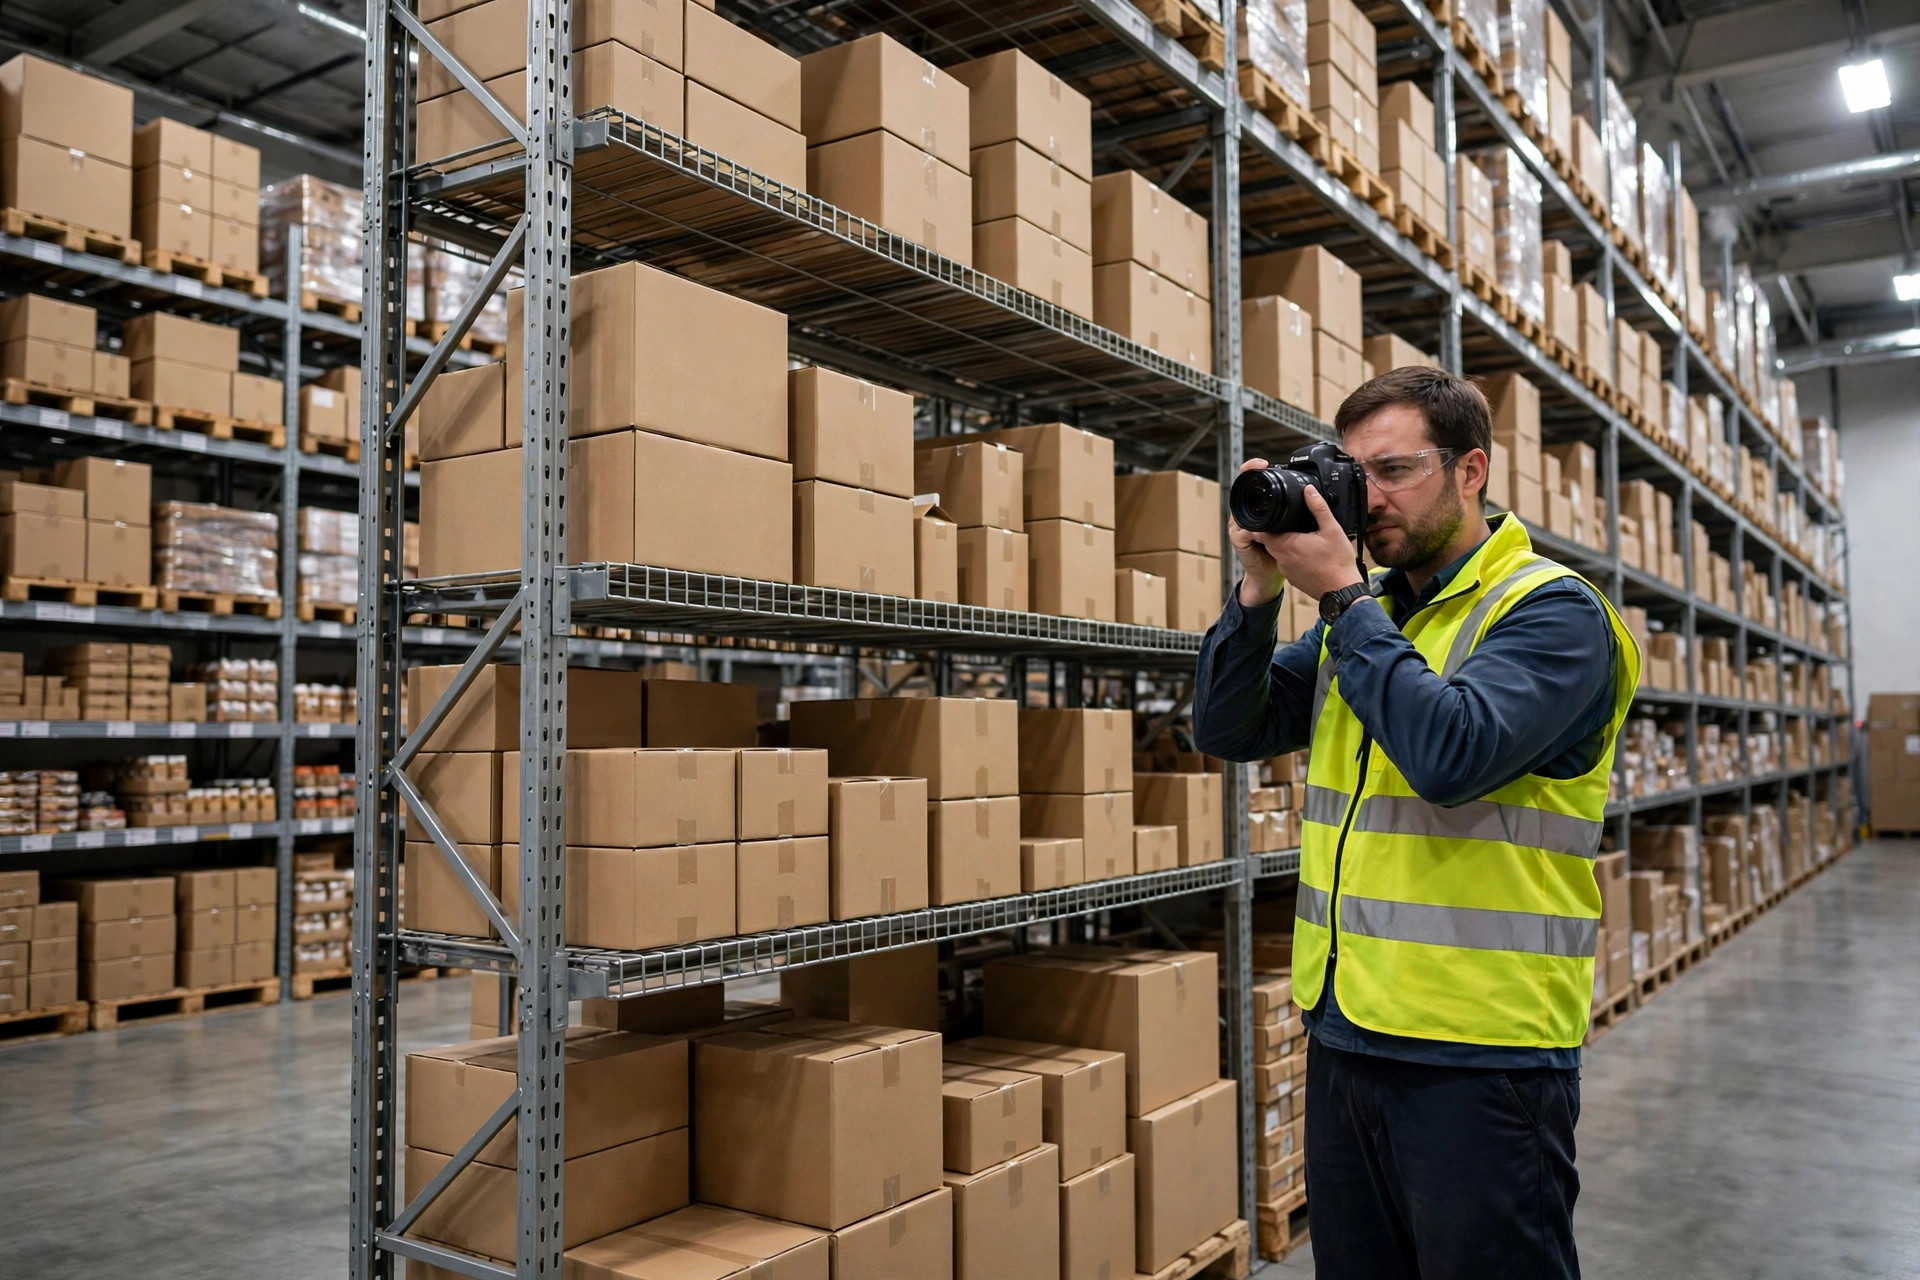
去年见过一个真实的翻车现场。一家做食品分销的客户,IT 负责人很有干劲,花了三个月,组织了两个人专门拍照标注,攒了一万多张 SKU 图片,训练了一个识别模型。上线第一周,拣选复核环节看着挺准,大家都挺高兴。结果换季一到,几个主力 SKU 换了包装设计、主色都变了,模型准确率直接跳水,还不如原来的人工复核省心。项目组当时的表情,我至今记得。
这不是个例。仓库想自己训视觉模型,坑从来不在算法——开源模型多的是,选谁都大差不差。真正的坑在数据这头:到底拍多少张、怎么拍、怎么标。这篇就把这几个问题掰开讲。
照片不是越多越好,是越"全"越好
很多人第一反应是堆量:拍它一万张。这个思路只对了一半。
模型怕的从来不是"少",而是"偏"。一万张照片,全是同一个工位、同一台相机、上午十点的灯光,那第十万张跟前面的也长一个样,模型照样学不会。真正决定数据够不够的,是你覆盖了多少种变化。拍之前,先把变量清单列出来贴在墙上:
光照。 仓库的日光灯管和傍晚从月台门斜射进来的自然光,颜色完全两样。同一批 SKU,早上和下午各拍一轮。灯管老化色温变了,也算一种变化。
角度。 复核台上方的相机是固定的,箱子可不是:横着放、竖着放、倒着放、半个箱子露在镜头外。别只拍"摆拍位",叉车司机随手一放的真实状态也拍进去。
背景。 复核台的传送带、托盘缝隙、地面的反光——背景越杂,模型越要学着忽略它。换两三个工位拍,别可着一个地方薅。
包装状态。 这是跳水重灾区。压皱的、淋过雨的、缠绕膜半包的、促销贴纸贴满的,还有换季换包装的新设计,都得有。上面那家客户翻车,就是训练集里一张"新包装"都没有,模型一见新设计就懵。
变量清单列完,每拍一轮打勾,缺哪块补哪块。这比闷头拍一万张管用得多。顺带说一句,SKU 也可以按包装变化频率分层:常年不变的工业件拍一次管很久;食品快消这种一年换几次包装的,采集就得做成常规动作,而不是一次性工程。
先框选,再谈分割
第二个坑在标注。很多人一上来就想画轮廓(实例分割),觉得越精细越好。我的建议是:先用框选(bounding box)把模型跑通再说。
框选标注快得多,一个熟练标注员一上午能标几百张(举例,按常规速度估算);画轮廓慢得多,还容易标得不稳定。而框选已经足够应付仓库里八成的识别任务:SKU 识别、空箱检测、托盘有没有货、传送带上有没有异物。只有要做精确测量(比如量箱子尺寸算体积重),或者遮挡严重到框选都框不准的时候,才值得上分割。
标注质量比标注数量重要得多。同样几百张,两个人对"破损箱子"的定义不一致,模型学到的就是噪声。动手前先写半页纸的标注规范:什么算破损、什么算正常、遮挡超过一半还标不标。然后找两个人同时标同一批几十张(举例),对不上就改规范,改到两个人基本一致再开工。
外包还是自己标,看阶段。外包平台(Labelbox、Roboflow 这一类)起量快,但他们不懂你的业务,"新包装"和"促销贴纸"这种变化他们认不出来;自己标慢,但标的人天天泡在仓库里,异常一眼就能看出来。我的做法:首批难例自己标,把标准定下来;量产的常规标注外包,抽查比例不低于一成(举例,根据项目经验设定),抽查出问题整批打回。
能微调就不从零训练,能喂难例就不堆数据
先说结论:绝大多数仓库根本不需要从零训练模型。
开源的预训练模型(比如 Ultralytics 的 YOLO 系列,在 COCO 这种大规模数据集上预训练好的)已经见过几十万张日常物品。你要做的,是拿自家仓库的 SKU 照片去"微调"它,让它认识你家的包装。微调需要的数据量级,和从零训练完全不是一个概念:通常几百到几千张、覆盖全变量的照片就能起步(以实际测试为准,不同 SKU 差异很大)。从零训练是研究院干的事,仓库用不上。
准确率目标也别拍脑袋定"99%"。在复核场景里,模型是给人打下手,不是替代人:实在的目标是"把人工复核的工作量砍掉一半以上,漏检率不高于现在的人工水平"(举例目标,需按自家基线设定)。目标定得太高,你会掉进无限加数据的泥潭。
最被低估的一环,是上线后的持续喂数据。新 SKU 上架、老 SKU 换包装、促销季贴纸一贴——这些"长尾"训练集里没有,模型就瞎。正确的做法是把流程跑起来:上线后,模型"认错"和"拿不准"的照片自动捞回来,人工复核确认,难例回流到训练集,定期重训。重训频率看 SKU 变化速度:食品快消这种变化快的,一个月甚至两周一次不为过;工业品变化慢,一个季度一次也行。关键是这个循环转起来,而不是训完一次就不管了——上面那家客户,就是缺了这一环。
还有一句实在话:如果你连标注团队都没有,先别谈自建。市面上有按工位收费的视觉复核方案,先买一个工位验证价值,跑顺了再决定要不要自己训。自建模型的成本大头从来不是 GPU,是人。
明天就能动手的一步:别急着立项。先挑一个拣选复核工位,花一个下午,把主力 SKU 的正常、侧光、破损、堆叠几种状态各拍几十张,凑两三百张(举例),找个标注平台试标。跑一个星期,看模型在真实班次里准不准。准,再谈扩大;不准,你也知道了问题在哪——大概率是变量没覆盖全,而不是照片不够多。