过去两年,我在翻集成商的方案库和行业展会资料时注意到一个明显的变化:提到"视觉检测"的仓库自动化方案越来越多。分拣线上的读码隧道、出库口的破损检测相机、AMR 上的标签校验模块——仓库 AI 视觉检测正在从"可选配置"变成主流方案里的标配。但和很多技术热词一样,热度背后有一个始终没被回答清楚的问题:这些相机到底在看什么,以及,我们凭什么相信它们看得准。
相机到底在看什么:仓库视觉检测的三个真实任务
先把"视觉检测"这个大词拆开。仓库里相机的活儿,归纳起来其实只有三类,而且每一类的技术成熟度和"靠谱"的含义都不一样。
第一类是读码。条码、二维码、面单上的文字识别(OCR),这是仓库视觉最成熟的应用。很多人以为相机读码就是"拍张照",实际上工业读码做的是两件事:解码和分级。国际标准 ISO/IEC 15416 把条码质量分成 A 到 F 六个等级,相机在读出内容的同时,会给这个条码打一个质量分。分拨中心的多相机扫描隧道就是典型代表——包裹从隧道里穿过,多个角度的相机同时抓拍,系统把读到的条码拼成一条完整的包裹身份信息。根据 Cognex 官网对其物流扫描隧道的标称,读码率"高达 99.9%",即便是破损、污损或反光的条码也在覆盖范围内。注意"标称"两个字,后面会讲它成立的条件。
第二类是破损检测。相机看的不再是码,而是箱子本身:凹陷、撕裂、浸水、变形、封箱带脱落。这类任务用的是深度学习的异常检测,模型先学会"正常的箱子长什么样",再把偏离正常的部分标出来。学术界的数字可以给我们一个参照系:一篇 2026 年发表在 IJIRT 的论文报告,基于卷积神经网络的包裹破损检测模型在实验室环境下准确率达到 92%;MDPI 在 2022 年的一项研究里,用 MobileNet 模型对快递箱做破损二分类,测试准确率为 84.6%。这些数字看起来不错,但它们都是实验室数字——光线可控、样本有限、传送带静止。现场是什么样,下一节细说。
第三类是标签校验。面单贴歪了、贴重了、面单信息和订单对不上、危险品标识缺失,这类问题相机都能抓。它的特殊之处在于往往和贴标机形成闭环:相机发现标签不合格,信号直接打回贴标机重贴。这一类任务的价值不在"看",而在"拦"——把问题拦截在出库之前。
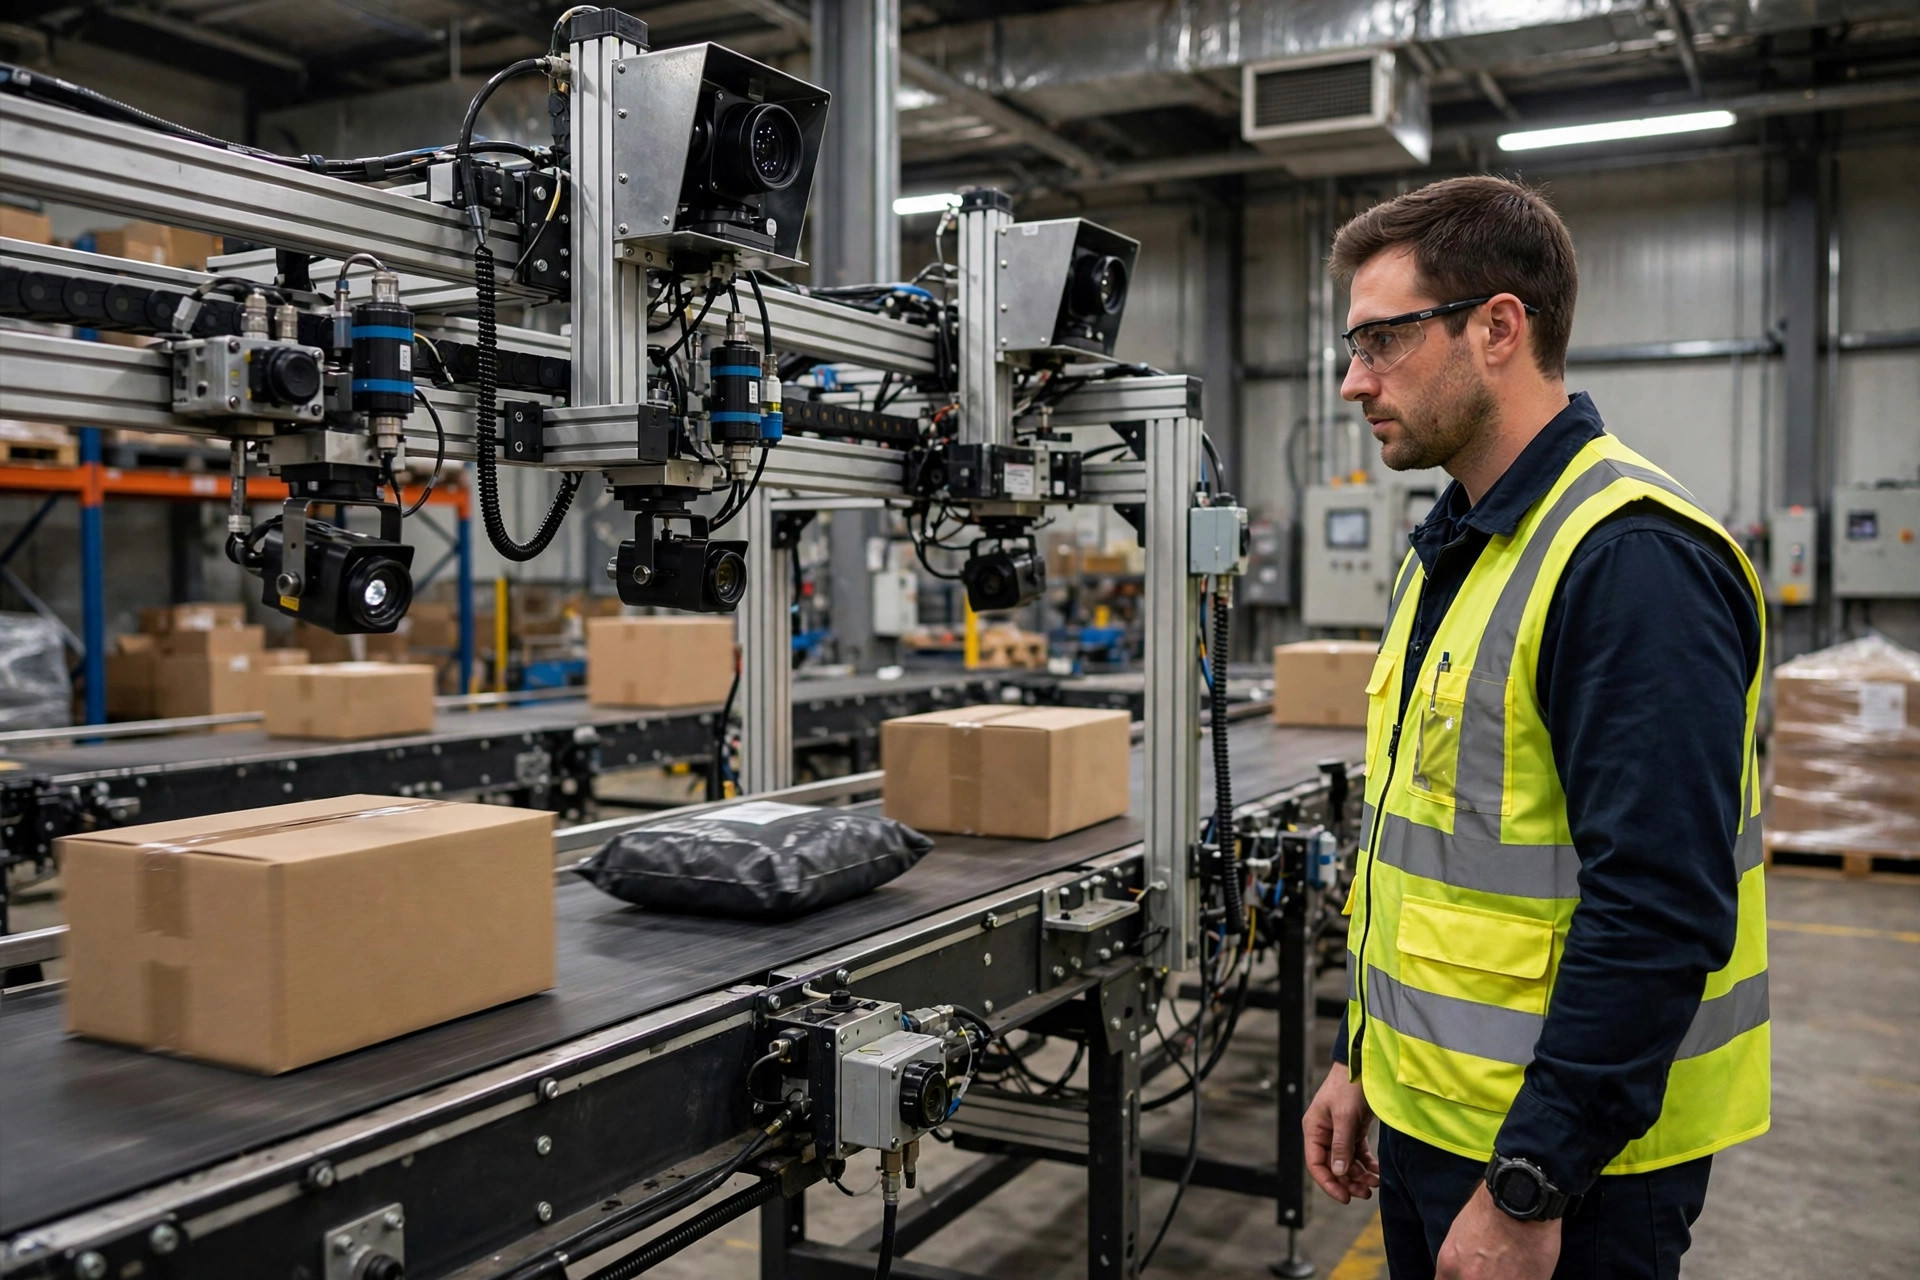
视觉检测准确率的三重决定因素:实验室数字为什么到了现场会缩水
理解了相机在看什么,下一个问题是:厂商宣传的准确率,到底有多少能兑现?根据我的观察,决定现场准确率的有三个变量,而这三个变量恰恰是实验室环境里被"优化掉"的。
第一个变量是光。工业视觉圈里有句老话:相机的成败七成在光源。仓库的顶灯角度、包裹表面的反光、黑色面单和深色纸箱的低对比度,都会直接吃掉成像质量。实验室里用环形光源精心打光拍出的样本,和现场传送带上顶灯直射的包裹,完全是两种输入。很多视觉项目上线后效果打折,复盘下来第一责任人往往不是算法,而是当初为了省钱没做好的光源设计。
第二个变量是数据。异常检测模型依赖大量标注样本,而"破损"这个定义本身就带有主观性——多深的凹陷算破损?封箱带翘起两厘米要不要拦?如果标注团队的标准前后不一致,模型学到的就是噪声。更麻烦的是长尾问题:仓库里 95% 的包裹都是正常的,真正的破损样本本来就少,模型在训练时见过的破损形态有限,到了现场遇到没见过的破损类型,漏检率就会上升。
第三个变量是节拍。实验室拍的是静止的箱子,现场的箱子在传送带上以每秒一到两米的速度移动。速度越快,运动模糊越重,相机需要更高的帧率和更短的曝光时间,这又反过来要求更强的光源——三个变量在这里拧成了一个互相牵制的三角。
一个公开的集成商案例很能说明"基准线"的重要性。ElifTech 公开的一份包裹质检案例显示,自动化视觉检测相比人工抽检,检测准确率提升 85%、检验时间减少 40%、单件检测成本降到原来的四分之一。注意它的比较对象是"人工抽检"——人工抽检本身的覆盖率只有百分之几,而且依赖抽检员当天的状态。这个案例的价值不在于证明视觉检测有多神,而在于提醒我们:读懂一个准确率数字,首先要问它是在和谁比、在什么条件下测的。
这里有一个反常识的判断,值得单独拿出来:决定一套视觉系统成败的,往往不是漏检率,而是误报率。漏检造成的损失是线性的——漏过去一件,赔一件的钱;误报造成的损失却是乘法——误报率每高一个点,需要人工复核的包裹量、传送带的停线次数、复核岗位的工时都会往上翻,最后是人去给机器救场。我见过不止一个项目,算法本身的检出率很漂亮,却因为误报太多被现场操作员关掉——因为对他们来说,一个总在狼来了的系统,不如没有系统。
| 维度 | AI 视觉检测 | 人工抽检 | 固定式激光读码 |
|---|---|---|---|
| 擅长任务 | 读码+破损+标签校验 | 复杂异形件判断 | 高速条码读取 |
| 覆盖率 | 全量(100% 过机) | 抽检(通常低于 10%) | 全量(仅限条码) |
| 速度瓶颈 | 算力与帧率 | 人力与疲劳 | 几乎无瓶颈 |
| 主要风险 | 误报导致复核工时暴增 | 漏检率高且不稳定 | 条码破损即失效 |
| 成本结构 | 前期投入大、边际成本低 | 边际成本随单量线性涨 | 硬件便宜、功能单一 |
值不值得上:一套五步评估视觉系统的框架
如果前面两节把"看什么"和"准不准"讲清楚了,这一节给一个可以直接拿去用的评估框架。我建议按下面五个步骤走,顺序不要乱。
第一步,先定义缺陷清单。把你想抓的问题一条条列出来:错发、破损出库、面单缺失、标签贴歪……然后给每一类问题标一个"漏过去的成本"。错发一件的综合成本(客服、退货、重发、平台处罚)是多少,破损出库被索赔一次是多少。这一步决定了后面所有测算的分母,做不了,后面全是空谈。
第二步,采集现场样本。至少覆盖一个完整的业务周期——比如大促那一周。光照条件、品类结构、包装形态都要有代表性。拿实验室的公开数据集去评估自家仓库,相当于拿别人的体检报告给自己开药。
第三步,做小规模验证。用你自己的样本测两个指标:召回率(有问题的,有多少被抓出来)和精确率(被抓出来的,有多少是真有问题)。不要看厂商在演示环境里的数据集成绩,要看在你样本上的成绩。精确率尤其重要,原因上一节已经讲过:误报是乘法。
第四步,节拍匹配测试。在真实线速下跑至少一个班次,确认相机的帧率和算法的处理延迟跟得上传送带。很多 PoC 在实验室线速下表现完美,一上真实节拍就开始丢帧——丢帧的本质就是漏检。
第五步,算总拥有成本和回本周期。硬件、集成实施、样本标注、每年的维护和模型迭代,对比省下来的人工复核工时和错发、破损成本。一个粗算的方法是:先算出"每拦截一件问题件值多少钱"(第一步的缺陷成本),再乘以系统每月实际拦截量,得到月收益;用总投入除以月收益,就是回本月数。如果这个数字超过 24 个月,就要认真掂量——因为视觉算法的迭代周期很快,两年后的方案很可能比今天便宜三成。
趋势层面,数据指向同一个方向。根据 Reports and Data 的报告,物流仓储机器视觉市场规模 2024 年约 25 亿美元,预计 2034 年达到 65 亿美元,年复合增长率约 9.8%;Dataintelo 对"仓储计算机视觉"用了更大的统计口径,给出 2025 年 58 亿美元、2034 年 224 亿美元的预测。两家机构的口径不同,数字区间拉得很大,但方向一致:未来五到八年,是视觉检测从头部大仓向中型仓渗透的窗口期。背后的驱动力有三条:人力成本持续上行、错发和破损的下游成本被电商平台规则不断放大、相机和边缘算力的价格持续下行。2026 年 6 月,Zebra 在美国发布了结合 AI 视觉检测与实时读码的仓库方案,大厂的产品动作通常比论文更能说明商业化节奏——当头部厂商开始把视觉检测做成标准化产品,意味着这项技术正在走出定制化项目阶段。
所以,问题可能从来不是"视觉检测靠不靠谱",而是"我们到底想让它替我们承担哪一部分不确定性"。机器擅长的是不知疲倦地执行既定标准,不擅长的是定义标准本身——"什么样的破损算破损""多歪的标签算贴歪",这些判断今天仍然在人手里。当技术把执行层的不确定性吃掉之后,留给管理者的,恰恰是那些更难回答的问题:标准定多严,误报和漏检的天平往哪边倾斜,以及,你愿意为"确定性"付多少钱。
作者:陈博士|供应链行业研究员