2026 年,AI 行业的关键词正在从数据中心转向物理世界——world models warehouse physical ai 这条赛道,正在成为机器人行业最大的变量。6 月 1 日,NVIDIA 在 GTC Taipei 上发布了 Cosmos 3——用官方的说法,这是全球首个完全开源的物理 AI"全能模型"(omnimodel),把视觉推理、世界生成和动作预测装进了一个混合 Transformer 架构。而在 2026 年中,NVIDIA 已经把 Physical AI Data Factory 的蓝图推向开源:一套用 world models warehouse physical ai 思路生成、筛选、策展合成数据的参考架构。官方的表述很直白:这个行业最大的瓶颈,已经不是算法,是数据。
资本的流向印证了这个判断,而且相当激进。旧金山公司 Physical Intelligence 成立于 2024 年,融资轨迹是:约 7000 万美元种子轮(随首版 π₀ 模型),4 亿美元 A 轮、估值 24 亿美元(Bezos、OpenAI、Thrive、Lux 参与),6 亿美元 B 轮、估值 56 亿美元(Alphabet 旗下 CapitalG 领投);据 Bloomberg 报道,公司新一轮融资的目标估值已到 110 亿美元。值得注意的一个事实是:截至公开报道,该公司尚无商业化产品,也未披露商业化路线图。资本买的不是收入,是"通用机器人基础模型"这个叙事本身。
从"预测下一个词"到"模拟物理世界":世界模型是什么
语言模型吃的是互联网,而互联网是文本的。物理 AI 没有这个运气:不存在"机器人轨迹的互联网",真实机器人数据的采集又慢、又贵、偶尔还危险。世界模型(World Models)的思路是换一条路:让模型学会物理直觉——重力、接触、尺度、物体恒存——然后用它生成"看起来对、物理上也对"的未来视频,把几次真实示教"乘"成几千次训练数据。
Cosmos 3 发布了 Super、Nano 等多个尺寸,这本身就是一种分工宣言:云端训练、端侧推理。推理一侧跑在 NVIDIA Jetson 这类端侧算力模块上,换的是机器人等不起的东西:去数据中心打个来回的时间。在工厂和仓库里,延迟是安全约束,不是体验问题。
钱和人都去了哪:一条 2026 年的时间线
把 2026 年的公开事件按时间排开,一条清晰的 world models warehouse physical ai 主线就浮出来了:
- 2026 年中:NVIDIA 把 Physical AI Data Factory——一套合成数据"生成、筛选、策展"的参考架构——推向开源,Nebius 等云厂商跟进做了可落地的运行框架。"数据工厂"这个词值得玩味——合成数据正在被工业化,而不是停留在研究玩具阶段。
- 6 月 1 日:Cosmos 3 在 GTC Taipei 发布,同时成立 Cosmos Coalition,创始成员包括 Agile Robots、Black Forest Labs、Runway、Skild AI。开源世界模型开始抱团。
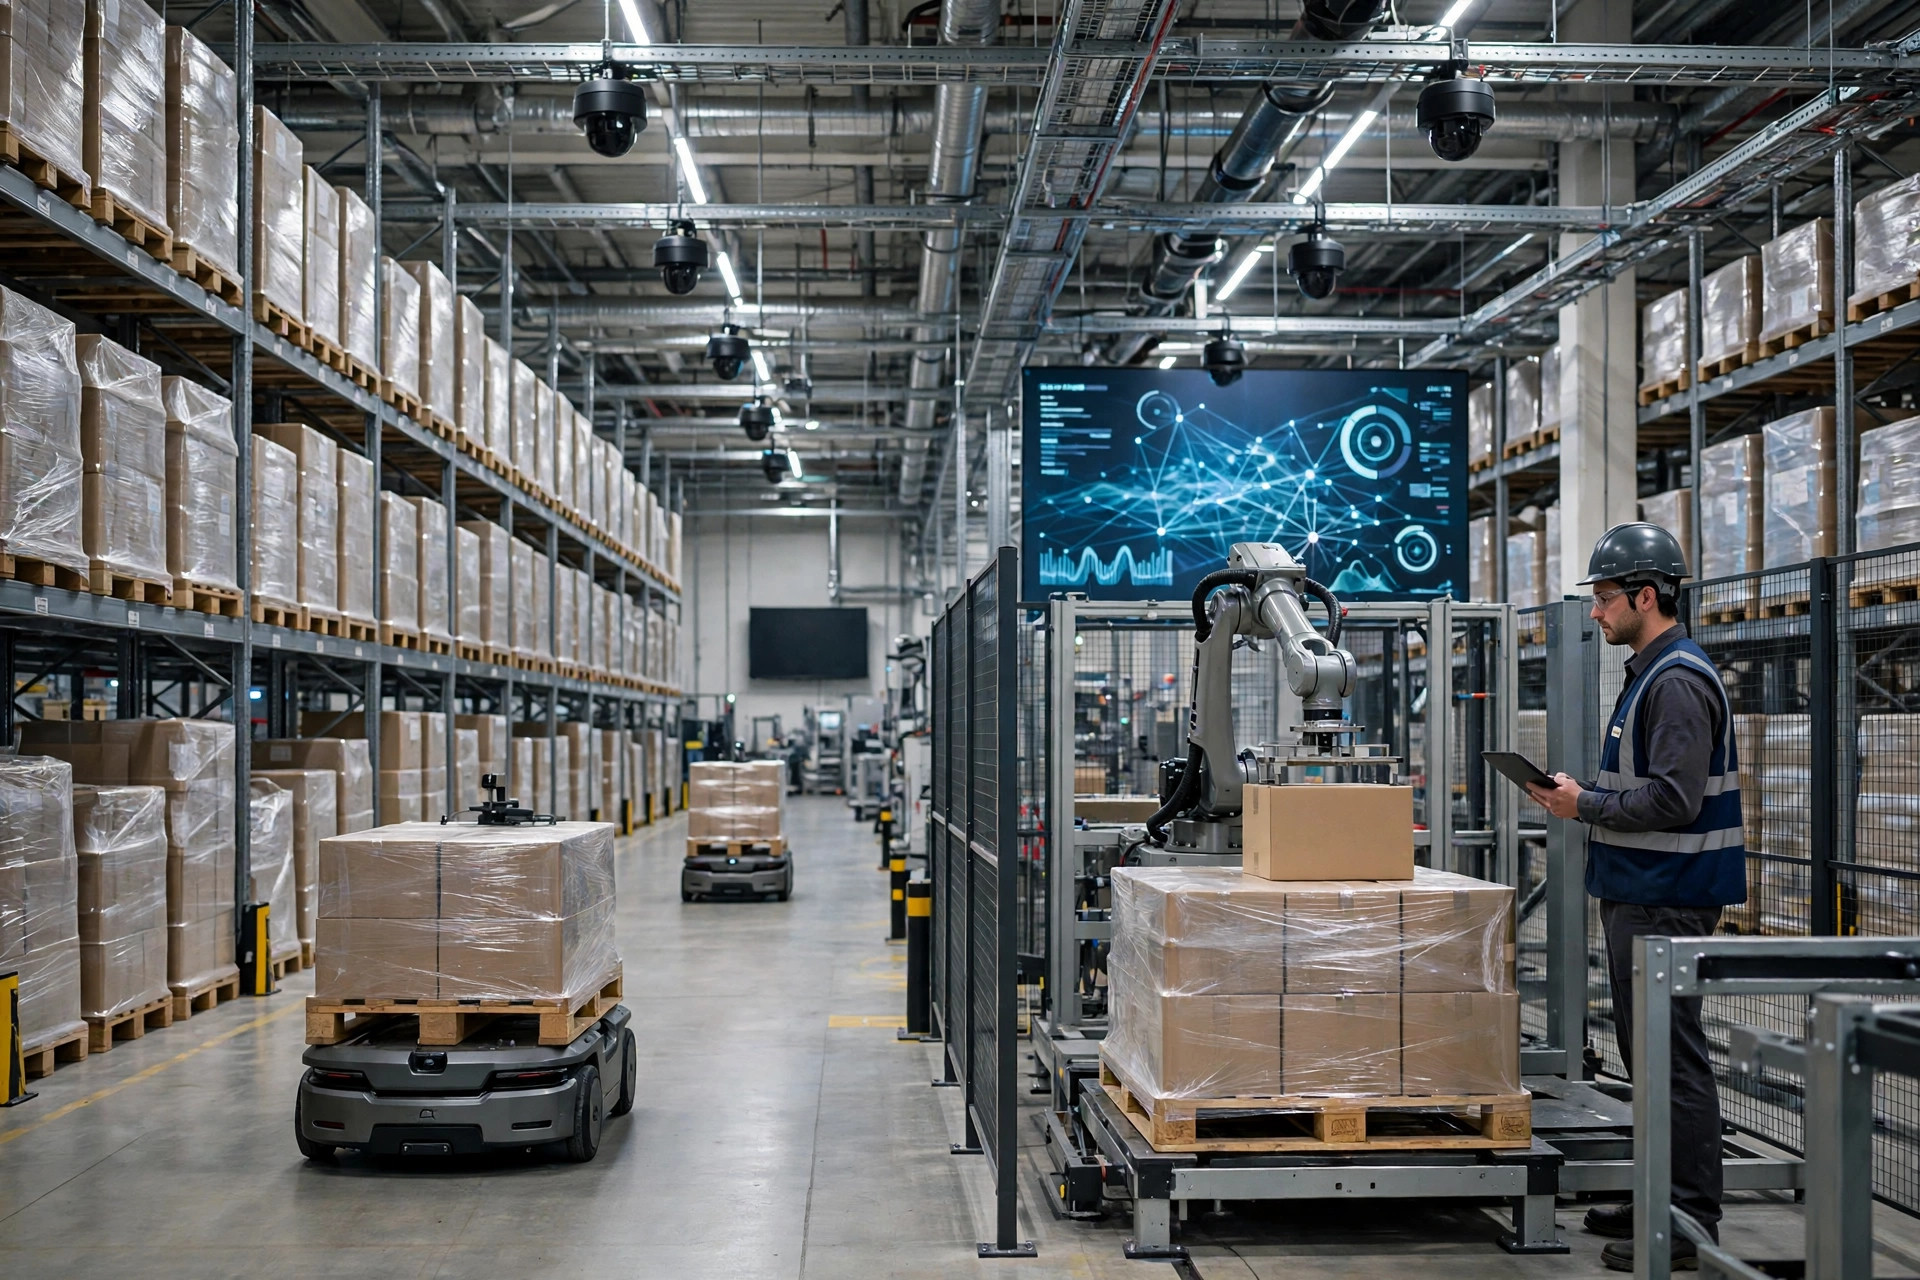
- 从 Doosan 的机械臂到 Sereact 的双臂分拣,工业界正在往同一条管线上下注——Isaac 做仿真、Cosmos 造数据、Jetson 跑推理。
- Doosan Robotics 把 NVIDIA 全套管线——Isaac Sim/Lab 做仿真训练、Cosmos 生成合成数据、Newton 物理引擎、Jetson Thor 端侧推理——接入其 Agentic Robot OS。首批两个工业应用是拆垛和打磨,目标 2028 年实现工业人形机器人的商业化部署。
- 10 月 21 日:Sereact、NVIDIA、Nebius、CEVA Logistics、Zalando 联合宣布,把"闭环训练"搬进仓库:在 CEVA 的履约中心里做 Zalando 的退货处理。退货是仓库里最难自动化的环节之一——每一件都带着客户留下的"原样",机器人要识别、判断、分拣;做错的案例几天内就能变成更新后的策略,而过去这个循环要几周。
为什么是仓库:世界模型在仓库落地的归因
归因要回到机器人学习十年未解的核心问题:sim-to-real gap。仿真里跑得漂亮的策略,一到真实库房就水土不服——摩擦、材质差异、接触动力学,仿真都简化掉了。过去十年的解法是"采更多真实数据",但真实数据贵得离谱:仿真里跑一万次的成本,还不到在真实库房采一天数据的零头。
世界模型改变的是这个成本结构:当合成数据的物理保真度足够高,"数据"就从一种需要采集的稀缺资源,变成一种可以生产的工业品。这是对仓库自动化最友好的变化,因为仓库恰恰是"长尾场景"最多的地方:退货的每一件都不一样,拆垛的每一箱破损程度都不一样——这些场景过去因为"数据不够"做不了,现在第一次有了工程化的解法。
这里有个反常识的判断:世界模型最大的意义,不是让机器人更聪明,而是让训练数据从"采"变成"造"。数据的护城河,从"谁手里有数据"转向"谁有真实场景可以验证合成数据"。仓库服务器里那些堆积如山的作业视频、异常处理记录,过去是成本中心,未来可能是资产——前提是,现在开始有意识地存下来,而且存的是结构化的(带时间、库位、SKU 上下文)。
2026-2028:三个时间刻度上的判断
基于公开信息,我给出三个带时间线的判断,留待验证:
- 2026-2027 是验证期。看 Sereact/CEVA 这类闭环能不能把"周"级迭代稳定跑下来,看退货、拆垛这类非结构化场景的成功率能不能爬过人工成本的盈亏线。过不了,故事就停在幻灯片里。
- 2027-2028 是规模化窗口。Doosan 把 2028 年定为工业人形机器人商业化部署的目标,这是一个可观察的锚点——它背后是整条管线(Isaac、Cosmos、Newton、Jetson)必须在那之前达到工业级可靠性。
- 给仓库经营者的三条具体建议:第一,把作业视频存下来,这是未来的训练燃料;第二,试点从"乱"的场景开始——退货、质检、拆垛,而不是已经跑顺的整托盘搬运;第三,别自己从零训 world models warehouse physical ai 模型,买管线、用开源权重,你的优势是场景,不是算法。
最后留一个开放式的问题:当模拟足够便宜,真正的稀缺会变成什么?可能是物理世界本身的"意外"——而意外,只发生在开着门的仓库里。世界模型能模拟一万种纸箱的倒法,但它模拟不了旺季第一天库房里的真实混乱。物理世界最后的护城河,可能恰恰是"物理"二字。
作者:陈博士|供应链行业研究员