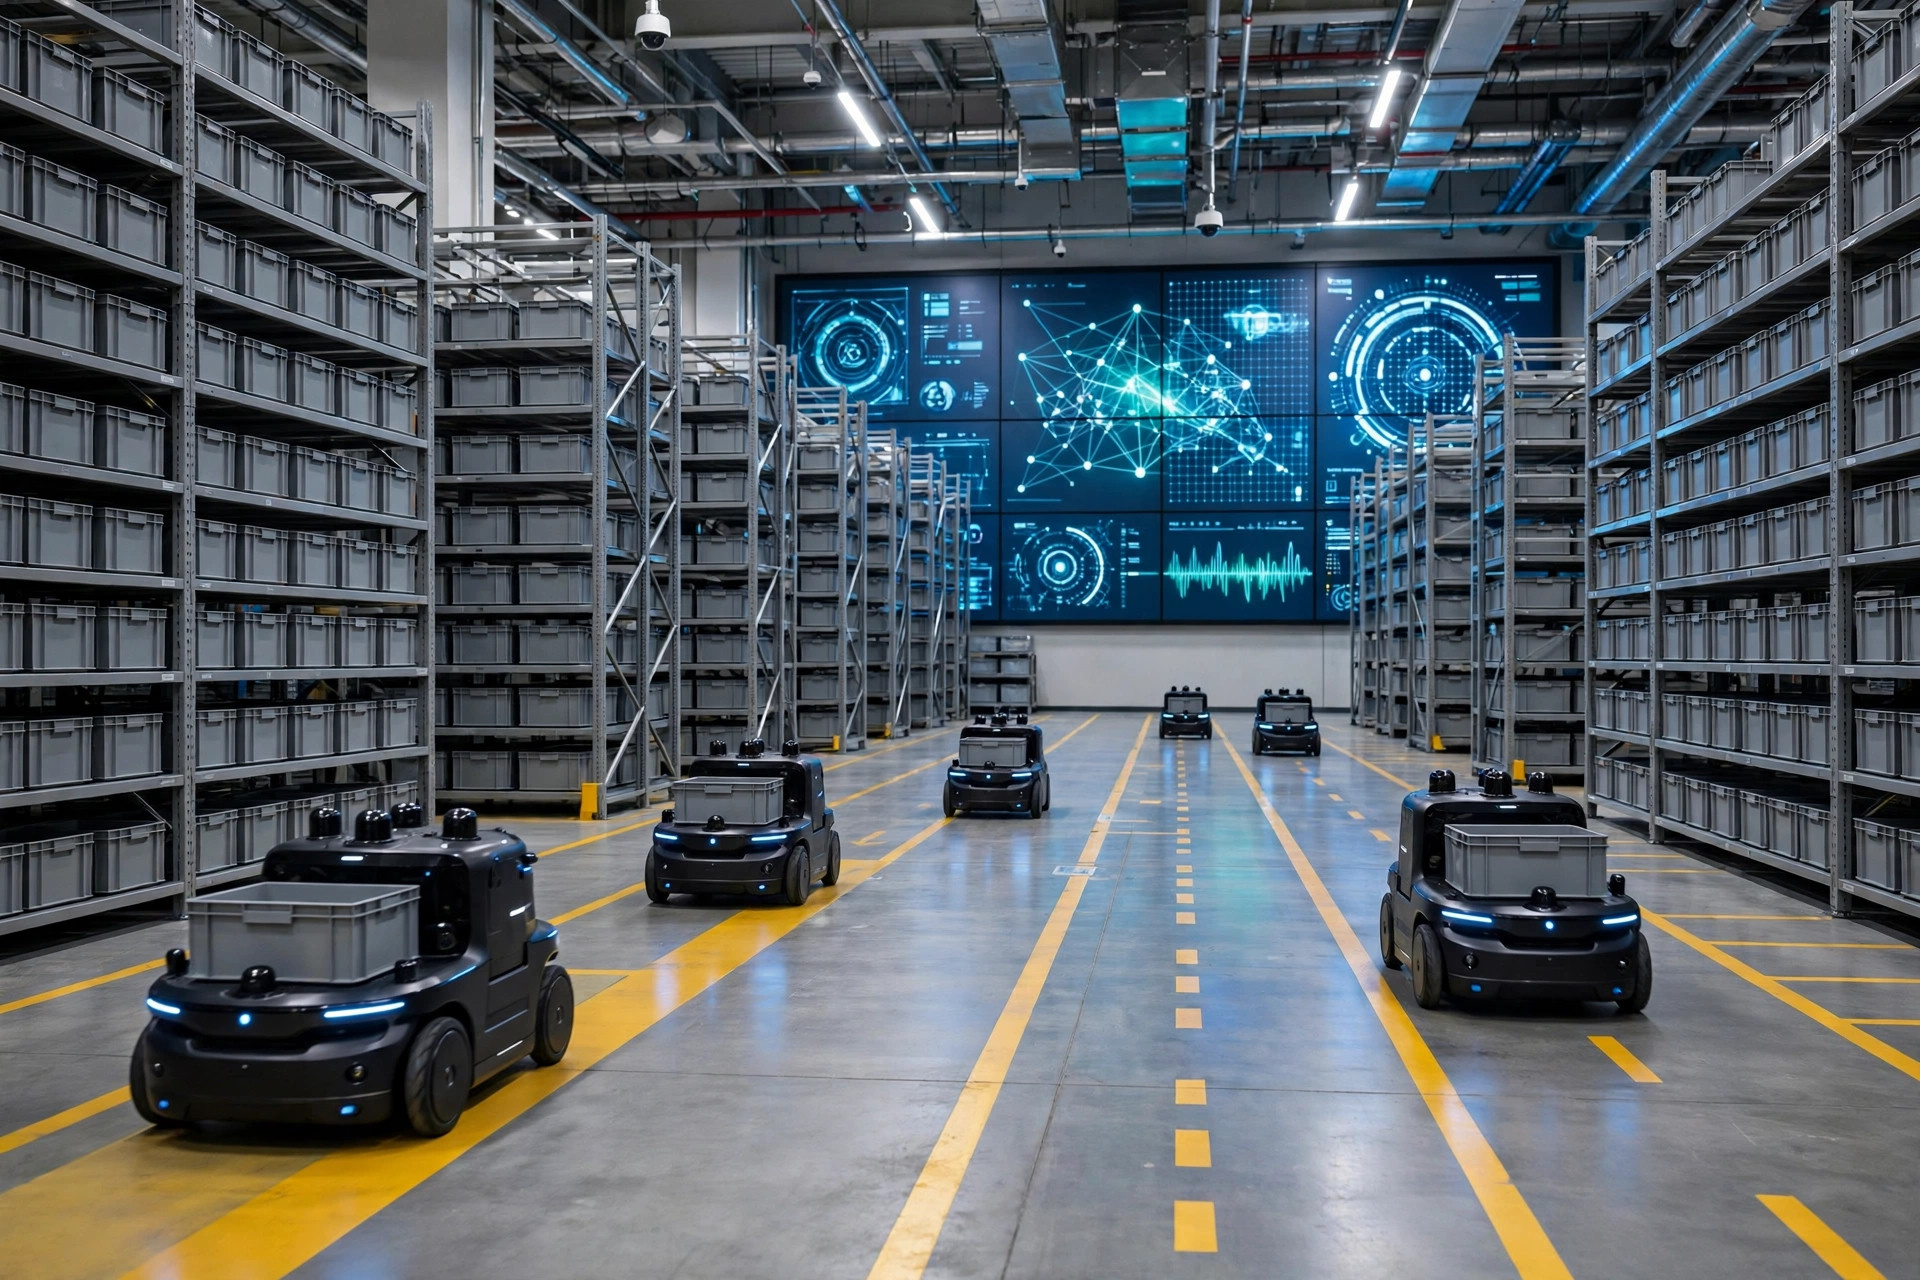
仓库AI数据飞轮这个说法,过去两年在供应链技术圈的出现频率越来越高。它的字面意思是:仓库里跑的 AI 系统,用得越多、喂的数据越多,模型就越准;越准,大家就越愿意用;越用,数据又越多。听起来像一个自我强化的正循环。但根据我对仓库 AI 落地项目的持续跟踪,这个飞轮并没有传说中转得那么顺——它在某些场景里确实存在,在另一些场景里更像是一个愿景。要把这件事讲清楚,需要先看数据,再谈归因。
一、数据飞轮在仓库 AI 中的三次具象落地
在仓库这个场景里,数据飞轮不是一句口号,它至少有三个已经被验证的具象形态。一是需求预测与补货:历史订单和库存数据喂给模型,模型输出 SKU 级销量预测,预测指导补货和库位调整,实际销售结果又变成新的训练数据——预测越准,业务越敢把决策权交给模型,模型拿到的数据越完整。二是视觉检测:入库质检、破损识别、盘点复核中,每一次人工复核都是一次免费标注。三是机器人路径与任务分配:AMR 每次搬运记录实际耗时,机械臂每次抓取记录成败,数据天然带标签,无需二次加工。
要观察飞轮的真实转速,需要一个时间线足够长的样本。Amazon 的仓库机器人网络是目前最合适的公开样本:2012 年收购 Kiva Systems,大规模铺开货到人机器人;2022 年发布 Sparrow 机械臂,据其官方介绍可识别并处理在售商品中约 65% 的品类;2024 年宣布全球履约网络部署的移动机器人超过 75 万台。十二年间,每一次拣选、抓取和失败,都变成了训练数据的增量。
Sparrow 的迭代很能说明飞轮的机制:早期只能处理形状规则、位置固定的商品;抓取数据积累后,对异形件、软包装的成功率逐步提升;成功率提升,Amazon 敢把它放到更多品类,数据又更多——"能力边界→数据增量→能力边界"的循环。关键不在算法(抓取规划框架学术界早已公开),而在 Amazon 手里有别人拿不到的、带真实失败标签的抓取数据。
第二个样本是需求预测。2024 年底到 2025 年初,我调研了两家日均 8 万~12 万单的电商大仓(华东、华南各一家),均在 2023 年前后上线了 SKU 级销量预测。上线一年后,缺货率从约 6% 降到约 4% 上下,滞销品库存周转天数缩短约两成。两家供应链负责人说了几乎同一句话:"模型刚上线还不如老计划员的直觉,熬过前六个月的数据积累期才开始反超。"飞轮的前半圈是亏的,这是后来者最容易低估的一点。
二、为什么先发者越转越快
归因可以落到三个机制。第一,标注资产的复利:仓库数据的特殊之处在于业务动作本身就是标注——人工复核、异常处理、盘点差异都自带标签。先发者上线早,"免费标注"积累得早;后来者买得到同样的算法,买不到这几年的标注资产。第二,反馈闭环的速度:飞轮的转速不取决于数据量,而取决于"数据→模型→决策→新数据"一圈要多久。Amazon 履约网络以小时计,需求预测以天计——周期越短,先发者的领先拉开得越快,接近指数级。第三,长尾覆盖的宽度:先发者的数据覆盖了足够多的长尾——异形件怎么抓、大促波峰怎么切、异常件怎么处理。后来者用公开数据训出的模型,标准场景表现接近,一进长尾差距立刻显现,而仓库恰恰是长尾密集的行业。
三、反常识:数据飞轮不会自动转动
到这里,它听起来像注定属于先发者的故事。但根据我对落地项目的跟踪,有三个反常识的判断必须先讲清楚——它们决定了飞轮到底转不转得起来。
第一,飞轮有冷启动门槛,而且不低。"用得越多越准"的前提,是系统已经准到让人愿意用。模型初期准确率若低于人工,业务方会绕开它,数据就断流。上面两家电商仓熬过前六个月,靠的不是技术,而是管理层强制"预测结果必须作为补货依据"。没有组织层面的强制闭环,飞轮的第一圈转不起来。很多仓库 AI 项目死在这里:数据有、模型有,业务流程里却没有给模型留一个"必须经过它"的位置。
第二,数据会贬值。仓库数据有个隐蔽的敌人:分布漂移。SKU 大换血、仓库搬迁、从标品仓切到非标品仓,老数据价值快速衰减。为服装仓训练三年的视觉模型搬到汽配仓,准确率可能直接腰斩。护城河有保质期,保质期取决于场景稳定性:越稳定越深,变化越快蒸发得越快。
第三,飞轮会放大初始偏差:最初标注质量不高、或规则带系统性偏差,转得越快放大得越快。我见过一个分拣异常检测项目,初期把"包装轻微褶皱"大量标成"破损",模型越学越严,误拦率一路走高,最后被迫关停自动拦截。飞轮不辨方向,它只负责加速。
把这三个判断放进一个评估框架,可以判断一个仓库 AI 场景值不值得押注飞轮:
| 评估维度 | 飞轮友好型场景 | 飞轮困难型场景 |
|---|---|---|
| 数据密度 | 高频重复动作,如拣选、搬运 | 低频长尾动作,如年度盘点 |
| 反馈闭环速度 | 分钟到小时级可验证,如抓取成败 | 季度级才知道结果,如长期需求趋势 |
| 标注成本 | 业务流程自然产出,如人工复核 | 需要专人离线标注 |
| 场景稳定性 | SKU 与流程长期稳定 | 频繁换品、搬仓、切换品类 |
| 初始数据规模 | 已有数年历史数据沉淀 | 从零开始冷启动 |
一个场景如果在五个维度里有三个以上落在右列,"用得越多越准"大概率只是一个愿景,投入之前先把冷启动和闭环设计想清楚。
四、后来者的三种追赶路径
先发者有护城河,不等于后来者没有路。根据技术演进,我看到三条走得通的路径。第一,预训练模型加少量微调:视觉大模型正在改变游戏规则——过去要几十万张标注图片的破损检测,现在用预训练模型加几千张本仓图片微调就可用,算法商品化正在部分对冲先发者的数据优势;但对需求预测这类拼本仓历史纵深的场景帮助有限。第二,数据联盟:单个中小仓撑不起飞轮,几十家仓把脱敏操作数据凑到一起就能形成有分量的训练集。欧洲已有 3PL 在尝试:数据不出各自系统,只共享模型梯度或脱敏特征。难点不在技术,而在信任和利益分配——谁贡献大谁多分,这是商业问题不是 AI 问题。第三,错位竞争:主动选飞轮转不起来的场景。非标品仓、定制配套仓、频繁换品类的快时尚仓,数据贬值太快,先发者的历史数据优势大打折扣。后来者一开始就扎进这类场景,反而和先发者站在同一起跑线——护城河只存在于挖得动的地方。
五、未来三到五年的时间线判断
基于模型能力曲线的历史斜率、标注成本的下降速度和过去五年仓库自动化的渗透节奏,判断如下——这些是带时间线的可证伪判断,欢迎几年后回来检验。2026~2028 年:视觉类仓库 AI 的预训练模型成为标配,中小仓花不多的钱就能拿到"八十分"的视觉检测能力,先发优势被明显稀释;但需求预测和库存优化上的先发优势会继续拉大,因为这类场景拼的是本仓多年积累的纵深数据,预训练模型帮不上忙。2028~2030 年:出现区域性或品类性的仓库数据联盟,头部 3PL 开始用"数据换算法服务"做交易;算法继续商品化,"数据工程加业务闭环"的团队溢价上升——值钱的不再是调模型的人,而是能把飞轮转起来的人。
最后留一个开放式问题:如果数据真的是护城河,这条河的水到底归挖河的人,还是归流经的每一块土地?当数据联盟和数据监管同时入场,今天先发者手里的牌,五年后还值多少钱?没有标准答案,但每个打算在仓库 AI 上押注的人,都应该先想清楚自己的答案。
作者:陈博士|供应链行业研究员