2023 年我接了个退货仓的项目。客户想在复核线上加一套视觉检测,专门挑破损箱。账算得很实在:一个破损件混进发货,索赔加上退货运费,够买好几台工业相机了。方案评审一路绿灯,卡住的地方却出乎所有人意料——不是算法选型,不是相机参数,是我们凑不出训练数据。
几个月下来,真实的破损样本只攒了几十张。更要命的是,这几十张高度重复:同一个角被压瘪、同几条传送带、同一个顶灯角度。模型硬着头皮训出来,上线第一周就把好端端的箱子当破损拦下来,误报多到操作员直接关了报警。那次之后我学乖了:视觉项目立项第一天,先问数据从哪来,而不是先选相机。
异常为什么拍不到
先把残酷的现实摆出来。破损、泄漏、错标签、封箱带翘起,这些异常在仓库里天然就是小概率事件。一条日过几万件的复核线,破损率能压到千分之几已经算管理到位。你想攒几千张"破损"照片,等于要守着传送带等几个月,期间还不能换季、不能调灯、不能换箱型,不然数据分布全变。
就算等到了,标注也是个无底洞。破损没有标准答案:箱角压瘪到什么程度算"损"?胶带翘起两毫米要不要标?三个人标同一张图,能标出三个版本。真实拍摄还有个隐形杀手:场景覆盖率。光照、相机角度、传送带速度、纸箱新旧程度,组合起来是无穷的。你拍到的永远是"过去三个月这个工位"的样子,模型一上线就水土不服。
等真实数据攒够的那天,项目窗口往往已经过了。这就是仓库视觉的死循环:最需要模型的地方,恰恰最拿不出数据。
三条造数据的路子
既然等不来真实异常,那就自己造。目前靠谱的有三条路,各有各的脾气。
第一条路,三维仿真渲染。建一个纸箱的三维模型,用程序控制压痕深浅、撕裂位置、污渍形状,相机机位、光照、背景随便换。渲染出一张图的同时,标注是自动生成的——因为渲染器站在"上帝视角",边界框、分割掩膜、深度图直接从场景里读出来,一分钱标注费都不花。工具链已经很成熟:开源的有 BlenderProc,德国宇航中心 DLR 的 Denninger 等人 2019 年发表(arXiv:1911.01911),核心思路就是用照片级渲染把虚实差距压小;商业路线有英伟达的 Omniverse Replicator,官方定位就是给视觉检测、机器人这类场景批量生产带标注的合成数据;Unity 也有 Perception 工具包,专门生成带真值标注的合成数据集。
第二条路,域随机化,思路反直觉:不追求逼真,追求"乱"。2017 年 Tobin 等人发表的那篇论文(arXiv:1703.06907)是开山之作——训练图的纹理、光照、相机位置全部随机,乱到让模型觉得,真实世界不过是又一种随机组合。论文里用这种方法训出的定位模型,在真实场景达到了 1.5 厘米的精度。我的实战体会:传送带这种背景相对固定的场景,域随机化性价比奇高,因为你不需要把仿真做得多像,只需要把它做得足够"多变"。
第三条路,生成式模型。拿手里那几十张真实破损图,用生成对抗网络或扩散模型去"生"出更多变体。这条路我持保留态度。生成模型会一本正经地"脑补",生出物理上根本不存在的破损形态,模型学了一堆假特征,上线照样翻车。我的 verdict:生成式只能当数据增强的配角,调调亮度、换换背景可以;指望它凭空发明新的异常类型,不行。
仿真不是万能药
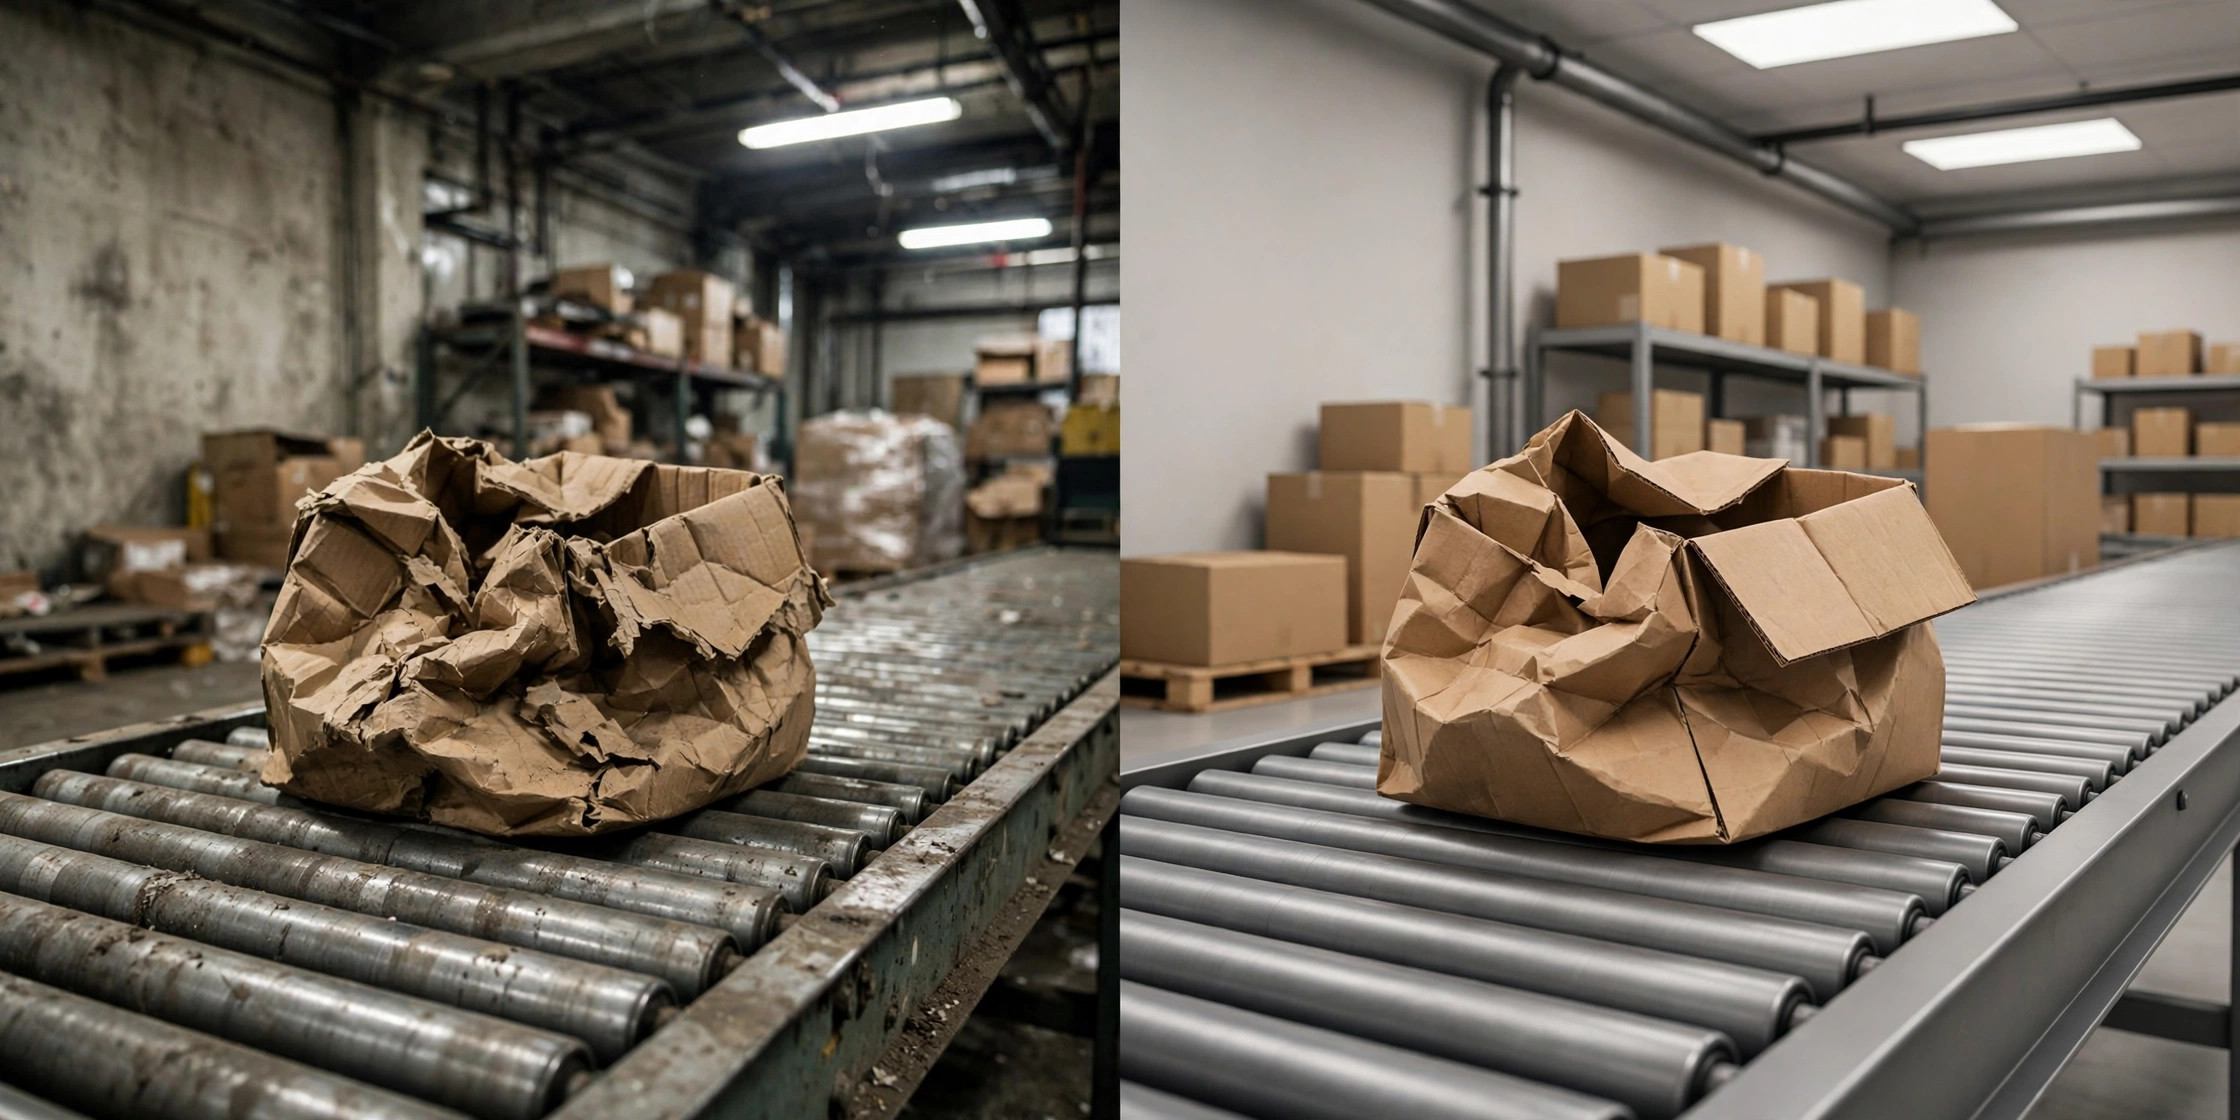
上面这张图,左边是真实仓库里拍到的破损箱,右边是三维渲染的"同款"。肉眼都能看出差距,模型只会更敏感。
虚实鸿沟是真实存在的。渲染图的光照做得再真,传感器的噪声、镜头的畸变、传送带高速运转带来的拖影,仿真里经常缺席。更隐蔽的坑是:合成数据里的"异常"往往做得太标准、太干净,而真实破损是脏的、随机的、不讲道理的。模型在干净数据上学到的决策边界,一碰到真实世界的泥泞就崩。
弥合的办法就一个:混合训练。合成数据打底盘,保证模型见过足够多的异常形态;真实数据做校准,把决策边界拽回现实。再往后是闭环迭代:把线上误报、漏检的真实图持续回流进训练集。合成数据解决的是"从零到一",真实数据解决的是"从可用到好用",两个谁也替代不了谁。
什么时候别玩合成
合成数据虽好,有些场景老老实实拍照更快。
异常形态本身很规整的时候,别折腾仿真。比如错标签检测:打印一批标签贴上去,一个下午能拍几百张,角度光照随便摆。建模师建场景的时间,够你拍完三轮了。
团队里没人懂三维管线的时候,也别硬上。仿真这套东西,建模、材质、光照、渲染管线,样样都是手艺活。外包建模的报价经常比拍摄加标注还贵,还返工两三次,项目直接烂尾。
最后算一笔账。真实拍摄是线性成本:拍一张、标一张,多一张就多一分钱。仿真是固定成本:场景建好的那一刻最贵,之后加量的边际成本接近零。所以决策点很清晰:你要的样本量越大、异常越稀有,合成数据越划算;反过来,样本需求小、异常好复现,相机拿起来就拍,别犹豫。
明天就能动手:五步检查清单
如果你明天就要启动一个仓库视觉项目,按这个顺序做,别跳步:
- 先数样本:把你要检测的异常类别列出来,每个类别现在手里有几张真实照片。连验证集都凑不齐的类别,直接划进"必须用合成数据"。
- 先装机位:按最终部署的机位把相机装好,连续跑一周。真实数据流先攒起来,这是你将来做校准的本钱。
- 先跑通工具:找台带 GPU 的机器,把 BlenderProc 的官方示例跑通,渲染出第一批自带标注的图。跑不通,就别谈自建仿真管线。
- 先做对照实验:合成数据打底加真实数据校准,训一个小模型;再用纯真实数据训一个。比误报率和漏检率,数据说话。
- 再谈规模:对照实验里合成路线赢了,再投入建完整的仿真场景;输了,老老实实回去拍,别跟工具较劲。
我的 verdict 很直接:合成数据不是银弹,但它是仓库视觉项目里最被低估的一根杠杆。用对地方,它能把"等数据"从几个月压缩到几周;用错地方,它就是烧钱的玩具。区分这两者的,永远是你手里的对照实验,不是对技术的信仰。