结论先说:车队变慢,十有八九不是车不行,是路堵了。做一轮RCS任务日志拥堵分析,把过去一周的任务日志回放出来,拥堵点自然现形——我经手的项目里,九成以上的"越跑越慢"都能在日志里找到病根,比凭感觉加车靠谱得多,花的钱也少一个数量级。
车队为什么会越跑越慢:堵的不是车,是逻辑
AMR 车队是个动态系统,车和车之间互相影响。一台车多等 30 秒,后面的车跟着排队,排队又反过来拖慢调度——这种连锁反应在现场你只能看到"大家都在慢",但在日志回放里看得一清二楚:哪一段路、哪个时间点、哪几台车互相卡住,全都有时间戳为证。
拥堵一般分三种,每种的病根完全不同:
- 充电拥堵:电量低的车扎堆去充电区,把主干道堵死。这是最常见的,约占我见过案例的四成。
- 路口拥堵:窄巷道、十字路口双向会车,频繁让行甚至死锁。车越多越严重。
- 任务分配拥堵:调度策略把任务全派给离得近的几台车,少数车跑死、多数车闲置。日志里看就是任务时长方差巨大。
2024 年 9 月,华东某 3PL 电商仓,约 1.5 万㎡,做服装和小家电。车队从 36 台扩到 54 台,拣选任务平均完成时长反而从 11 分钟涨到 16 分钟。甲方一口咬定是车不行,差点再下单 20 台。我让他们先停一停,导一周 RCS 任务日志做回放。结果一目了然:每天下午 2 点到 5 点,充电区门口排队十几台车——电量低于阈值的车扎堆去充电,把主干道堵得死死的。救回来的办法很简单:充电阈值从 25% 降到 15%,再把充电拆成两个时段错峰。第二天任务平均时长就回到 11 分钟出头,一台车没加。这个坑我见过三次,充电策略永远是第一嫌疑人,查拥堵先查充电,这是我的固定动作。
RCS任务日志拥堵分析,分五步做
别一上来就买可视化软件,先把这五步走扎实。每一步我都写细,照着做就行:
- 拉日志:找 RCS 厂商要日志导出接口,至少拉连续 7 天,必须含一个波峰日。关键字段一个不能少:任务编号、车辆编号、任务创建/开始/结束时间、每段路径的途经点时间戳、等待事件(等待/让行/死锁)记录、充电事件。字段不全的日志,回放出来就是错的,先跟厂商把字段补齐再往下走。
- 清洗:先对时钟。RCS 服务器和车端时钟漂移是常态,时间同步对齐后再分析,否则回放出来的"拥堵"全是假的。然后剔除测试车和维修车的数据——这个坑我见过三次,有人把维修车算进去,热力图上出现"幽灵拥堵点",全组人对着假数据开了一下午会。最后统一剔除异常短任务(比如 10 秒内完成的测试任务)。
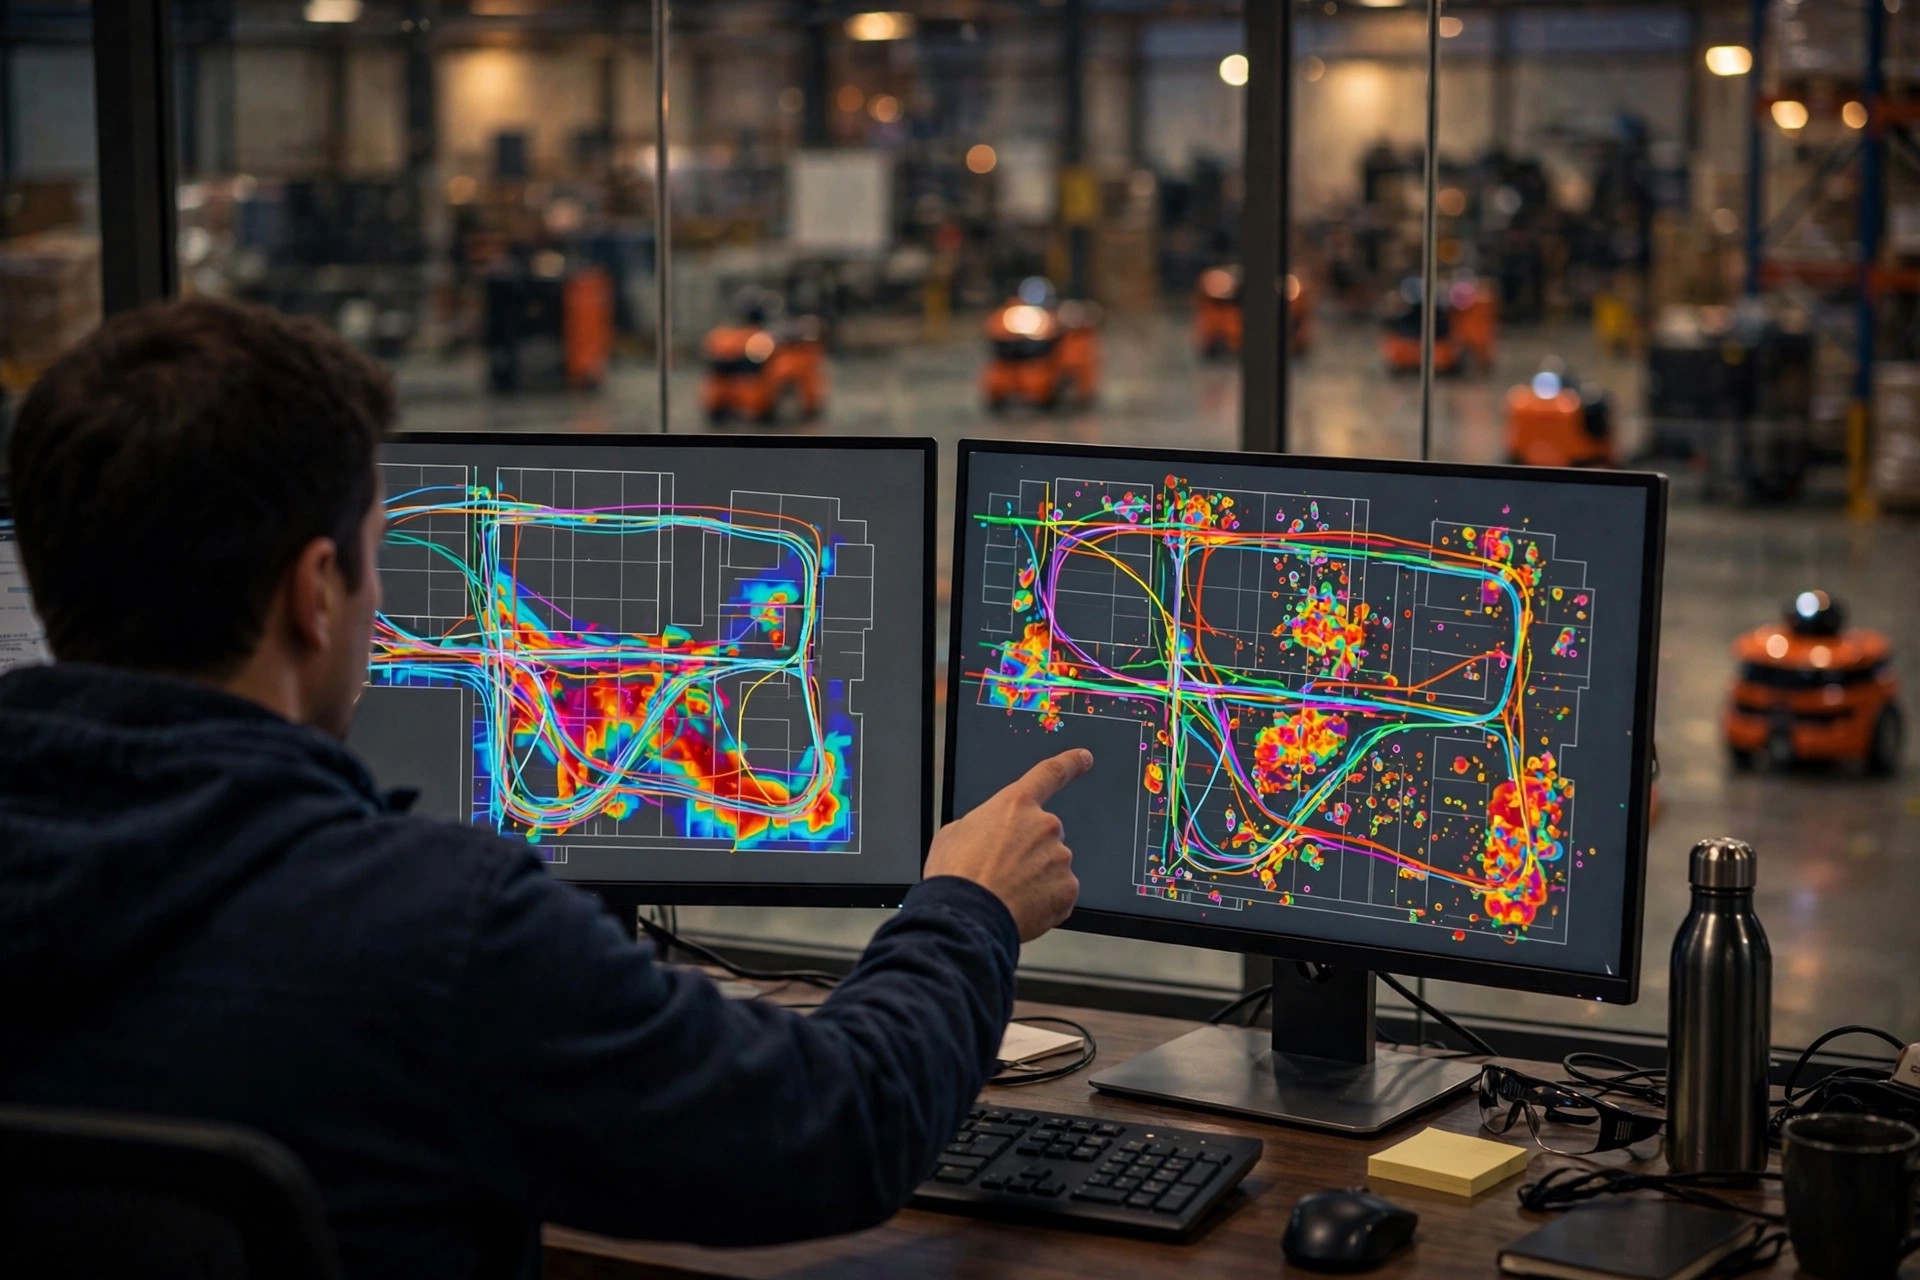
- 回放:用途经点时间戳做时空回放。大部分 RCS 自带回放工具,没有就用开源可视化自己画。先看三个指标:单任务平均时长趋势(是不是逐周爬升)、等待事件密度热力图(堵点在哪)、死锁和让行事件频次(严不严重)。
- 定位:把高等待密度的路段标出来,再交叉验证——这段路是物理太窄,还是任务流设计问题?充电区、上下料口扎堆的路段,优先怀疑后者。定位时一定要去现场看一眼,日志告诉你"哪里堵",现场告诉你"为什么堵"。
- 验证改动:调完策略再跑一周日志回放,前后对比拿数据说话。没有对照数据的"优化",等于没做。这一步最容易被跳过,也是最重要的一步。
2025 年初,华南某汽车零部件仓。2.8 米宽的窄巷道,双向 AMR 会车频繁让行,高峰期一条巷道同时挤 5 台车,互相等,谁都不让。日志回放显示,让行事件吞掉的时长占到总任务时长的两成以上。更要命的是,偶发死锁需要人工去现场挪车,一次死锁拖慢整条线近半小时。救回来的办法反常识:把该巷道改为单向环路,另一方向绕行,多走约 60 米路,任务时长反而降了近两成,死锁直接归零。多走路,更快——因为等待比绕路贵得多。这个取舍很多人转不过弯:路径最短不等于用时最短,调度优化拼的是系统总时长,不是单车里程。
这个坑我见过三次:RCS任务日志回放最容易翻车的四个点
- 时钟没对齐就分析:服务器和车端差几秒,回放出来的"拥堵"全是假的。先做时间同步对齐,这是铁律,每次开工第一步。
- 测试车没剔除:维修区门口永远"最堵",纯属噪音。清洗时建个车辆白名单,只留生产车。
- 只看一天日志:波峰波谷都看不到,至少 7 天,波峰日必须在内。工作日和周末的任务结构完全不同,只看一天等于盲人摸象。
- 分析完不落地:报告写完锁抽屉,等于白做。这个坑我见过三次,分析完不改策略的项目,最后都回到了原点。我的做法是:分析报告最后一页必须是改动清单,责任人加时间点,否则不算完工。
还有一个反常识的判断,单独拎出来说:车越多不一定越快。每加一台车,车与车之间的冲突概率都在上升,超过某个临界点,加车就是给系统添堵。我算过一笔账:一台 AMR 一年综合成本不低,加 20 台就是一笔大开支,而一次RCS任务日志拥堵分析加策略调整,成本不到加车的零头,效果却常常更好。我的经验是,八成左右的变慢案例靠调度和布局调整就能解决,根本不需要加车。决策框架很简单,先看症状再下药,对症了再动手:
| 症状 | 日志里的证据 | 正确对策 | 千万别做的 |
|---|---|---|---|
| 整体变慢 | 平均任务时长逐周爬升 | 查充电和任务分配策略 | 直接加车 |
| 局部卡死 | 某路段等待事件集中 | 改单向或分流 | 花大钱拓宽(贵且慢) |
| 波峰崩盘 | 高峰时段死锁事件暴涨 | 分时段充电加任务削峰 | 一刀切限制任务量 |
| 忙闲不均 | 任务时长方差巨大 | 调整调度权重和区域划分 | 换更贵的车 |
上线前夜 checklist:下次变慢先跑这五项
下次车队又慢下来,别急着下单买车。先做一轮RCS任务日志拥堵分析,跑完下面这份 checklist 再动手:
- 7 天完整日志拉到了吗?波峰日在不在里面?
- 时钟对齐了吗?测试车和维修车剔除了吗?
- 等待热力图画出来了吗?前三的拥堵点标出来了吗?
- 每个拥堵点,物理原因还是策略原因,分清了吗?去现场看过了吗?
- 改动方案有前后对照数据吗?责任人和时间点定了吗?
五项都打勾了再动手。这个坑我见过三次,次次都是跳过 checklist 的项目。日志不会说谎,说谎的永远是拍脑袋的决策。把RCS任务日志拥堵分析做成固定动作,车队才能越跑越顺,而不是越跑越慢。
作者:林晓|WMS 实施顾问