先算一笔账:仓库 AI 视觉模型是怎么训练出来的,直接决定这笔钱花在哪。
让一台拣货机器人学会认纸箱,需要 10 万张训练图。人工框出来,公开报价 $0.10~0.50/张,10 万张 $1 万~5 万美元——仅第一遍。三个月后换纸箱材质、灯光一变,模型认不出,再补标 2 万张,又是几千美元。
今天不讲神经网络,讲钱:三条路线多少钱、坑在哪,最后给一道代入报价的算术题。
开局先算一笔账:仓库 AI 视觉模型是怎么训练出来的,先看三条路线
视觉模型的训练数据只有三个来源:人拍的、人画出来的、机器生成的。对应三条路线——
路线一:真实拍摄+人工标注。 现场拍图,人工画框:纸箱、托盘、破损。
路线二:CAD 仿真渲染。 有零件 3D 图纸,虚拟场景"扔"零件渲染;引擎知道零件位置,标注自动生成,人工只调光照、数量、噪声。
路线三:生成式 AI 合成数据。 连图纸都不要,生成式 AI 直接"画"出带标注的仓库场景,附带纸箱压扁、沾灰、缠膜等"脏"状态。
路线一:真实拍摄 + 人工标注——最笨,也最贵,但最"保真"
这是最原始的一条路,也是今天大多数仓库视觉项目实际走的路。流程没什么花样:拍图 → 画框 → 质检 → 训练。
账:公开报价(Basic.ai)每框 $0.03~1.00、简单图 $0.10~0.50/张;按每图 4 框 $0.30/张,10 万张 $3 万,双人复核下总成本再乘 1.5~2。
2024 年昆山某 3PL 实账:2000 多 SKU、8 万张图,$0.08/框、每图 4 框,账面 8 万×4×0.08=$2.56 万,加项目管理和 15% 返工实付 $3 万出头;半年后换白色覆膜纸,识别率掉 6 个点,补标 2 万张又花小 $1 万。
路线一真相:真实数据成本不是一次性的,是订阅制。 换包装换灯换季,次次触发补标——签的不是一单生意,是长期账单。
它的优点也实在:保真。真实数据训出来的模型,sim-to-real 鸿沟最小——因为训练环境和部署环境本来就是同一个。
路线二:CAD 仿真渲染——有图纸的零件,用这条最划算
有准确 3D CAD 图纸就简单:虚拟零件"倒"进虚拟料箱,随机数量光照纹理噪声,一次渲染几百张图;引擎知道零件位置,标注零人工。
2026 年 5 月,RoboticsTomorrow 一篇讲 bin-picking 模型训练的实务文章把这条路线的定位说得很准:有准确 CAD 模型时,这是"最可靠、资源消耗最少"的一条路;工程师的时间主要花在调仿真参数上,而不是画框。
死穴有二:没图纸玩不转——老零件、供应商件、图物不符件无从下手;渲染"太干净"——真实图的油污划痕和忽明忽暗,仿真图里没有。用太干净的数据训出来的模型,一到现场就拉胯。
反常识:CAD 仿真的问题从来不是"不够真",而是"真得太整齐"。 仓库不是无尘车间,模型不怕丑,怕没见过的乱。
路线三:生成式 AI 合成数据——Zebra STRIPES 到底在解决什么问题
路线三代表作:Zebra 2026 年 9 月发布的 STRIPES 数据集。
数字:3 万张图、3000 种纸箱纹理/几何、100 万个标注框——无一出自人手,生成式 AI 边"画"图边打标。
STRIPES 三创新专砍路线二死穴:
- 生成式 AI 造图,不用静态 3D 模型。 场景多样性摆脱图纸限制。
- 仿真"磨损"。 压扁、凹痕、灰尘、缠绕膜——仿真仓库最"脏"状态,管线最值钱一步。
- 物理堆叠。 重力仿真让纸箱"自然"堆出歪斜交错的密集状态,覆盖货架、暂存、装车三环节。
这条路线回答的正是"仓库 AI 视觉模型是怎么训练出来的"这道题里,关于未来的那一半。
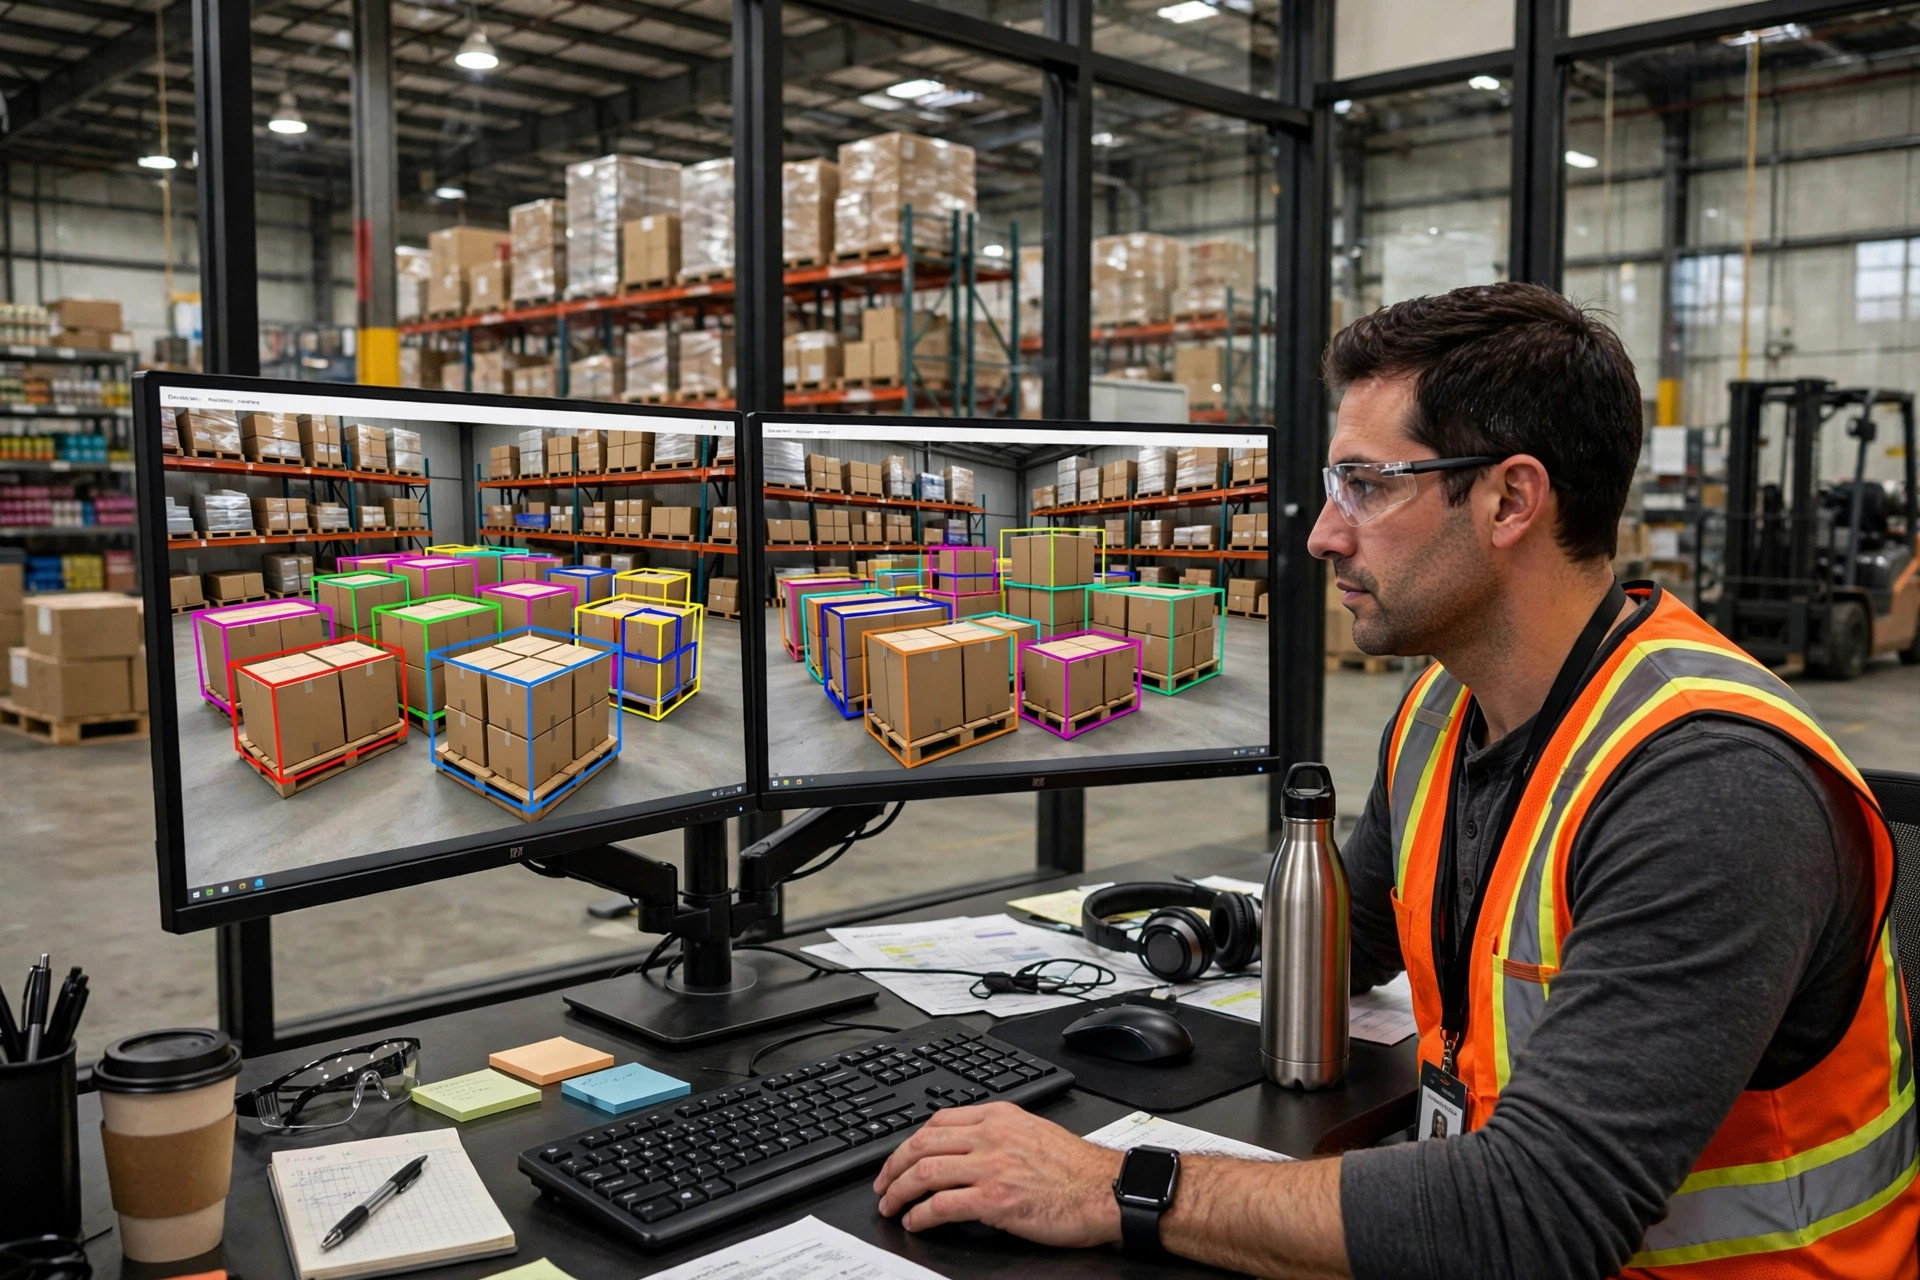
看懂了吗?STRIPES 解决的不是"合成数据像不像",而是"合成数据脏不脏"。合成数据不是越真越好,是越"脏"越好。 模型在仿真里考 99 分没有意义,有意义的是它在仿真里见过多少种"脏"。
成本视角:边际成本是算力,固定投入三条最高——生成模型、物理仿真、管线搭建全前置,小项目玩不起,大项目越用越划算。
sim-to-real 鸿沟:模型在仿真里考 99 分,到仓库为什么只剩 92?
sim-to-real 鸿沟,定义很直白:训练环境和部署环境之间的差。2026 年 5 月 roboticsandautomationnews 称弥合它为"现代机器人学最有价值目标之一"。
鸿沟多狠?2026 年 9 月案例:Telexistence 用 NVIDIA DreamZero 做便利店理货微调,干净仿真数据 45% 成功率,真实数据 0%——关节分布和状态尺度对不上。
45% 到 0%:鸿沟不在"图够不够多",在"分布对不对得上"。
TELUS Digital 的 AI 研究负责人 Steve Nemzer 在 2026 年 4 月说过一句很实在的话:"用合成数据去填具体的数据缺口,但训练要锚定在真实数据上。合成数据教不会模型传感器噪声和生产环境里的对抗条件。"
翻译成老周的话:合成数据是补丁,不是地基。 地基还得是真实数据,补丁用来填那些你拍不到、拍不起的长尾。
说到长尾,提一句:本站 2026 年 10 月 7 日有一篇《异常样本根本拍不到:用合成数据训练仓库视觉模型的实战》,专讲异常样本的合成实战。
三条路线,一张表
| 路线一:真实 + 人工标注 | 路线二:CAD 仿真 | 路线三:生成式合成 | |
|---|---|---|---|
| 单图边际成本 | $0.10~0.50/张(服务商公开报价) | 渲染算力,远低于人工 | 生成算力,远低于人工 |
| 固定投入 | 低(主要是拍图人力) | 中(管线搭建 + 工程师调参) | 高(生成模型 + 物理仿真 + 管线) |
| 10 万图量级总账 | $1 万~5 万,再乘 1.5~2 的质检系数 | 有图纸时最低,固定投入摊薄后 | 大规模下最划算,小项目回不了本 |
| 保真度 | 最高,鸿沟最小 | 中,怕"太干净" | 中高,STRIPES 正在补"脏" |
| 致命短板 | 长尾拍不到;换 SKU / 换环境要重标,成本是订阅制 | 没图纸玩不转 | 前期投入大 |
第一,数据标注行业正在被自己训出来的模型吃掉。 AI 预标注+人工复核已是标配,纯人工逐框近尾声,单价下行——现在签长期大批量纯人工单就是买在高点。
第二,最贵的数据不是标注费,是你拍不到的数据。 长尾异常样本获取成本趋近无穷大——等三个月也等不来"叉车撞散托盘"标准照。这才是合成数据真正的定价权来源:它卖的不是便宜,是"你买不到的东西"。
老周的结论:"仓库 AI 视觉模型是怎么训练出来的",答案是一道算术题
路线怎么选?别谈感觉,算。
路线一总成本 ≈ N × p × q
- N:图数
- p:单图报价(公开口径 $0.10~0.50)
- q:质检系数(含返工补标,1.5~2)
路线三总成本 ≈ F + N × m
- F:合成管线固定投入
- m:单图边际成本(算力,远小于 p)
盈亏平衡点 N*=F÷(p×q−m),N 超过 N* 合成路线划算。
示范演算(假设口径):F=$3 万,p=$0.30,q=1.5,m≈$0.05,则 N*=30000÷(0.45−0.05)=7.5 万张。
结论:图数超 7.5 万张,或 SKU 换得勤、环境变得快,合成路线值;反之老实走人工标注,别为"先进"多花冤枉钱。
这钱花得冤不冤,公式说了算。
作者:老周|物流成本分析师