一个 2 万 SKU 的退货仓,如果走传统的视觉识别路线——每个 SKU 拍 500 张训练图——那就是整整 1000 万张图。先说结论:这条路走不通。不是技术不行,是这笔账根本算不过来。
这几年找我聊视觉识别的客户越来越多,话术都差不多:"我们 SKU 太多了,传统 AI 训练数据量太大,听说小样本学习只要几张图就能认,是不是我们的救星?"我的回答也差不多:是救星,但只救得了一半的场景;另一半场景,它连门都进不去。今天就把这条分界线讲清楚。
小样本到底是个什么东西
一句话讲清:传统深度学习是"死记硬背",要把每个 SKU 长什么样从头学起,每个 SKU 都得喂几百上千张图;小样本学习(few-shot)是"认亲戚"——基座模型已经看过几千万张图,学会了形状、颜色、质感这些通用本事,你只给它每个 SKU 看 3~5 张图,它靠比对相似度来认人。
这在技术上不算新东西。学术界早就把它玩熟了:公开数据集 SKU-110K 有 1.17 万张图、170 万+个标注框、覆盖 11 万+个 SKU(CVPR 2019);2024 年还有论文专门研究只用一张原型图就做 SKU 分类。真正的变化是最近两年基座模型够强了,落地门槛才降下来。换句话说,技术早就绪了,缺的是一线的人知道它该用在哪。
什么情况下小样本够用了
我的判断标准很简单,就看两件事:容错空间,和 SKU 更新速度。
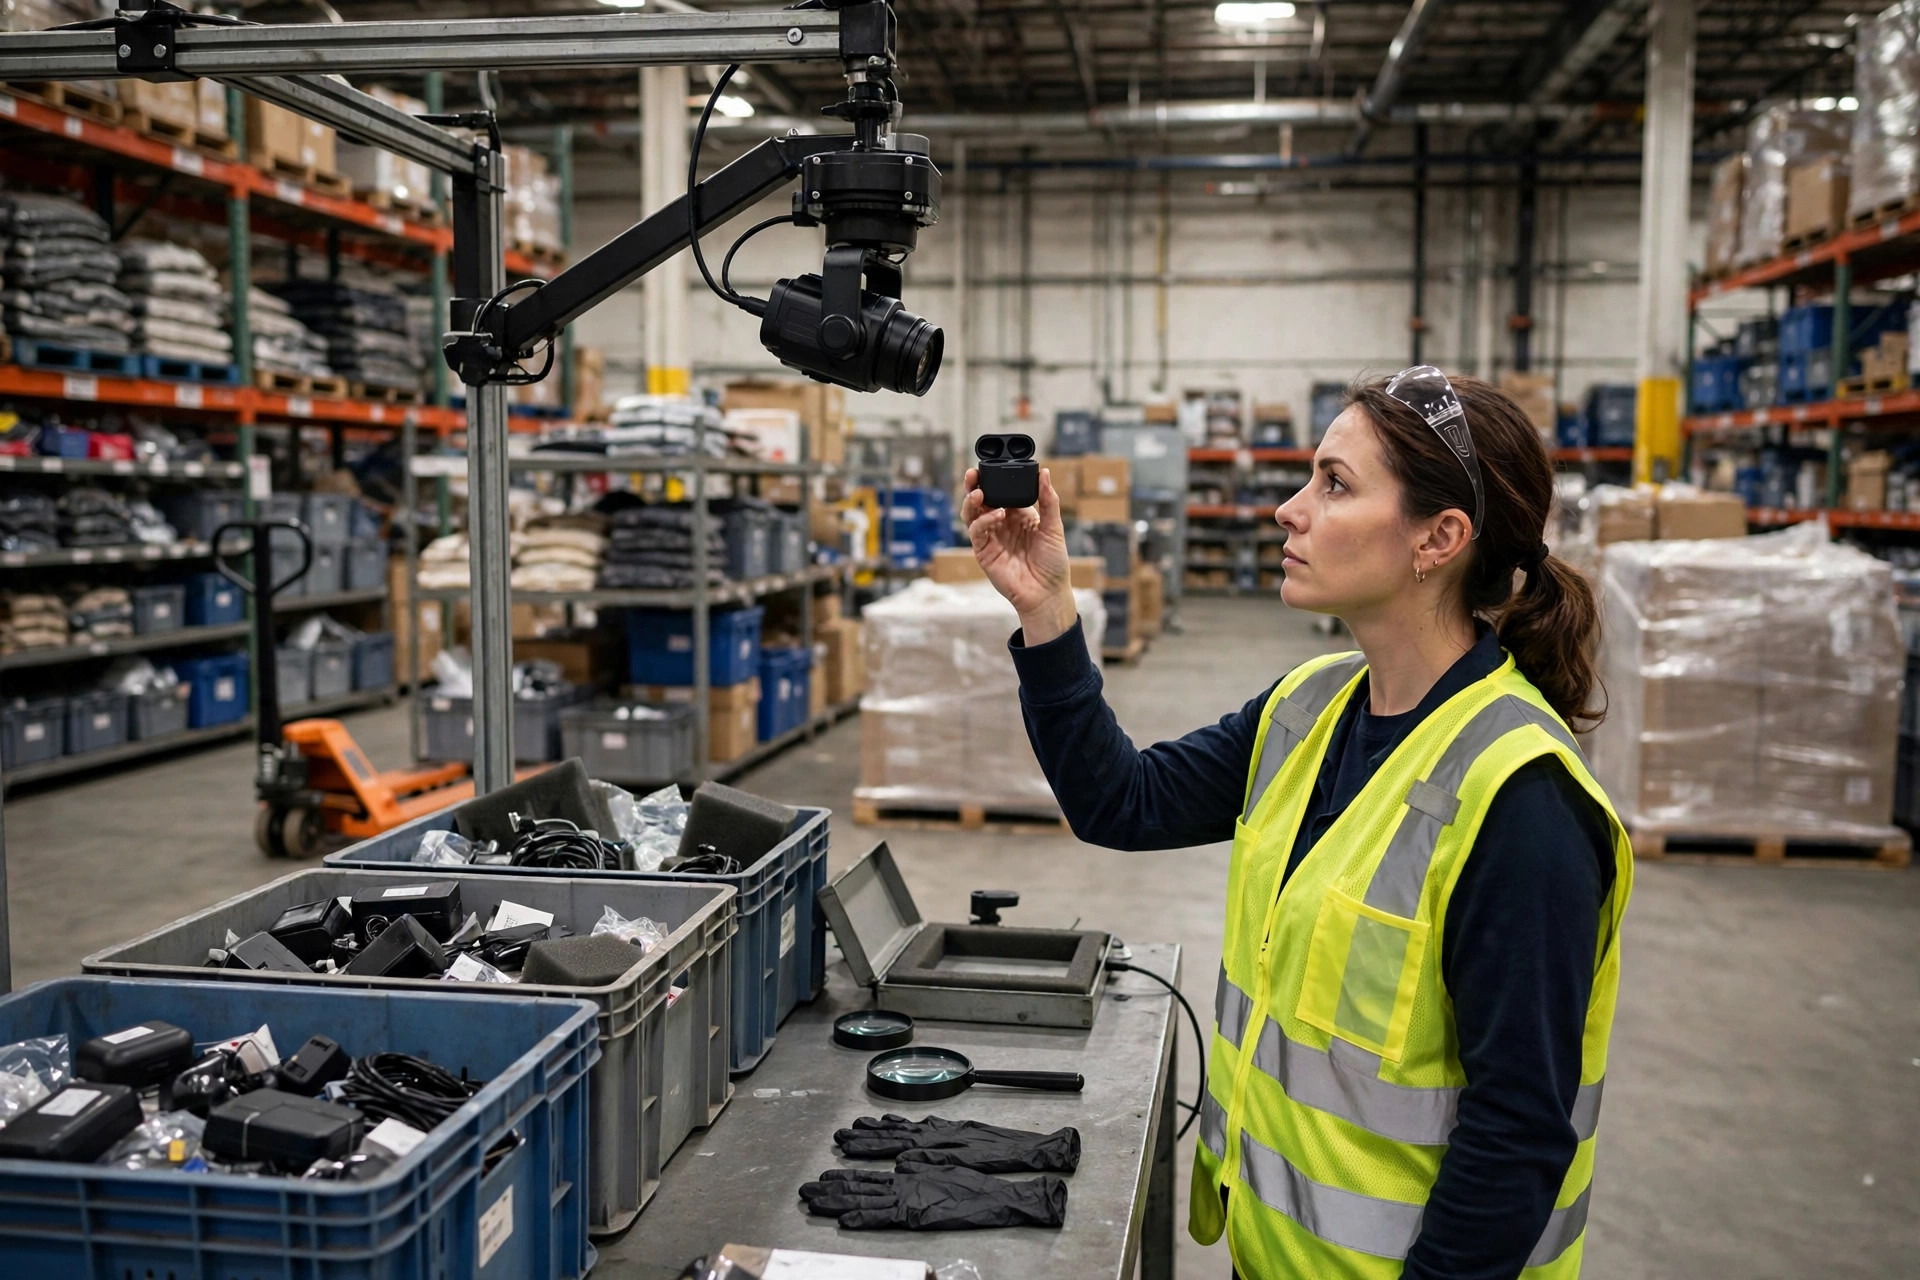
退货质检是我见过最匹配的场景。退回来的货,SKU 又杂又散,很多长尾商品一年就卖几十件,你根本不可能给它攒几百张训练图。质检员拿着货在相机前一过,系统认出 SKU、调出商品信息,质检员看一眼确认就行。认错了?人纠正一下,这张图自动回流成新样本,系统下次就认得更准。
再一个是外观分拣的辅助场景。比如跨境仓里一批无条码的裸装商品,或者条码贴歪了扫不上的,小样本视觉做"第二意见"。注意我说的是辅助——它给出候选,人或者扫码做最终确认,别让它拍板。
这两个场景的共同点:低速、低频、后面有人兜底。SKU 越多、单个 SKU 样本越少、长尾越长,小样本的相对优势就越大。传统路线在这种场景下不是"贵一点",是根本干不了——你不可能为一年卖 30 件的长尾 SKU 去拍 500 张图。
什么情况下千万别碰
先说最直接的:高速分拣线。分拣机一分钟过几百件,对准确率的要求极高(具体以实测为准),这种场景你指望一个只看过 3 张图的模型?别做梦。高速场景的老实做法是全量标注训练,或者干脆别用视觉,用条码加重量加尺寸多传感器融合。速度越快,小样本的容错空间越小,这是物理规律,不是调参能解决的。
第二个坑:长得太像的 SKU。比如同品牌同系列、只有净含量不同的两款洗发水,包装几乎一模一样,只差一个数字。小样本靠"认亲戚",恰恰在这种细粒度区分上最弱。我见过有团队在这上面栽过:模型信心满满地认错,人还得一张张复核,最后比纯人工还慢,还多花了一套设备的钱。
第三,拍摄条件不稳定的地方。仓库现场跟实验室是两回事,传送带上方装个相机,灯一闪、箱子一歪,准确率就掉。样本本来就少,一张拍糊了等于废掉五分之一的训练数据。所以小样本对拍摄规范的要求反而更高——后面我会讲怎么落地。
落地怎么干:四步走
第一步,选基座模型,别自己从头训。现在开源和商用的视觉基座模型都够用,关键是选在商品图上表现好的,而不是在通用榜单上刷分的。拿你自己的货实测,top-1 准确率以实测为准,别信厂商 PPT。这一步花两周做实测,比后面返工便宜得多。
第二步,定拍摄规范。这是整个项目里最被低估的一环:固定机位、固定光源、固定背景,每个 SKU 拍 3~5 张不同角度。样本少,所以每张都得是有效样本。我的建议是把拍摄规范写进 SOP,打印出来贴在质检台旁边,换人也不走样。
第三步,bad case 回流。系统认错的、置信度低的,自动进一个待复核队列,人确认后正确的标签回流成新样本。这个闭环跑起来,模型是越用越准的。这是小样本方案相对传统方案最大的运营优势:传统方案加一个新 SKU 要重新攒数据、重新训练;小样本加一个新 SKU,就是拍几张照片的事,几分钟上线。
第四步,永远留人工兜底。置信度低于阈值的,一律转人工。这条线不能省,省了就是事故。AI 在仓库里最好的位置永远是"副驾驶",方向盘在人手里。
算一笔账:三种路线对比
先看全量标注训练。按公开的标注服务报价,基础图片分类标注大概 $0.03~$0.10 一张(basic.ai 的行业报价指南)。听起来便宜?但别忘了采集成本:拍照、整理、质检、版本管理全是人力。2 万 SKU × 500 张 = 1000 万张,这个量级的人力投入,中小仓库根本扛不住。这条路只适合 SKU 少、极其稳定、准确率要求极高的场景。
小样本路线:每个 SKU 3~5 张,2 万 SKU 就是 6~10 万张,数据量级直接掉两个数量级。标注成本几乎可以忽略——拍照的时候顺手就把标签定了。真正的成本在基座模型选型验证和拍摄规范落地的人力上,一次性投入,后面越跑越省。
第三条路很多人忘了:条码和规则方案。如果你的商品都有规范条码,老老实实扫码,视觉识别纯属多余。我一直跟客户说:能用扫码解决的,别上视觉;能用规则解决的,别上学习。AI 解决不了管理问题——SKU 主数据一团糟、条码贴得歪七扭八,先整顿流程再谈 AI,这个顺序不能反。
退货这个场景为什么值得单独说
NRF 和 Happy Returns 的报告:2024 年美国零售退货预计达到 8900 亿美元,占零售商年销售额的 16.9%。退货仓是仓库里 SKU 最杂、人最贵、流程最乱的一块。质检员要认货、要判断成色、要决定退回上架还是报废——其中"认货"这个环节,小样本视觉是最划算的切入点,因为退货的 SKU 分布天然就是长尾的。
但有一点要提前打预防针:退货质检的难点不只是认 SKU,还有成色判断(全新、轻微使用、损坏),这部分今天的小样本模型还做不好,别被厂商忽悠。先做 SKU 识别,成色判断留给人,分两步走。一步一个坑,别想着一口吃成胖子。
明天就能动手的一件事
如果你仓里有退货质检台,明天就可以做一件事:挑 50 个最常见的退货 SKU,每个拍 5 张不同角度的照片,拿一个开源视觉基座模型跑一遍相似度检索,看看 top-1 准确率到多少。这个实验一下午就能做完,成本几乎为零,但它能告诉你:你们家这条路,到底走得通还是走不通。数据自己会说话,比听十场厂商路演都管用。