这事我站边缘侧,但有个前提:你得先分清自己的 AI 是在"看路",还是在"算命"。
看路的事,一毫秒都耽误不起;算命的事,晚一小时出结果也没人死。这个分界,就是边缘和云的分界。过去两年我看过太多仓库在这件事上花冤枉钱:要么把什么都往云上扔,网络一抖整条分拣线停摆;要么一上来就买 GPU 服务器,跑的却是每天只用跑一次的报表模型。
部署位置这件事,归根到底是三个量在打架:延迟、带宽、成本。哪个场景对哪个量最敏感,推理就该离它最近。
毫秒级的事,云端干不了
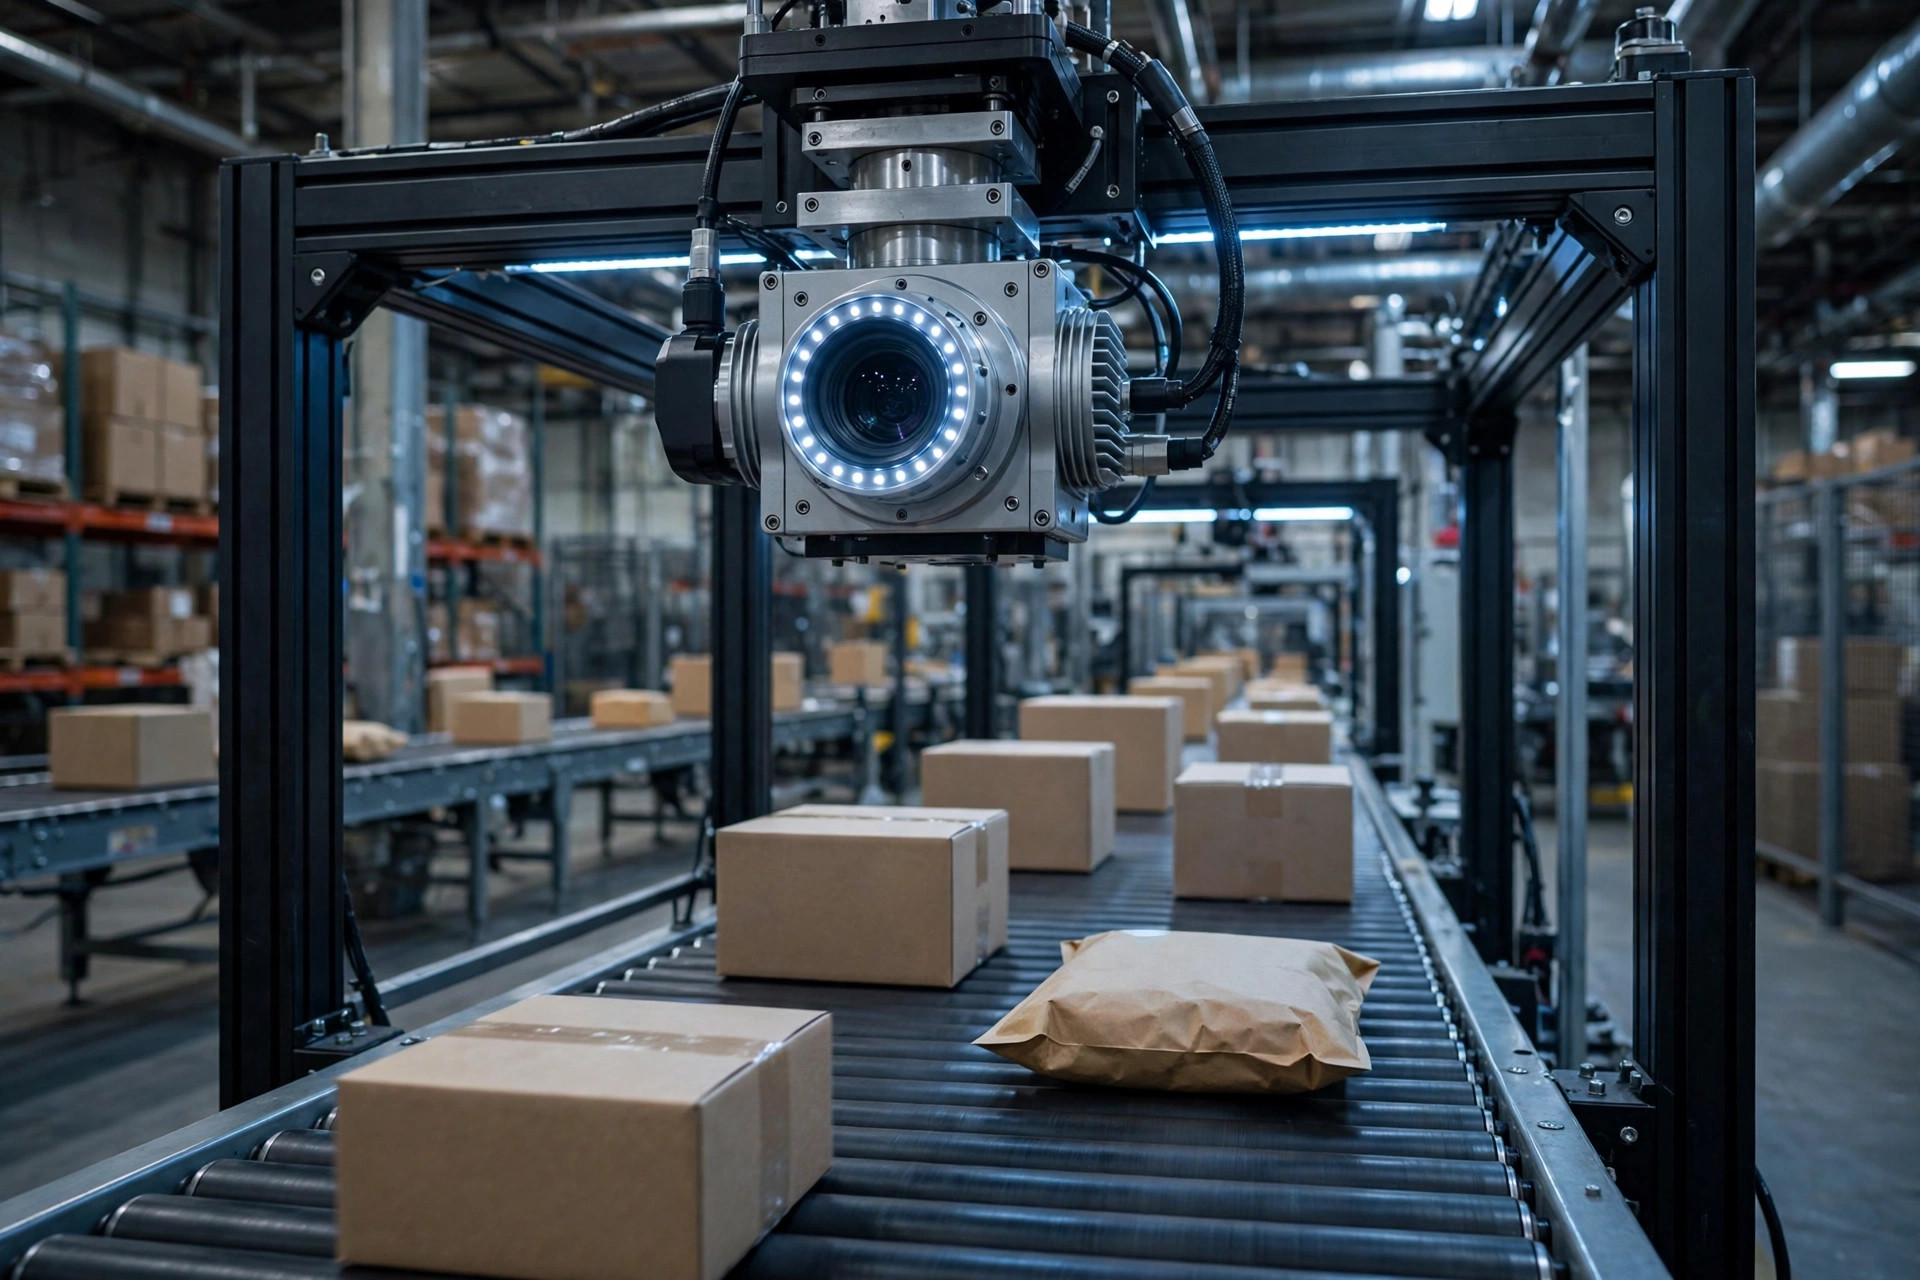
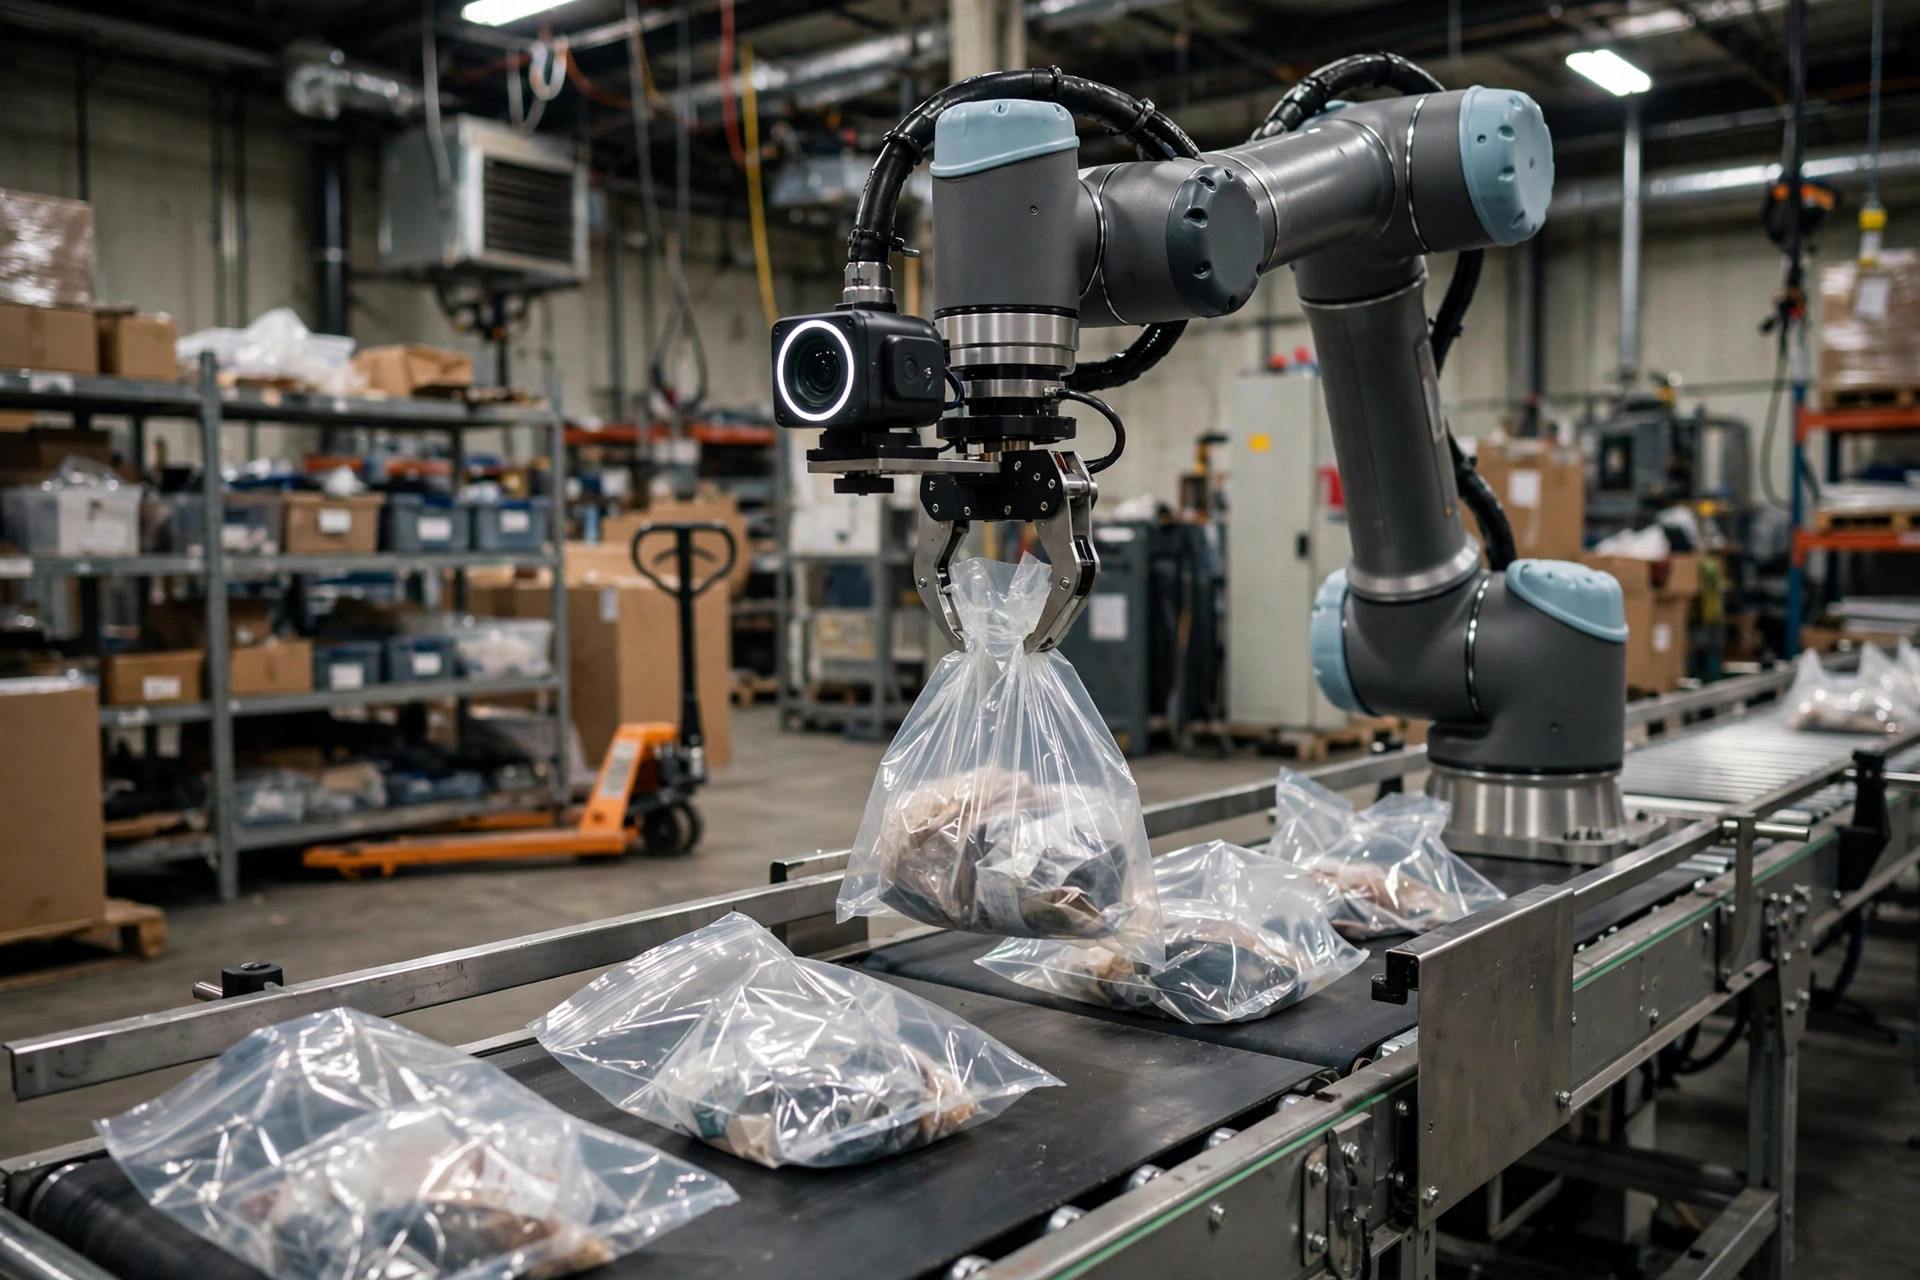
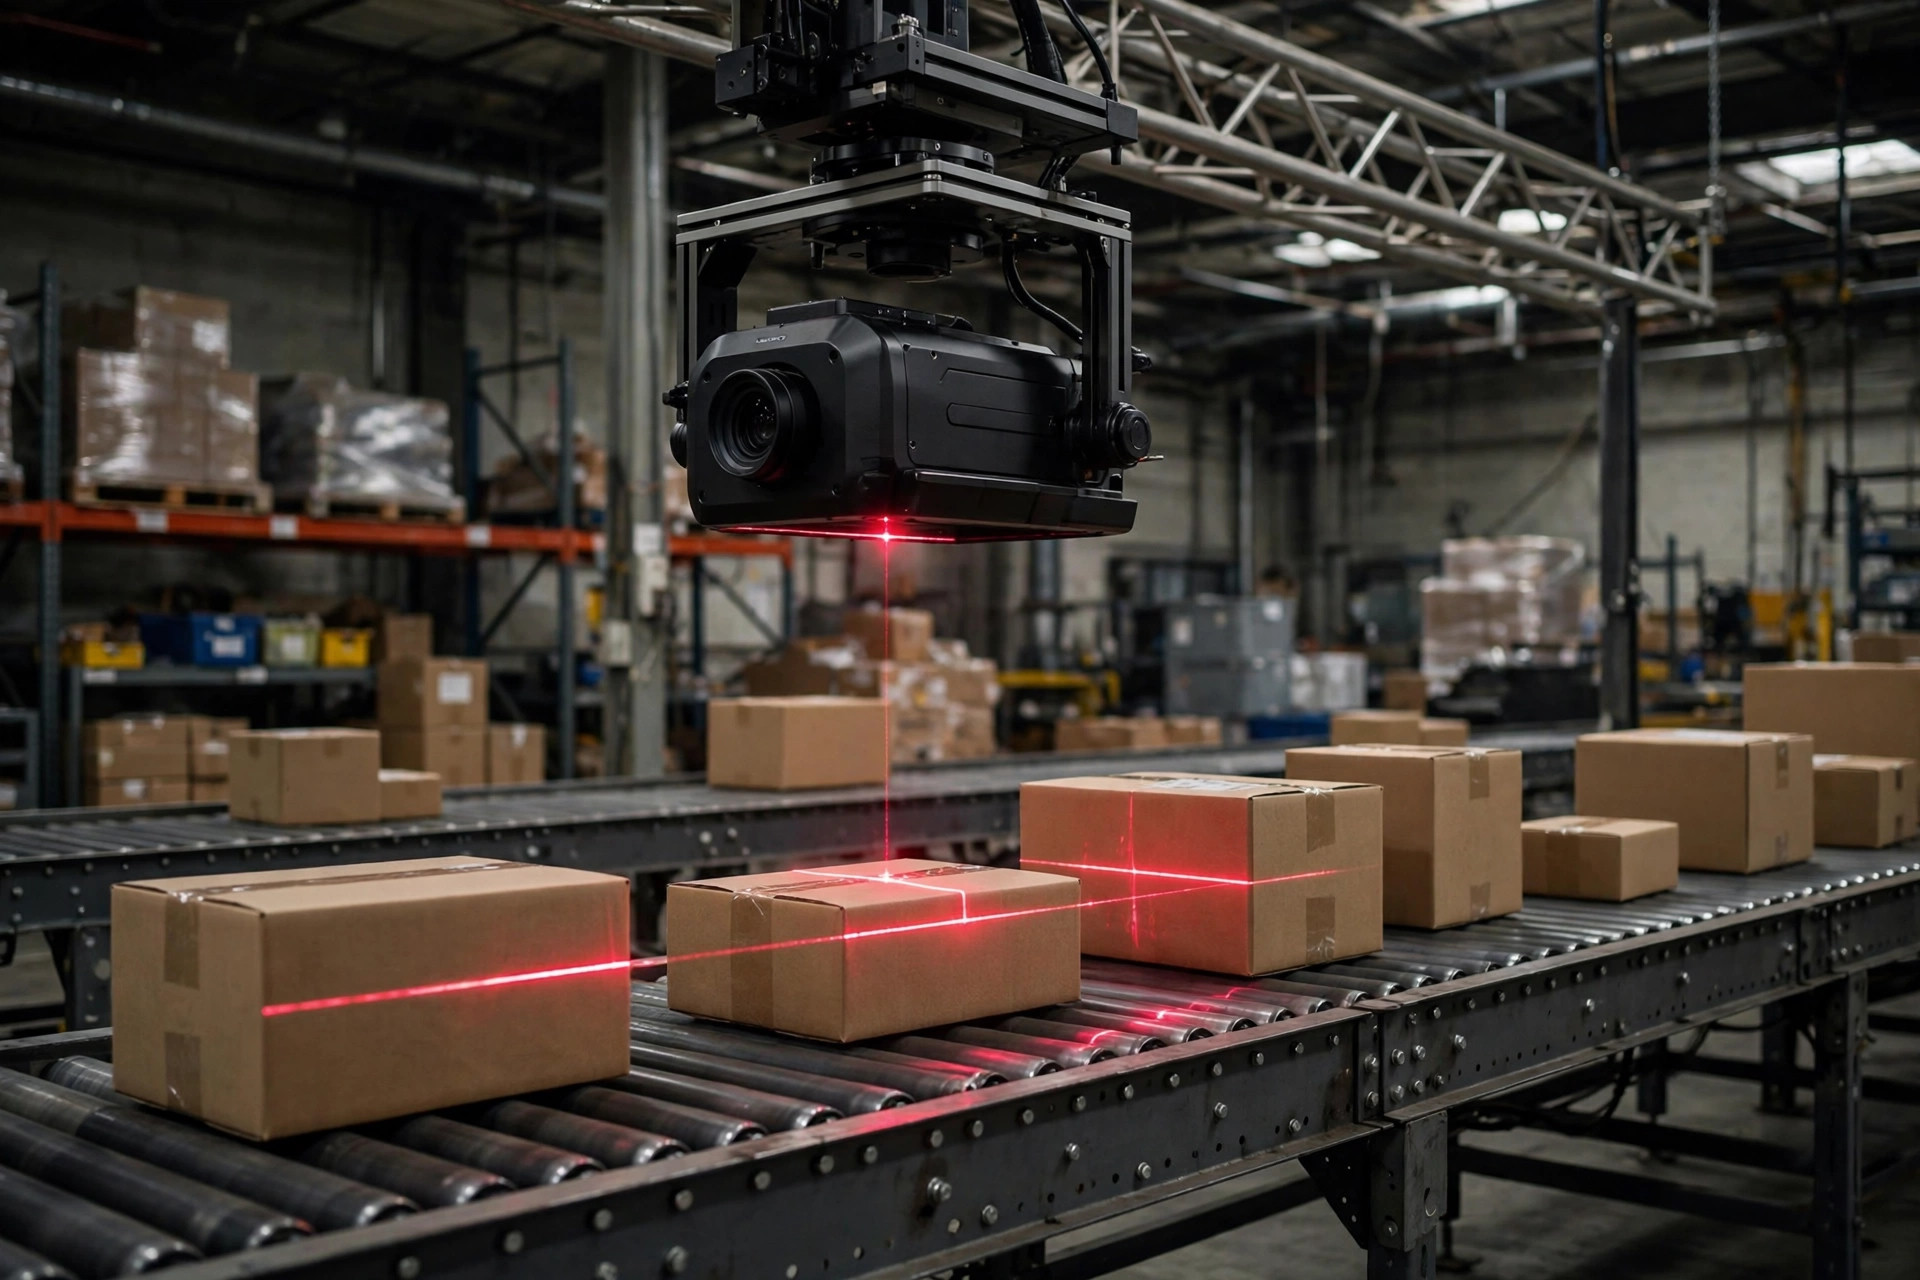
先看"看路"这一类:视觉检测、AMR 避障、机械臂抓取定位。共同点是闭环都在毫秒量级。分拣线速度动辄每分钟上百件,包裹从相机视野里经过就是一眨眼的工夫,识别结果必须在几十毫秒内回来。云端一个往返动辄几百毫秒,等结果回来,包裹早过站了,剔除气缸都不知道该往哪打。
带宽账也得算。一台视觉相机全天候回传原始图像,一天的流量轻松上到几十 GB 量级,几个点位加起来,一个月的上行带宽费用就不是小数目。更要命的是仓库的网络环境:Wi-Fi 死角、金属货架的信号遮挡、叉车碾过网线的日常,这些在办公室里不存在的问题,在仓库里天天发生。把实时推理押在这样一条链路上,等于把整条线的命交给了运气。
去年我在安大略一家 3PL 的仓库里见过反例:他们的读码相机走的云端识别,网络一抖,整条线降速到人工补扫。那天只是换了个 AP 做维护,四个小时的产能直接打了七折。老板后来跟我说了一句大实话:省下来的服务器钱,全赔进了加班费里。
AMR 避障更极端。车在跑,前面突然出现一个人,激光雷达和视觉融合的推理必须在本地完成,几十毫秒内给出刹车指令。这事要是等云端,车早就撞上去了。所以你看所有正经的 AMR 厂商,避障模型全是板载跑的——这不是技术偏好,是物理定律。
这类场景的判据就一条:推理结果直接驱动物理动作的,必须放边缘。断网了线还得照转,这条写进验收标准里。
能等的事,放云上更划算
另一类是"算命":需求预测、补货建议、安全库存测算、月度运营报表。这些模型的特点是跑一次管一天甚至管一周,晚几分钟出结果没有任何影响。放云上最大的好处不是算力便宜,而是你根本不用养算力——不用买机器、不用管散热、不用半夜爬起来处理死机。
云端的第二个好处是训练。模型训练吃的是历史数据,而仓库的历史数据天然就沉淀在云上:WMS 数据库、订单库、 人工数据都在云端,训练和迭代在云上做顺理成章。边缘设备只负责一件事:把训练好的模型拿下来跑推理,定期从云端拿新版本。
这里有个实战里最常见的混合架构,我建议小中型仓库直接抄作业:边缘做实时推理加本地缓存,断网也能独立跑;云端做训练、模型下发和全局数据分析。两边分工写死,谁也别抢谁的活。模型更新走灰度下发——先给一个点位上新版本,跑一周没异常再全量推,别搞"一键全仓升级",出问题就是全仓一起趴。
验收那天有个必选项:直接把网线拔了,看线停不停。停了,这套架构就是摆设,供应商的 PPT 写得再漂亮也没用。
数据回传策略也值得单独定一条规矩:边缘只回传元数据和异常帧,原始视频在本地滚动覆盖。视觉检测每天产生的图像里,绝大多数都是"正常通过"的废帧,全量上传纯属烧钱。正确的做法是边缘端做初筛——只把识别异常、置信度低的帧,连同时间戳和工单号一起传回云端。这样既省了带宽,又给事后追溯留了证据。云端要的是能分析的数据,不是能看的录像。
小仓别买 GPU 服务器,先搞台工控机
说到钱。很多人一听"AI 推理"就想到机房里的 GPU 服务器,动辄几万到十几万美元。我说句得罪人的话:九成的小仓库用不上。
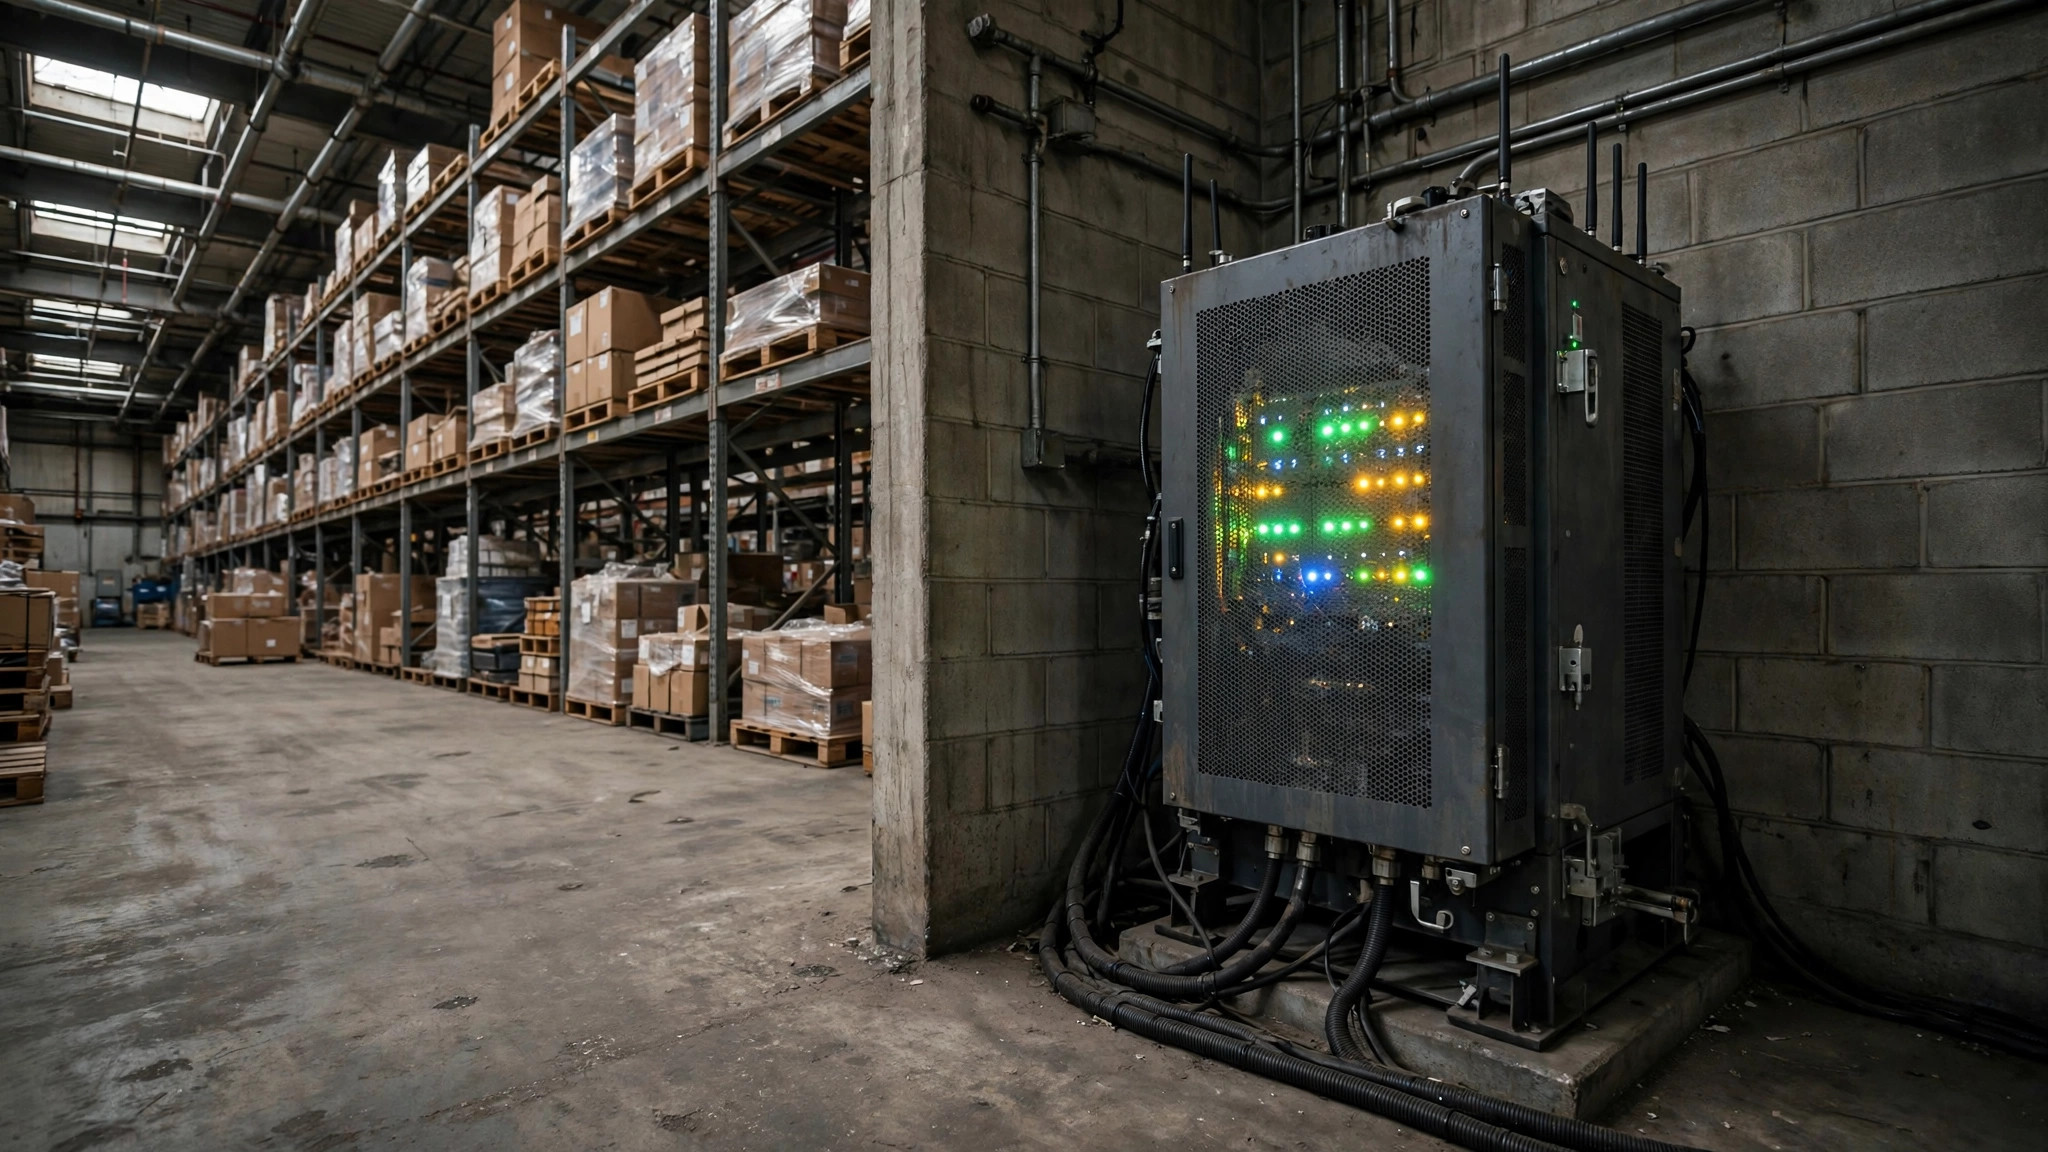
一个视觉检测点位,跑在 NVIDIA Jetson Orin Nano 这种级别的边缘设备上就绰绰有余——2023 年发布的 8GB 版本,功耗几十瓦,能直接塞进电控柜。一台带算力的工业工控机,几千美元量级,能带两三个点位。你先拿一两个点位把 ROI 跑通:比如把人工复核的漏检率降下来,或者把分拣线的降速停机次数打掉。账算得过来,再谈扩点位、再谈服务器。
工业环境还有个细节容易被忽略:粉尘和高温。仓库夏天动辄三十七八度,粉尘无处不在,消费级设备扔进去活不过一个旺季。选边缘硬件时,宽温、无风扇、防尘是硬指标,别只看算力参数。这也是我建议从工控机起步的原因之一:它是为这种环境生的。
GPU 服务器是给谁准备的?同时跑几十个点位、或者自己训模型的玩家。你的仓库要是还没到这个规模,买了就是给机房交电费,顺便给供应商的销售提成做贡献。
还有个容易被销售话术带偏的地方:算力不是越大越好,模型要和硬件互相迁就。边缘设备上跑的模型通常要做量化和剪枝,把一个云端训练的大模型压缩到原来的几分之一,精度损失控制在可接受范围内。这一步很多供应商会帮你做,但你得知道它存在——否则下次模型一更新,体积翻倍,你的边缘设备直接跑不动,锅还不知道该找谁背。合同里最好写清楚:模型更新不得超出当前硬件的算力上限,超了供应商负责优化。
我的结论很直接:先按"看路还是算命"把场景分成两类,看路的放边缘、算命的放云上;硬件从一台工控机起步,跑通一个点位再扩;合同里把断网可用和模型体积上限写死。下次有 AI 供应商跟你谈方案,先问三个问题:推理在哪跑?断网时线停不停?模型多久更新一次?答不上来这三个问题的,方案书可以直接合上了。