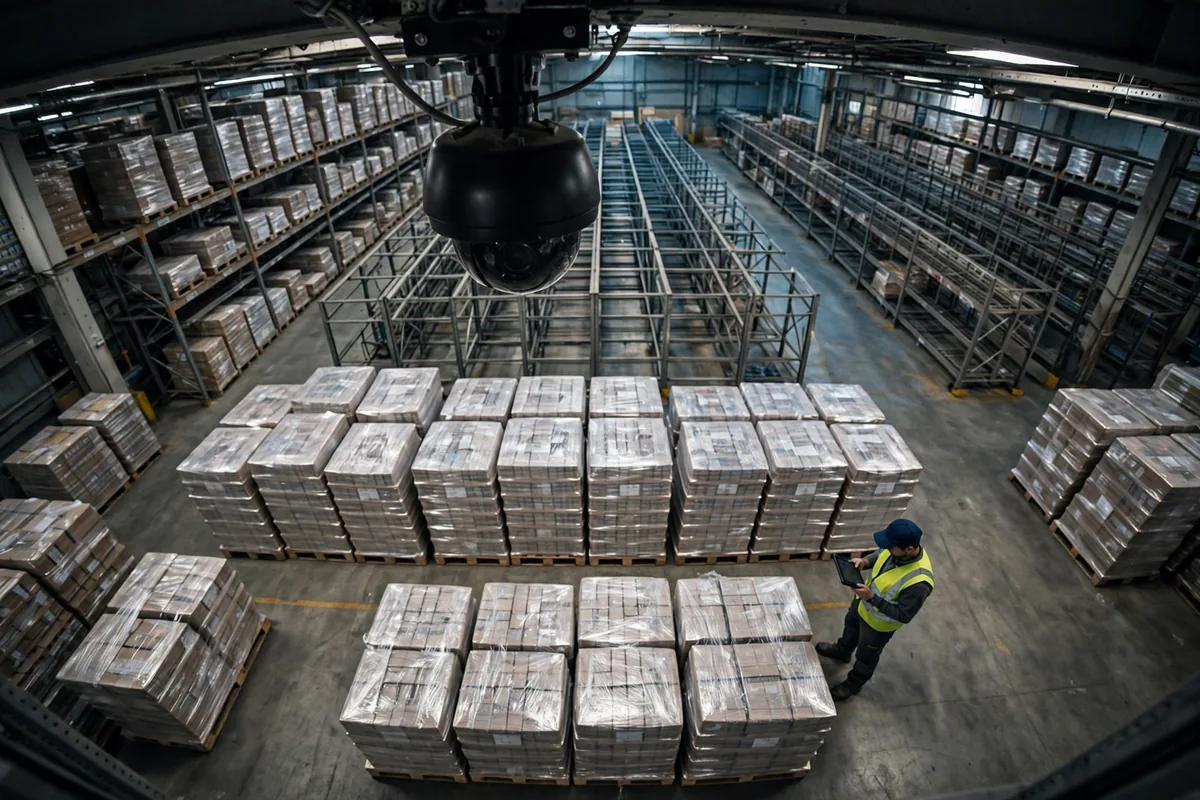
过去两年,我在三个不同类型的仓库里跟过相机数托盘的试点,结论出奇地一致:AI视觉数托盘准确率从来不是设备说明书上的一个数字,而是一组条件的产物,条件变了,同一个系统给出的结果也会跟着变。把这一点想明白,再谈要不要上视觉盘点,才不会被演示视频带偏。
我先说一个看起来最顺的现场。华东一家做日化代发的第三方仓,月台一侧装了两台固定摄像头,对着一排码放整齐的整托成品,托盘朝向一致,码垛高度基本相同,灯光明亮且没有直射阳光。盘点时叉车不动,托盘不动,相机一张张拍过去,系统数出来的托数和人工复核几乎没有出入。现场主管当时很兴奋,觉得以后夜盘可以省掉大半人力。这个场景确实是视觉计数最舒服的区间:目标完整可见、背景干净、没有运动模糊,算法要做的事接近数方块,难度本身就不高。
第二个现场就没那么好看了。同一套系统搬到华北一家汽配仓的备件区,托盘有高有矮,有的上面压着纸箱,有的只码了半层,还有几托被立柱和暂存的空托挡住一半。相机在通道一端斜着拍,远处的托盘互相遮挡,近处的托盘又因为透视变形显得比实际宽。结果系统在那个区域连续两天少算了几托,不是随机误差,而是同一类遮挡反复出现。工作人员后来补了一道人工复核,才把账面拉平。这件事说明的问题很直接:遮挡不是偶发噪声,而是一种结构性偏差,遮挡越多,漏数越有方向性,往往是系统性偏低,而不是时高时低。
第三个现场更有意思,也更值得警惕。华南一家电商仓想在出货高峰用移动摄像头跟着叉车数托,想法是边作业边盘点。现实是叉车一动,画面就带拖影,托盘在镜头里忽大忽小,系统在同一个托盘经过两个点位时一度算成两托,调低灵敏度之后又开始漏数。后来我们把做法改成叉车在指定点位停稳两秒再拍,误算立刻少了很多。这说明运动本身不是不能处理,而是要付出代价:要么放慢作业节奏,要么接受更高的误算风险,不存在既全速跑又全数准的免费选项。
AI视觉数托盘准确率在什么场景下站得住
根据这三个试点的对照,视觉计数站得住的场景有几个共同点:托盘朝向和码垛形态相对统一,视线没有结构性遮挡,光线稳定,相机与目标之间没有持续的相对运动。反过来,只要其中两项同时恶化,结果就很难再用一句还可以来概括。混合品规的散托、半托与满托混放、通道两侧堆放不规则的物料,都会让画面里的边界变得模糊,算法分不清一托的结束和下一托的开始,错误也就从个别的点变成了整片区域的倾向。
影响AI视觉数托盘准确率的四个变量
如果把影响因素拆开看,大致可以归为四类。第一是遮挡与堆叠形态,托盘被挡住三分之一以上,计数基本就靠推测,推测多了,账面就不可信。第二是光线,顶光直射造成的强反光、傍晚自然光的变化、以及出入口明暗交界,都会让同一托盘在不同时段看起来不一样。第三是运动与视角,移动拍摄和过大倾角都会放大透视误差,固定点位加停稳拍摄是成本最低的修正办法。第四是品规混杂,同一画面里既有整托又有散箱,系统要先判断什么算一托,这个判断标准一旦和仓库的实际记账口径不一致,数得再稳也是错的账。
| 现场条件 | 视觉计数的可信程度 | 更稳妥的做法 | | 整托、朝向一致、固定机位、光线稳定 | 高,可作为盘点主数据复核 | 定期抽检即可,异常再人工介入 | | 半托与满托混放、局部遮挡 | 中等,适合做预警而非直接记账 | 系统报数后按区域抽盘,差异区全盘 | | 移动拍摄、光线变化大、堆叠不规则 | 低,容易出现系统性偏差 | 先改拍摄方式,改不了就不要单独采信 |
这里还要提醒一句关于厂商说法的读法。演示现场往往是厂商挑过的库区,托盘整齐、光线充足、拍摄点位固定,拿那个结果直接套到自己的乱区,落差会非常大。我见过有仓库拿着演示里的表现去算全年省多少盘点人力,上线一个月就发现复杂区的复核工作量根本没下来,预算反而更紧张。更稳妥的读法是把厂商说法当成待验证的说法,只认自己现场跑出来的那组数。AI视觉数托盘准确率在不同仓库之间本来就没有可比性,库区形态不同,数字就不同,跨仓库比大小没有意义,同一仓库试验前后的变化才有意义。
先跑一场自己的准确率试验,再谈人机分工
根据以往试点的经验,一场可信的试验不需要很大,但必须讲规矩。先划定一块有代表性的区域,不要只挑最整齐的库区做样板,半托区、遮挡区、光线变化大的通道都要放进来。再定好记账口径,什么算一托、半托怎么折算、空托算不算,试验前写在纸上,相机和人工用同一套口径。接着连续跑几天,覆盖早班、晚班和不同的光线时段,把系统数、人工数和差异原因逐条记下来,差异要按遮挡、光线、运动、品规混杂分类,而不是只记一个总数。记录表越简单越好,一行就是一个区域、一个时段、一次比对,原因只写一类主因,写多了后面反而没法归纳。关键看的不是平均表现,而是最差的那类场景能不能接受,因为上线之后,恰恰是那类场景最先找上门。
从趋势上看,视觉计数更合理的定位不是取代人工盘点,而是改变人工盘点的工作量结构。整齐区交给相机做高频复核,复杂区仍然靠人,人的时间从逐托数数转向处理系统标出来的异常区。这种分工的好处是账面风险可控,坏处是省人力没有演示里说的那么多,管理者如果按省掉全部盘点人力去算回报,注定会失望。反常识的一点也在这里:相机最该先上的地方,往往不是最乱的库区,而是最整齐的库区,因为只有在那里,它的高频复核才是可信的,乱区硬上,只会把系统性偏差包装成自动化。
这件事往远了看,值得继续观察的不是识别算法又进步了几个点,而是仓库会不会反过来为视觉计数调整现场:统一码垛高度、留出拍摄视线、给半托定一个清晰的折算规则。现场越是为机器可读而标准化,视觉计数的边界就越宽,反过来,现场越是维持原样,视觉计数的天花板就越明显。这里面还有一层取舍容易被忽略,标准化本身也是成本,统一码垛意味着作业员要多一道整理动作,留出视线意味着一部分库位要空出来,这些成本不会出现在设备报价里,却会每天摊在作业效率上。所以现场改造的账要和设备账放在一起算,只算设备不算改造,回报还是会被高估。买设备之前先回答一个问题,可能比比选厂商更重要:我们愿意为了一台相机的视线,改多少现场习惯,而这些改变带来的日常成本,值不值得用更可信的盘点数据来换。
作者:陈博士|供应链行业研究员