先说结论:AI 落地项目翻车,至少一半不是模型不行,是数据没收拾好。这个坑我见过三次——每次都是上线前夜爆雷,每次都得停下来先补数据的课。AI 落地之前,有三类数据必须先收拾干净:主数据、业务交易数据、标注数据。收拾到什么程度算合格、每一类怎么查怎么补,下面一条一条讲清楚。
为什么数据准备是第一道门
打个比方:模型是学生,数据是教材。你给学生一套印错一半的教材,再好的学生也考不好。AI 在仓库里干的事——认库位、预测补货、答客服问题——全都建立在"系统里的数据跟现场一致"这个前提上。而现实是,大部分仓库的系统数据跟现场都有偏差:SKU 一码多物、库位条码重码、出入库靠事后补录。这些偏差人眼扫一眼能纠偏,AI 可不会,它只会把错误学得更像真的。
所以数据准备不是"顺手做一下"的前置工作,它就是项目本身。我经手的 AI 相关项目里,数据准备平均吃掉项目总工时的一半以上,预算里也要单独留三到四成给数据治理。这笔账先算在前面,免得立项时只给模型留了钱,做到一半发现数据这关过不去。
三类数据,一类一类收拾
第一类:主数据——一物一码,没得商量
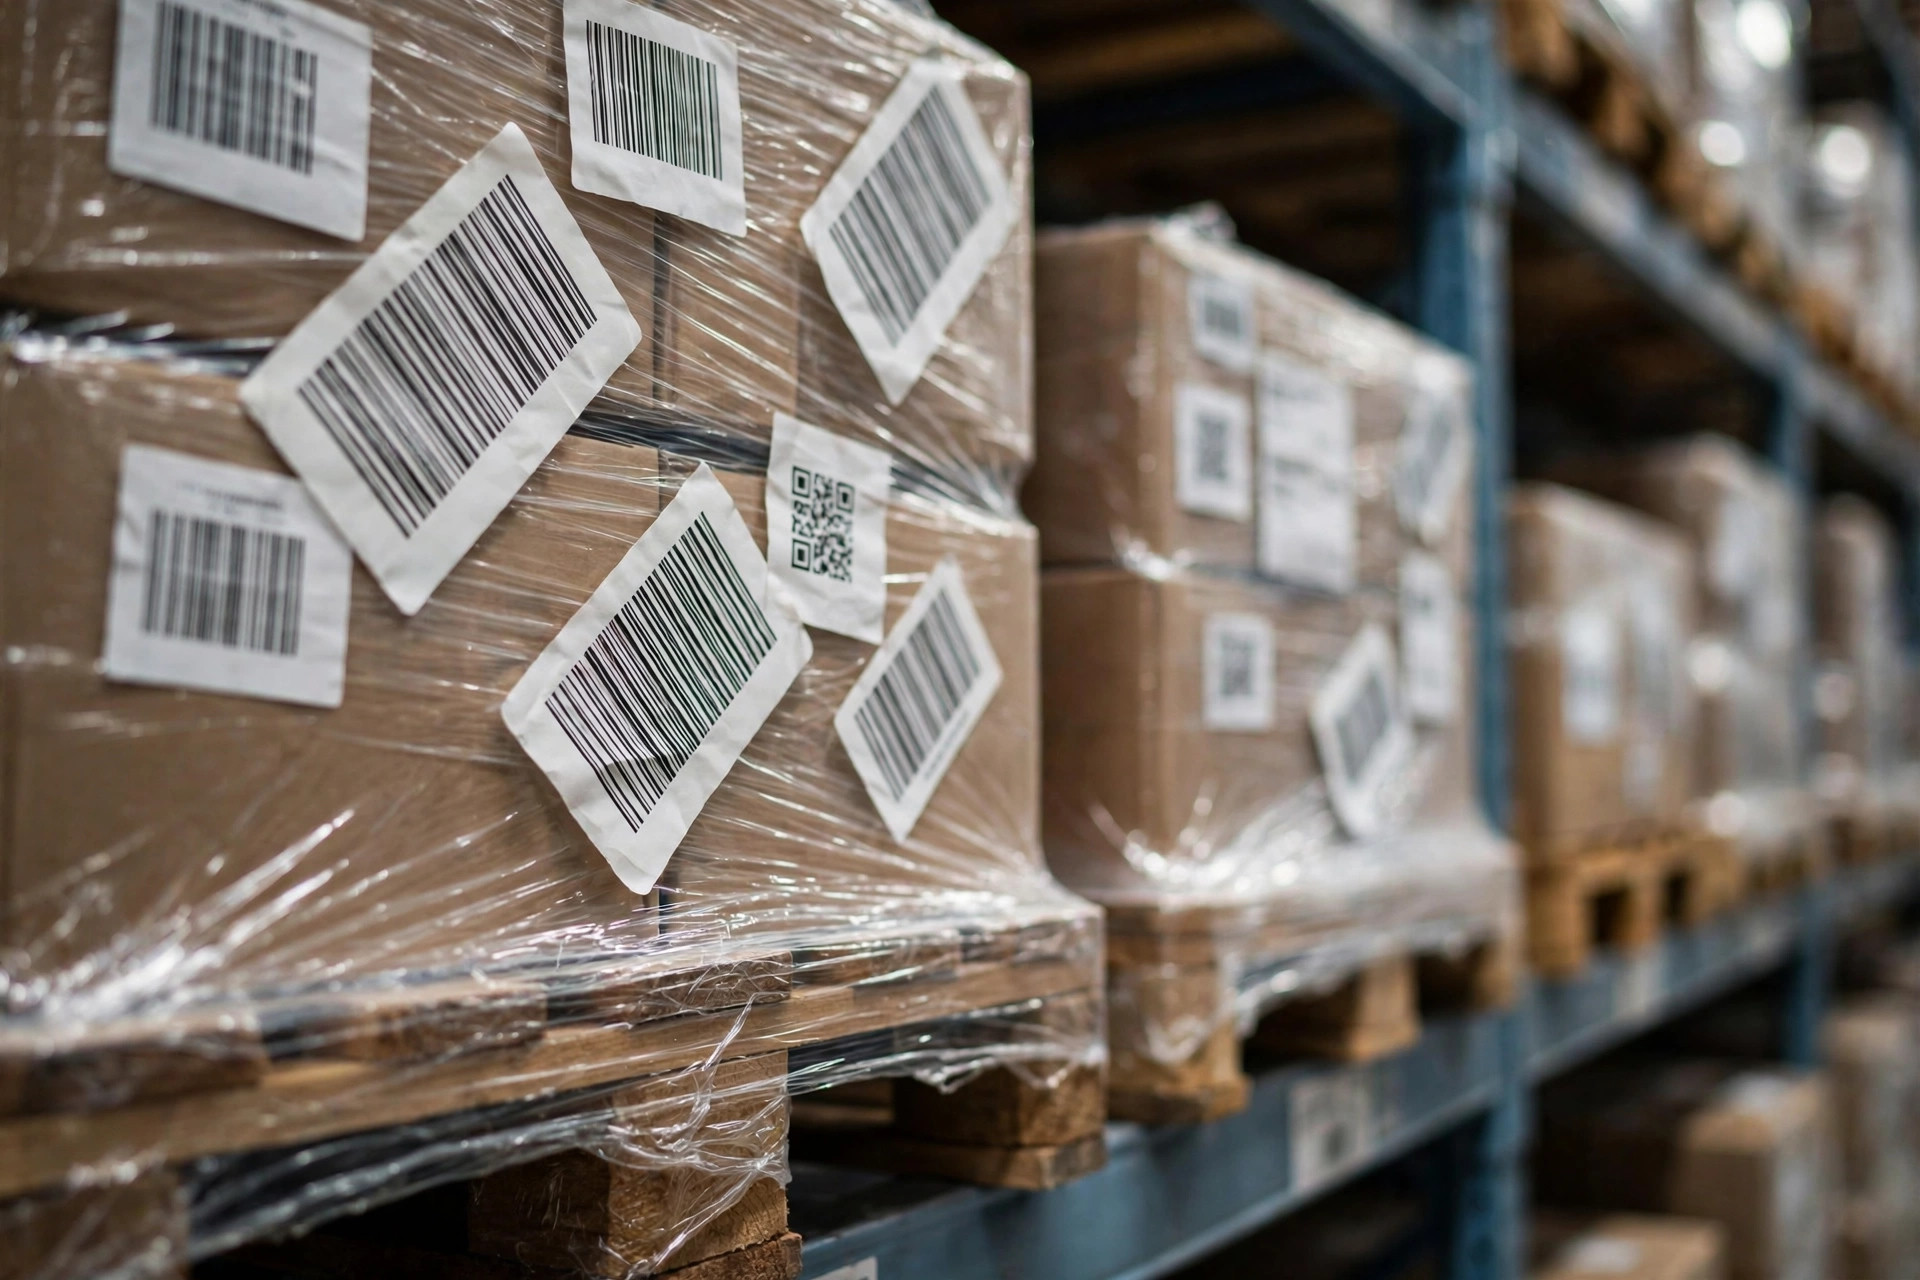
主数据就是 SKU、库位、供应商这些"字典"。AI 落地的第一要求:一物一码、一位一码,一个码只对应一个东西。
怎么查脏数据:导出全量 SKU 主档,跑三遍检查——第一遍查空码(条码字段为空或全零);第二遍查重码(同一条码对应多个 SKU);第三遍查一码多物(现场扫码,看一个码是不是贴在了两种货上)。库位同样:导出库位主档,查重码、查"幽灵库位"(系统里有、现场找不到的)。
怎么补:空码重码的,先冻结相关 SKU 的出入库,现场逐一核对后重新赋码;一码多物的,必须拆到一物一码,没有捷径。供应商主数据重点查"一户多名"——同一家供应商在系统里有三个名字,AI 做对账分析时会当成三家。
验收标准:随机抽 500 个 SKU 去现场扫码,扫码结果与系统完全一致;再抽 200 个库位,同样全对。抽检一次不过,扩大到全量核对,直到连续两次抽检全对再往下走。
第二类:业务交易数据——时间戳是 AI 的眼睛
出入库记录、盘点记录、任务记录,这些是 AI 学"仓库是怎么运转的"的教材。教材的最低要求:时间戳完整、记录不断档。
怎么查脏数据:拉最近 90 天的出入库流水,查三件事——第一,时间戳缺失或为 1970 年这种默认值;第二,未来时间戳(系统时间被改过);第三,负库存(账面为负,说明有漏记的出库)。再查"事后补录率":看多少单据的创建时间比业务发生时间晚了 24 小时以上——补录的单据时间戳是假的,AI 拿它学"波峰波谷"会学歪。
怎么补:时间戳缺失的,能找回原始记录就回填,找不回的整段剔除并标注,不要"估一个时间填上";负库存必须先盘点做平,再谈 AI;补录率高的环节(通常是退货和越库),先把流程改成实时扫码,再攒数据。
验收标准:连续 90 天出入库记录不断档,时间戳完整率 100%,负库存清零,事后补录率压到 5% 以下。达不到这个标准,预测类 AI(销量预测、补货建议)一律先别上,上了也是错上加错。
第三类:标注数据——AI 落地的弹药
视觉识别要"异常图片"(破损包装、贴错标签、空托盘),客服问答 AI 要"问答对"(客户真实问题 + 标准答案)。这类数据仓库里天然没有,得现标。
怎么查:先问三个问题——样本量够不够(视觉类起步至少几千张有效样本,问答对至少上千条);覆盖全不全(异常图片是不是只拍了白天的、只拍了一个库区的);标得准不准(找两个人独立标同一批,抽 200 条看一致率)。
怎么补:样本不够就定点采集——让现场人员两周内按清单拍照;覆盖不全就补场景(夜班、雨季室外月台这种容易漏的);标不准就写标注规范,一页纸讲清"什么算破损、什么算正常",标完抽检,抽检不过整批返工。
验收标准:抽检 200 条标注,两个人独立标注的一致率达标(视觉类建议 95% 以上,问答类 90% 以上);样本覆盖全部主要场景和班次。标注数据的质量标准,宁可写进合同附件,也别口头约定。
这个坑我见过三次:一个翻车项目的抢救实录
2025 年年中,华东一家 3PL 仓上了 AI 视觉辅助盘点:AGV 驮着相机逐排拍照,AI 识别库位条码和货物,自动比对账面。想法很好,上线第一周盘点差异率不降反升,现场怨声载道,项目差点被叫停。
问题出在哪?查了一周,根子在第一类数据:这个仓的库位条码有近一成是重码——历史上库区调整过两次,老条码没撕干净,新条码又贴上去,一个位置有两个码;再加上部分 SKU 一码多物,AI 把 A 库位的货认成了 B 库位,越盘越乱。人盘的时候,盘点员看到重码会自己判断,AI 可不会。
抢救分三步,停了整整两周。第一步,全仓一物一码治理:撕掉所有重复条码,重新赋码,冻结期间所有出入库走人工复核;第二步,SKU 主数据清洗,一码多物的全部拆分;第三步,用治理后的数据重新训练识别模型,再小范围试运行两周,差异率回到人工盘点水平以下,才全量上线。
这个项目的数据准备,吃掉了总工时的六成。教训就一句:AI 项目立项时,数据治理的工时要单独列、单独排期,别把它藏在"实施"两个字里。这个坑我见过三次,每次的剧本都一样——不是模型选错了,是开工前没人去现场扫那 500 个码。
上线前夜 checklist:数据篇
先说一句反常识的:别等数据"完美"再上 AI。完美数据不存在,先跑起来再迭代,模型会在运行中暴露新的数据问题。但三类数据的底线标准不能让:主数据一物一码、交易时间戳完整、标注有验收。底线以下,模型越跑越偏,不如不上。
上线前夜,对着这张表逐项打勾,一项不过不许切生产:
- 主数据:随机抽 500 个 SKU 现场扫码,与系统完全一致
- 库位:随机抽 200 个库位,无重码、无幽灵库位
- 交易数据:最近 90 天流水不断档,时间戳完整,负库存清零
- 补录率:事后补录(晚于 24 小时)的单据占比在 5% 以下
- 标注数据:抽检 200 条,独立标注一致率达标,覆盖全部主要场景
- 脏数据处理规则已文档化:谁负责、多久跑一次、异常升级给谁
都打上勾了再上线。明天就能做的事只有一件:先随机抽 100 个 SKU 去现场扫一遍,对不上的比例,就是你家数据准备的真实起点。
作者:林晓|WMS 实施顾问