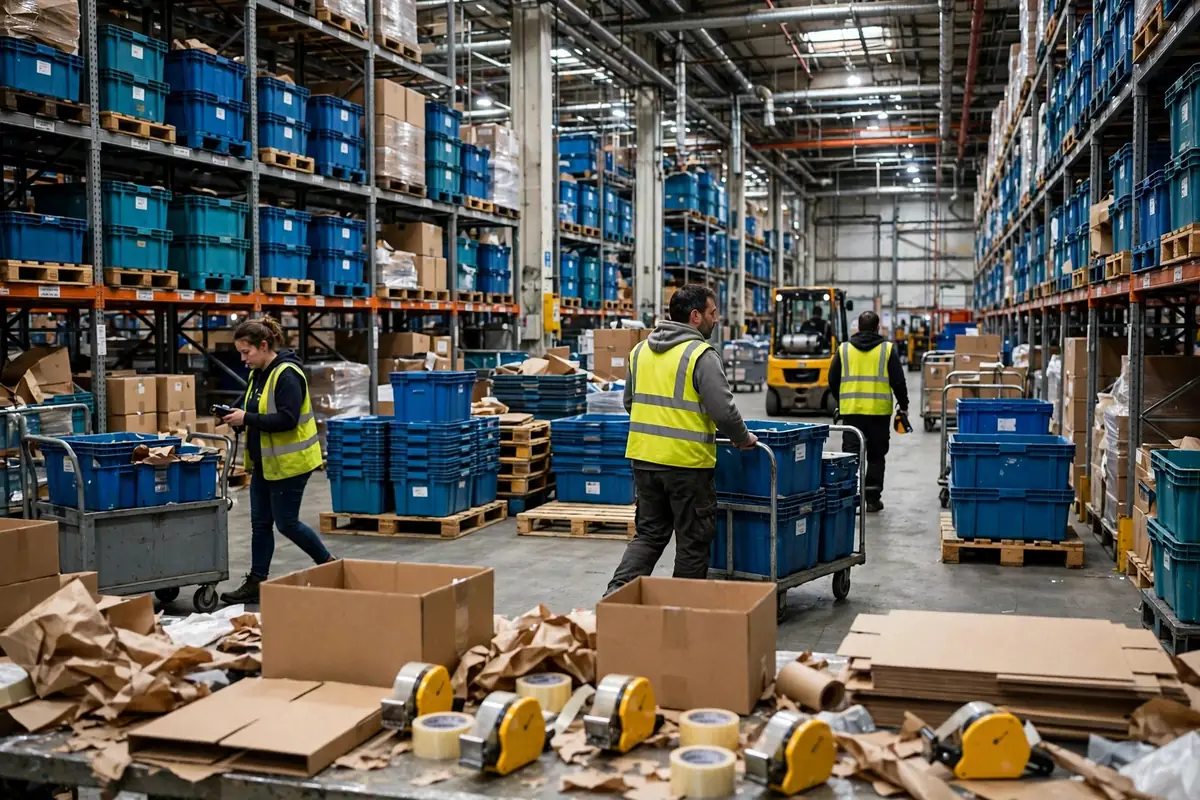
A transição de uma migração de WMS começa assim: 6:30 de uma segunda-feira de manhã, eu parado no cais de recebimento segurando duas listas de picking, uma do sistema antigo e outra do novo. É assim que parece visto do chão, e nenhum plano de projeto que eu já tenha visto captura isso.
Nosso armazém tem 200 pessoas, cerca de 8,000 pedidos por dia, até 14,000 no pico. O sistema antigo estava em uso há sete anos. As telas pareciam de outro século e os scanners travavam nos piores momentos, mas todas as pessoas do prédio conseguiam operá-lo de olhos fechados. Trocar o sistema nunca foi realmente uma questão de software. Era saber se 200 pessoas conseguiriam aparecer na manhã seguinte e fazer seu trabalho, e se os pedidos continuariam saindo pelo cais.
Dormi menos de 20 horas naquela semana inteira, mas não perdemos um único dia de expedição. Foi assim que funcionou de verdade.
Migração de WMS: as duas semanas de execução em paralelo que desgastam você
Escolhemos a execução em paralelo, não a virada de uma vez. A virada de uma vez soa corajosa: trocar tudo em um fim de semana e todo mundo estar no sistema novo na segunda-feira de manhã. Mas se algo quebrar, 8,000 pedidos quebram junto. A execução em paralelo significa que o sistema novo entra em operação enquanto o antigo continua rodando, os dois sistemas emitindo pedidos e registrando estoque, com uma conciliação toda noite.
Começamos com uma zona como piloto: a Zona B, 1,200 posições, cerca de 15% do volume diário, por duas semanas completas. A primeira semana revelou um problema real. Um SKU muito vendido tinha o tamanho de embalagem errado no sistema novo. O sistema antigo o expedía por caixa, o novo o contava por unidade, então os separadores que seguiam a tela nova pegavam uma unidade em vez de uma caixa de 24. Foram só 32 pedidos, todos detectados no mesmo dia. Troque o armazém inteiro de uma vez e 32 viram 200.
A execução em paralelo desgasta mais as pessoas do que os sistemas. Cada pedido é confirmado no sistema antigo e depois confirmado de novo no novo. É o mesmo trabalho feito duas vezes. As horas extras daquelas duas semanas nos custaram $18,000 a mais, e o moral caiu. Um veterano me disse sem rodeios: Chefe, isto é trabalhar dois dias em um. Tudo que pude fazer foi estender os turnos, colocar mais duas pessoas à noite e pôr mais frango nas marmitas. A execução em paralelo é a opção mais segura e a mais cara, e o custo se mede em pessoas e paciência. Orce isso antes de começar, não depois de descobrir.
Havia outra armadilha. Durante a execução em paralelo, as contagens de estoque dos dois sistemas tinham que bater todas as noites. Uma noite estávamos com 47 unidades de diferença. Fomos atrás até as 2 a.m. e achamos a causa nas devoluções: uma devolução tinha sido recebida no sistema antigo e ainda estava pendente no novo. Depois daquela noite criamos uma regra: durante a execução em paralelo, as devoluções passam só pelo sistema antigo. O sistema novo lê, não escreve. Dois sistemas significam o dobro do trabalho e o dobro de chances de errar, então cada processo precisa de um responsável claro.
| Padrão de transição | Como funciona | Risco | Ideal para |
|---|---|---|---|
| Virada de uma vez | Trocar tudo em um fim de semana | Uma falha para o armazém inteiro | Volumes pequenos, armazéns que podem parar |
| Execução em paralelo | Os dois sistemas ativos, conciliação noturna | Trabalho em dobro, processos podem colidir | Alto volume, não pode perder um dia |
| Por fases por zona | Uma zona de cada vez | Cronograma longo, dois processos convivem por semanas | Grandes centros com zonas independentes |
Com 8,000 pedidos por dia, um dia perdido são 8,000 clientes insatisfeitos, então a execução em paralelo era a única escolha honesta para nós. Um armazém menor não precisa dessa dor. A virada de uma vez no fim de semana é mais barata e mais rápida quando dá para assumir o risco.
Migração de WMS: limpando o terreno antes do congelamento
As 48 horas antes do fim de semana da transição importam mais do que o próprio fim de semana. Às 6 p.m. de sexta-feira, o sistema antigo parou de aceitar novas ondas. Qualquer onda pela metade tinha que ser terminada, embalada, etiquetada e levada para a área de preparação. Uma onda que não pudesse ser terminada era devolvida por inteiro às suas posições, para ser liberada de novo no sistema novo na segunda-feira. Na entrada era igual: os caminhões que chegavam depois das 4 p.m. de sexta-feira eram descarregados no cais e deixados intocados, paletes intactos, para serem recebidos no sistema novo na segunda-feira.
Naquela noite de sexta-feira caminhei pelo chão com seis líderes de equipe e contei os lugares onde sistema e prateleiras mais divergem: a zona de giro rápido, os níveis superiores das prateleiras, a área de devoluções. Todas as 86 posições da zona de giro rápido foram contadas, e encontramos 11 divergências. A maior era de 60 unidades em um SKU, um erro de contagem da semana anterior. Os paletes dos níveis altos desceram um de cada vez, foram contados e voltaram para cima. Terminamos à 1 a.m. Esta é a verdade: o quão limpa sai a transição é decidido naquela noite, pelo cuidado com que você conta.
Às 8 a.m. de sábado os dados foram congelados. O sistema antigo ficou só para leitura e a migração começou. O primeiro trabalho depois da carga foi a conciliação: total de SKUs, total de posições, total de estoque, conferência tripla. 12,000 SKUs, 8,600 posições, 430,000 unidades. Os três números tinham que bater antes de seguirmos. Um número fora, paramos e procuramos. Não se entra em produção com um ponto de interrogação no arquivo de estoque.
O fim de semana de entrada em produção e a linha de retorno
Às 3 p.m. de sábado fizemos a reunião de entrada em produção. Eu, o líder de TI, o consultor de implantação e a gerente de atendimento ao cliente. Decidimos exatamente três coisas: a que horas a entrada em produção começa oficialmente, o que conta como falha e até que horas voltamos atrás se falhar. Um plano de retorno não é admitir derrota. É a rede de segurança do cliente. Nossa linha era clara: se até as 10 a.m. de segunda-feira o volume de saída estivesse abaixo de 50% do normal, ou a taxa de envio errado passasse de 2%, voltaríamos ao sistema antigo. Quando o relógio chega à linha, ninguém pede permissão. Executa-se.
O domingo foi ensaio o dia todo. Passamos 200 pedidos reais pelo sistema novo do início ao fim: recebimento, liberação de ondas, picking, conferência, embalagem, etiquetagem, expedição. A primeira rodada foi em média 40 segundos mais lenta por pedido, principalmente pela hesitação na tela de conferência. Na terceira rodada eram 12 segundos. Bom o suficiente. Vamos.
Na segunda-feira às 6 a.m. cheguei uma hora mais cedo. A primeira onda de 800 pedidos saiu, os separadores desajeitados mas em movimento. Às 9 a.m. tínhamos expedido 3,200 pedidos, cerca de 85% de uma manhã normal. Às 10 a.m. estávamos em 5,200, acima da linha, sem precisar voltar atrás. O dia fechou com 7,600 pedidos, 400 a menos que o normal, com zero envios errados. Às 9 p.m. escrevi uma linha no chat da equipe: nenhum pedido parou hoje, obrigado a todos.
Olhando para trás, a tecnologia era talvez 30% de uma transição de migração de WMS. Os outros 70% são pessoas e timing. A execução em paralelo custa dinheiro de verdade, então orce. O congelamento exige tempo real de contagem, então proteja-o. A linha de retorno tem que estar escrita antes do fim de semana, com um relógio junto. O mais perigoso é entrar em produção com números de estoque em que você não confia, ou sem ninguém disposto a mandar parar às 10 a.m. Sistemas podem ser substituídos. A confiança de um cliente, não.
Se o seu armazém está prestes a trocar de sistema, lembre-se de três coisas. Primeiro um piloto, nunca aposte o prédio inteiro de uma vez. Limpe todos os trabalhos abertos antes do congelamento, e não entre em produção com números que não batem. E defina a linha de retorno com antecedência, e depois honre-a quando o relógio disser. Sem hesitação.
Por Chen Feng, Gerente de Operações de Armazém Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.