Em 2019, trabalhei num go-live de WMS num armazém 3PL em Ontario, Califórnia: 80.000 pés quadrados, 12.000 SKUs. Na primeira semana após a virada, a taxa de erro de separação saltou de 2% para 9%. O atendimento ao cliente ficou soterrado em ligações. O software estava bem. As integrações estavam bem. Após três dias de investigação, a equipe de implantação encontrou o verdadeiro problema: os dados migrados do sistema legado. Mais de 800 SKUs não tinham código de barras, mais de 300 tinham as unidades de medida bagunçadas (caixas e unidades misturadas) e uns 50 códigos de endereço não batiam entre o sistema velho e o novo. O proprietário gastou $400,000 num sistema novo e foi derrubado por um punhado de planilhas.
Meu veredito de cara: a limpeza de dados mestres é o trabalho de maior ROI em qualquer projeto de WMS. Não custa quase nada, e se você pular, cada dólar gasto depois vai para limpar a bagunça deixada. A maioria dos atrasos de go-live que já vi não tinha nada a ver com software. Eram problemas de dados.
Muita gente acha que migração de dados é exportar uma tabela. Não é. Os dados do sistema legado são escritos para humanos; os dados do WMS são escritos para máquinas. Uma pessoa lê "cerca de 2 caixas" e entende. Uma máquina não: unidades erradas quebram o algoritmo de ressuprimento, códigos de barras ausentes travam o fluxo de leitura, e endereços errados mandam as tarefas para o nada.
Checklist um: dados mestres de SKU, cinco campos, sem exceções
Os SKUs são a parte mais suja dos dados mestres. Percorra esta lista item por item:
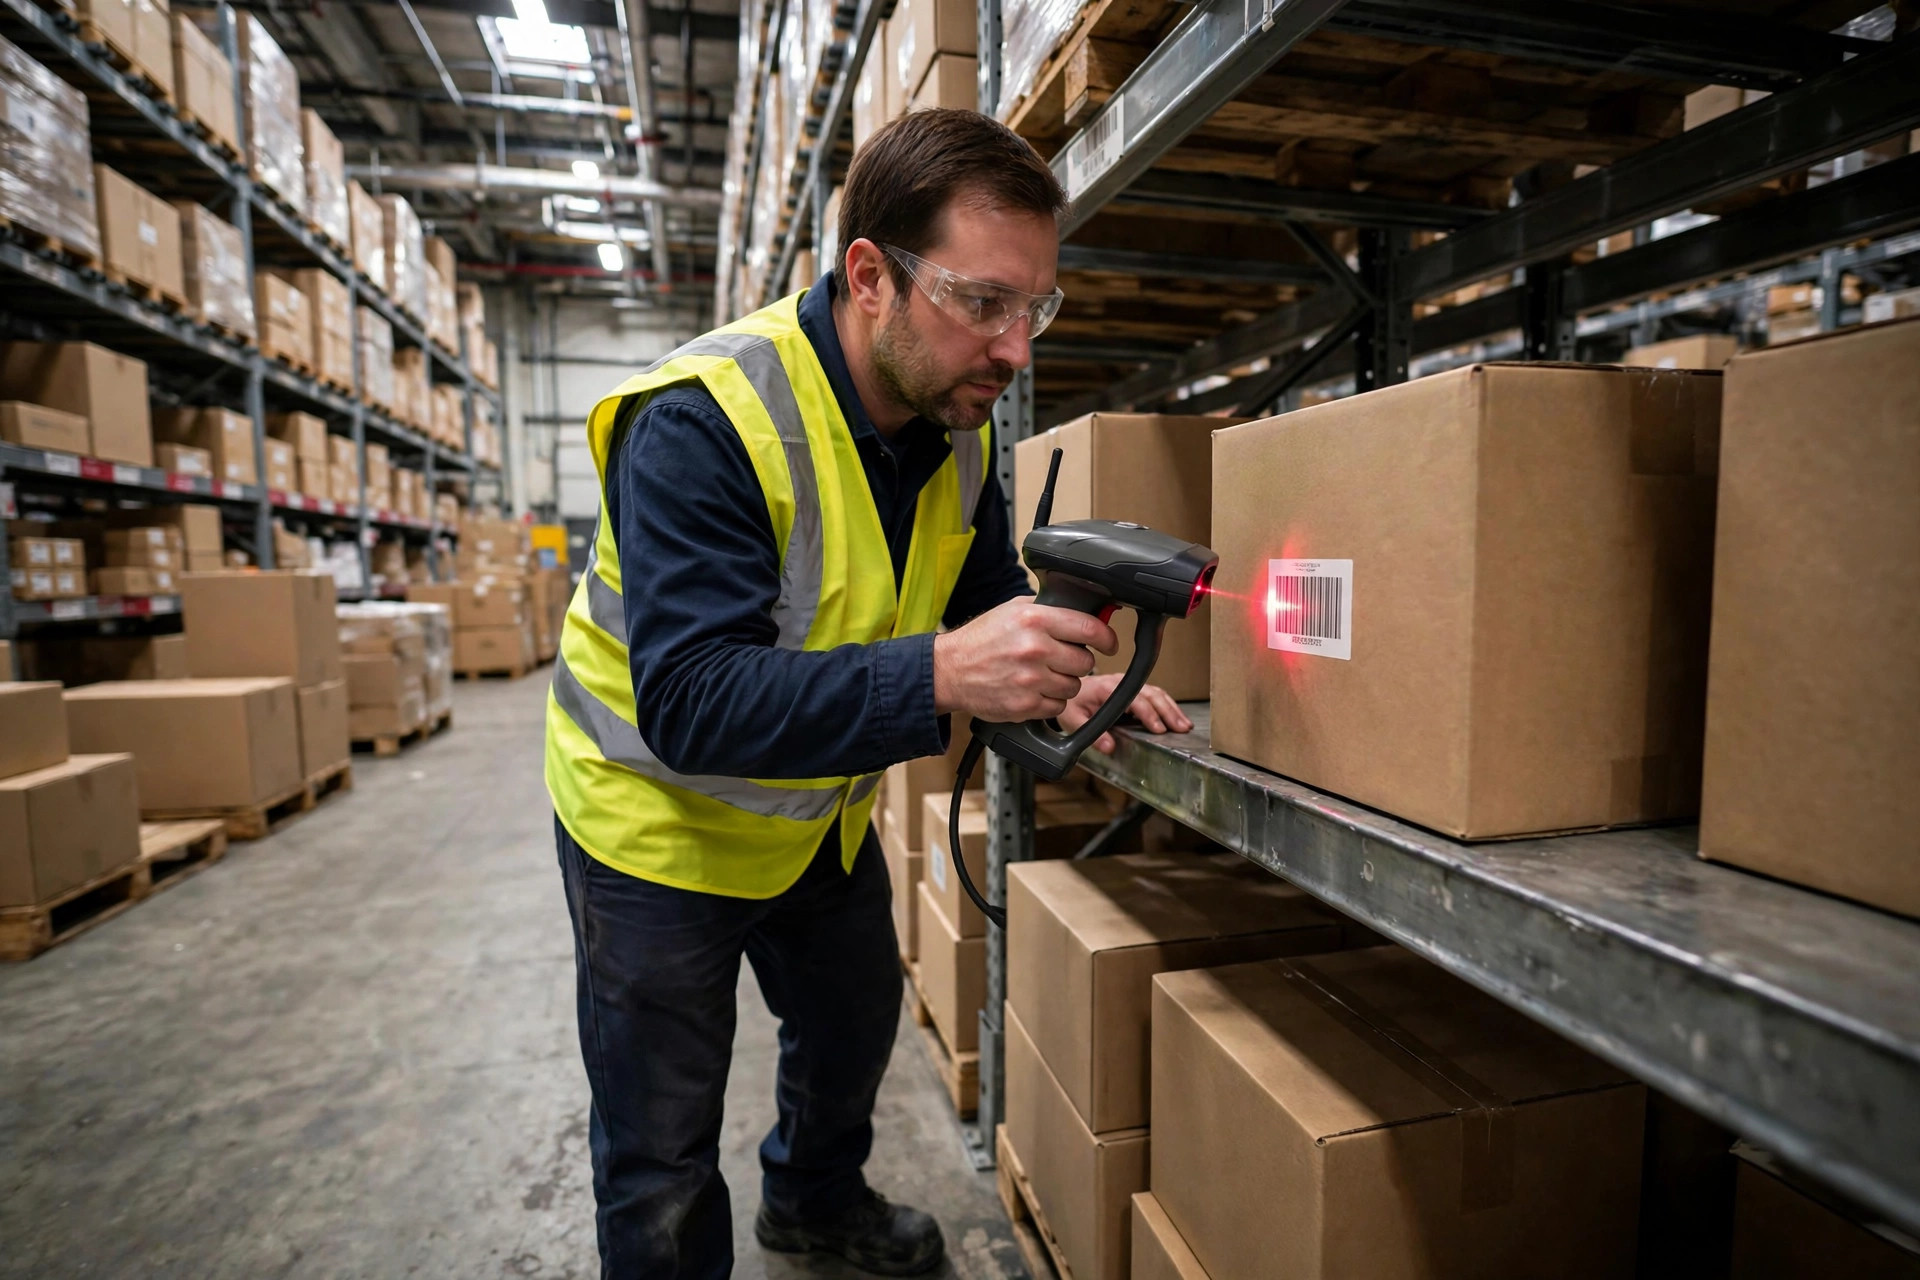
Códigos de barras. Todo SKU precisa de pelo menos um código de barras legível, um UPC ou um código interno. O pior caso que já vi: 800 de 12.000 SKUs sem código de barras, e o recebimento era feito no olho, olhando para as caixas. A solução não tem glamour, mas funciona: quatro semanas antes do go-live, puxe todos os SKUs sem código de barras e cole uma etiqueta de código de barras interno. Não diga a si mesmo que vai "adicionar depois do go-live". Depois do go-live você não terá tempo de etiquetar nada.
Unidades e conversões. Unidades avulsas, embalagens internas, caixas, paletes: cada nível precisa de um fator de conversão. A armadilha clássica é um SKU com múltiplas unidades: o compras recebe em caixas, o vendas expede em unidades avulsas, e o sistema legado só registrava caixas. Antes de importar para o WMS, preencha cada conversão "1 caixa = 24 unidades", ou toda quantidade de tarefa de separação sairá errada.
Peso e dimensões. Esses dois campos alimentam o cálculo de frete e o endereçamento (slotting). SKUs sem peso não podem ser usados na otimização de carga; SKUs sem dimensões quebram o cálculo de cubagem do motor de ressuprimento. O método prático: pese e meça 200 SKUs representativos e estime o resto por família de produto. Qualquer coisa é melhor que deixar os campos em branco.
Atributos de lote e validade. Armazéns de alimentos, farmacêuticos e cosméticos precisam sinalizar se um SKU tem controle de validade. Esse único campo decide se o WMS ativa a lógica FEFO, e mudá-lo depois significa reconstruir o processo.
Sinalização de produtos perigosos. SKUs com baterias ou líquidos são sinalizados cedo: isso determina se podem dividir zonas com mercadoria geral. Arrumar isso quando o corpo de bombeiros aparecer já é tarde demais.
Checklist dois: dados mestres de endereços, onde os endereços fantasmas são o assassino número um
Os dados de endereços são mais traiçoeiros que os de SKU porque ninguém olha para eles no dia a dia. Três itens:
Um único esquema de codificação. Os códigos de endereço antigos e novos precisam corresponder um para um. Já vi um sistema legado usando "A-01-02" contra um sistema novo esperando "A0102": a importação truncou os códigos e 300 endereços simplesmente não existiam no sistema novo. A tabela de mapeamento precisa de confirmação humana, linha por linha. Não confie no script.
Atributos de endereço. Todo endereço recebe uma etiqueta: face de separação, armazenagem a granel, área de devoluções ou área de exceção. Com atributos errados, o sistema ressupre paletes inteiros numa posição de separação de 6 pés onde fisicamente não cabem.
Elimine os endereços fantasmas. Endereços que existem no sistema mas não no armazém - ou no armazém mas não no sistema - precisam ser percorridos antes do go-live. Meu método: duas equipes se conferindo. Uma pessoa pega a lista do sistema e caça cada endereço no armazém; outra percorre o armazém etiquetando e conciliando de volta para o sistema. Duas pessoas conseguem percorrer 80.000 pés quadrados em dois dias.
Checklist três: saldos iniciais - melhor três dias devagar que um lançamento errado
Com os dados dentro, os saldos de estoque precisam estar certos. Minha regra de ferro: fazer um inventário completo de parede a parede antes do go-live, não por amostragem. Uma precisão de amostragem de 98% parece boa, mas os 2% restantes de divergências vão explodir todos como exceções de separação na primeira semana.
Use a contagem para fazer três coisas de uma vez: sinalize o estoque morto e liquide o que puder - não carregue dados lixo para o sistema novo; reetiquete o estoque antigo com números de lote fora do padrão; e isole tudo que tiver menos de 30 dias de vida útil restante para sair primeiro depois do go-live.
Meu cronograma habitual: começar a limpeza de SKUs em T menos 6 semanas, começar a caminhada física dos endereços em T menos 4, fazer a contagem completa e congelar os dados em T menos 2 (após o congelamento, o sistema legado só expede, nada é recebido), e fazer o ensaio de migração em T menos 1. Para um armazém de 10.000 SKUs, duas pessoas terminam toda a limpeza em três semanas. Compare com pular: pelo menos seis semanas de retrabalho depois do go-live, mais a confiança do cliente que você queima.
O que custa de verdade pular
De volta àquele armazém de Ontario. Dados sujos entraram em produção, os erros de separação bateram 9% na primeira semana, e na segunda semana o cliente começou a invocar as penalidades de acurácia do contrato 3PL - a maioria dispara abaixo de 98.5%. Na terceira semana, o proprietário parou toda a integração de novos clientes e colocou duas pessoas em tempo integral em três semanas de retrabalho: reetiquetar códigos de barras, preencher conversões de unidade, percorrer cada endereço.
O prejuízo: mais de $20,000 em mão de obra de retrabalho, mais de $10,000 em penalidades, um mês de atraso no projeto (mais $30,000 em honorários de consultoria). Total acima de $60,000. A limpeza pulada teria custado menos de $10,000 e duas semanas. Limpeza de dados não é custo. É a apólice de seguro mais barata do projeto inteiro.
Dados precisam de um dono
Checklists são inúteis sem donos. Nove em cada dez esforços de limpeza que emperram é porque "todo mundo está trabalhando nisso e ninguém é o dono". Minha divisão:
Dados de SKU pertencem ao compras ou à equipe de produto. Só eles sabem quantas configurações de embalagem um SKU realmente tem. Funcionário do armazém adivinhando de uma planilha vai adivinhar errado. Um dono nomeado por família de produto: a assinatura dele significa que aquele lote está pronto.
Dados de endereços pertencem à operação do armazém. É o armazém deles; só quem anda por ele todo dia consegue achar os endereços fantasmas. Líderes de turno andam, o consultor anota - não o contrário.
Saldos iniciais recebem dupla assinatura do financeiro e do armazém. Os saldos iniciais no sistema novo viram os números iniciais nos livros contábeis. Se não baterem, o fechamento do mês será miserável. Dupla assinatura significa que a operação é dona das quantidades e o financeiro é dono dos dólares.
Mais uma regra de ferro: o consultor de implantação fornece modelos e regras de validação, mas nunca é dono dos dados. Coloque no contrato que a preparação de dados é responsabilidade do cliente, ou todo atraso vira "os dados não estavam prontos" - o cartão de saída da cadeia deles.
Ensaie a migração: rode duas vezes antes da de verdade
Dados limpos não vão direto para produção. O movimento padrão é dois ensaios:
Primeira rodada, amostra de 10%, conferindo a lógica: códigos de barras duplicados, conversões de unidade em branco, códigos de endereço que o sistema novo não encontra. A validação pode ser vergonhosamente simples: um CONT.SE para códigos de barras duplicados no Excel, um PROCV contra o mapa de endereços. Simples funciona.
Segunda rodada, volume total, com cronômetro: 12.000 SKUs mais 8.000 endereços - quanto tempo leva a importação e quanto tempo leva um rollback? Esses dois números definem a janela de tempo da sua noite de go-live. Minha meta: importação completa mais validação em menos de quatro horas. Mais que isso significa que os dados ou o script precisam de trabalho antes de você marcar uma data de go-live.
Após o congelamento em T menos 2, o sistema legado só expede: sem SKUs novos, sem mudanças de endereço. Duas semanas de novos recebimentos vão para um registro manual e são lançadas no primeiro dia após o go-live. O aviso de congelamento chega a cada pessoa afetada, e a assinatura em papel é o melhor. O que você mais teme num congelamento é alguém editando discretamente o sistema velho: uma edição lá é uma divergência no sistema novo.
Uma coisa que você pode fazer amanhã: exporte sua tabela de SKUs do sistema legado e filtre de três formas: sem código de barras, sem peso, múltiplas unidades. Conte as linhas vermelhas. Esse número é a exposição real ao risco do seu projeto de WMS. Limpe primeiro essa tabela, e depois fale de datas de go-live.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.