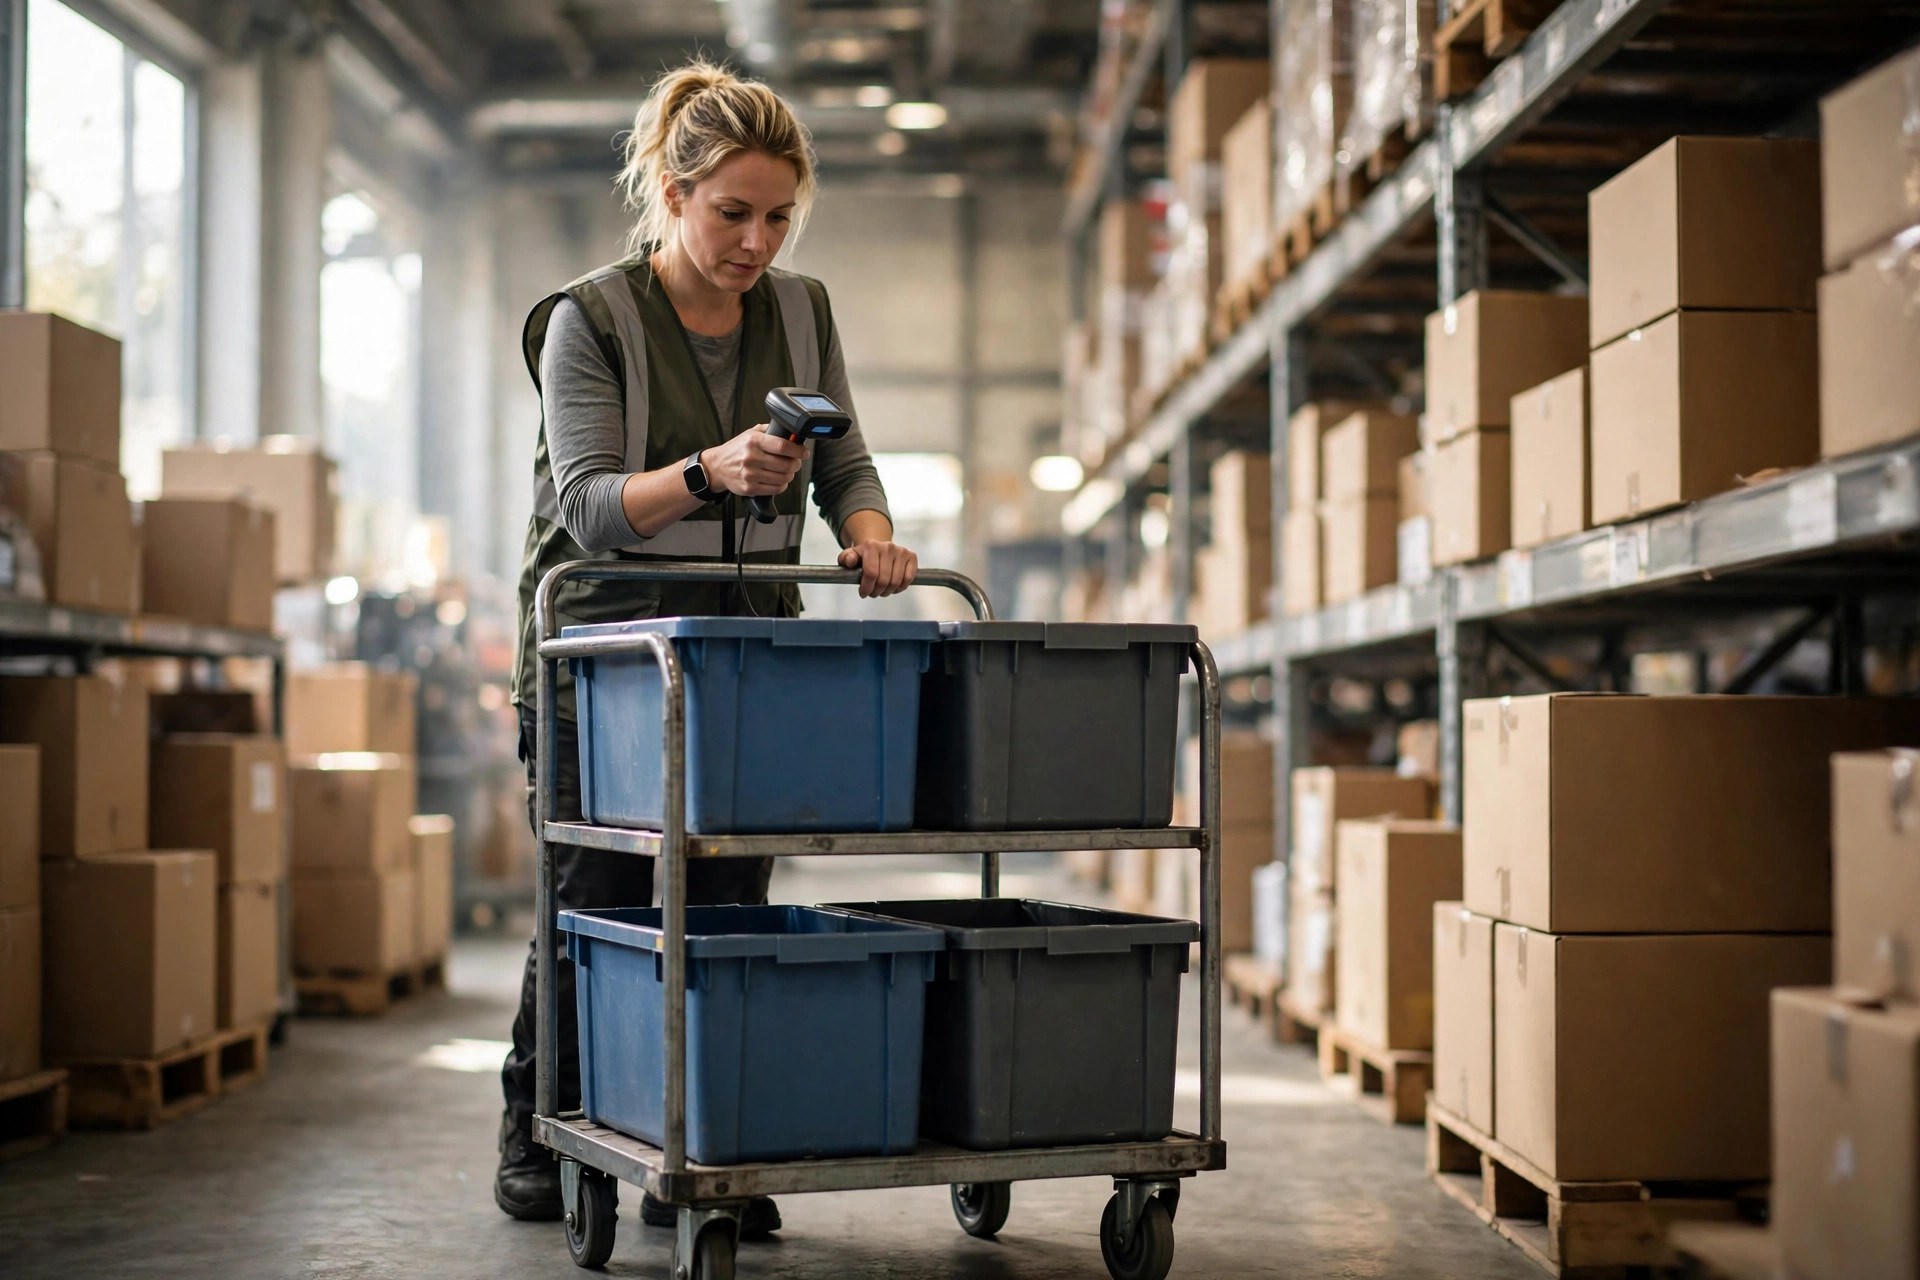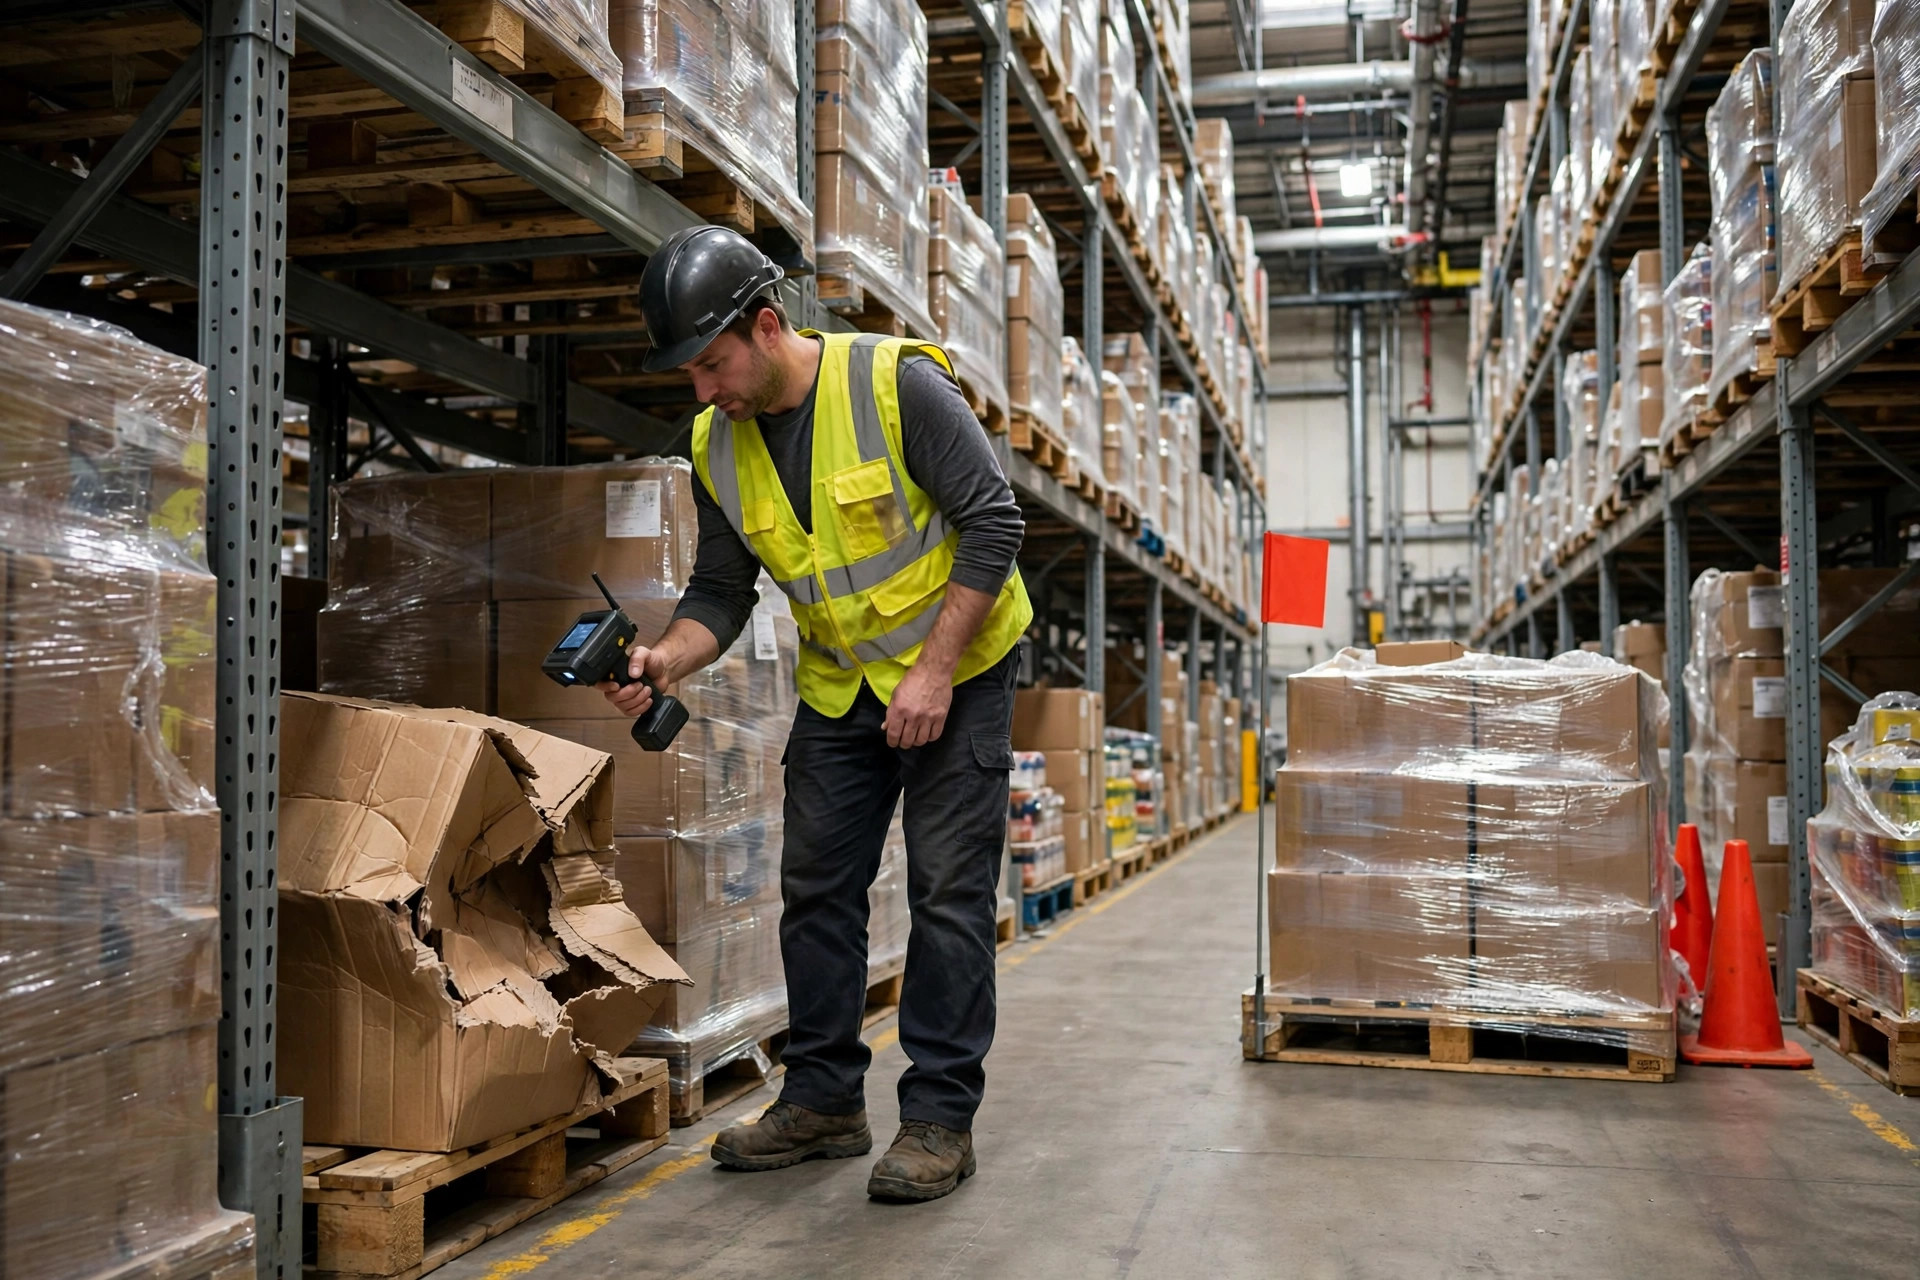
Era uma manhã de quarta-feira de março de 2024, e eu estava em um armazém 3PL de 120,000 pés quadrados em Ontario, Califórnia, vendo o WES recém-instalado deles processar sua primeira onda de um dia de pico. Um operador empurrava seu carrinho pelo corredor C-07, parou em frente a um endereço e encarou seu scanner de RF. A tarefa dizia doze unidades. O endereço tinha sete, e as etiquetas não batiam com o que estava lá. Ele digitou "short pick" e devolveu a tarefa ao sistema.
Essa parte era normal. O que veio depois, não.
O sistema, todo "prestativo", jogou a tarefa de volta direto para o pool da onda. Vinte minutos depois, outro operador recebeu a mesma tarefa, caminhou até o mesmo endereço e bateu na mesma parede. Ao meio-dia, a tarefa já tinha quicado entre três ou quatro operadores, com short pick todas as vezes, e a luz de consolidação da onda se recusava a ficar verde. Todo o lote de saída ficou esperando no doca enquanto o caminhão da transportadora buzinava lá fora — tudo por causa de uma unidade que ninguém conseguia achar.
O gerente do armazém, de pé ao meu lado no doca, me disse algo que nunca esqueci: "Gastamos uma fortuna nesse sistema, e a coisa que ele faz melhor é reenviar problemas que ele não consegue resolver."
A maioria dos armazéns se vira bem despachando tarefas pelo WES. O que realmente separa é o que acontece depois que uma tarefa dá errado — como o sistema a captura, a devolve, a redistribui e fecha o ciclo. É sobre isso que trata este artigo: a mecânica do reflow para tarefas de exceção.
A tarefa voltou para a onda. E daí?
Comece classificando as exceções em grupos. Em vinte anos, vi sempre as mesmas cinco, de novo e de novo: short picks (estoque insuficiente), rupturas (não há nada), unidades danificadas ou com flag de qualidade, divergências de leitura (etiqueta errada, endereço errado) e retenções de qualidade aguardando liberação do QC. Este passo parece trivial, mas é aqui que muitos armazéns morrem — configuram trinta códigos de motivo, os operadores apressados tocam no primeiro e todo relatório depois disso é lixo.
Para os caminhos de reflow, fico com três. Nem um a mais.
Primeiro: de volta ao pool da onda. Serve para exceções que outro operador ou outro momento pode resolver — digamos, um short pick cuja reposição já está a caminho. Mas limite o número de vezes. Naquele centro de Ontario, a mesma tarefa fez reflow quatro vezes em uma manhã. Minha regra: depois de três reflows, a tarefa se converte automaticamente em uma tarefa manual. Não se preocupe com a configuração. Uma onda que não consolida custa muito mais.
Segundo: converter em tarefa manual. Isso é para exceções que exigem julgamento humano — danos, retenções de qualidade. O ponto-chave: "manual" não pode significar "jogado numa fila que ninguém olha". Encaminhe para um time — danos vão para o QC, divergências de endereço para o time de auditoria — e mantenha visível no RF, não invisível dentro do sistema.
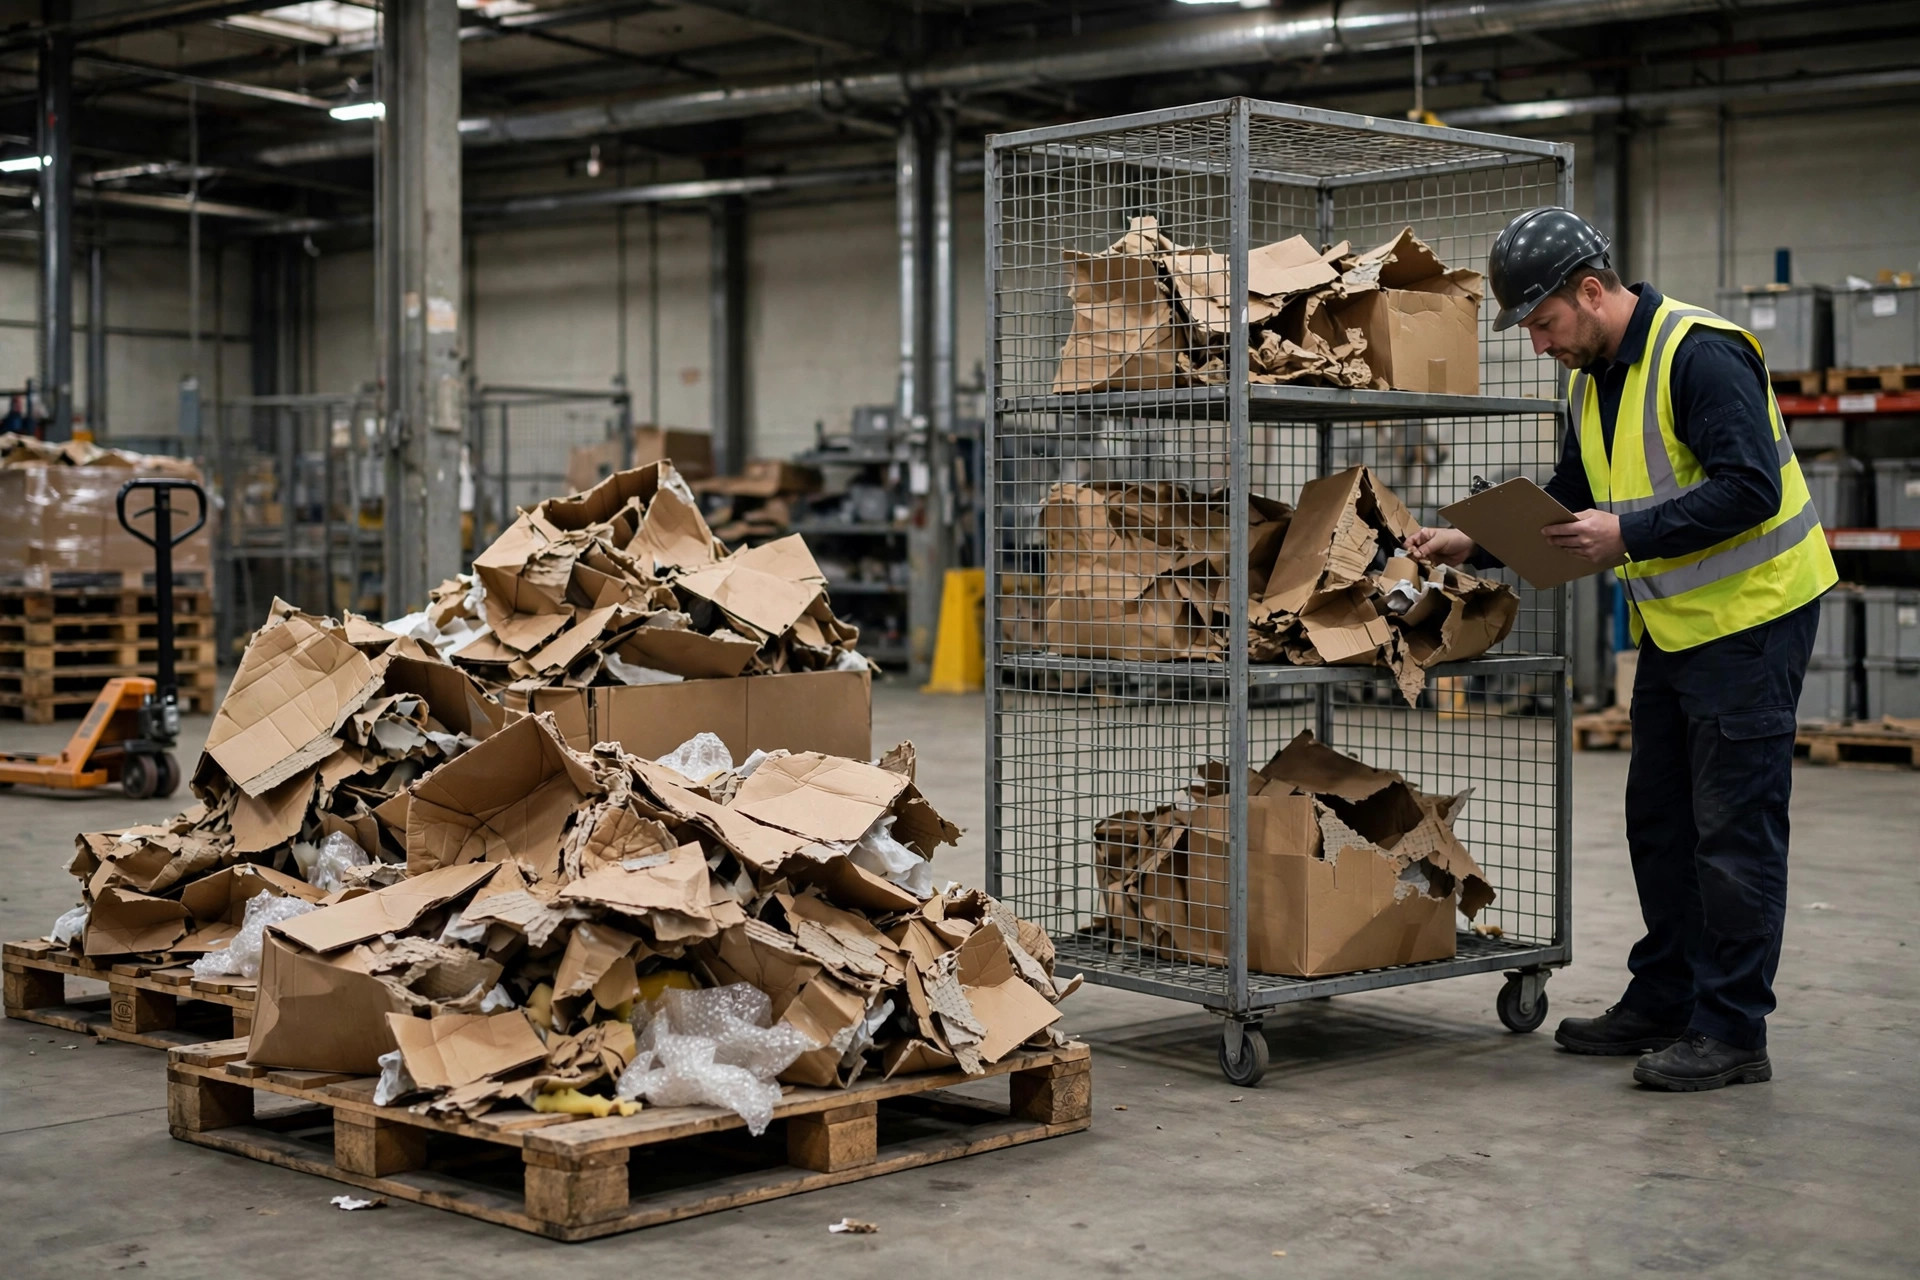
Terceiro: suspender. Isso é para o temporariamente insolúvel — um problema de lote aguardando confirmação do fornecedor, por exemplo — onde você também não pode deixar bloquear a onda. Suspensão não é exclusão: precisa de uma condição clara de despertar e um tempo máximo de suspensão, após o qual escala automaticamente.
O trade-off é real. Refazer para a onda é o mais barato, mas corre o risco do jogo da batata quente. Tarefas manuais são as mais confiáveis, mas a fila manual só cresce. Suspensão é o mais limpo, mas é fácil esquecer. Minha abordagem: predefinir o caminho padrão por motivo de exceção, para que o operador só selecione um código de motivo e o sistema encaminhe por regra. Deixe o julgamento com as regras, e o trabalho de campo com as pessoas.
Quanto tempo pode ficar sem ninguém tocar antes de virar um problema de verdade?
Reflow é só o passo um. O verdadeiro buraco negro é uma exceção parada no sistema sem ninguém olhar.
Recomendo dois níveis de escalonamento — não cinco, ninguém lembra de cinco. Nível um: trinta minutos depois de criada a exceção sem ninguém assumir, escalona para o líder de turno — pop-up no RF mais alerta no terminal do líder. Nível dois: se a exceção está bloqueando a consolidação da onda, com outras tarefas esperando por ela, escalona em quinze minutos, direto para o supervisor.
Repare que eu disse pop-up e alerta no terminal, não e-mail. Já me queimei com essa: um armazém tinha regras lindas de escalonamento que mandavam um e-mail para o supervisor a cada estouro. O supervisor recebia mais de quarenta e-mails do sistema por dia e há muito tempo tinha criado uma regra de arquivamento automático. Uma caixa danificada ficou na jaula de exceções por três dias, até um cliente reclamar de uma falta. Escalonar é roubar a atenção de alguém. E-mail não consegue roubar, então você precisa de algo mais barulhento.
Também há um trade-off aqui. Limite apertado demais e você tem fadiga de alarmes — os líderes ficam insensíveis. Frouxo demais e as exceções expiram em silêncio. Minha prática: começar apertado nos dois primeiros meses para forçar os problemas reais de processo a aparecer, depois afrouxar quando estabilizar. E mais uma coisa: registre quem reconheceu ou assumiu a exceção e quando. Sem isso, todo post-mortem termina em jogo de culpas sem placar.
Você registrou todos esses dados de exceção. O que você realmente olha?
Muitos armazéns registram montanhas de dados de exceção do WES, depois abrem o relatório e encontram "312 short picks" — tecnicamente verdade, totalmente inútil. Registre os dados, mas registre os dados certos.
Registre pelo menos oito campos por exceção: número da tarefa, SKU, endereço, código de motivo, timestamp, responsável, contagem de reflows, disposição final. Mantenha os códigos de motivo entre oito e dez. Mais do que isso e ninguém seleciona com cuidado; menos e o post-mortem não mostra nada. Meu conjunto usual: short pick, ruptura, danificado, divergência de etiqueta, confusão de endereço, retenção de qualidade, falha de equipamento, outro. Se "outro" passar de quinze por cento, sua lista de códigos está incompleta — adicione códigos.
Três números bastam para a revisão. Esqueça o deck de vinte slides.
Primeiro: os cinco SKUs com mais reflows repetidos. Um SKU que faz short pick repetidamente é quase sempre um problema de slotting ou de reposição, não um problema do operador. Naquele centro de Ontario, o SKU batata-quente tinha o estoque de segurança abaixo do volume médio diário de picks. A reposição nunca alcançava.
Segundo: a parcela de exceções que estouram sem fechamento — observe a tendência. Se está subindo, sua capacidade de tratamento manual não acompanha o volume de exceções. Adicione gente ou conserte o processo.
Terceiro: mudanças no mix de códigos de motivo. Se "divergência de etiqueta" dobrar em um mês, as chances são de que o fornecedor de etiquetas mudou ou o treinamento dos novos contratados escorregou. Dados são o sintoma; processo é a causa.
Aqui está um checklist para confrontar com o seu go-live do WES ou revisão: há mais de dez códigos de motivo? Há um teto de reflows? As exceções que bloqueiam a onda têm seu próprio relógio de escalonamento? O escalonamento depende só de e-mail? As tarefas suspensas têm idade máxima e condição de despertar? Seus relatórios conseguem puxar os cinco SKUs com mais reflows repetidos? Acertando tudo isso, seu reflow de exceções está basicamente sólido.
Voltando àquela quarta-feira. O armazém de Ontario depois limitou os reflows a três, com conversão automática para tarefa manual de auditoria no quarto — e essa classe de problema caiu drasticamente em dois meses. Mas aqui vai a pergunta que deixo com você: puxe os dados de exceção do mês passado do seu armazém — qual a parcela de tarefas que fez reflow mais de duas vezes? Se você nem consegue puxar esse número, então não importa quão elegante pareça seu design de reflow, é decoração.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.