Aqui vai o veredicto logo de cara: o seu plano de redundância e failover do WCS precisa estar fechado antes do go-live — e ensaiado pelo menos uma vez, de ponta a ponta, para valer. Um plano que nunca foi ensaiado é o mesmo que plano nenhum. Eu vi essa mesma falha três vezes, e em todas o aprendizado foi pago em tempo parado.
Por que o WCS não perdoa? Porque ele é o cérebro de um armazém automatizado: transportadores, sorters, elevadores, despacho de AMR — tudo recebe ordens dele. Quando ele morre, o sistema não "desacelera"; todos os equipamentos do armazém param juntos, e a mercadoria fica presa nos equipamentos onde nenhuma mão humana alcança. Se o seu servidor WMS morre, você ainda expede com listas de picking em papel. Se o seu WCS morre, você só fica ali olhando. São falhas de magnitude completamente diferente, e no checklist da noite do go-live, a redundância do WCS é o item que você não desconta.
Vi essa falha três vezes: quatro horas contra dez minutos
No fim de 2024, um centro de distribuição de e-commerce no sul da China nos chamou para apagar um incêndio. O site processava cerca de 80,000 pedidos por dia, com um armazém automatizado de grande altura mais classificação cross-belt — tudo rodando sobre um único servidor WCS físico. Sem reserva. Uma manhã o disco falhou e o WCS não subiu. A cena no armazém: mercadoria congelada nos transportadores, metade das calhas de classificação cheias e mais de 60 trabalhadores do turno da noite parados, sem nada para fazer. Da detecção da falha, à espera de peças, à reinstalação do sistema operacional, à recarga da configuração, até a recuperação total — quatro horas. Para o volume diário desse site, quatro horas equivalem a cerca de 13,000 pedidos acumulados, na semana antes da alta temporada, com os telefones do atendimento ao cliente pegando fogo. A frase do gerente de TI no post-mortem ainda dói: "A gente sempre achou que o servidor era sólido. Nunca nos passou pela cabeça que ele pudesse simplesmente morrer."
Agora o exemplo positivo. Na primeira metade de 2025, um armazém automatizado 3PL no leste da China operava uma configuração ativo-reserva de manual: a reserva replicava o banco de dados do primário em tempo real, havia monitoramento por heartbeat, e o SOP de failover estava impresso e colado na parede da sala de controle. O ponto crítico: eles tinham feito dois simulados completos de failover ao vivo antes do go-live — não simulados de slides, mas daqueles em que você realmente arranca o cabo de rede do primário. Três meses depois do lançamento, o módulo de alimentação do servidor primário falhou; o operador de plantão seguiu o SOP, e a reserva assumiu em dez minutos. Dois simulados, cerca de duas horas cada; o que eles compraram foram dez minutos numa pane real. Conta fácil.
O checklist pré-lançamento: cinco passos para fechar o projeto de failover
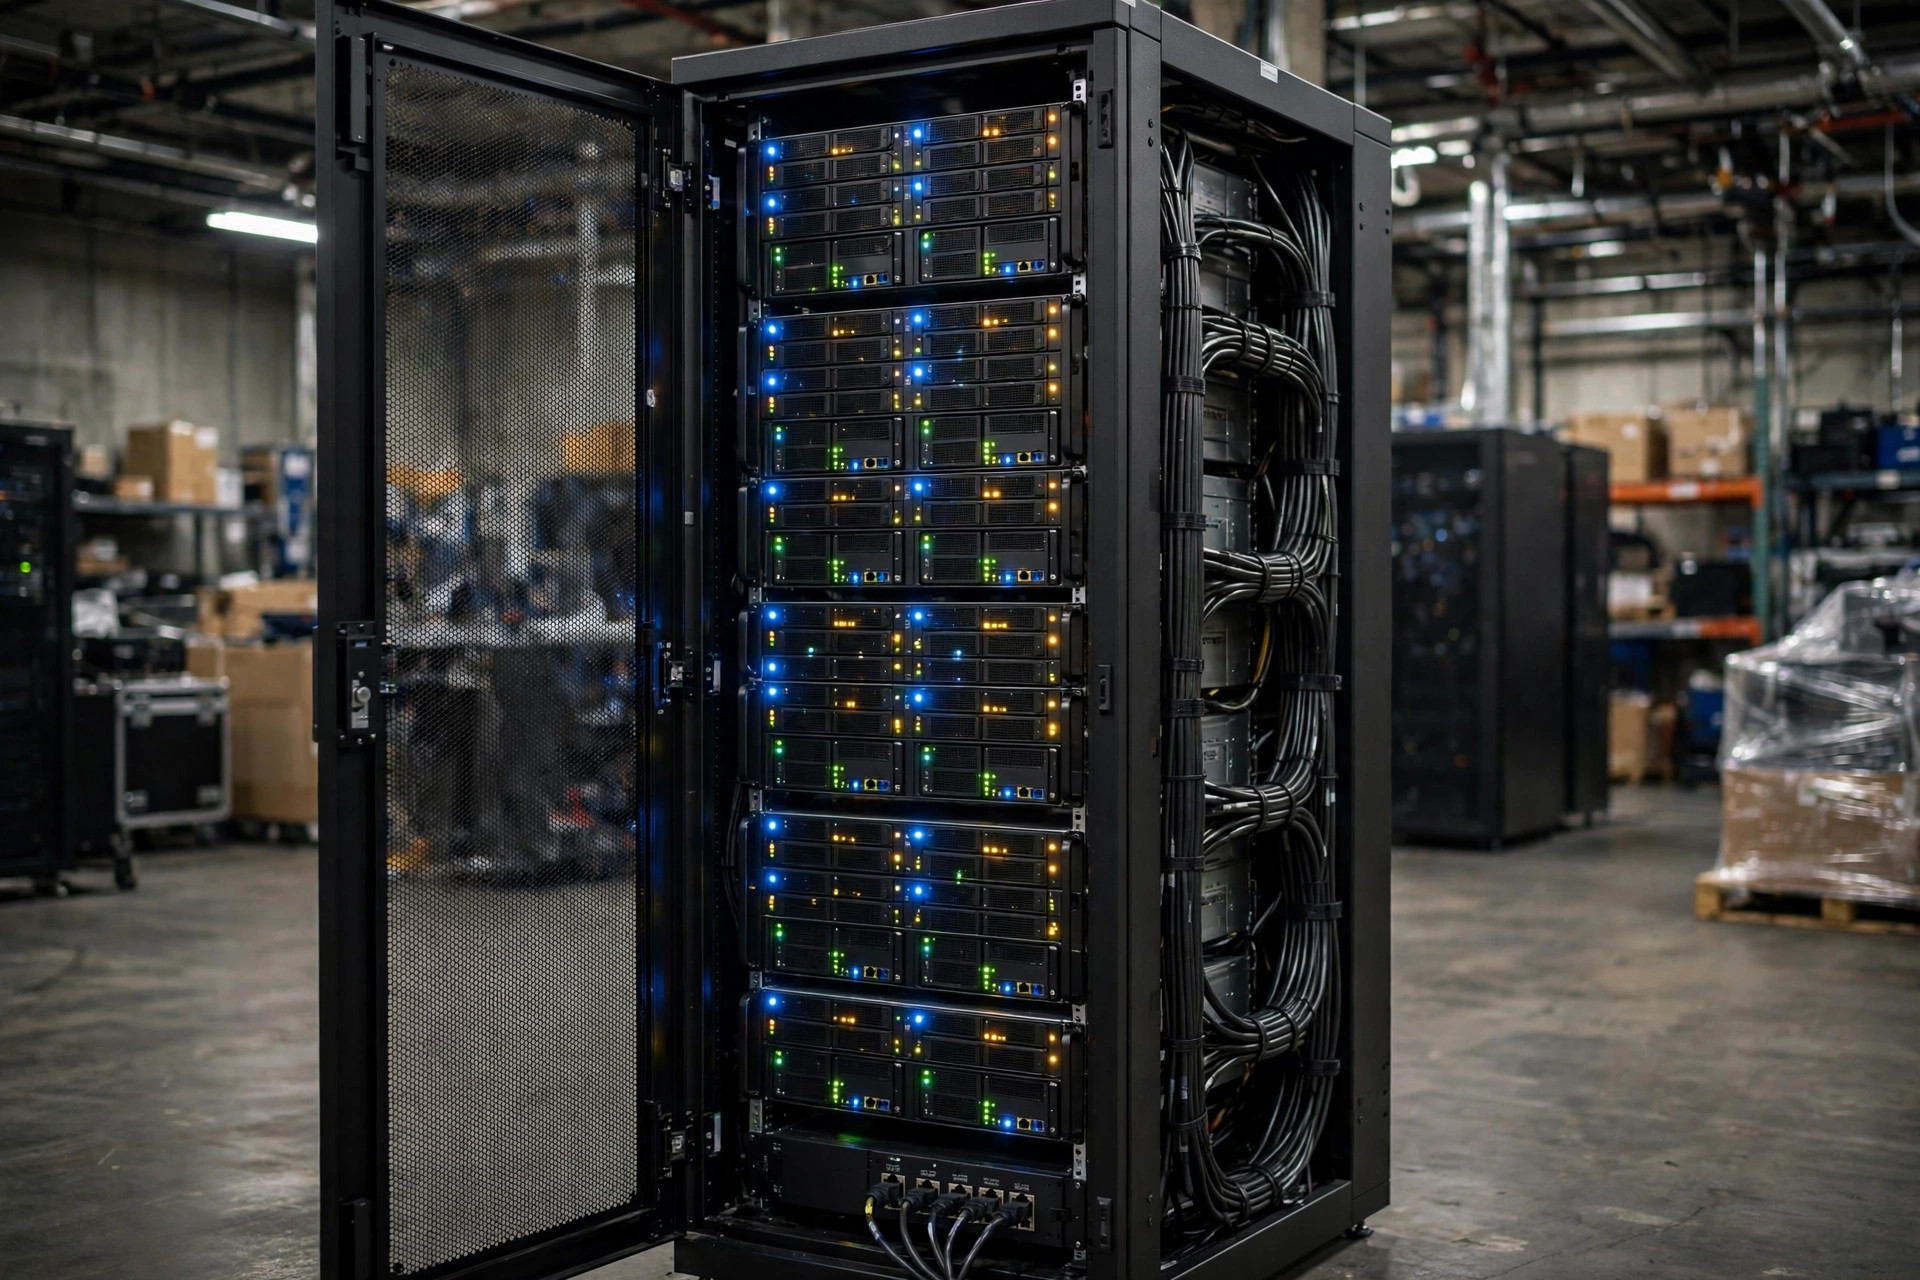
Passo um: escolha a arquitetura e não superdimensione. Para sites com menos de cerca de 100,000 pedidos por dia, ativo-reserva com replicação primário-réplica do banco de dados é suficiente; dual-ativo dobra a complexidade — deixe para os mega-hubs. E a reserva precisa ter especificação não inferior à do primário. Não economize na máquina de reserva: fazer failover para uma máquina que não aguenta o armazém inteiro é pior do que não ter reserva nenhuma.
Passo dois: grave em pedra as metas de sincronização de dados. O RPO (quanta perda de dados você pode tolerar) não deve passar de cinco minutos; avise alguém se o atraso de replicação passar de um minuto. Os estados de tarefas do WCS e os estados dos equipamentos precisam estar dentro do escopo da replicação. Replicar só o banco de dados de negócio e não o banco de estados significa que você faz failover direto para o caos do mesmo jeito — esse é o detalhe que mais passa batido.
Passo três: escreva o SOP de failover de um jeito que dê para executar meio dormindo. Precisa cobrir: quem está autorizado a ordenar o failover (líder de turno ou acima), a sequência (primeiro pausar o despacho de tarefas, depois a assunção pela reserva, depois a reconexão dos equipamentos e por fim a verificação pontual) e os critérios de aceitação de cada etapa (por exemplo, "os três troncos de transportadores movimentando mercadoria"). Imprima duas cópias — uma na sala de controle, outra na sala de plantão de TI. Não deixe viver só no laptop de alguém.
Passo quatro: pelo menos um simulado completo ao vivo antes do go-live. Três exigências duras: você corta um link de verdade (arranca o cabo, desliga a energia — sem botão de "simular"), você cronometra tudo (da detecção da falha à retomada da produção, minuto a minuto) e você faz um post-mortem (qualquer etapa que estourou o tempo ganha uma correção no SOP ou na arquitetura). Depois do go-live, simulado trimestral, mais um extra sempre que pessoal-chave mudar.
Passo cinco: monitoramento e inspeção de rotina, sem exceções. A reserva não é mobília: cheque automaticamente todo dia o heartbeat da reserva e o atraso de replicação, faça uma verificação semanal somente leitura na reserva (confirme que os dados estão quentes) e um walkthrough mensal de mesa do fluxo de failover. Uma reserva em que ninguém fez login há três meses pode ter a senha expirada — uma das três falhas que eu vi foi exatamente essa: credenciais de reserva expiradas, e o armazém ficou parado quarenta minutos a mais enquanto todo mundo corria.
Os jeitos habituais de dar errado: plano no papel é igual a plano nenhum
- Os dados da reserva têm três meses de idade: a replicação quebrou há muito tempo e ninguém olhou os alertas.
- Só uma pessoa sabe como apertar o botão de failover: essa pessoa está de férias, e o armazém inteiro espera com ela.
- O simulado só existiu no PowerPoint: a primeira vez que se arranca um cabo de verdade revela que metade dos equipamentos não se reconecta à reserva.
- A reserva está subdimensionada: dezenas de núcleos no primário, uma fração disso na reserva, e ela desaba sob carga no momento em que assume.
A conclusão contra-intuitiva: alta disponibilidade não é cara — um plano nunca ensaiado, sim
Uma última conclusão contra-intuitiva: a alta disponibilidade do WCS em si não é cara. Um servidor de reserva mais o software de replicação costuma custar uma fração de uma hora de indisponibilidade — pela conta acima, quatro horas de parada acumularam 13,000 pedidos, e o estrago no atendimento ao cliente e nos SLAs sozinho ofusca o preço de um servidor. O que é genuinamente caro é o plano que existe num documento e nunca foi ensaiado: ele dá a ilusão de uma saída, e você descobre que a saída está pintada na parede só quando o incêndio começa.
Então aqui vão três coisas que você pode fazer ainda hoje: pergunte à sua equipe de TI se o WCS tem reserva; pergunte se os dados da reserva estão quentes ou têm três meses de idade; pergunte quando foi o último simulado de failover. Se qualquer uma dessas perguntas ficar no vazio, isso pertence à pauta agora — antes do go-live, não numa chamada de madrugada às 3 a.m.
Por Lin Xiao, Consultora de implementação WMS
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.