A versão curta
Uma queda do WCS não precisa parar o seu armazém. Se o seu time ensaiou a troca, dez minutos de pane no sistema de controle é um simulado, não um desastre. Estive em campo nesse exato defeito três vezes, e a lição foi idêntica em todas: um plano de contingência que ninguém ensaiou é o mesmo que plano nenhum.
É assim que acontece: 1:00 AM, a placa de rede do servidor WCS morre, e a esteira, os sorters e os elevadores param de uma vez. O supervisor congela por cinco minutos. Primeiro instinto: ligar para o fornecedor. Segundo instinto: esperar o sistema voltar. O primeiro instinto correto: trocar para o modo manual em três minutos, colocar o pessoal em movimento, e deixar os equipamentos esperando.
Este é um manual de campo para operação manual com WCS: um checklist de troca em 3 minutos, um manual em 7 passos, sete erros a evitar, e a conta de operar no manual versus ficar parado.
Por que a queda do WCS dói tanto
Entenda o conceito: um WCS não é um WMS. O WMS diz quais mercadorias mover; o WCS diz aos equipamentos como movê-las — roteamento de esteiras, alocação de chutes do sorter, programação de elevadores, despacho de shuttles. Quando ele morre, os equipamentos, as cargas e as pessoas continuam lá, mas ninguém está regendo. A zona automatizada passa do piloto automático para uma pilha de peças soltas em segundos.
As quedas vêm em três sabores, cada uma exigindo uma resposta diferente. Diagnostique errado e tudo depois é desperdício:
- Falha do aplicativo WCS (serviço ou servidor fora): os PLCs continuam rodando no local, mas nenhuma nova tarefa é despachada. As caixas terminam o percurso atual e param.
- Desconexão de rede (falha de switch, ou uma empilhadeira cortando um cabo — essa eu vi três vezes): o WCS está bem, mas o heartbeat para os PLCs se foi. Os equipamentos param por segurança; as esteiras fazem parada de emergência.
- Falha do banco de dados ou da fila de mensagens do WCS: tarefas meio despachadas, estado dos equipamentos e registros do sistema em desacordo. O tipo mais traiçoeiro — a reconciliação depois da recuperação leva um tempo sério.
Primeira regra: diagnostique o tipo antes de mexer em qualquer coisa. A maioria reinicia primeiro o serviço do WCS. Se for uma desconexão de rede, dez reinicializações não compram nada e queimam vinte minutos.
Contingência para quedas do WCS: os primeiros 3 minutos
Este checklist é um item fixo do checklist da véspera do go-live que rodo com cada cliente. Imprima, cole na parede da sala de controle, marque as caixas quando acontecer.
Passo 1: Minutos 0–3 — Confirme o alcance do estrago
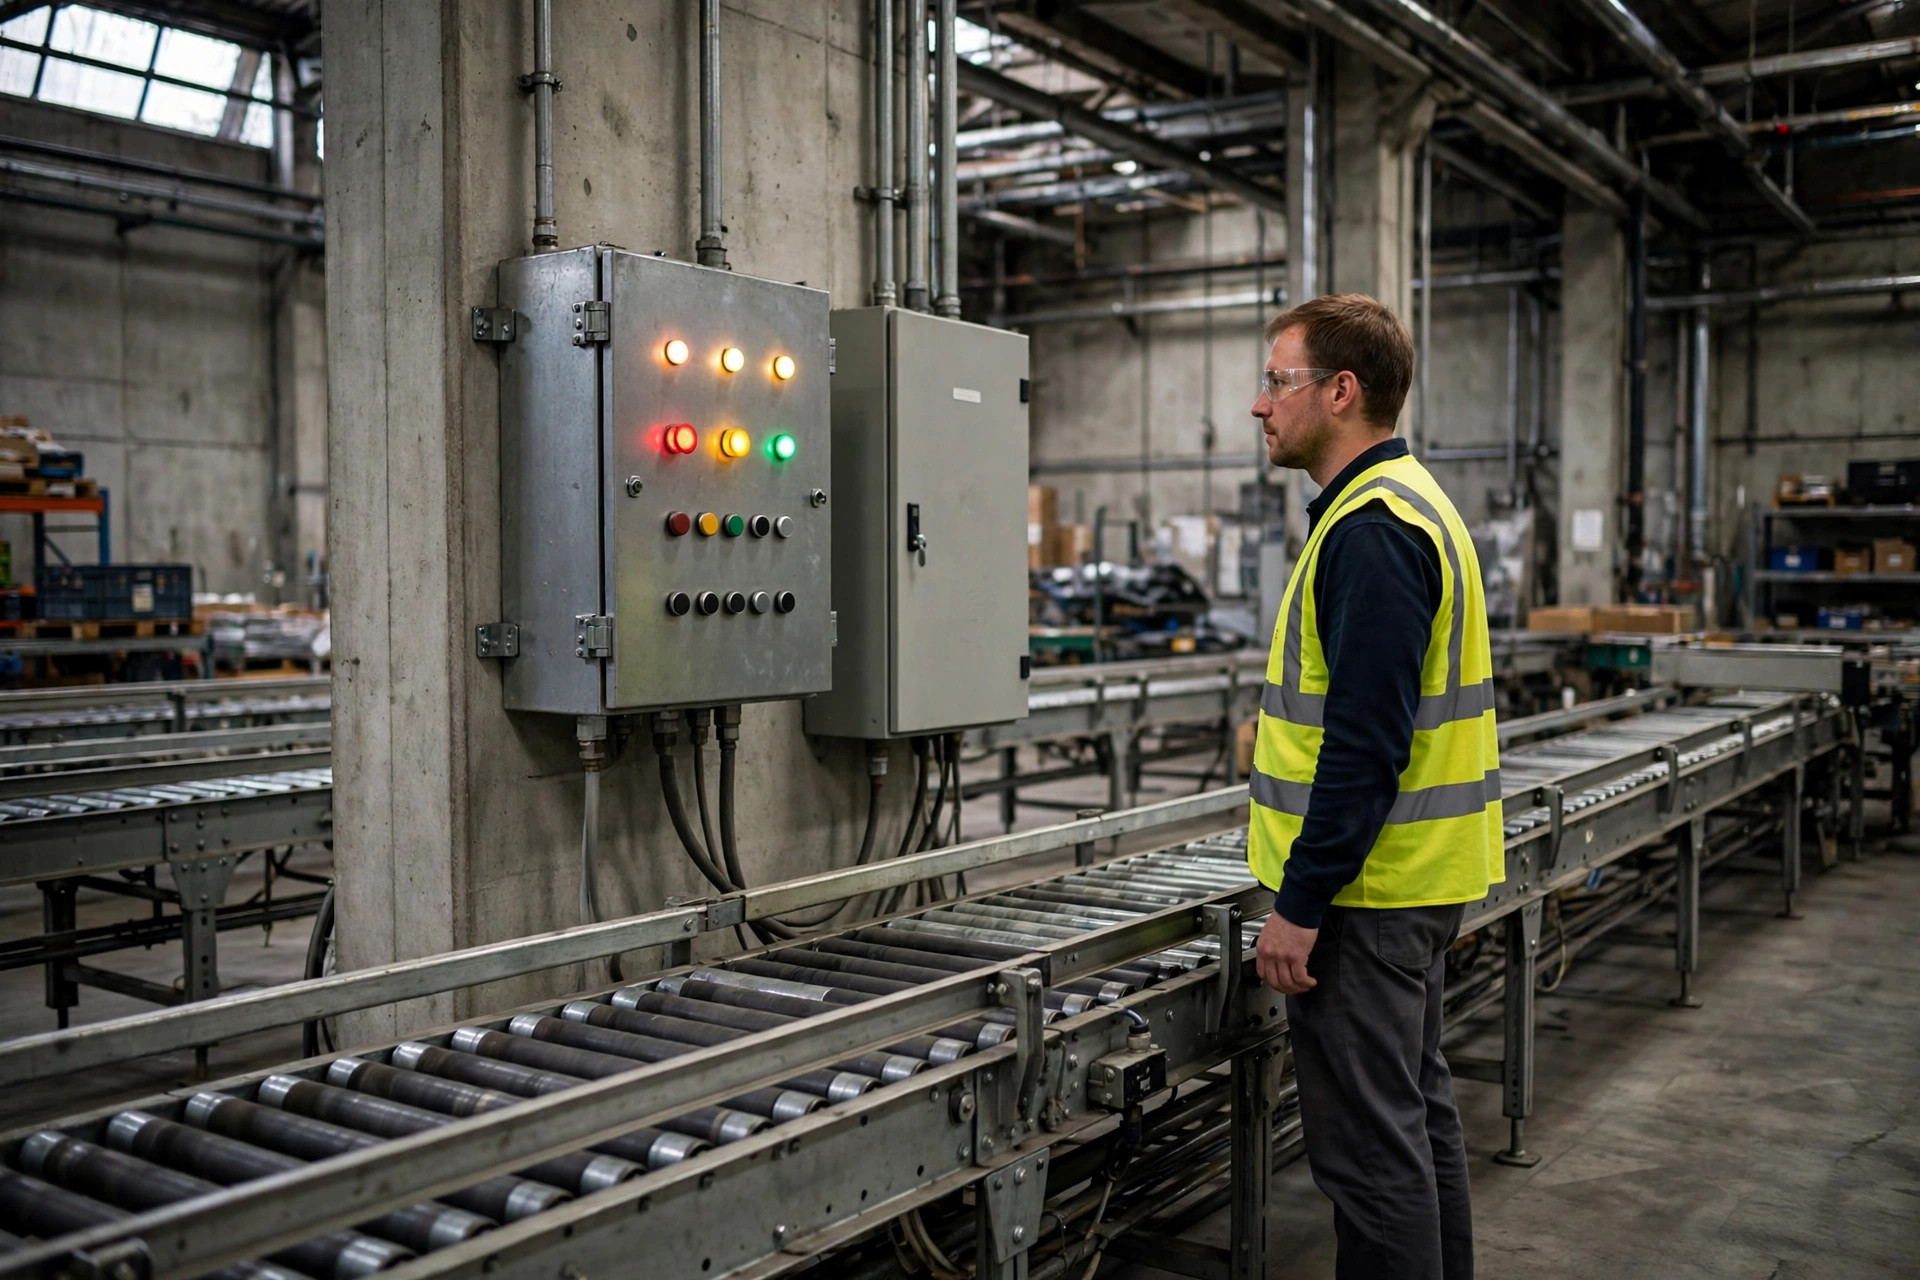
- Dashboard de controle: tudo vermelho ou parcialmente vermelho? Tudo vermelho geralmente significa que o aplicativo WCS ou o switch core caiu; vermelho parcial aponta para um PLC ou uma linha.
- Peça à TI para dar ping no servidor WCS e no switch core em paralelo — problema de aplicativo ou de rede?
- Anuncie agora: "WCS fora, trocando para o modo manual," três vezes pelo rádio. Não no chat do grupo — todo mundo está no piso, e o rádio é o mais rápido.
- Movimento crítico: congele as tarefas novas. Diga ao lado do WMS para pausar as liberações de onda, ou você criará tarefas fantasma que o sistema acha que despachou mas os equipamentos nunca receberam.
Passo 2: Minutos 3–10 — Troque para o manual
- Esteiras: no painel HMI do PLC de cada seção, troque para o modo manual/local e pulse as esteiras para limpar as caixas até o desvio mais próximo. Uma pessoa por seção, puxada temporariamente do packing.
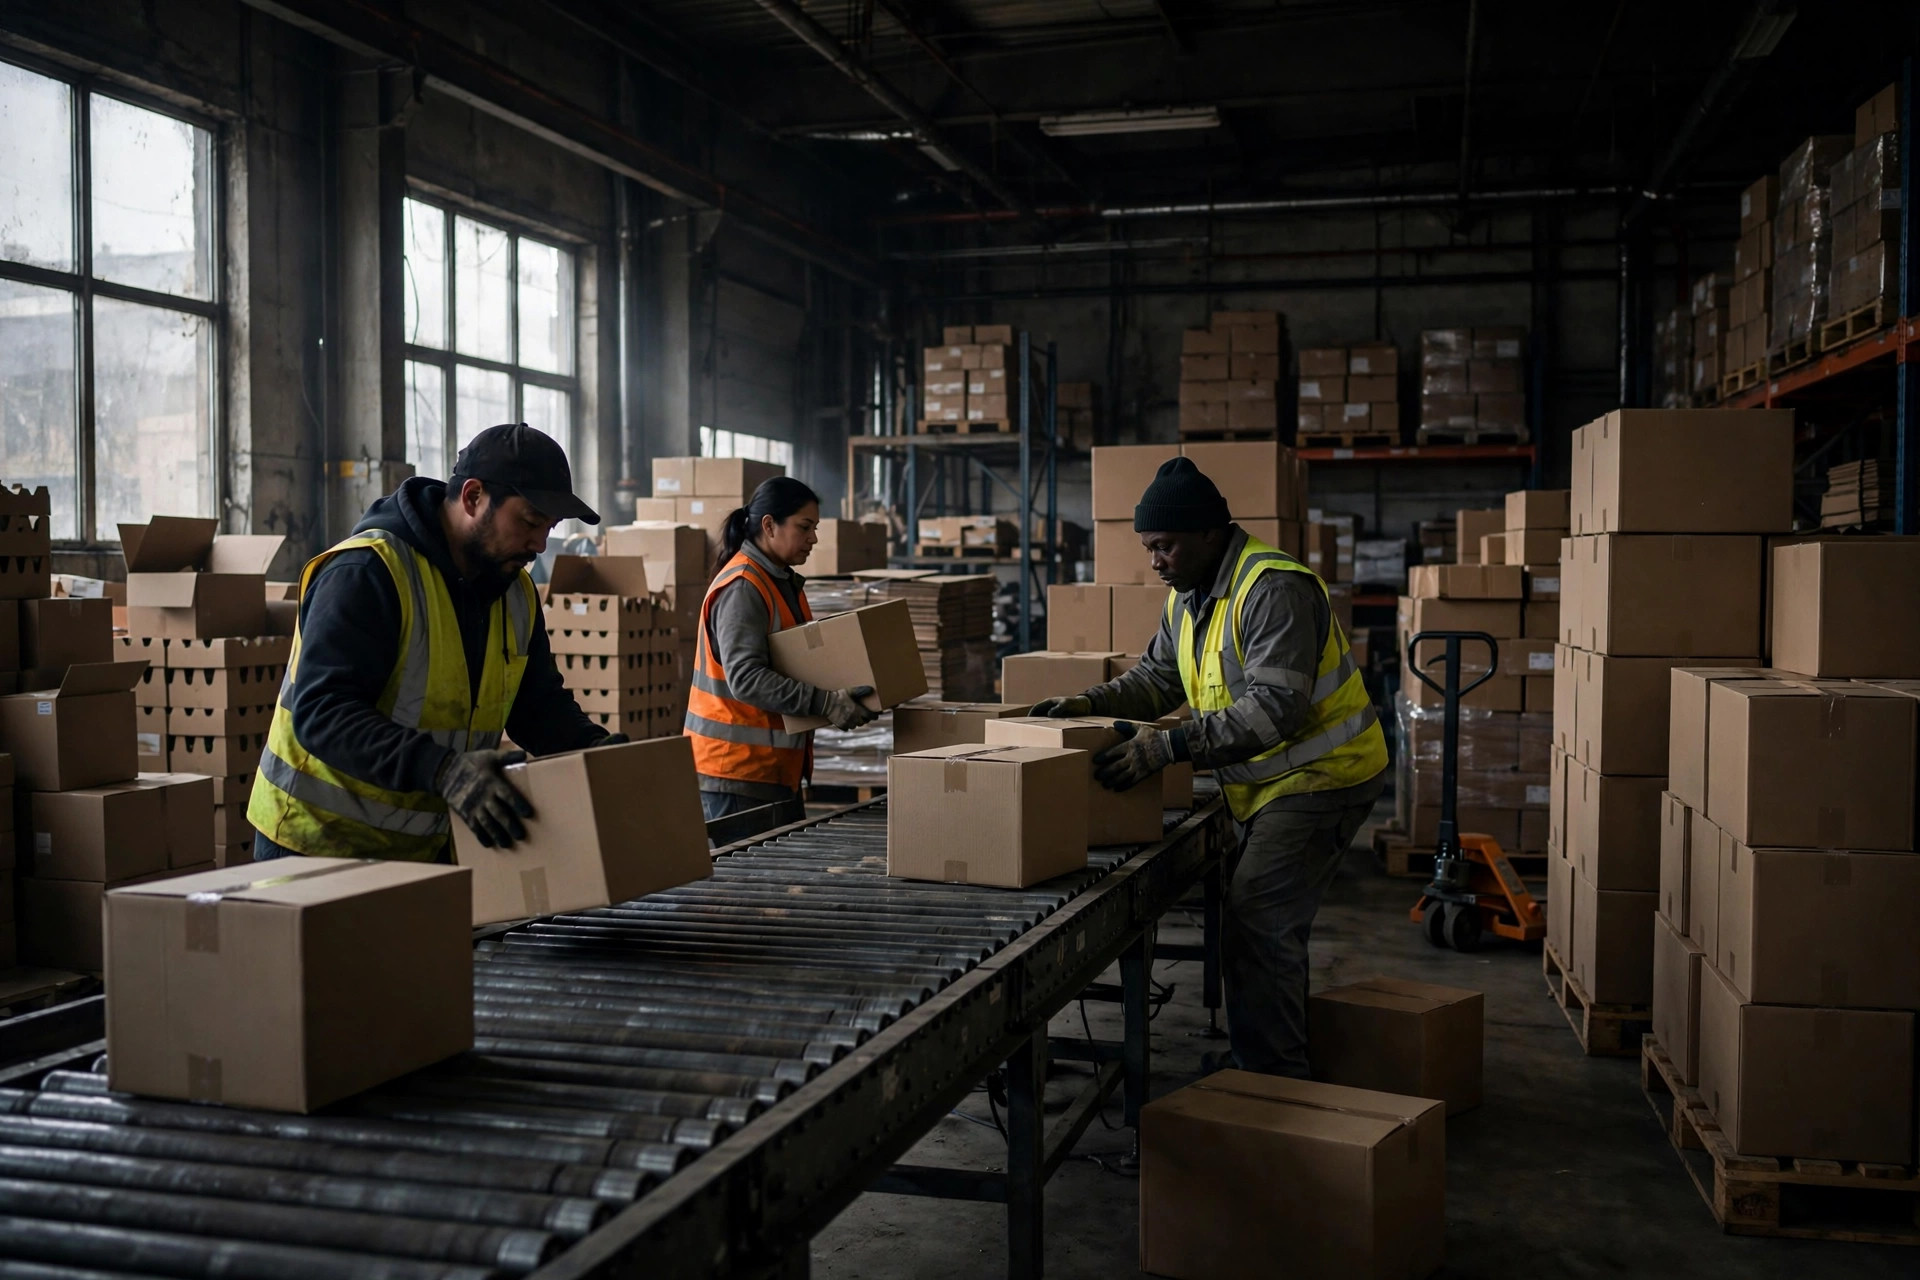
- Sorters: a alocação de chutes acabou — classifique à mão. Rode o sorter como uma esteira burra; os operadores desviam pelo rótulo de envio em cada chute. A vazão cai, mas a carga flui.
- Elevadores e shuttles: o modo manual aqui é de alto risco. Bloqueie-os; mova a carga à mão ou com paleteira. Não aposte com pessoas ao lado de equipamentos automatizados para economizar minutos — linha dura de segurança.
- Etiquetas: se o sistema de etiquetas estiver de pé, continue imprimindo. Se estiver fora, escreva à mão em etiquetas pré-impressas em branco. O checklist da véspera do go-live precisa incluir uma caixa de etiquetas pré-impressas — uma lição paga com sangue.
Passo 3: Depois do minuto 10 — Segure o ritmo manual
- Um comandante do modo manual — geralmente o supervisor de turno — no meio do piso com um rádio, alocando mão de obra e tratando exceções.
- Conte o progresso a cada 15 minutos: caixas processadas, caixas em atraso. Quadro branco, não memória.
- Registre cada ação manual para lançar no sistema depois. Prepare folhas de papel com antecedência (ID da caixa, ação, hora, operador); digite-as depois da recuperação. O passo que a maioria dos times pula — e registros pulados significam que o estoque nunca reconcilia.
Passo 4: Recuperação — Reconciliação antes de reiniciar
- Não volte direto para o automático. Primeiro: (1) confirme que o heartbeat PLC–WCS está estável por cinco minutos; (2) confira por amostragem as caixas da linha contra os registros em papel; (3) faça um teste de 10 minutos em baixo volume.
- Vi esse erro três vezes: automático total no segundo em que o WCS volta, uma caixa de tarefa fantasma classifica no chute errado — duas horas de retrabalho.
Os 7 erros (vi cada um três vezes)
- Escrito mas nunca ensaiado. Um plano em papel não é um plano. O checklist da véspera do go-live precisa de um simulado real de desconexão.
- Ninguém sabe a senha do painel do PLC. Está no telefone do engenheiro do fornecedor — ele vai atender às 2 AM? Mantenha acessível na sala de controle.
- As instruções do modo manual estão em inglês; o pessoal do piso não consegue ler. Traduza, adicione fotos, cole nos equipamentos.
- Rádios descarregados. Lista de suprimentos de emergência: cheque o carregamento dos rádios mensalmente.
- Sem etiquetas pré-impressas. O sistema de etiquetas geralmente morre com todo o resto — sem etiquetas, sem movimentação de carga.
- Lado WMS não congelado. As ondas continuam saindo; as tarefas fantasma inundam o sistema na recuperação.
- Reinício total, sem reconciliação. Veja o Passo 4 — a zona de desastre do retrabalho.
Dois incidentes reais
Junho de 2024, um DC de e-commerce em pico de temporada no leste da China. 1:17 AM: a placa de rede do servidor WCS falha, a camada de aplicação cai, esteiras, sorters e três elevadores param com ~8,000 pedidos esperando. O supervisor roda o checklist ensaiado — anúncio mais congelamento de ondas do WMS em três minutos, esteiras no manual e classificação à mão em dez. Sistema de volta após 47 minutos, 20 minutos de reconciliação, depois automático total. Atraso zerado antes das 11 PM; o cutoff do pico foi mantido. Post-mortem: dois ensaios antes, o terceiro "fogo real" — ninguém entrou em pânico.
Novembro de 2023, um armazém 3PL no sul da China. 3 PM: uma atualização de firmware do switch core falha; o heartbeat do sistema de controle para os PLCs cai por 12 minutos. Nunca ensaiado. 8 minutos de caos — alguém reinicia o WCS (inútil, é um problema de rede), alguém liga para o fornecedor (não atende). Um veterano troca as esteiras para o manual de memória e salva a linha de travar. 12 minutos de queda, 40 minutos de parada: os 28 minutos extras foram puro "ninguém sabia o que fazer". O valor do plano mais o ensaio equivale a cada minuto desperdiciado além da própria queda.
A conta: operação manual vs. ficar parado
Um DC de e-commerce de 5,000 pedidos por dia, uma hora de queda:
| Ficar parado esperando | Trocar para o manual | |
|---|---|---|
| Vazão nessa hora | 0 pedidos | ~800–1,200 pedidos (manual ≈ 30–40% do ritmo automatizado, pelos sites que vi) |
| Atraso | Os 5,000 pedidos todos empurrados para trás | ~1,000 a menos em atraso |
| Rampa pós-recuperação | 2–3 horas | ~1 hora |
| Custo de mão de obra | 0 (hora extra depois) | ~15 pessoas por 1 hora |
| Risco | Estouro do SLA de cutoff | Taxa de erro um pouco maior — adicione verificação |
Conclusão direta: uma hora no manual compra de volta uma a duas horas de rampa. Para um DC com cutoffs duros de expedição, essa é a diferença entre "expedido no prazo" e "atrasos em massa".
A verdade desconfortável
A visão contrária: o plano de contingência mais assustador não é o que nunca foi escrito — é o que foi escrito e nunca ensaiado.
Vi um plano de 40 páginas que ninguém conseguiu abrir rápido o bastante, e um checklist de uma página A4 que funcionou porque o time ensaiou três vezes e todo mundo conhecia o seu posto. O valor de um plano é memória muscular, não contagem de páginas.
Minha recomendação: coloque o simulado de operação manual no seu checklist da véspera do go-live e repita-o trimestralmente. As pessoas giram; um contratado novo sem ensaio é um plano vencido. Um simulado custa duas horas de baixa demanda. Uma queda sem preparo pode triplicar seu tempo de parada (incidente dois: 12 minutos de queda, 40 de parada).
Na próxima vez que o sistema de controle cair, você quer o incidente um ou o incidente dois no seu piso? A resposta está em quantas vezes você ensaiou.
Por Lin Xiao, consultor de implementação WMS
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.