Eis o veredito logo de início: o reconhecimento OCR de documentos em armazém só vai economizar trabalho real no seu cais de recebimento se três coisas acontecerem ao mesmo tempo: os conhecimentos de embarque e as listas de embalagem são modelados separadamente, os limites de revisão são definidos campo a campo e a precisão em nível de documento é medida por si só. Se faltar uma das três, a entrada em produção vai acabar cobrando. Já vi isso falhar três vezes, e todas as vezes foi exatamente da mesma forma: uma demonstração perfeita e depois um primeiro mês caótico.
No outono passado, trabalhei com um importador de artigos para o lar cujo armazém ficava perto do Porto de Long Beach. Nos dias de pico, recebiam mais de quarenta contêineres. Seus conhecimentos de embarque chegavam num formato fixo da transportadora. Suas listas de embalagem vinham dos fornecedores, cada uma com um leiaute um pouco diferente. A frase de abertura do fornecedor na reunião de início foi uma afirmação de precisão de 99%. Fiz uma só pergunta: 99% do quê — caracteres, campos ou documentos inteiros? A sala ficou em silêncio por três segundos. Nada depois disso correu bem.
Um conhecimento de embarque e uma lista de embalagem não são o mesmo tipo de documento, e qualquer sistema que os trate como um só vai ler mal um dos dois. O conhecimento de embarque é emitido pela transportadora. Cumpre três funções ao mesmo tempo: é o contrato de transporte, o recibo da carga e, quando negociável, o documento de titularidade. A lista de embalagem é preparada pelo vendedor. Diz o que há dentro de cada caixa, quantas caixas há e quanto pesam. Não traz preços nem peso legal. Existe para que a equipe de recebimento possa contar.
Reconhecimento OCR de documentos em armazém: conhecimentos de embarque e listas de embalagem são documentos diferentes
O conhecimento de embarque tem poucos campos, e cada um deles importa: navio e viagem, número do conhecimento de embarque, número do contêiner, número do lacre, quantidade de volumes, peso bruto, porto de embarque e porto de descarga. A lista de embalagem tem muitos campos, e são desordenados: números de caixa, descrições de itens, quantidades por caixa, pesos líquidos e brutos, dimensões e, às vezes, o mesmo item dividido em várias linhas. Minha regra são duas tabelas de campos e dois limites de confiança. Um número de contêiner ou de lacre com um só caractere errado é parado. Uma quantidade com um só dígito errado é parada. Uma descrição de item pode ter um pouco mais de folga.
Já vi isso falhar três vezes. A terceira foi num cliente de autopeças. A lista de embalagem do fornecedor amontoava a especificação, a cor e uma observação na coluna de descrição, então o sistema leu «preto, porta dianteira esquerda» como parte do nome do item. O WMS acabou com um item fantasma que não existia em nenhuma prateleira. A equipe de recebimento o procurou por uma hora. A solução não teve glamour: dividir descrição, especificação e observação em três campos, guardar os dois últimos sem validá-los e montar um dicionário só para os nomes de itens. O dicionário começou com cerca de duzentos termos e passou de mil em um mês. Só então as leituras erradas se acalmaram.
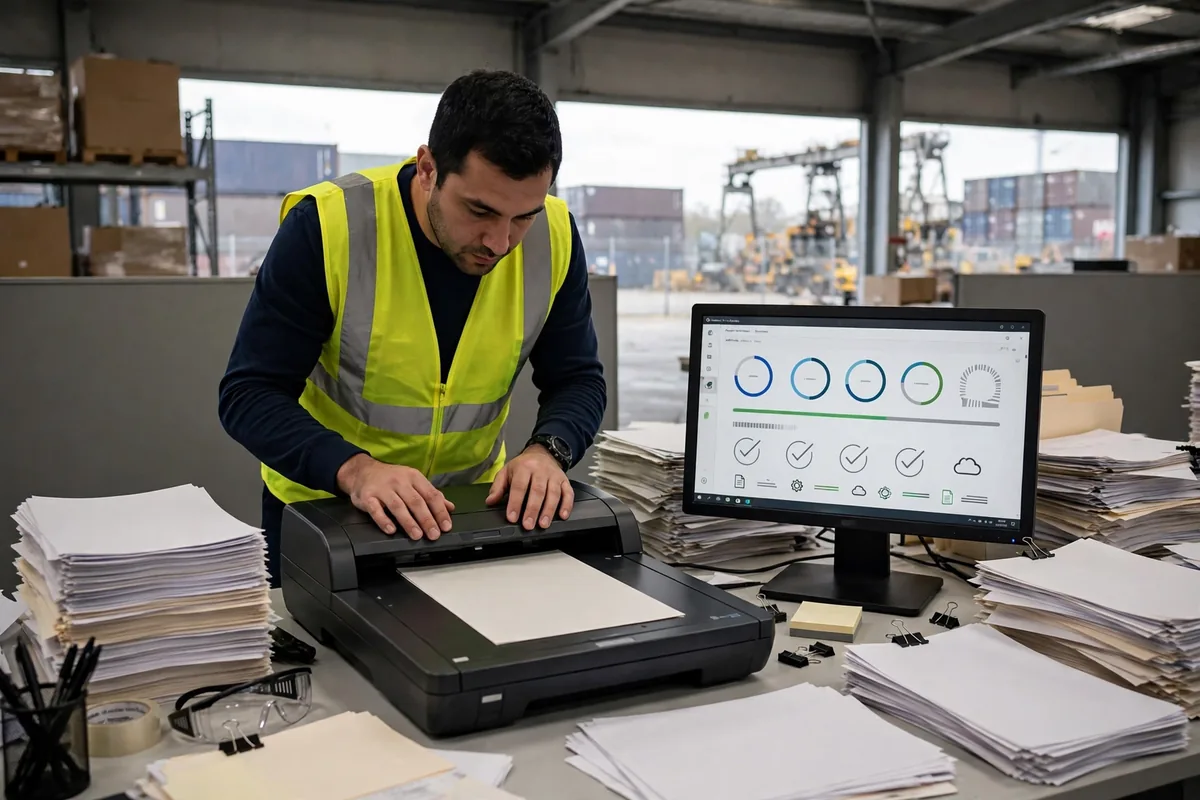
Minha lista de verificação da noite de entrada em produção tem uma linha que nunca muda: passar três meses de documentos reais pelo sistema, nunca as páginas de amostra que o fornecedor preparou. As páginas de amostra são impressões limpas. Os documentos reais têm dobras, carimbos sobre o texto e correções manuscritas. Corrija a inclinação antes do reconhecimento e devolva para novo escaneamento tudo o que foi escaneado abaixo de 200 dpi. Se pular esta etapa, seus revisores vão gastar três vezes mais tempo limpando depois.
Precisão do reconhecimento OCR de documentos em armazém: caracteres, campos e documentos inteiros são três números
A precisão de caracteres, a precisão de campos e a precisão de documentos são três números diferentes, e confundi-los é como se tomam decisões ruins de compra. O material publicado do setor coloca os motores OCR tradicionais em cerca de 85 a 97% de precisão de caracteres, enquanto os sistemas modernos baseados em IA chegam a 95 a 99.5% de precisão de campos. Os dois números soam tranquilizadores. Os documentos inteiros contam uma história mais dura. Tome um documento com 20 campos, cada um certo 98% das vezes. A chance de os 20 estarem certos é 0.98 elevado a 20, cerca de 67%. Um documento em cada três traz pelo menos um campo errado.
Essa matemática decide como a revisão é dimensionada. Eu defino linhas de revisão por campo, não por documento. Números de contêiner, de lacre e de conhecimento de embarque, quantidades e pesos brutos vão para um humano sempre que a confiança cai abaixo de 99%. Descrições de itens, marcas e observações vão para um humano abaixo de 95%. Cada manhã a fila é zerada em ordem: primeiro os conhecimentos de embarque, depois as listas de embalagem. Um conhecimento de embarque errado segura um contêiner no portão. Uma lista de embalagem errada ainda pode ser corrigida enquanto o contêiner está sendo descarregado.
Agora a matemática do trabalho (exemplo hipotético): um recebedor digitando à mão uma lista de embalagem leva 12 minutos. Trinta listas por dia são 6 horas. Depois da entrada em produção, suponha que 70% dos documentos passem direto e os 30% restantes levem 3 minutos cada para revisar. O tempo diário de revisão cai para 27 minutos. As mais de cinco horas economizadas não são para o café. São para conferir a mercadoria física com o papel. Um revisor que só fica olhando para a tela ainda vai liberar a carga errada.
Eis a parte contraintuitiva: os documentos com as maiores taxas de reconhecimento não são as impressões mais limpas. São os de leiaute mais estável. Um conhecimento de embarque de transportadora mal muda de formato em uma década, então é lido com confiabilidade. Uma lista de embalagem feita por fornecedor muda de leiaute a cada poucos meses, então oscila. Ao avaliar um fornecedor, não julgue a maior pontuação da demonstração. Julgue a pontuação do seu lote mais feio de documentos reais. Quanto mais bonitas forem as páginas de amostra, mais desconfiado você deve ficar.
Fazendo funcionar no cais de recebimento
Esse é o teste que aplico a qualquer projeto de reconhecimento OCR de documentos em armazém antes de assiná-lo. A implantação avança em quatro movimentos. O primeiro movimento é uma tabela de campos assinada: recebimento, alfândega e TI sentam juntos e decidem, campo por campo, o que entra no WMS, o que é guardado apenas como referência e o que deve parar a linha quando está errado. O segundo movimento é uma rodada histórica: passar três meses de conhecimentos de embarque e listas de embalagem reais pelo sistema, registrar cada campo mal lido e corrigir o dicionário, os limites e as regras. O terceiro movimento é uma rodada paralela de duas semanas, com o sistema novo e a digitação manual lado a lado e uma conciliação diária. Se a diferença diária passar de cinco documentos, pare e descubra a causa. Não avance carregando a diferença. O quarto movimento é a virada para um único sistema, com a digitação manual mantida apenas como canal de emergência.
As filas de revisão devem ser zeradas antes do fim de cada turno. O que ficar da noite recebe prioridade máxima na manhã seguinte, e tudo com mais de 48 horas vai direto ao gerente do armazém. As exceções precisam de um destino com nome, não de uma pilha que ninguém possui. Um contêiner cujo número ou lacre não confere com o conhecimento de embarque fica trancado até a transportadora confirmar por escrito. Uma quantidade de lista de embalagem que não confere com a contagem física é recebida pela contagem física, com uma nota de divergência enviada a compras e ao fornecedor no mesmo dia. Uma correção manuscrita só vale quando traz assinatura e carimbo. Sem eles, registre o número original e trate a diferença separadamente. Essas três regras pertencem à parede do cais de recebimento, não enterradas num manual do sistema.
Três pontos de falha aparecem sempre. O primeiro é tratar o reconhecimento como mágica enquanto ninguém controla a qualidade do escaneamento: páginas borradas, cantos rasgados e reflexos são alimentados no sistema, e a precisão cai. O segundo é definir a linha de revisão frouxa demais, de modo que um número de contêiner com uma letra errada passa e só aparece num exame alfandegário, com o contêiner meio descarregado. O terceiro é lançar e depois abandonar a manutenção: chegam novos fornecedores, novos nomes de itens e novos leiautes, ninguém atualiza o dicionário e, três meses depois, a precisão voltou silenciosamente para onde a digitação manual começou.
Quando isso funciona, o cais não parece mais vazio. Parece mais calmo. Menos contêineres liberados com um número errado, menos erros de linha nas listas de embalagem, menos noites conciliando. A economia de mão de obra é o resultado, não o objetivo. O objetivo é que cada documento no WMS possa ser rastreado até uma folha de papel, com uma pessoa nomeada que conferiu os campos que importavam.
Uma coisa que você pode fazer amanhã: pegue os 20 conhecimentos de embarque mais feios e as 20 listas de embalagem mais feias do mês passado e faça o fornecedor executá-los ao vivo na sua frente. A precisão de campos e a precisão de documentos que você vir ali são o verdadeiro ponto de partida do projeto.
Por Lin Xiao, consultor de implementação de WMS Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.