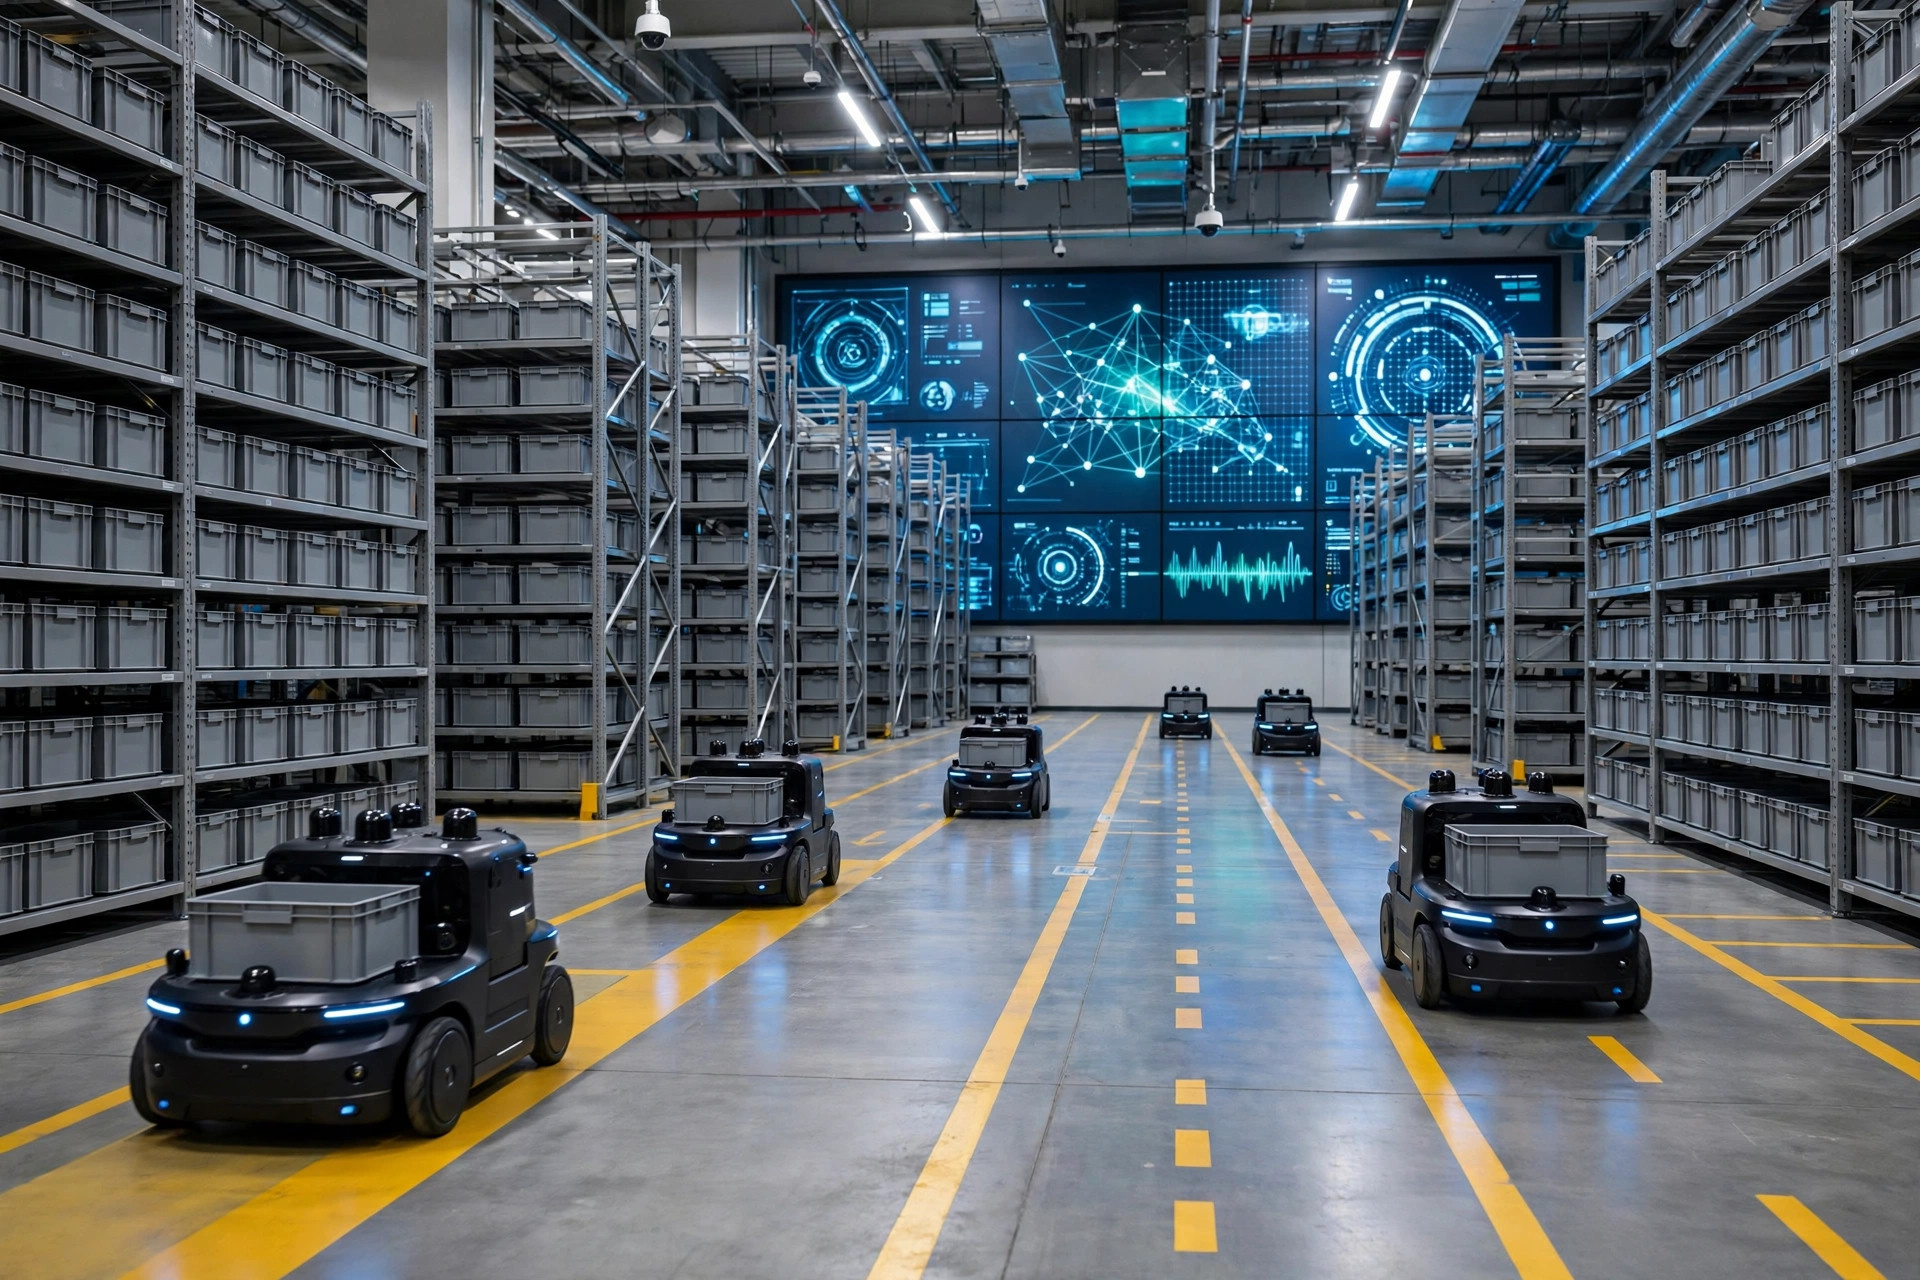
O "ciclo virtuoso de dados da IA em armazéns" (data flywheel) tem aparecido com frequência crescente nos círculos da cadeia de suprimentos: quanto mais um sistema de IA de armazém é usado, mais dados ele coleta e mais precisos seus modelos se tornam; quanto mais precisos, mais as pessoas dependem deles; e essa dependência maior devolve ainda mais dados ao ciclo. Mas, com base no meu acompanhamento das implantações de IA em armazéns, esse ciclo não gira nem de longe com a suavidade que a lenda sugere: existe de verdade em alguns cenários, e em outros está mais próximo de uma visão. Para acertar, primeiro olhamos os dados, e só depois a atribuição.
Onde o ciclo virtuoso de dados realmente gira nos armazéns
Nos armazéns, o ciclo virtuoso de dados não é um slogan — tem três formas concretas e verificáveis. Primeira, previsão de demanda e reposição: pedidos históricos e estoque alimentam o modelo, o modelo gera previsões em nível de SKU, as previsões orientam a reposição e o slotting, e as vendas reais se tornam novos dados de treinamento. Segunda, inspeção por visão: conferências de entrada, detecção de avarias, recontagens — cada revisão manual funciona também como uma anotação gratuita. Terceira, alocação de tarefas a robôs: cada movimento de um AMR registra um tempo de deslocamento, cada pegada registra um sucesso ou uma falha — dados que nascem já rotulados, sem necessidade de processamento secundário.
Para observar a verdadeira velocidade de rotação de um ciclo, é preciso uma linha do tempo suficientemente longa, e a rede de robótica de armazéns da Amazon é a melhor amostra pública: Kiva Systems adquirida em 2012, robôs goods-to-person em grande escala; o braço Sparrow, apresentado em 2022, que supostamente lida com cerca de 65% dos produtos do seu inventário; mais de 750.000 robôs móveis anunciados em 2024. Doze anos — cada picking, cada pegada, cada falha se tornou dado de treinamento incremental.
A evolução do Sparrow ilustra o mecanismo: os primeiros braços só manipulavam itens de formato regular em posições fixas; à medida que os dados de pegada se acumulavam, as taxas de sucesso em itens irregulares e de embalagem flexível melhoraram, permitindo à Amazon implantá-lo em mais categorias — fronteira de capacidade → incremento de dados → fronteira de capacidade. O ponto não é a sofisticação algorítmica — os frameworks de planejamento de pegada são públicos no meio acadêmico há muito tempo — mas o fato de que a Amazon detém dados de pegada com rótulos reais de falha que ninguém mais consegue obter.
Uma segunda amostra é a previsão de demanda. Entre o final de 2024 e o início de 2025, estudei dois grandes centros de fulfillment de e-commerce — um no leste da China, outro no sul da China — cada um processando entre 80.000 e 120.000 pedidos por dia, e ambos operando desde cerca de 2023 previsões de vendas em nível de SKU com ML. Um ano após o lançamento, as taxas de ruptura de estoque de ambos haviam caído de cerca de 6% para cerca de 4%, e o tempo de permanência do estoque de baixo giro havia encurtado cerca de 20%. Os dois responsáveis pela cadeia de suprimentos disseram quase a mesma coisa: "No lançamento, o modelo era pior que a intuição dos nossos planejadores; só depois de seis meses de acúmulo de dados ele assumiu a dianteira." A primeira meia-volta do ciclo opera no prejuízo — o ponto que os retardatários mais subestimam.
Por que os pioneiros giram mais rápido
A atribuição se resume a três mecanismos. Primeiro, a composição de ativos rotulados: nos armazéns, as ações do negócio são em si anotações — uma revisão manual, uma exceção tratada, uma divergência de inventário, cada uma carrega seu próprio rótulo. Os pioneiros entraram em produção mais cedo, então essas "anotações gratuitas" começaram a se compor mais cedo. Um retardatário pode comprar o mesmo algoritmo, mas não pode comprar esses anos de ativos rotulados. Segundo, a velocidade do ciclo de feedback: a velocidade de rotação não é determinada pelo volume de dados, mas pelo tempo que um ciclo completo leva — dados → modelo → decisão → novos dados. Na rede de fulfillment da Amazon, esse ciclo é medido em horas; na previsão de demanda, em dias. Quanto mais curto o ciclo, mais rápido a vantagem do pioneiro se amplia. Terceiro, a amplitude da cobertura da cauda longa: como pegar itens irregulares, como cortar ondas de pedidos na alta temporada, como lidar com exceções. Um modelo treinado por um retardatário em conjuntos de dados públicos performa de forma comparável em cenários padrão, mas a diferença se abre imediatamente na cauda longa — e o armazém é denso em cenários de cauda longa.
A verdade desconfortável: ciclos não giram sozinhos
Até aqui, soa como uma história destinada a pertencer aos pioneiros. Mas primeiro há três julgamentos contraintuitivos — são eles que determinam se o ciclo gira.
Primeiro, o ciclo tem um limiar de arranque a frio, e ele não é baixo. "Quanto mais é usado, mais preciso se torna" só vale se o sistema já for preciso o suficiente para que as pessoas queiram usá-lo. Se a precisão inicial fica atrás do desempenho humano, a operação o contornará e o fluxo de dados secará. Os dois armazéns acima sobreviveram aos primeiros seis meses não graças à tecnologia, mas graças a um mandato da gestão: a saída da previsão deve direcionar a reposição. Sem um ciclo fechado imposto organizacionalmente, a primeira volta nunca acontece. Muitos projetos de IA em armazéns morrem exatamente aqui: os dados existem, o modelo existe, mas o processo não reserva nenhuma posição pela qual o modelo "deve passar".
Segundo, os dados depreciam. Os dados do armazém têm um inimigo oculto: a mudança de distribuição (distribution shift). Uma grande reformulação do mix de SKU, uma mudança de endereço, uma troca de produtos padrão para não padrão — e os dados antigos decaem rápido. Um modelo de visão treinado por três anos em vestuário pode perder metade da sua precisão da noite para o dia em um armazém de autopeças. Um fosso de dados tem um prazo de validade definido pela estabilidade do cenário: quanto mais estável o cenário, mais profundo o fosso; quanto mais rápido as coisas mudam, mais rápido ele evapora.
Terceiro, o ciclo amplifica o viés inicial: qualidade de anotação inicial ruim ou regras de rotulagem sistematicamente enviesadas, e quanto mais rápido ele gira, mais rápido o viés se amplifica. Certa vez vi um projeto de detecção de anomalias em separação onde a "embalagem levemente amassada" foi massivamente rotulada como "avariada" no início; após o lançamento, o modelo ficou cada vez mais rigoroso, a taxa de falsos bloqueios subiu sem parar, e a operação acabou desligando o bloqueio automático. Um ciclo não tem senso de direção — ele apenas acelera.
Esses três julgamentos formam um arcabouço para julgar se um cenário vale a aposta no ciclo:
| Dimensão | Cenário favorável ao ciclo | Cenário hostil ao ciclo |
|---|---|---|
| Densidade de dados | Ações repetitivas de alta frequência, p. ex. picking | Ações de cauda longa de baixa frequência, p. ex. inventários rotativos |
| Velocidade do ciclo de feedback | Verificável em minutos a horas, p. ex. sucesso da pegada | Resultados conhecidos só após meses, p. ex. tendências de demanda |
| Custo de rotulagem | Produzido naturalmente pelo processo, p. ex. revisões manuais | Requer anotadores dedicados offline |
| Estabilidade do cenário | SKUs e processos estáveis no longo prazo | Mudanças frequentes de sortimento e realocações |
| Escala inicial de dados | Anos de dados históricos acumulados | Arranque a frio do zero |
Se um cenário cair na coluna da direita em três ou mais dessas cinco dimensões, "quanto mais é usado, mais preciso se torna" é muito provavelmente apenas uma visão — resolva o arranque a frio e o desenho do ciclo fechado antes de investir.
Três rotas de recuperação para os retardatários
O fosso do pioneiro não significa que os retardatários não tenham caminho. Vejo três rotas viáveis. Primeira, modelos pré-treinados mais ajuste fino leve. Os grandes modelos de visão estão mudando o jogo: a detecção de avarias que antes exigia centenas de milhares de imagens rotuladas agora pode alcançar precisão utilizável com ajuste fino em alguns milhares de imagens do próprio armazém do operador. Mas isso ajuda pouco a previsão de demanda, que precisa da profundidade do histórico próprio do local. Segunda, alianças de dados. Um armazém de médio porte sozinho não consegue sustentar um ciclo, mas dezenas compartilhando dados operacionais desidentificados podem montar um conjunto de treinamento significativo. Alguns 3PL europeus já experimentam assim: os dados nunca saem dos sistemas de cada empresa; apenas gradientes do modelo ou características desidentificadas são compartilhados. A dificuldade não é técnica, mas de confiança e partilha de benefícios. É um problema de negócio, não de IA. Terceira, competição assimétrica: escolher cenários onde os ciclos não conseguem girar. Armazéns de produtos não padronizados, armazéns que atendem à manufatura personalizada, armazéns de fast fashion com alta rotatividade — os dados depreciam tão rápido ali que a vantagem histórica dos pioneiros em grande parte evapora. Retardatários que começam aqui partem da mesma linha de largada. Um fosso só existe onde um fosso pode ser cavado.
Uma linha do tempo para os próximos três a cinco anos
Meus julgamentos abaixo se apoiam na inclinação histórica das curvas de capacidade dos modelos, no custo decrescente da anotação e no ritmo de penetração da automação de armazéns nos últimos cinco anos — julgamentos falsificáveis, com carimbo de tempo, que vocês estão convidados a revisitar em alguns anos.
De 2026 a 2028: os modelos pré-treinados para IA de visão em armazéns se tornam equipamento padrão; operadores de médio porte compram inspeção por visão "nota oitenta" a custo moderado, e a vantagem do pioneiro aqui se dilui visivelmente. Enquanto isso, a vantagem na previsão de demanda continua se ampliando — ela é decidida pela profundidade acumulada durante anos nos dados próprios do local, onde os modelos pré-treinados não podem ajudar.
De 2028 a 2030: alianças de dados regionais ou por categoria emergem, e os 3PL líderes começam a trocar "dados por serviços de algoritmo". Os algoritmos continuam se commoditizando, e o prêmio sobe para as equipes de "engenharia de dados mais operações de ciclo fechado" — as pessoas pelas quais valerá a pena pagar não serão mais as que sabem ajustar modelos, mas as que sabem fazer o ciclo girar.
Encerro com uma pergunta aberta: se os dados são realmente o fosso, sua água pertence a quem o cavou, ou a cada pedaço de terra por onde ela flui? À medida que tanto as alianças de dados quanto a regulação entram em cena, quanto ainda valerão daqui a cinco anos as cartas dos pioneiros de hoje? Não existe uma resposta padrão — mas quem aposta na IA em armazéns deveria ter primeiro resolvida a sua.
Por Dr. Chen, pesquisador de cadeia de suprimentos
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.