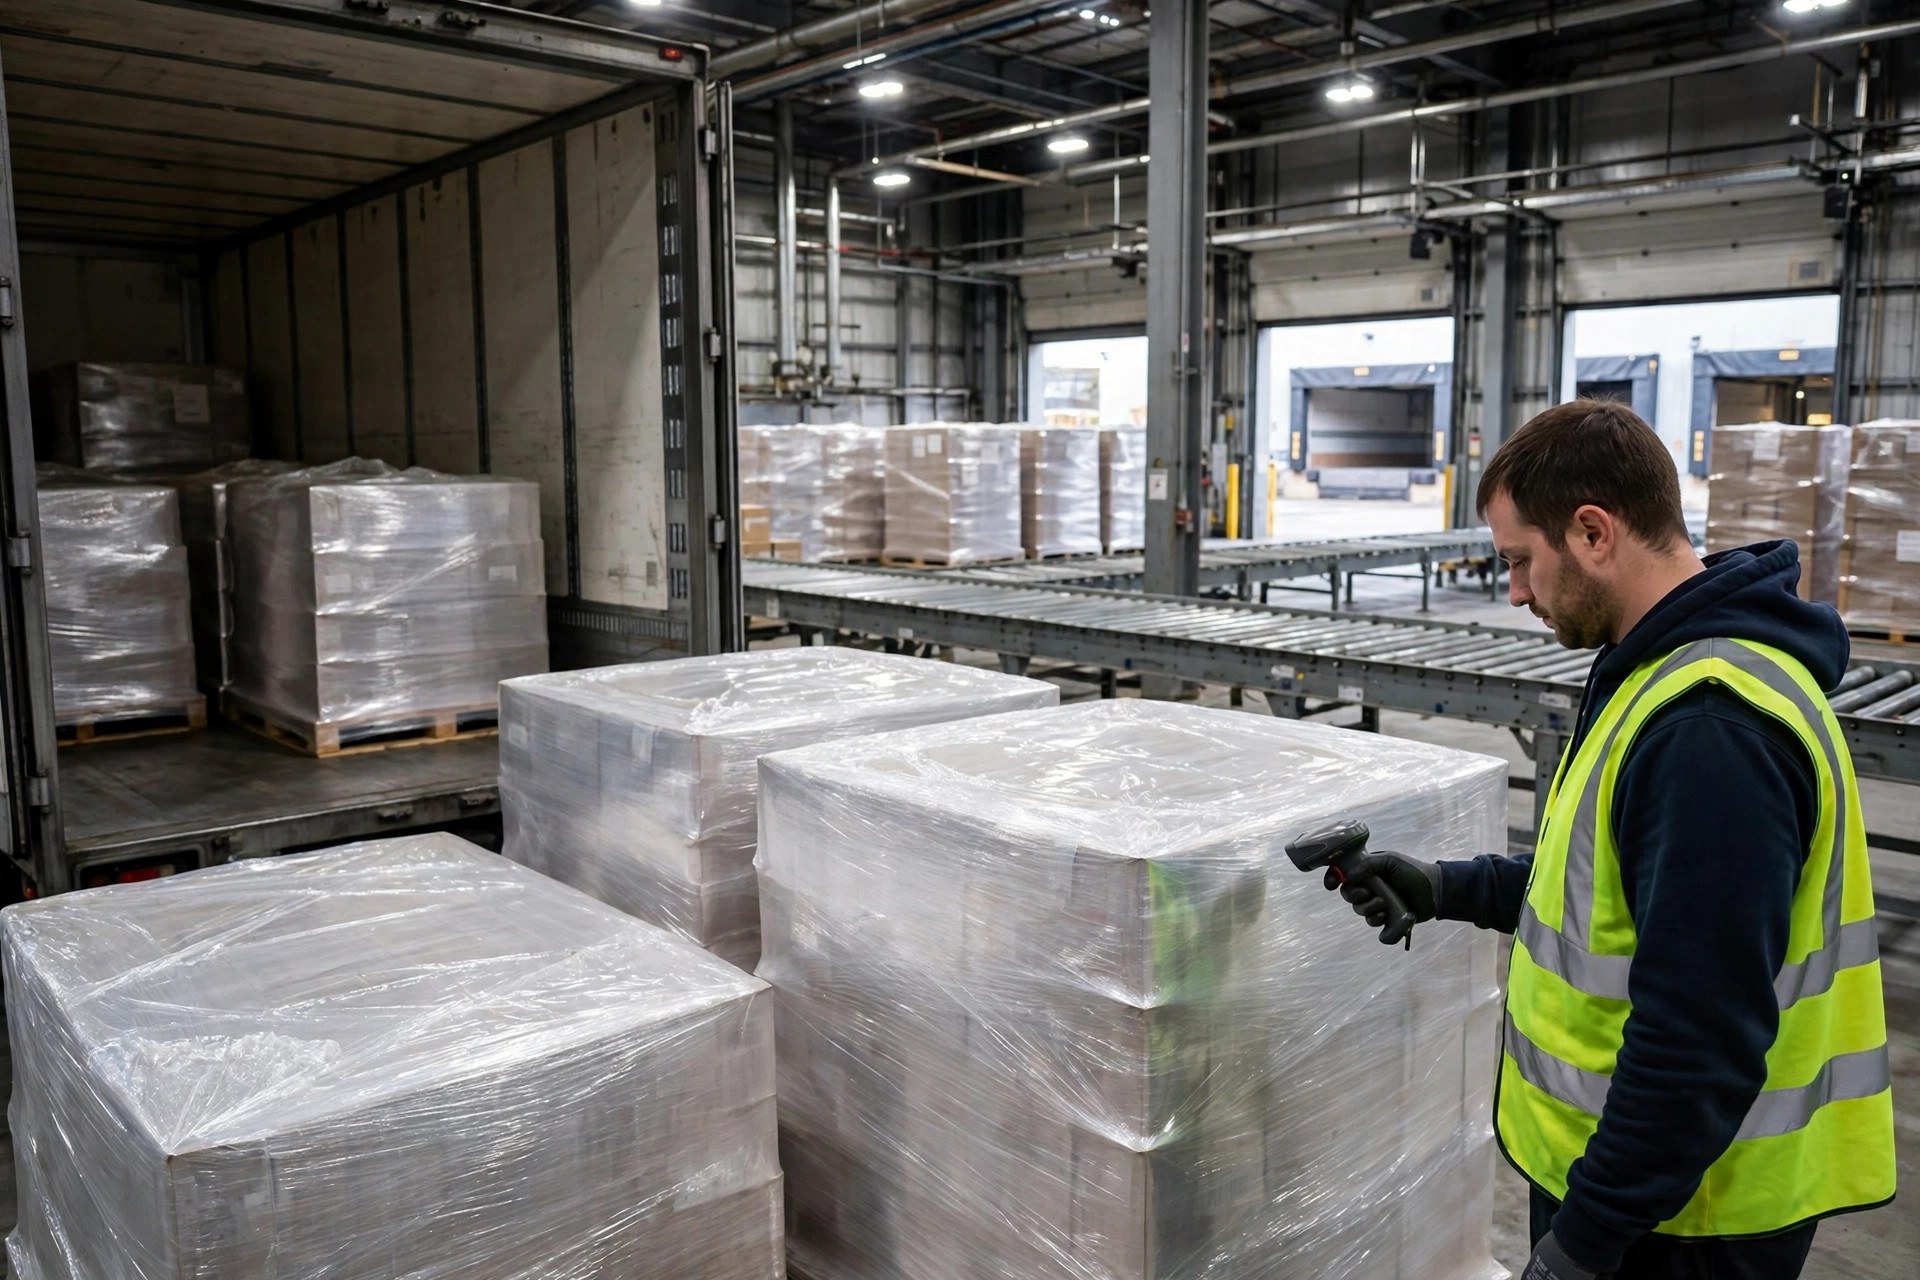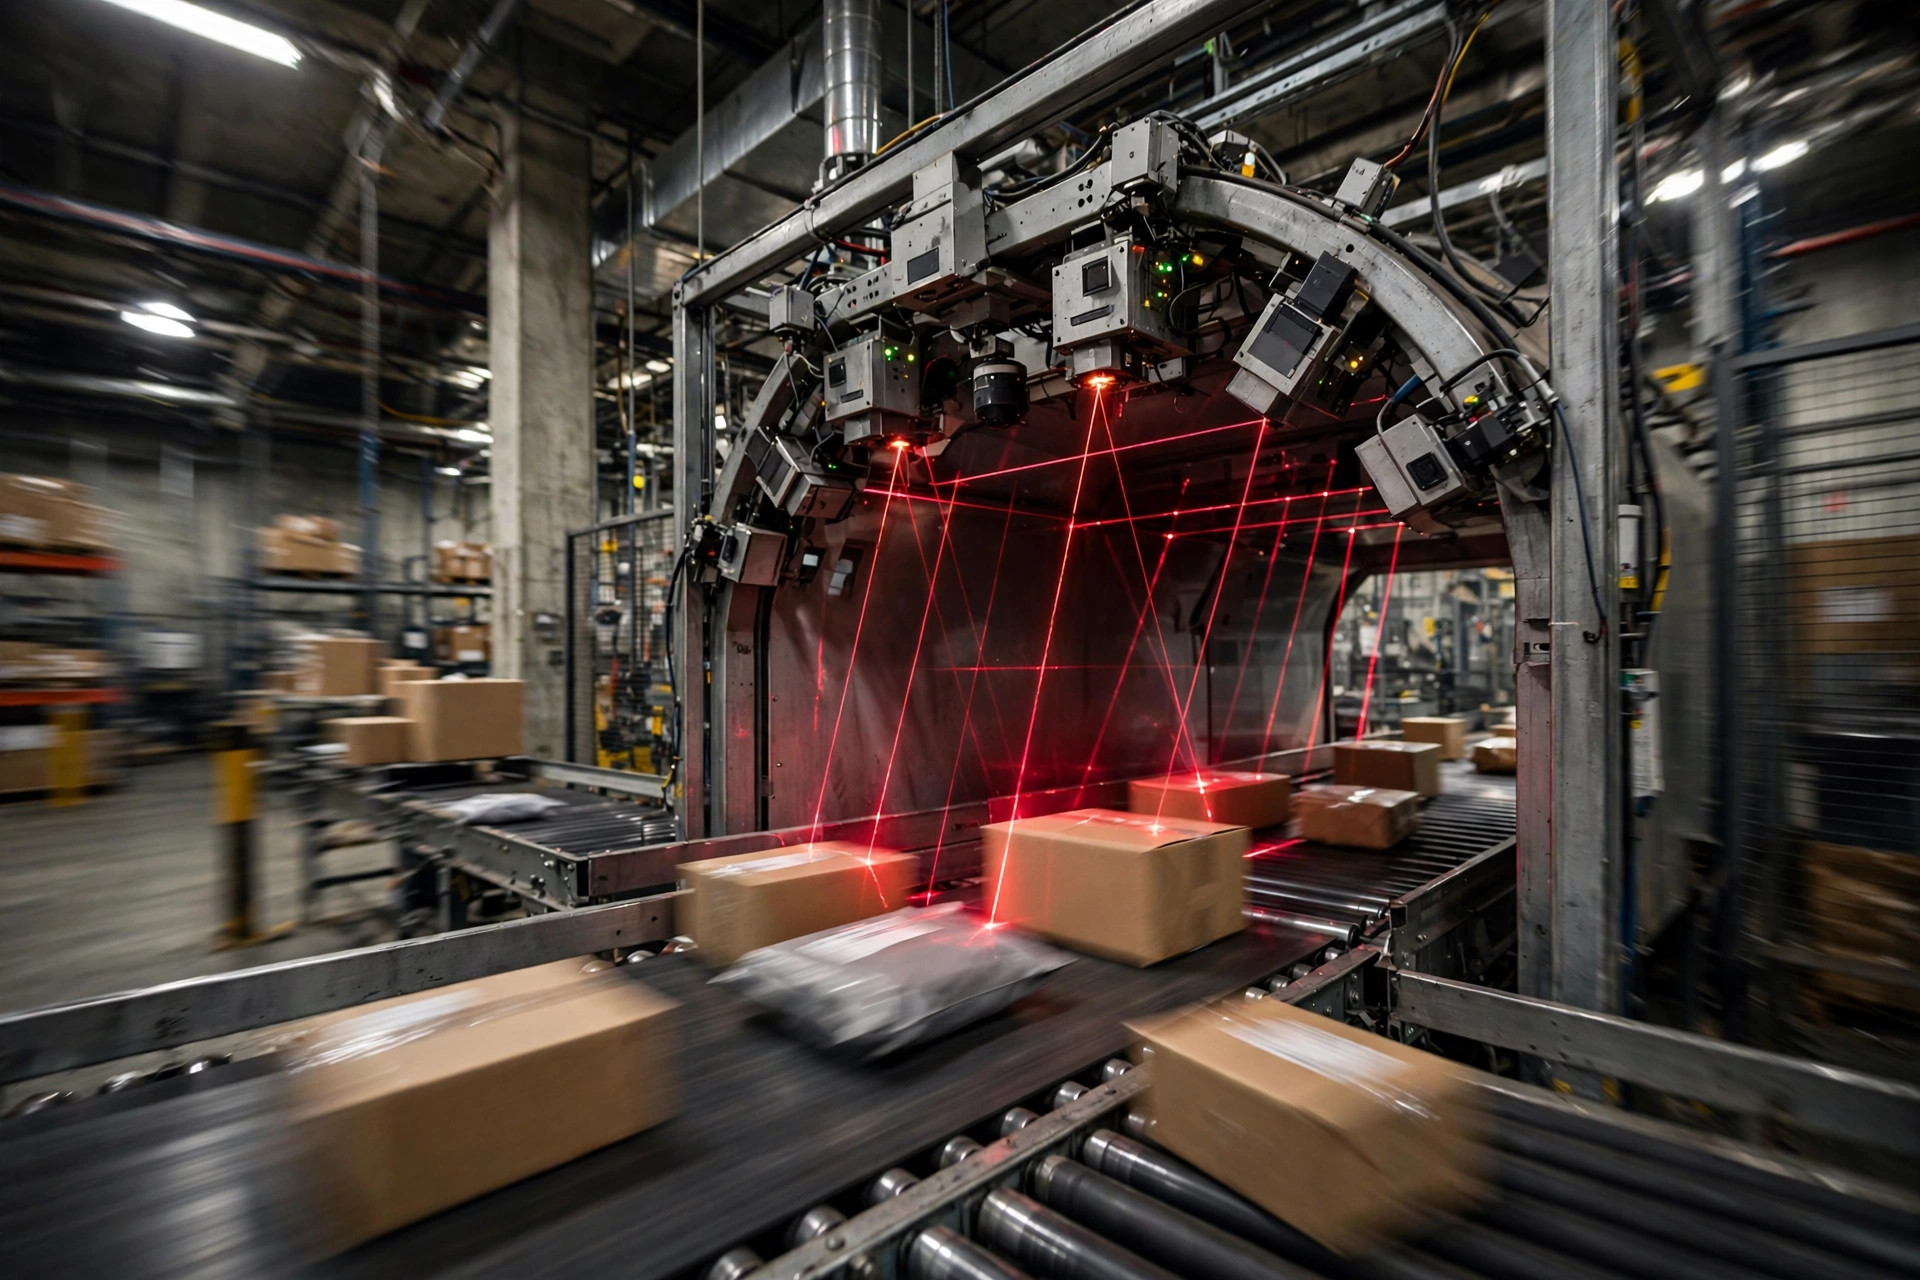
8:40 AM. A troca de turno tinha acabado de terminar quando o gerente de operações enfiou o celular na minha cara. Na tela: o relatório da noite passada da taxa de leitura de códigos de barras do classificador do armazém — 98.2%, em vermelho. As primeiras palavras dele: "Os cabeçotes de leitura estão morrendo? Devemos substituí-los?"
Eu trabalho com integração de automação há mais de uma década, e já tive exatamente essa conversa pelo menos cinquenta vezes. Cada vez, começo com o mesmo balde de água fria: ainda não condenem os cabeçotes de leitura. Quando a taxa de leitura cai para 98%, nove vezes em dez a culpa não está no scanner — está naquela pequena etiqueta de expedição. Hoje vamos fazer o acerto de contas direito: o princípio, a linha divisória e as armadilhas de manutenção. Tudo de uma vez.
Como a taxa de leitura é realmente calculada
Primeiro o princípio. Sem ele, toda discussão é superstição.
Pense como a câmera de um pedágio numa rodovia: o pacote é o carro, atravessando a zona de leitura a cerca de 2 metros por segundo; o cabeçote de leitura é a câmera, com uma janela de uma fração de segundo para "ler a placa". Ou imagine um professor fazendo chamada: de 100 nomes, 98 respondem "presente" e 2 ficam em silêncio — o classificador não sabe para onde vão esses 2 pacotes, então os desvia para a rampa de não leitura e espera um humano vir buscá-los.
A fórmula é simples: taxa de leitura = pacotes lidos com sucesso ÷ total de pacotes que passaram pela zona de leitura.
Note o denominador: "que passaram por ali". Pacotes travados na esteira ou retidos por uma parada de emergência não contam. Então o número do relatório sempre parece um pouco melhor do que o que você sente no chão de fábrica — essa é a armadilha número um. O relatório diz 98.2%; o seu instinto diz que mal chega a 97%.
Neste setor, os critérios de aceitação de um classificador costumam ser escritos em 99.5% ou mais (verifique a especificação do fornecedor do equipamento e o seu contrato). Cair de 99.5% para 98% parece só 1.5 ponto, mas o número de pacotes não lidos triplica. Essa é a armadilha número dois: a taxa de leitura é uma "taxa de sucesso", mas o seu custo vive na "contagem de falhas" — e a contagem de falhas é brutalmente sensível a mudanças minúsculas de ponto.
Abaixo de 98%, cada décimo de ponto é dinheiro
Pacotes não lidos não andam sozinhos até a rampa. Cada um precisa de manuseio manual: tirá-lo da rampa de exceções, ler a etiqueta, reescaneá-lo com uma pistola manual, devolvê-lo à esteira. Um operador experiente leva cerca de 45 segundos por pacote — essa é a norma.
Vamos fazer as contas para um armazém que movimenta 30,000 pacotes por dia (mão de obra na escala típica de um armazém americano de vinte e poucos dólares por hora, 300 dias úteis por ano):
| Taxa de leitura | Pacotes não lidos por dia | Horas manuais por dia | Custo anual de mão de obra |
|---|---|---|---|
| 99.5% | 150 | ~1.9 hrs | ~$12,000 |
| 99.0% | 300 | ~3.8 hrs | ~$25,000 |
| 98.0% | 600 | ~7.5 hrs | ~$50,000 |
Viu? Deslizar de 99.5% para 98% queima quase $40,000 por ano em mão de obra extra — antes mesmo de contar as horas extras de alta temporada e o custo em cascata das reclamações por expedição errada. Por isso eu digo: cada 0.1 ponto de taxa de leitura é dinheiro de verdade.
Qualidade de impressão: uma divisão de responsabilidade em três partes
Dinheiro acertado. Agora, de quem é o problema? Em campo eu sempre triago nesta ordem: o lado da impressão → o lado da aplicação → o lado da leitura. O lado da leitura vai por último, porque é o mais caro — e o culpado menos provável.
Primeiro, o lado da impressão: é aqui que vivem 80% dos problemas.
A qualidade de impressão de códigos de barras tem uma norma internacional, a ISO 15416, que classifica os códigos de A a F. Num ambiente de classificação, C é o mínimo e B é onde você dorme tranquilo à noite. Um cabeçote de impressão sujo, escuridão configurada baixa demais, uma troca por um ribbon barato — e as barras começam a se quebrar e desbotar, derrubando a nota direto para D. Nenhum cabeçote de leitura, por mais caro que seja, consegue ler um código de barras quebrado.
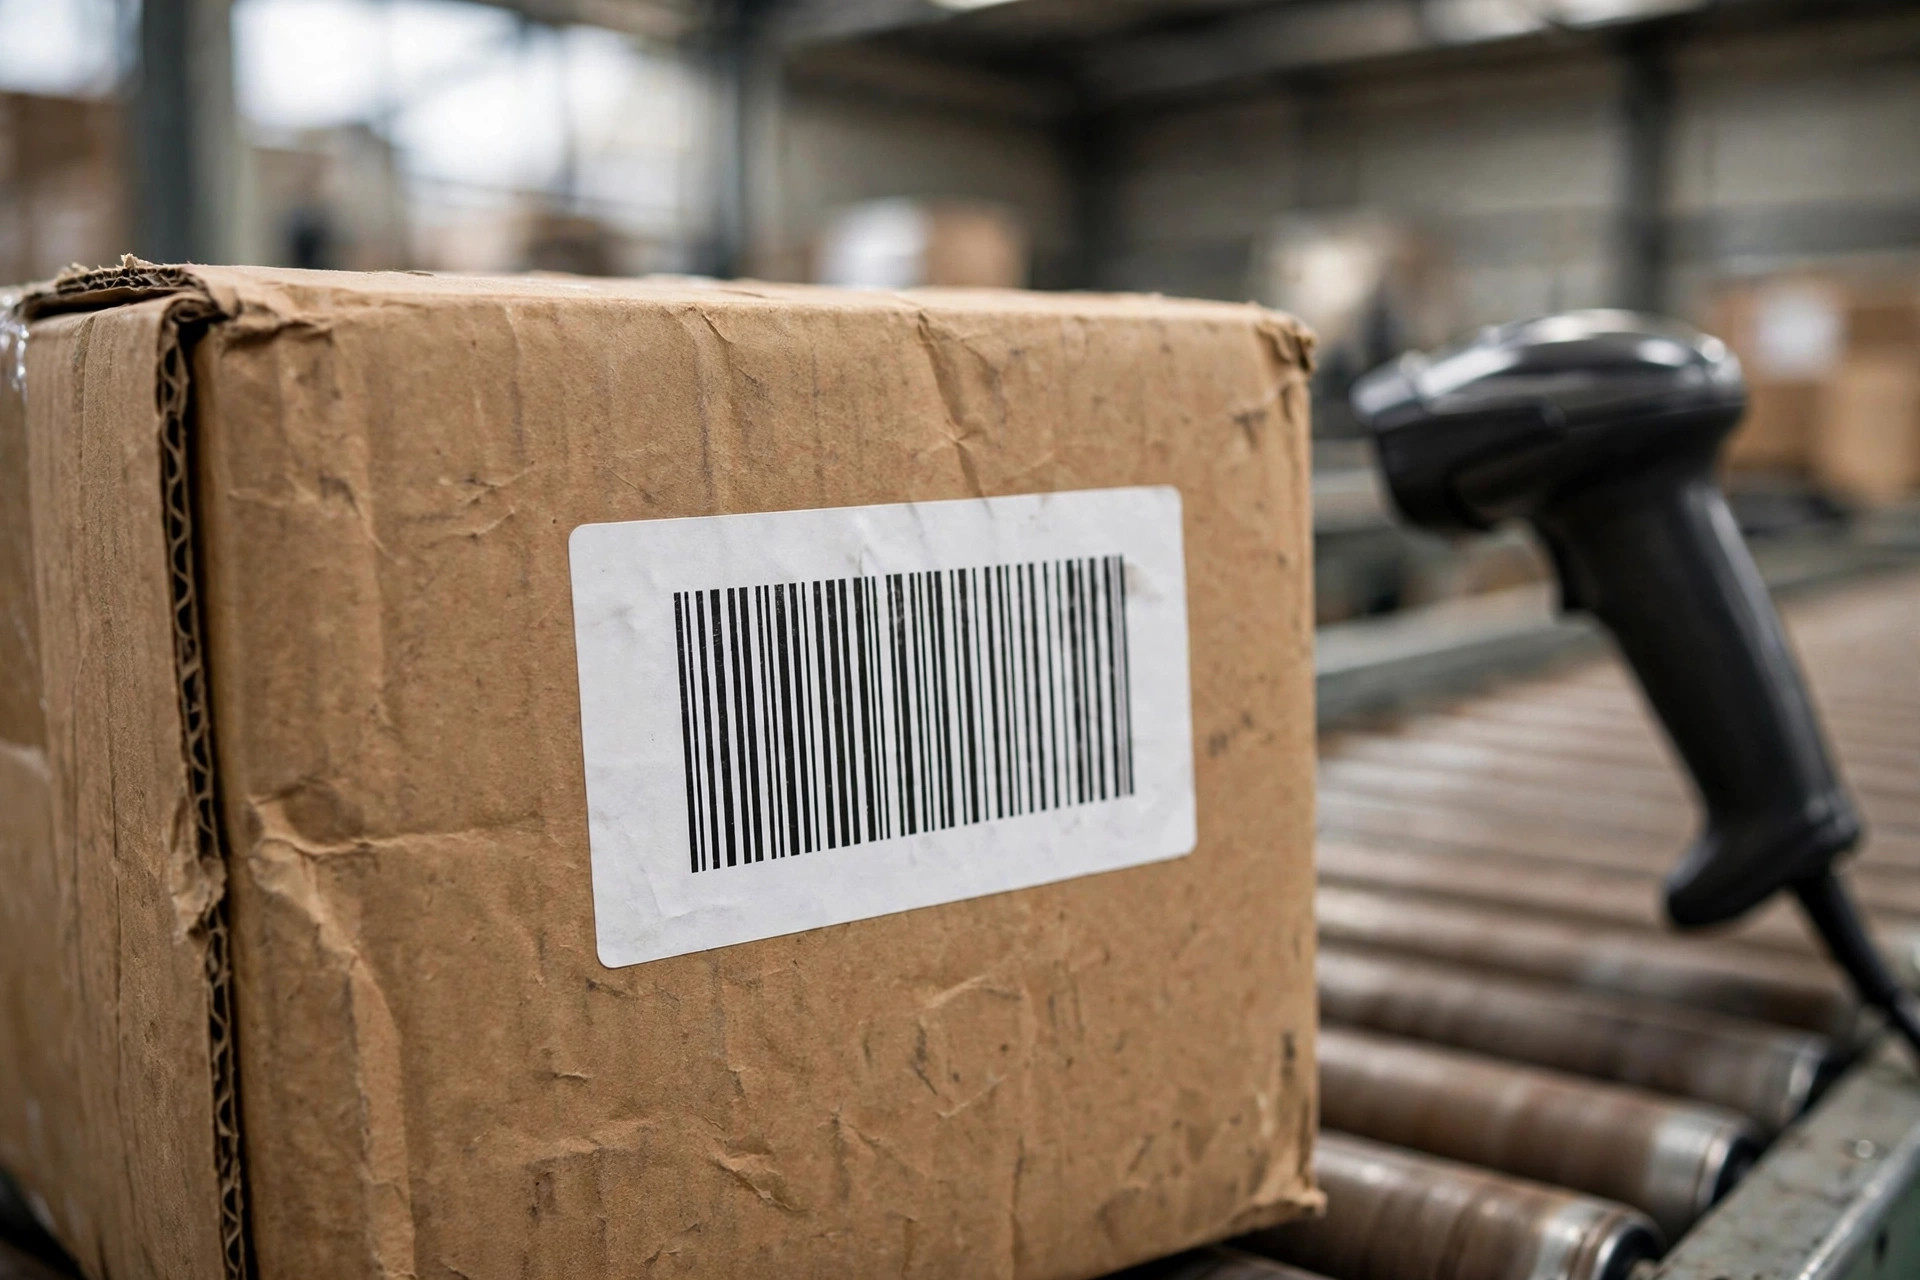
Em 2023, um armazém de e-commerce de vestuário no leste da China — cerca de 25,000 pacotes por dia — viu sua taxa de leitura deslizar de 99.4% para 98.1%. A operação culpou o envelhecimento dos cabeçotes de leitura; o integrador orçou uma melhoria do conjunto de leitura. Meu primeiro passo no local não foi olhar os cabeçotes de leitura. Pedi 20 etiquetas não lidas e passei-as por um verificador de códigos de barras — cada uma delas tirou nota D. Investigando mais: os cabeçotes de impressão não eram limpos havia três meses, e alguém tinha trocado por um ribbon barato cujo preto simplesmente não era preto o bastante. Limpei os cabeçotes de impressão, voltei ao ribbon original, subi a escuridão um ponto. Três dias depois: 99.5%. Nem um centavo em hardware novo.
Segundo, o lado da aplicação: uma etiqueta torta desperdiça até a impressão perfeita.
Em 2024, um armazém 3PL no Meio-Oeste americano instalou um aplicador automático de etiquetas e ficou travado em 98.3%. As etiquetas em si tiravam um belo B. O problema era que a roda-guia do aplicador tinha se deslocado — as etiquetas continuavam caindo sobre a emenda da fita da caixa, e quando a fita se comprimia e enrugava, o código de barras enrugava junto. A solução foi quase constrangedoramente simples: ajustei a roda-guia em 3 milímetros e reduzi a etiqueta um tamanho para desviar da emenda. Duas semanas depois: 99.4%.
Lembre-se deste hábito de inspeção: com uma etiqueta não lida, verifique "onde ela foi colada" primeiro, e depois "como foi impressa". Posição errada — culpa do aplicador. Posição certa, mas ilegível — culpa da impressora.
Terceiro, o lado da leitura: verifique por último, mas verifique direito.
Lentes empoeiradas, tubos de laser no fim da vida útil (os fornecedores costumam especificar MTBF na casa das dezenas de milhares de horas — verifique o datasheet), deriva de foco nos cabeçotes de leitura — a chance de serem o verdadeiro culpado é menor que 10%. Mas quando são, a conta de substituição é séria. Então minha regra continua valendo: descarte primeiro a impressão e a aplicação, depois mexa nos scanners.
Hora do desabafo. Toda vez que as taxas de leitura caem, alguém propõe duas "soluções": "melhorar os cabeçotes de leitura de 4 lados para 6 lados" ou "adicionar rechecagem por visão de IA". Ambas soam avançadas. Ambas são pseudo-requisitos. Um código de barras quebrado também parece quebrado de seis lados; uma impressão nota D também é ilegível para a IA — a IA não faz adivinhação. Leve sua qualidade de impressão acima da nota B primeiro, depois fale de melhorias. Isso é gastar pouco dinheiro para resolver um grande problema. Inverta a ordem e você estará gastando muito dinheiro para resolver um pequeno.
A triagem de 30 minutos (pegue, é grátis):
- Pegue 20 etiquetas não lidas aleatórias e passe-as por um verificador de códigos de barras. Abaixo da nota C — lado da impressão, caso encerrado.
- Olhe a distribuição horária das não leituras. Agrupadas após trocas de turno ou trocas de ribbon — consumíveis ou fatores humanos.
- Olhe as fotos das etiquetas. Tortas, enrugadas, refletivas — lado da aplicação.
- Nada disso — agora verifique as lentes e o foco do scanner.
Vale o dinheiro? Olhe este único número
Pare de perguntar "devemos substituir os cabeçotes de leitura?" Pergunte-se um número: qual é a sua taxa de não leitura? Deslizar de 99.5% para 98% queima $40,000 por ano em mão de obra — enquanto um verificador de códigos de barras manual custa algumas centenas de dólares e limpar um cabeçote de impressão não custa nada. Qual você faz primeiro? Não é uma decisão difícil.
A taxa de leitura é como a pressão arterial num exame físico: quando o número parece ruim, a causa raiz raramente é o coração — é o estilo de vida. A etiqueta é o estilo de vida do classificador.
Por Da Liu, Engenheiro de Automação
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.