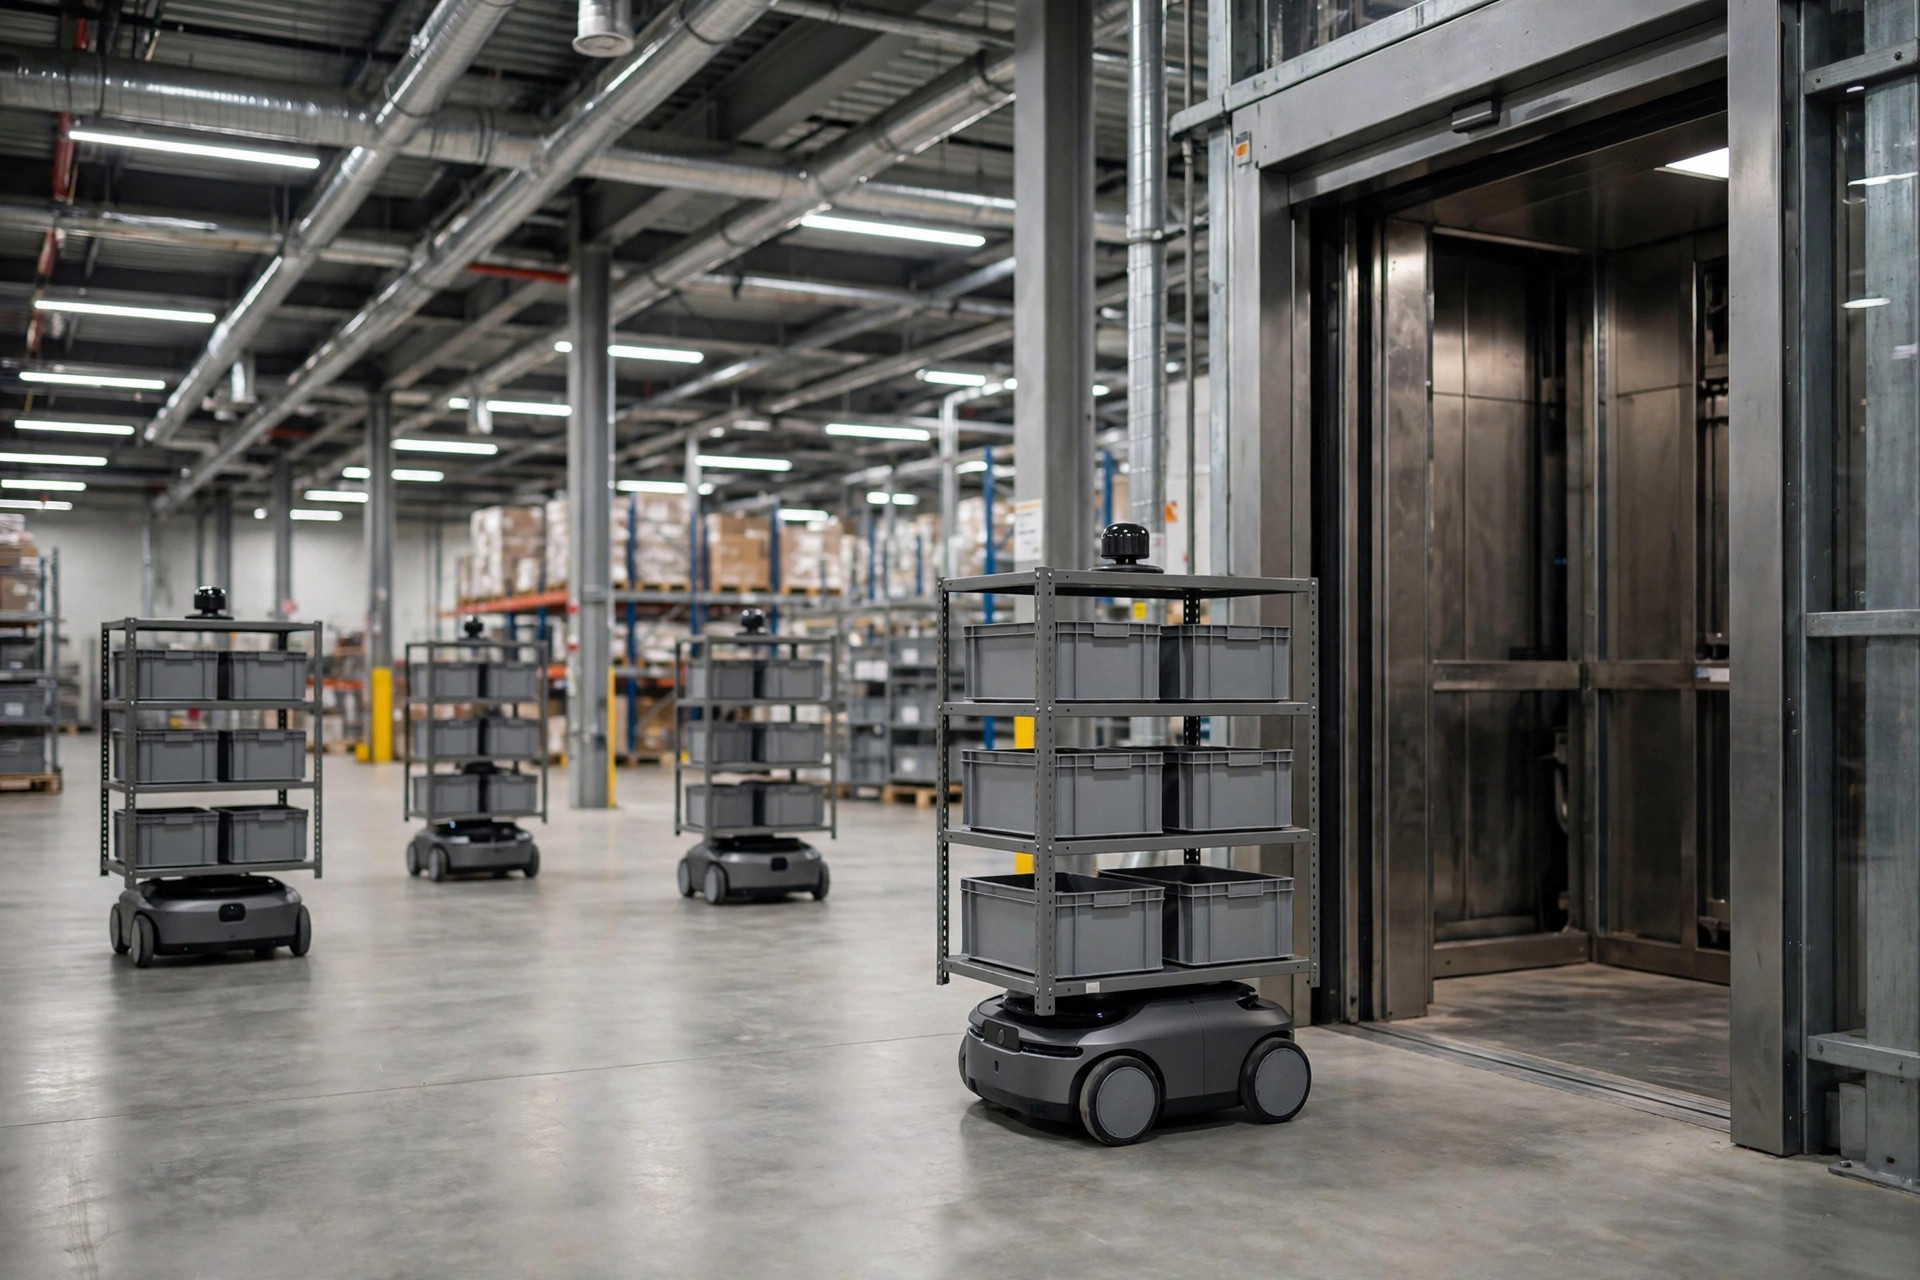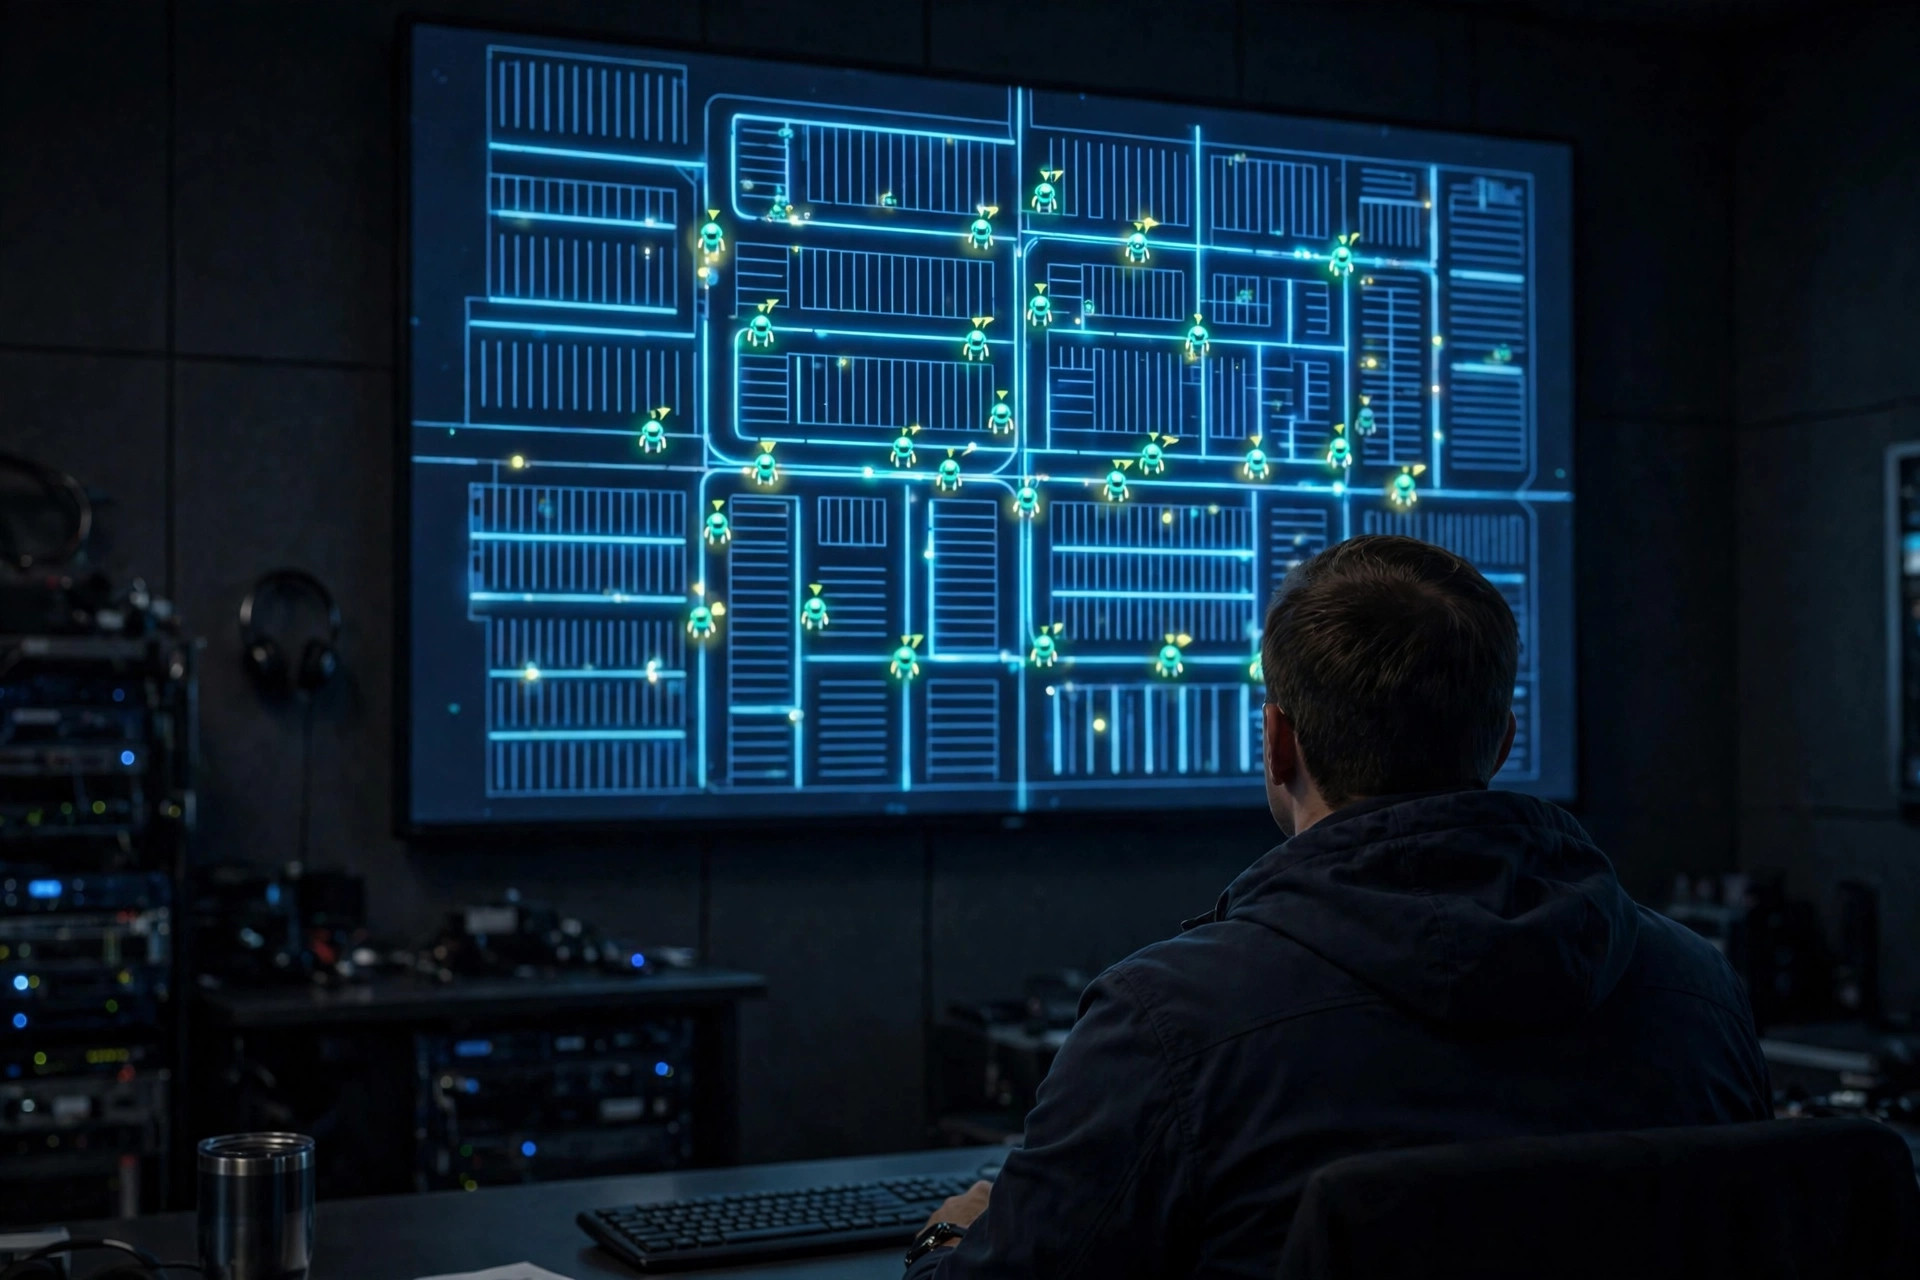
Pergunte a qualquer fornecedor de AMR o que acontece quando a rede cai e veja a sala ficar em silêncio. A demonstração sempre mostra o caminho feliz: robôs deslizando, tarefas sendo distribuídas, o painel brilhando em verde. Ninguém demonstra a ligação telefônica das 2 da manhã. Mas eu já recebi essa ligação, e a diferença entre uma noite ruim e um desastre nunca foram os robôs — foram três configurações em que ninguém tinha pensado.
No inverno passado, um centro de distribuição nos arredores de Chicago perdeu seu RCS por cerca de quinze minutos durante uma reinicialização de rotina de um switch. Cerca de vinte robôs congelaram no meio do corredor. A equipe da noite fez o que pessoas sem treinamento fazem: começou a reiniciar os robôs um por um, o que só embaralhou ainda mais os estados das tarefas. Quando a rede voltou, metade da frota mostrava "offline" e a outra metade "task exception", e levou quase duas horas para desembaraçar. Os robôs estavam bem. O que faltava era o plano.
Eis a verdade incômoda: o enlace robô-RCS é o enlace cérebro-corpo, e cada fornecedor entrega padrões diferentes para o que o corpo faz quando o cérebro silencia. Se esses padrões não estão no seu contrato, você está comprando uma surpresa.
Ninguém testa a rede até ela morrer
A primeira configuração é o comportamento na perda de enlace: quanto tempo sem batimento cardíaco até o robô declarar a rede morta, e o que ele faz em seguida. Se o tempo limite for curto demais, cada microcorte de Wi-Fi dispara uma parada de emergência na planta inteira. Se for longo demais, uma rede verdadeiramente morta deixa os robôs rodando com instruções obsoletas.
Após o tempo limite, os fornecedores geralmente oferecem duas filosofias. A conservadora: pare onde está e espere. Serve para prédios com tráfego misto de pessoas e robôs e corredores complexos. A agressiva: mude para o modo local, termine a tarefa atual a partir do cache do mapa embarcado e depois estacione em algum lugar fora do caminho. Parece mais esperto, mas tem uma pegadinha — o mapa local precisa estar atualizado. Se o RCS tinha acabado de emitir uma zona de exclusão temporária e o robô não a tinha sincronizado antes da queda, o modo local o levará direto para um corredor bloqueado.
Minha opinião: prédios com tráfego misto devem parar no lugar; linhas de produção fechadas de rota fixa podem considerar a continuação local. De qualquer forma, a velocidade reduzida não é negociável — um robô rodando às cegas deve rodar mais devagar que o normal. Coloque isso por escrito nos seus critérios de aceitação.
E uma palavra sobre a própria rede: a maioria das "quedas" não são redes mortas, são pontos mortos. Um robô transitando entre dois pontos de acesso falha na transferência, o batimento cardíaco falha por alguns segundos e o RCS o declara perdido. Conecte os servidores do RCS por cabo — não os obrigue a disputar o Wi-Fi com os robôs. Adicione redundância à cobertura dos APs e verifique os cantos e a parte de trás das estantes altas. Antes do go-live, circule a frota por todo o prédio em um teste de roaming e corrija primeiro os pontos fracos. Isso supera de longe ajustar os tempos limite depois.
As três configurações enterradas no seu contrato
A segunda configuração é a fila de tarefas: o que o robô lembra e quem ganha a discussão quando a rede volta. Embarcado, um robô normalmente guarda em cache sua tarefa atual mais uma ou duas tarefas na fila — a profundidade do cache varia por fornecedor. Cache raso significa que uma queda de mais de alguns minutos apaga a lista de tarefas, e o RCS precisa redistribuir tudo após a recuperação. Cache profundo significa que o robô continua trabalhando de memória por mais algum tempo.
A verdadeira armadilha é o momento do reencontro. O RCS acorda lembrando o mundo como era antes da queda; os robôs guardam o trabalho que fizeram durante a queda. Alguns sistemas conciliam do lado do robô — o robô reporta, o RCS aceita, as tarefas retomam de onde pararam. Outros conciliam do lado do RCS — tudo da janela da queda é anulado e redistribuído. Nesse segundo desenho, o palete que um robô já entregou na linha aparece como "not delivered", e o sistema envia outro. Entrega dupla, dois paletes na linha e uma discussão sobre de quem é a culpa.
Então, antes de assinar: quando a rede se recupera, qual estado de tarefa prevalece e como as execuções duplicadas são deduplicadas? Coloque ambas as respostas em um anexo do contrato. Durante a seleção, não se limite a assistir à demonstração do caminho feliz — peça ao fornecedor para demonstrar uma queda de rede de cinco minutos e a recuperação, e observe se a lógica de conciliação se sustenta. A hesitação nessa demonstração diz tudo.
A terceira configuração é a tomada de controle manual: quem pode colocar um robô no manual, como e o que acontece depois. Quando a queda se arrasta, sempre haverá alguém no chão pensando "vou só dirigir eu mesmo". Sem uma regra, você tem três turnos fazendo três coisas diferentes — empurrando robôs, ligando e desligando, arrancando baterias. Eu vi exatamente isso uma vez: após a recuperação, ninguém conseguia dizer quais robôs estavam no meio de uma tarefa e quais estavam apenas perdidos, porque humanos tinham tocado metade da frota.
A correção é chata e essencial: nomeie um comandante de queda por turno, geralmente o líder do turno. Ninguém mais toca em um robô — sem movimentos manuais, sem ciclos de energia. Após a recuperação, o comandante percorre uma lista de verificação, confirma o estado de cada robô e só então emite o comando de retomada. Escreva isso no manual de operação e ensine na integração. E mantenha o privilégio restrito: a autoridade do modo manual vai para os líderes, não para todos. Os operadores precisam de visibilidade do status, não das chaves.
O que me leva ao teste de aceitação que mais importa. Na semana do go-live, puxe o plugue de verdade — não uma apresentação de slides, não uma demonstração de laboratório, mas o cabo de rede real, no seu prédio real, durante a produção real. Observe cada robô: quantos segundos para declarar a perda, parar ou continuar, até onde vai, se as tarefas se conciliam na recuperação, se algo é distribuído em duplicidade. Anote tudo. Esse documento é o primeiro rascunho do seu manual de quedas.
Depois faça isso trimestralmente, como um simulado de incêndio. O equipamento de rede envelhece, o RCS é atualizado, o firmware dos robôs muda — qualquer um deles pode silenciosamente inverter um padrão. Escolha uma janela de baixa produção, puxe o cabo por dez minutos e confirme que o manual ainda funciona.
Uma queda não é o desastre. Descobrir seu plano de contingência pela primeira vez no auge da temporada, sim. Ensaie antes de precisar, e as ligações das 2 da manhã ficam muito mais curtas.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.