A resposta curta: sim, dá para atualizar um WMS sem parar o armazém — mas isso não tem nada a ver com sorte. Antes da noite da atualização, você precisa de três coisas resolvidas: um snapshot ao qual você realmente possa voltar, uma ordem de implantação que vá do site de menor risco ao de maior risco, e uma lista de verificação pós-atualização que leva cerca de quatro horas para percorrer. Pule qualquer uma delas, e você está apostando. Já vi essa aposta perder três vezes, e em todas o preço foi uma doca de expedição parada.
Um esclarecimento antes de começar: estamos falando do WMS — o sistema de gerenciamento de armazém que roda pedidos, estoque e alocação de tarefas. Não do WCS, o sistema de controle de armazém que aciona esteiras e pontes rolantes por sinais de PLC. Atualizações de WCS param equipamentos; atualizações de WMS param o fluxo de informação. Planejamentos diferentes, não os misture.
Novidades nunca quebram uma atualização de WMS — os periféricos sim
Em mais de 30 projetos de implementação e atualização, conto nos dedos as atualizações que falharam por causa de uma novidade. Cada falha real que vi veio dos mesmos três periféricos: scanners RF, modelos de etiqueta e integrações externas. Scanners mortos, etiquetas que não imprimem e uma conexão EDI silenciosa — isso é um armazém parado.
Um exemplo real. Em 2023, um 3PL operando uma instalação de 120.000 pés quadrados no Inland Empire, na Califórnia, fez uma atualização de versão menor. A atualização em si levou 40 minutos, e a TI postou "atualização concluída" no chat do grupo. Às 6h da manhã seguinte, os separadores bateram o ponto e encontraram as telas de tarefas desalinhadas nos seus coletores RF — a nova versão havia alterado um tamanho de campo que os clientes de scanner mais antigos não conseguiam interpretar. Mais de quatrocentos dispositivos, reinstalados um por um, das 6h ao meio-dia. Meio dia sem liberar uma única onda (wave). O dono do cliente ficou na doca vendo os caminhões se acumularem. Ainda me lembro da cara dele.
A lição cabe numa frase: na noite da atualização, validar os coletores RF, as impressoras e as integrações merece o mesmo peso que a atualização em si. Essa é a armadilha que vi três vezes, e em todas a história é a mesma — "a atualização deu certo, o armazém parou".
A lista da véspera: contrate primeiro três apólices de seguro
Apólice um: um snapshot completo. Um backup do banco de dados é o mínimo. Você também precisa exportar toda a configuração — estratégias de ondas, regras de numeração de endereços, modelos de etiqueta, permissões de usuário, mapeamentos de integração. Um snapshot de dados e um snapshot de configuração são duas coisas diferentes. Os dados se restauram do backup; uma estratégia mal configurada demora mais para corrigir.
Apólice dois: um plano de reversão tão bem escrito que dê para executar meio dormindo. Um plano de reversão útil responde três perguntas: quem chama a reversão (um nome, não "o gerente de projeto"); para que ponto se volta (o timestamp do snapshot); e quanto tempo a reversão leva (seu RTO). Nossa regra fixa: o time inteiro percorre os passos de reversão na noite anterior, como um simulacro de mesa. Um plano que ninguém ensaiou equivale a nenhum plano.
Apólice três: uma alternativa de negócio para o próprio tempo de inatividade. Folhas de separação em papel impressas com antecedência, scanners offline carregados, uma lista de contatos de emergência colada no chão de fábrica. Se chegar à reversão, o armazém precisa migrar para o modo manual em 30 minutos — esse é nosso padrão interno de projeto, não uma promessa do fornecedor. Escreva isso no seu próprio plano.
Sobre RTO e RPO, deixe-me ser preciso: a rapidez com que você consegue reverter e quantos dados pode se dar ao luxo de perder dependem de como você tira o snapshot — não do que diz o SLA do fornecedor. Nossa regra prática: tire um snapshot completo logo antes de começar a atualização, mire um RTO de reversão abaixo de duas horas, e um RPO de zero perda de dados (tudo criado depois do snapshot é redigitado a partir do rastro em papel). Se você não consegue cumprir isso, não agende a atualização na alta temporada.
A ordem de implantação multi-site
Para clientes multi-site, a ordem de implantação:
| Onda | Qual site primeiro | Por quê | Janela de observação |
|---|---|---|---|
| 1 | Site de teste / ambiente sombra | Se explodir, o negócio nem percebe | Pelo menos um ciclo de onda completo |
| 2 | Site de menor volume | Validação com negócio real, risco contido | 24 horas |
| 3 | Site de volume médio | Amplia a amostra de validação | 48 horas |
| 4 | Site principal / de maior volume | Mexa nele por último | Vigilância presencial total |
Regra de ferro: a próxima onda não começa até a lista de verificação da onda anterior estar toda verde. Já vi essa armadilha três vezes — alguém decide que a onda um "parece boa" e dispara a onda dois em paralelo, então um bug de queima lenta aparece e dois sites caem juntos.
Agendando a janela de inatividade: planeje-a para o negócio, não para a TI
Uma janela de manutenção não é uma janela técnica da TI. É a janela que o negócio pode pagar. Três passos:
- Leia primeiro a curva de volume. Encontre a noite de menor volume numa janela móvel de sete dias. Para 3PLs, geralmente é domingo de madrugada; para sites de e-commerce, confira o calendário de promoções e fique a mais de 72 horas de qualquer venda.
- Depois faça as contas. Um número, calculado com honestidade: quanto custa uma hora de inatividade? Volume diário de pedidos ÷ 24 × margem por pedido × horas de inatividade, mais horas extras de recuperação e eventuais penalidades de SLA. Use seus próprios números. Esse valor é sua alavanca para pedir a janela — e para negociar a compensação com o fornecedor.
- Por fim, defina a linha de gatilho da reversão. Se as funções principais não forem restauradas X horas após o início da atualização, a reversão dispara automaticamente — sem "só mais 15 minutinhos". X vai para o plano, e ninguém pode mudá-lo naquela noite.
Aqui vai a visão contraintuitiva: a maioria dos times persegue o "zero downtime" e constrói deploys blue-green com escrita dupla que dobram a complexidade. Meu julgamento depois de mais de 30 projetos — para 90% dos armazéns, uma janela noturna bem planejada de duas a quatro horas é mais barata e segura do que a arquitetura de zero downtime. A complexidade do "nunca parar" é por si só o maior risco. Acerte o trade-off: o que você precisa é que o negócio nunca pare, não que o sistema nunca pare. Um armazém sobrevive duas horas com folhas de separação em papel. Não sobrevive a uma atualização de "zero downtime" que ninguém sabe consertar.
A validação de quatro horas pós-atualização: scanners, etiquetas, integrações
Ainda não declare vitória. Percorra esta lista, item por item, em quatro horas:
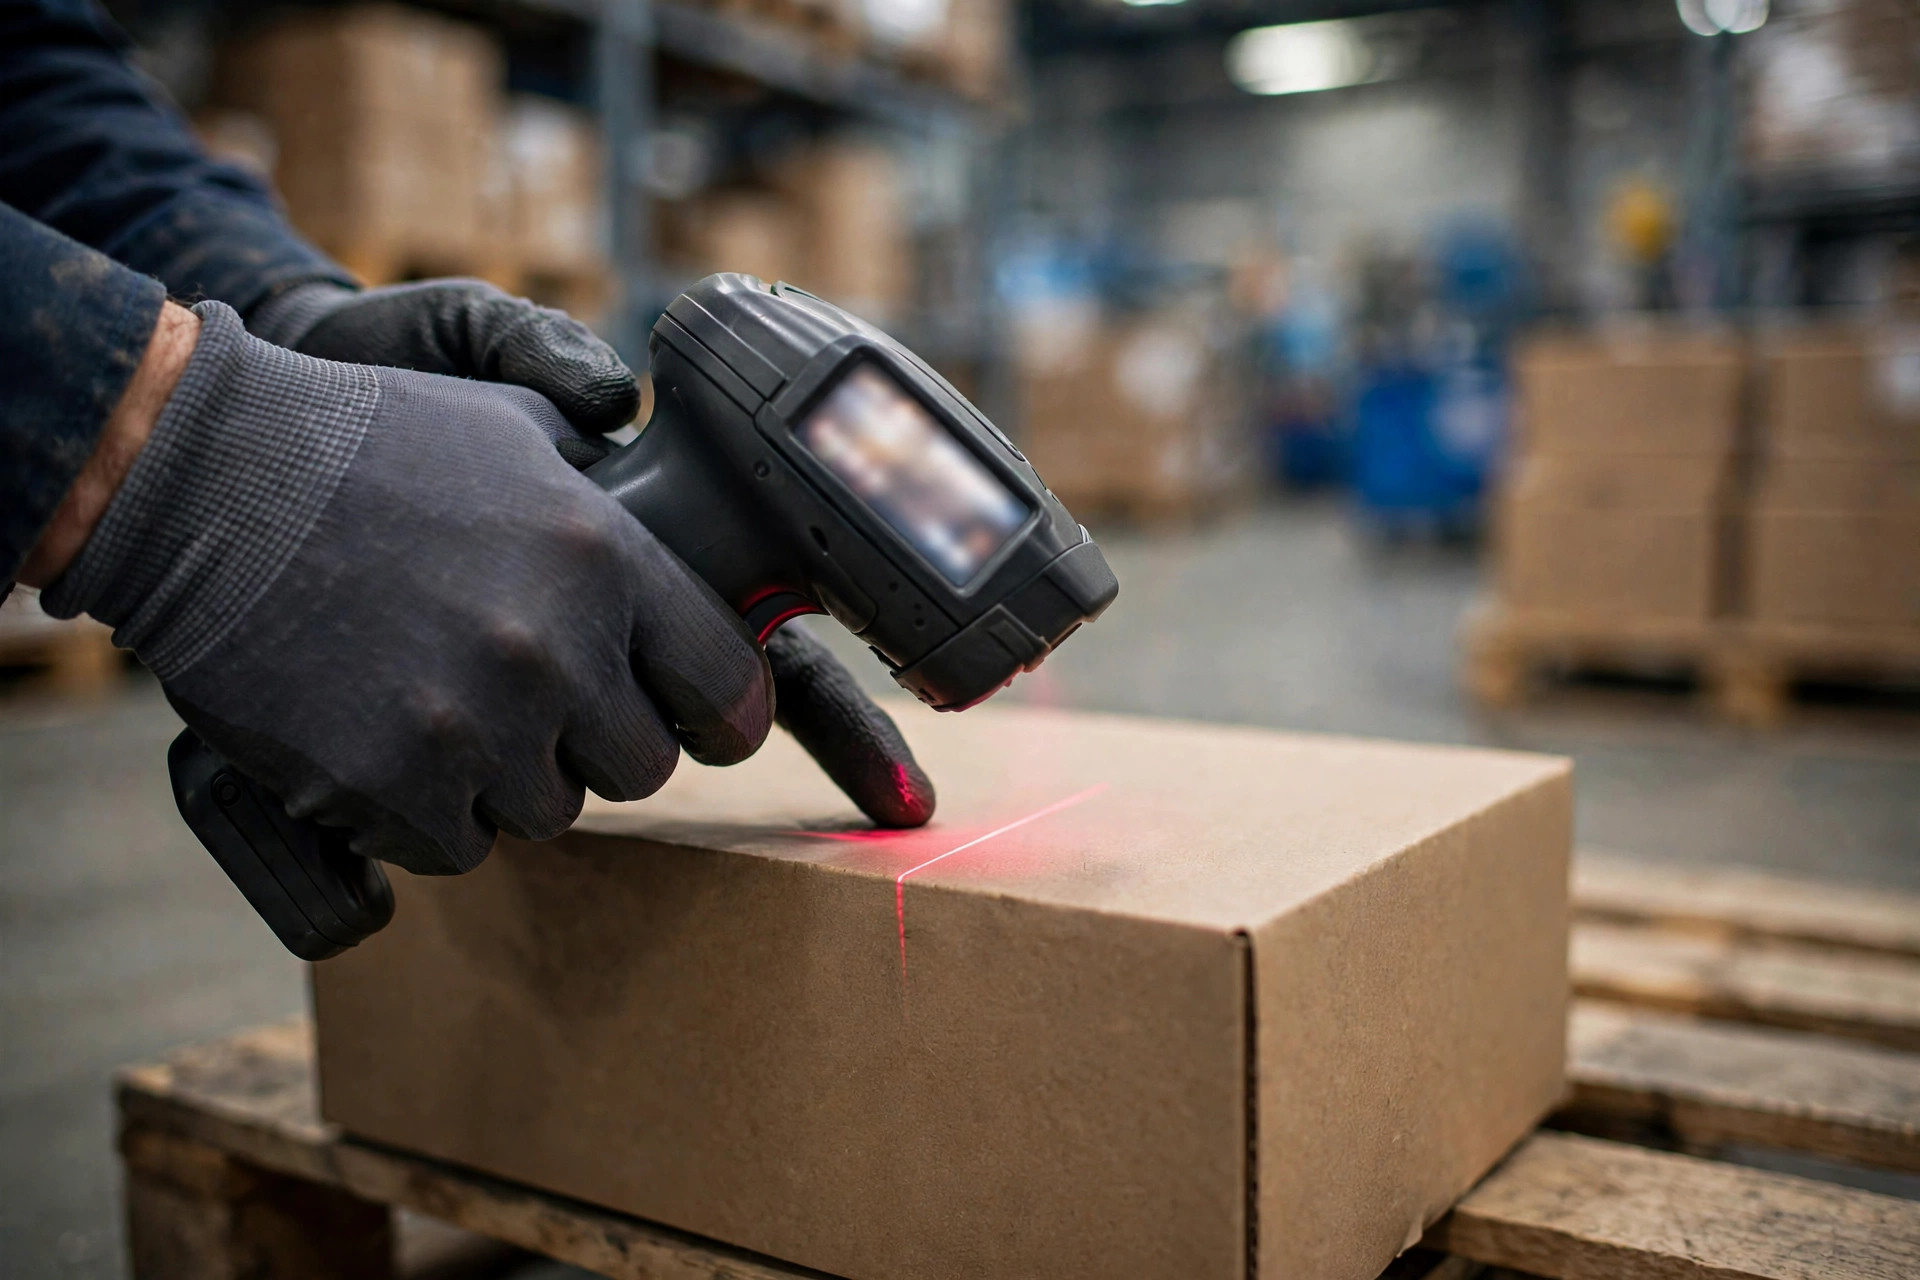
- Scanners RF: pelo menos três unidades de cada modelo no chão de fábrica, executando o fluxo completo recebimento → endereçamento (putaway) → separação → conferência. Em dispositivos mais antigos, fique de olho em campos de tela desalinhados.
- Modelos de etiqueta: imprima dez de cada — etiquetas de expedição, etiquetas de caixa e folhas de separação — e escaneie cada código de barras para confirmar a legibilidade. O desalinhamento de modelo é o bug pós-atualização mais comum.
- Integrações: rode pelo menos um pedido de ponta a ponta por cada conexão EDI, marketplace, ERP e TMS. "Conectado" não significa "correto" — verifique número do pedido, quantidade e endereço em cada teste.
- Estratégia de ondas: libere uma onda real e confirme que a lógica de alocação não mudou. Uma estratégia mal configurada não joga erros; ela realoca errado em silêncio.
- Permissões: faça login com cinco perfis diferentes e confirme que menus e direitos sobreviveram à atualização.
Atualizações forçadas de SaaS: você não tem botão de pausa
Atualizações de WMS on-prem seguem seu cronograma. As de WMS em nuvem (SaaS), não. As janelas de manutenção e os patches forçados seguem o calendário do fornecedor, e tudo que você pode fazer é se preparar — não torcer para sumirem.
Isso não é paranoia. Segundo o acompanhamento público de status do isdown.app sobre a Ongoing Warehouse, um provedor de WMS em nuvem: uma pane de sistema em 24 de fevereiro de 2026 durou cerca de 4 horas; uma interrupção grave de serviço em 25 de junho de 2026 durou cerca de 5 horas; a duração mediana dos incidentes nos últimos 90 dias foi de 4 horas e 33 minutos. Em outras palavras, um WMS em nuvem caindo algumas vezes por ano, por horas, é uma norma documentada — não um cisne negro.
Então, para clientes de WMS SaaS, minha lista sempre tem três linhas extras. Uma: assine a página de status do fornecedor e os avisos de manutenção, e confirme que nenhuma janela de manutenção do lado do fornecedor caia dentro de 72 horas da sua noite de atualização. Duas: coloque no contrato as compensações e obrigações de notificação por indisponibilidades causadas pelo fornecedor — promessas verbais não valem. Três: mantenha um plano B offline pronto. Quando um WMS em nuvem cai, você nem consegue tirar um snapshot local. Os documentos em papel e os procedimentos offline são seu único bote salva-vidas.
Uma última coisa
A atualização mais perigosa nunca é a versão principal. É o "patch pequenininho, não precisa testar, direto para produção". Das três explosões que vi, duas foram patches pequenos. Lembre-se disto: termine a lista da véspera antes de dormir, e não declare sucesso até a lista de validação estar toda verde. Algo que você pode usar amanhã: imprima as listas deste artigo e marque item por item antes da sua próxima noite de atualização. É o investimento em risco mais barato em mais de 30 projetos.
Por Lin Xiao, consultor de implementação de WMS
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.