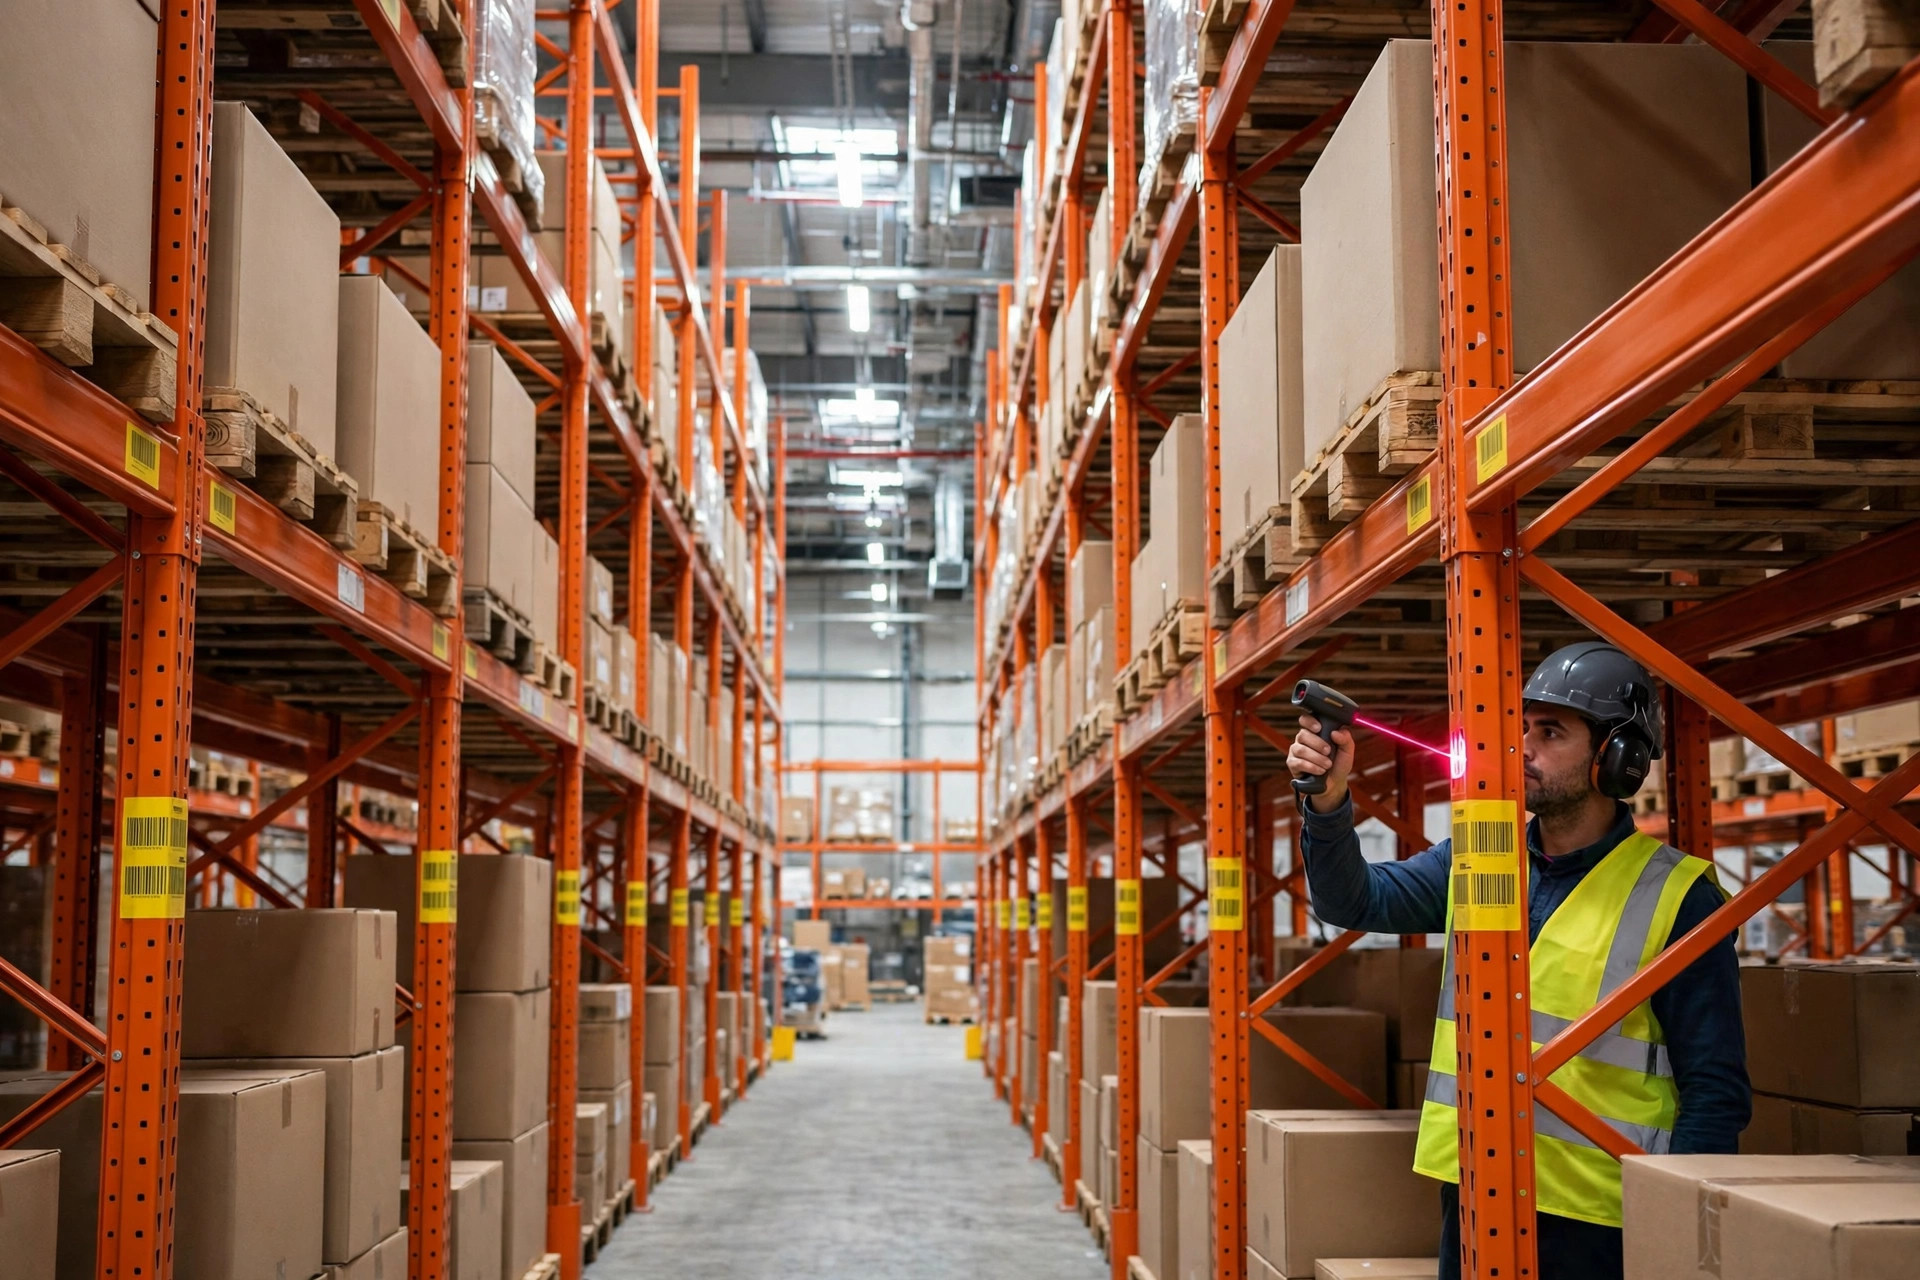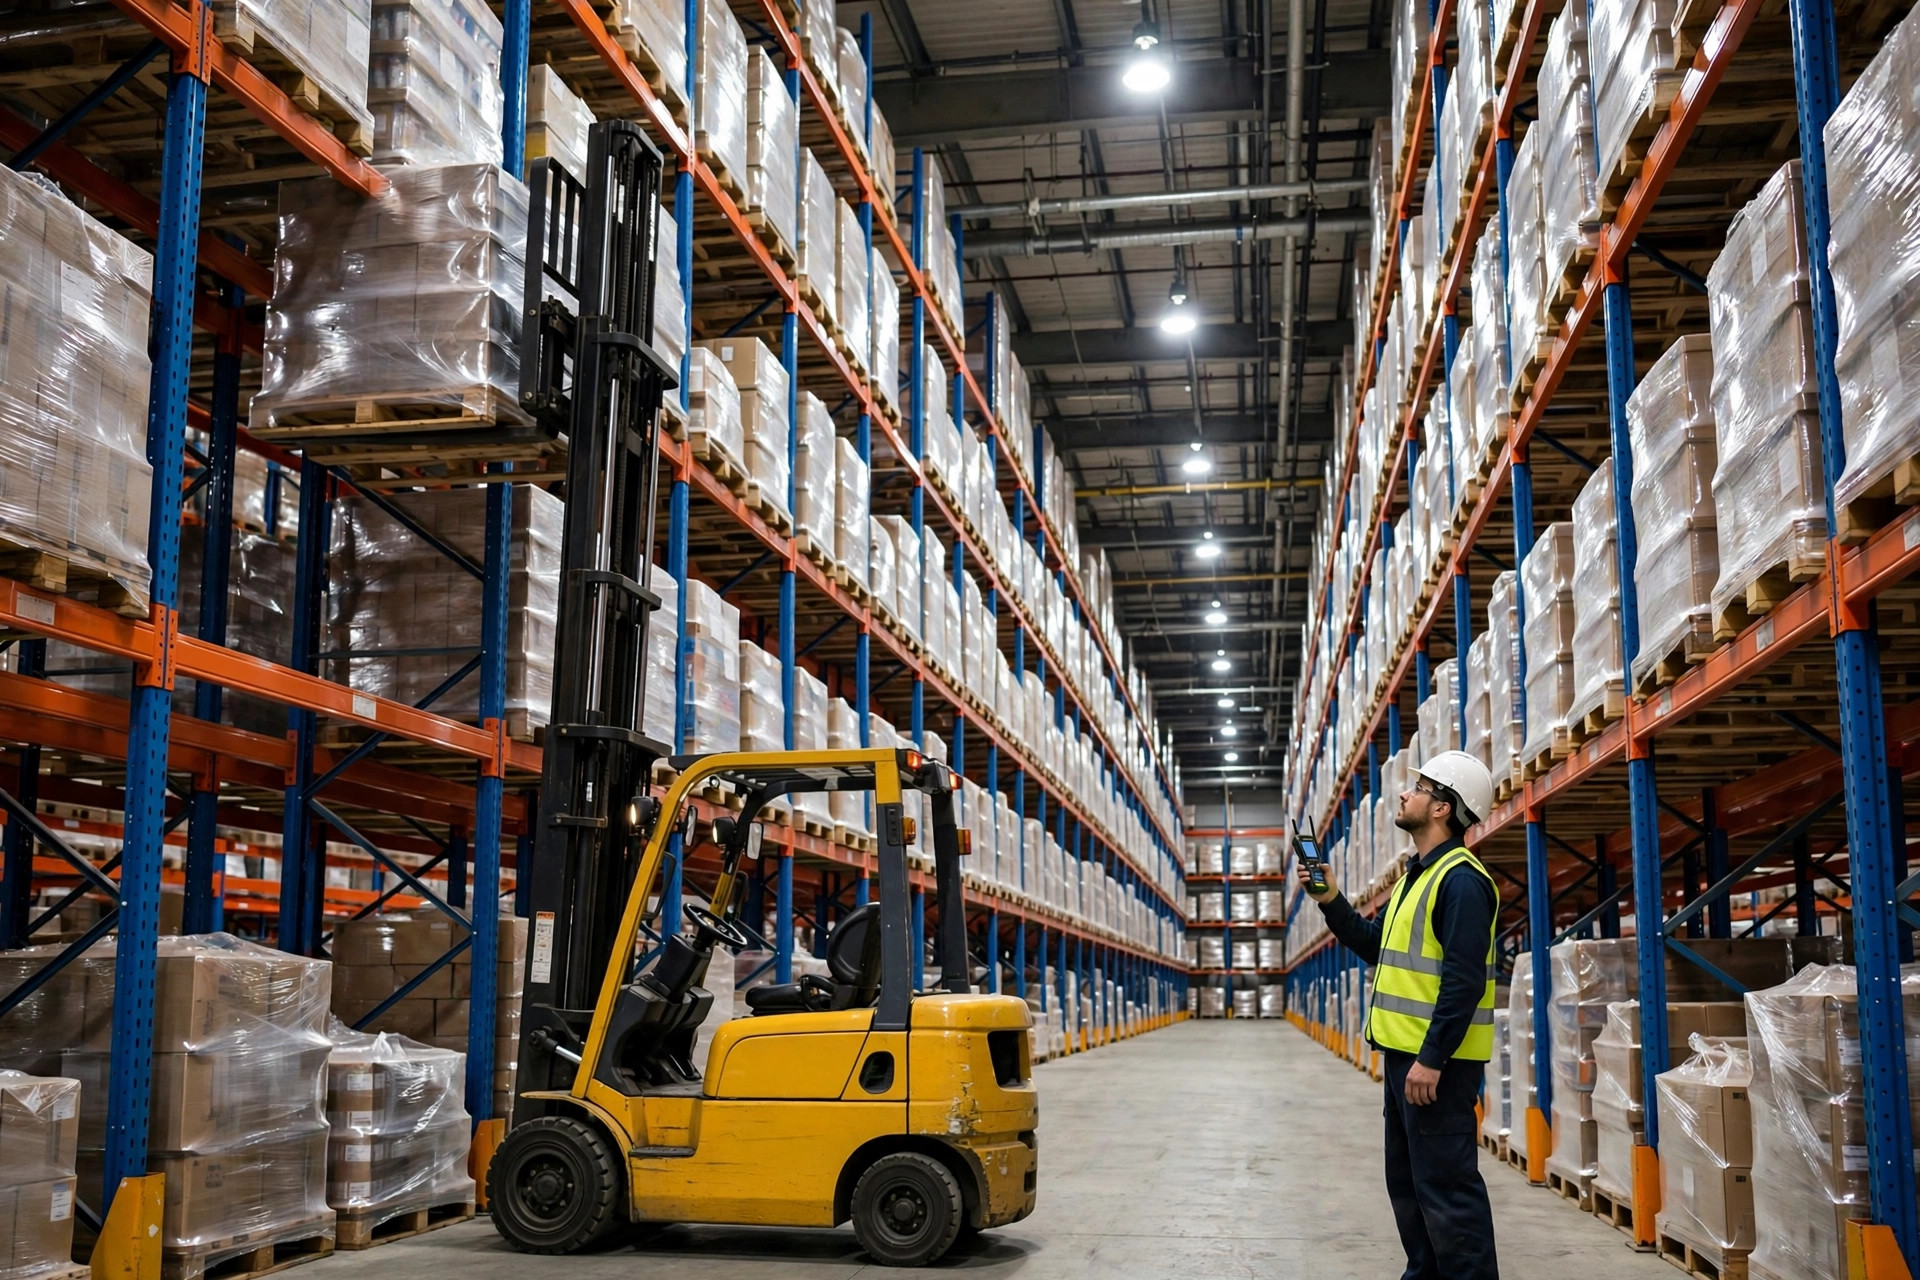
Parece uma decisão óbvia: a mercadoria chega e, em vez de o motorista da empilhadeira decidir para onde ela vai, o WMS dá a instrução — leve este pallet para o corredor 12, baia 4, nível 3. As viagens caem, a utilização do espaço sobe, os novatos trabalham como veteranos. Minha conclusão, depois de vinte anos na cadeia de suprimentos americana: se a armazenagem dirigida funciona tem muito pouco a ver com o quão inteligente é o seu WMS. Depende de duas coisas — do quão limpos estão seus dados mestres e do quão estável é seu mix de produtos.
Aqui vem a parte incômoda que a maioria dos fornecedores não vai lhe contar: a armazenagem dirigida costuma falhar nos dados mestres, não no software. Se as dimensões dos itens ou os status das posições estiverem errados, o sistema vai colocar a mercadoria no lugar errado com total confiança — e fará isso mais rápido e com mais empenho do que qualquer humano.
O 3PL da Califórnia em 2022: dados errados, executados com confiança
Em 2022, eu estava revisando as operações de um armazém 3PL na Califórnia. Eles tinham ativado o recurso três meses antes, e os incidentes de dano nas vigas das estantes haviam aumentado, não diminuído. O sistema não era o problema. Os dados mestres eram.
As caixas de um cliente tinham 32 polegadas de altura na vida real; o cadastro de itens ainda dizia 26. O WMS fez as contas com 26 polegadas e atribuiu "com confiança" uma posição baixa. O motorista confiou na tela, empurrou o pallet com força e entortou a viga. Uma posição perdida.
Pior foram as posições fantasmas: o sistema mostrava uma posição como vazia, o motorista chegava, e meio pallet ainda estava lá — porque ninguém tinha atualizado o status da posição. Quanto mais precisamente o sistema dirigia o tráfego, mais espetacular era a falha. Aquele armazém acabou desligando o recurso por duas semanas, auditando fisicamente cada posição e remedindo cada dimensão de item, antes de ousar ligá-lo de novo.
O CD de e-commerce de Dongguan em 2024: regras que não acompanham
Um caso de 2024 de um centro de distribuição de e-commerce em Dongguan, na China. A rotatividade de SKUs deles era brutal: dezenas de SKUs novos lançados e outros morrendo a cada semana. Eles operavam com zoneamento ABC por velocidade: os A na frente, os C no fundo das estantes. O problema: o ranking ABC deles mudava a cada três dias. A "posição ideal" do sistema estava sempre perseguindo os campeões de venda da semana passada.
O motorista veterano era mais rápido. Ele sabia qual corredor tinha posições livres hoje e qual zona acabara de ser liberada, e simplesmente ia para lá. O sistema, enquanto isso, seguia navegando pelos dados da semana passada. Esse é o trade-off que ninguém coloca no slide: não é que o sistema seja burro — é que o mix de produtos muda mais rápido do que as regras conseguem ser atualizadas. Num armazém cujo perfil muda diariamente, o recurso atrapalha.
Armazenagem dirigida vs. conhecimento empírico
| Armazenagem dirigida (dirigida pelo sistema) | Motorista veterano (conhecimento empírico) | |
|---|---|---|
| Base da decisão | Dados mestres + regras | Memória + olhos no chão |
| Velocidade de armazenagem | Rápida e consistente — quando os dados estão limpos | Flexível quando há pouca gente e a mercadoria vem bagunçada |
| Maior risco | Dados ruins falham rápido e com total confiança | O conhecimento sai pela porta com a pessoa |
| Melhor encaixe | SKUs estáveis, muitas posições, alguém mantendo os dados | Giro rápido de SKUs, armazém pequeno, perfil instável |
| Custo oculto | O trabalho de manter dados e regras | Retrabalho por mercadoria mal colocada, tempo de busca, inventários cíclicos |
Quando a armazenagem dirigida ajuda
Há três tipos de armazém que deveriam adotá-la sem hesitar. Primeiro, operações com SKUs estáveis: se o mix de produtos quase não muda em seis meses, uma boa configuração de regras se paga por muito tempo. Segundo, armazéns com restrições rígidas — zonas de temperatura, produtos perigosos, segregação por cliente. Quando um pallet mal colocado é um incidente de conformidade, o sistema nunca "esquece". As pessoas, sim. Terceiro, armazéns com muitas posições e pouca mão de obra: um recém-contratado com um coletor RF é produtivo na primeira semana em vez de acompanhar um veterano por três meses. Eu fiz essa conta: três meses de salário de um aprendiz é dinheiro de verdade, e a armazenagem dirigida transforma "experiência" em "instruções", o que também torna a contratação de temporários na alta temporada muito menos assustadora.
Depois há o estado intermediário mais comum, e ele descreve a maioria dos armazéns pequenos que visito: você tem gestão de posições, mas sem armazenagem dirigida. Cada pallet tem um número de posição, mas os motoristas escolhem as posições pela experiência. Meu conselho para essa situação: não corra para comprar o recurso. Arrume primeiro seus dados mestres de posições. Quando as posições forem confiáveis, a armazenagem dirigida pelo sistema vem naturalmente. Se não forem, o recurso só adiciona ruído.
Quando a armazenagem dirigida mais prejudica do que ajuda
Três situações — fique longe. Primeira, dados mestres bagunçados: dimensões digitadas por quem recebeu a mercadoria, status de posição atualizado aos gritos do outro lado do cais. Segunda, um mix de produtos que muda diariamente: alta temporada de e-commerce, produtos sazonais, regras permanentemente um passo atrás da realidade. Terceira, ninguém é dono das regras. Um conjunto de regras está correto no dia do go-live; três meses depois, sem manutenção, está errado — e o sistema vai executar as regras erradas com a maior cara de pau.
Cinco perguntas antes de ativá-la
- As dimensões de 80% dos seus SKUs estão medidas ou foram digitadas a partir de um e-mail do fornecedor?
- O status das suas posições é em tempo real? Quando o sistema diz vazio, está mesmo vazio?
- Seu mix de produtos é estável num horizonte de seis meses?
- Você tem restrições rígidas do tipo "isso não pode ir para o lugar errado" — temperatura, produtos perigosos, segregação por cliente?
- Alguém é dono da manutenção das regras e dos dados mestres?
Menos de três sins: não ative. Arrume primeiro os dados. E essas cinco perguntas também servem como check-up trimestral de saúde depois do go-live.
Faça as contas: o retorno não está na armazenagem
Vamos colocar números — claramente rotulados como ilustração. Pegue um armazém que recebe 200 pallets por dia, com a mão de obra de armazenagem a um custo total de $25 por hora. O verdadeiro retorno não está na armazenagem em si — uma viagem de armazenagem leva minutos. O dinheiro está na separação de pedidos. As análises do setor colocam a separação de pedidos acima da metade do custo direto de mão de obra do armazém, e as viagens acima da metade do tempo de separação. Mercadoria na posição certa significa separadores andando menos, e é aí que mora o número grande.
Uma ilustração concreta: se o retrabalho por pallets mal colocados cair de 10 incidentes por dia para 2, a 15 minutos cada um, são 2 horas economizadas por dia — mais de mil dólares por mês a $25 por hora com todos os custos. E isso sem contar nenhuma das viagens de separação economizadas. Se você contar só o lado da armazenagem no balanço, ele nunca se paga. Some as viagens de separação, e a conta muda completamente.
Mais uma verdade incômoda: aquela frase do setor de que "as viagens são metade do tempo de separação" — eu a rastreei uma vez. A fonte mais antiga é a estimativa de um profissional num livro de armazenagem de 1996, não uma medição, e ela vem sendo citada há trinta anos. Não construa seu business case em cima de médias do setor. Meça o seu próprio prédio: duas semanas de distância percorrida pelos separadores e de tickets de retrabalho de armazenagem vão lhe dizer mais do que qualquer benchmark.
Para fazer funcionar: três passos
Primeiro, arrume os dados mestres. Remeça as dimensões dos SKUs, audite os status das posições. É trabalho sujo e não tem atalho. Dados ruins dentro, erros confiantes fora.
Segundo, comece grosso e depois afine. Primeiro as zonas — temperatura, cliente, grandes áreas ABC. Ponha isso rodando bem antes de configurar centenas de regras em nível de posição. Conjuntos de regras que nascem detalhados demais morrem por falta de manutenção.
Terceiro, deixe um override humano — com código de motivo. Os motoristas precisam poder rejeitar uma instrução ruim, mas a rejeição é registrada e revista semanalmente. Um processo dirigido pelo sistema sem override humano acaba brigando com o chão de fábrica; override mais ciclo de feedback torna as regras mais afiadas a cada semana.
Então não pergunte se a armazenagem dirigida é boa. Pergunte se os seus dados mestres merecem estar no comando.
Por Lao Mi, Veterano da cadeia de suprimentos (20 anos)
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.