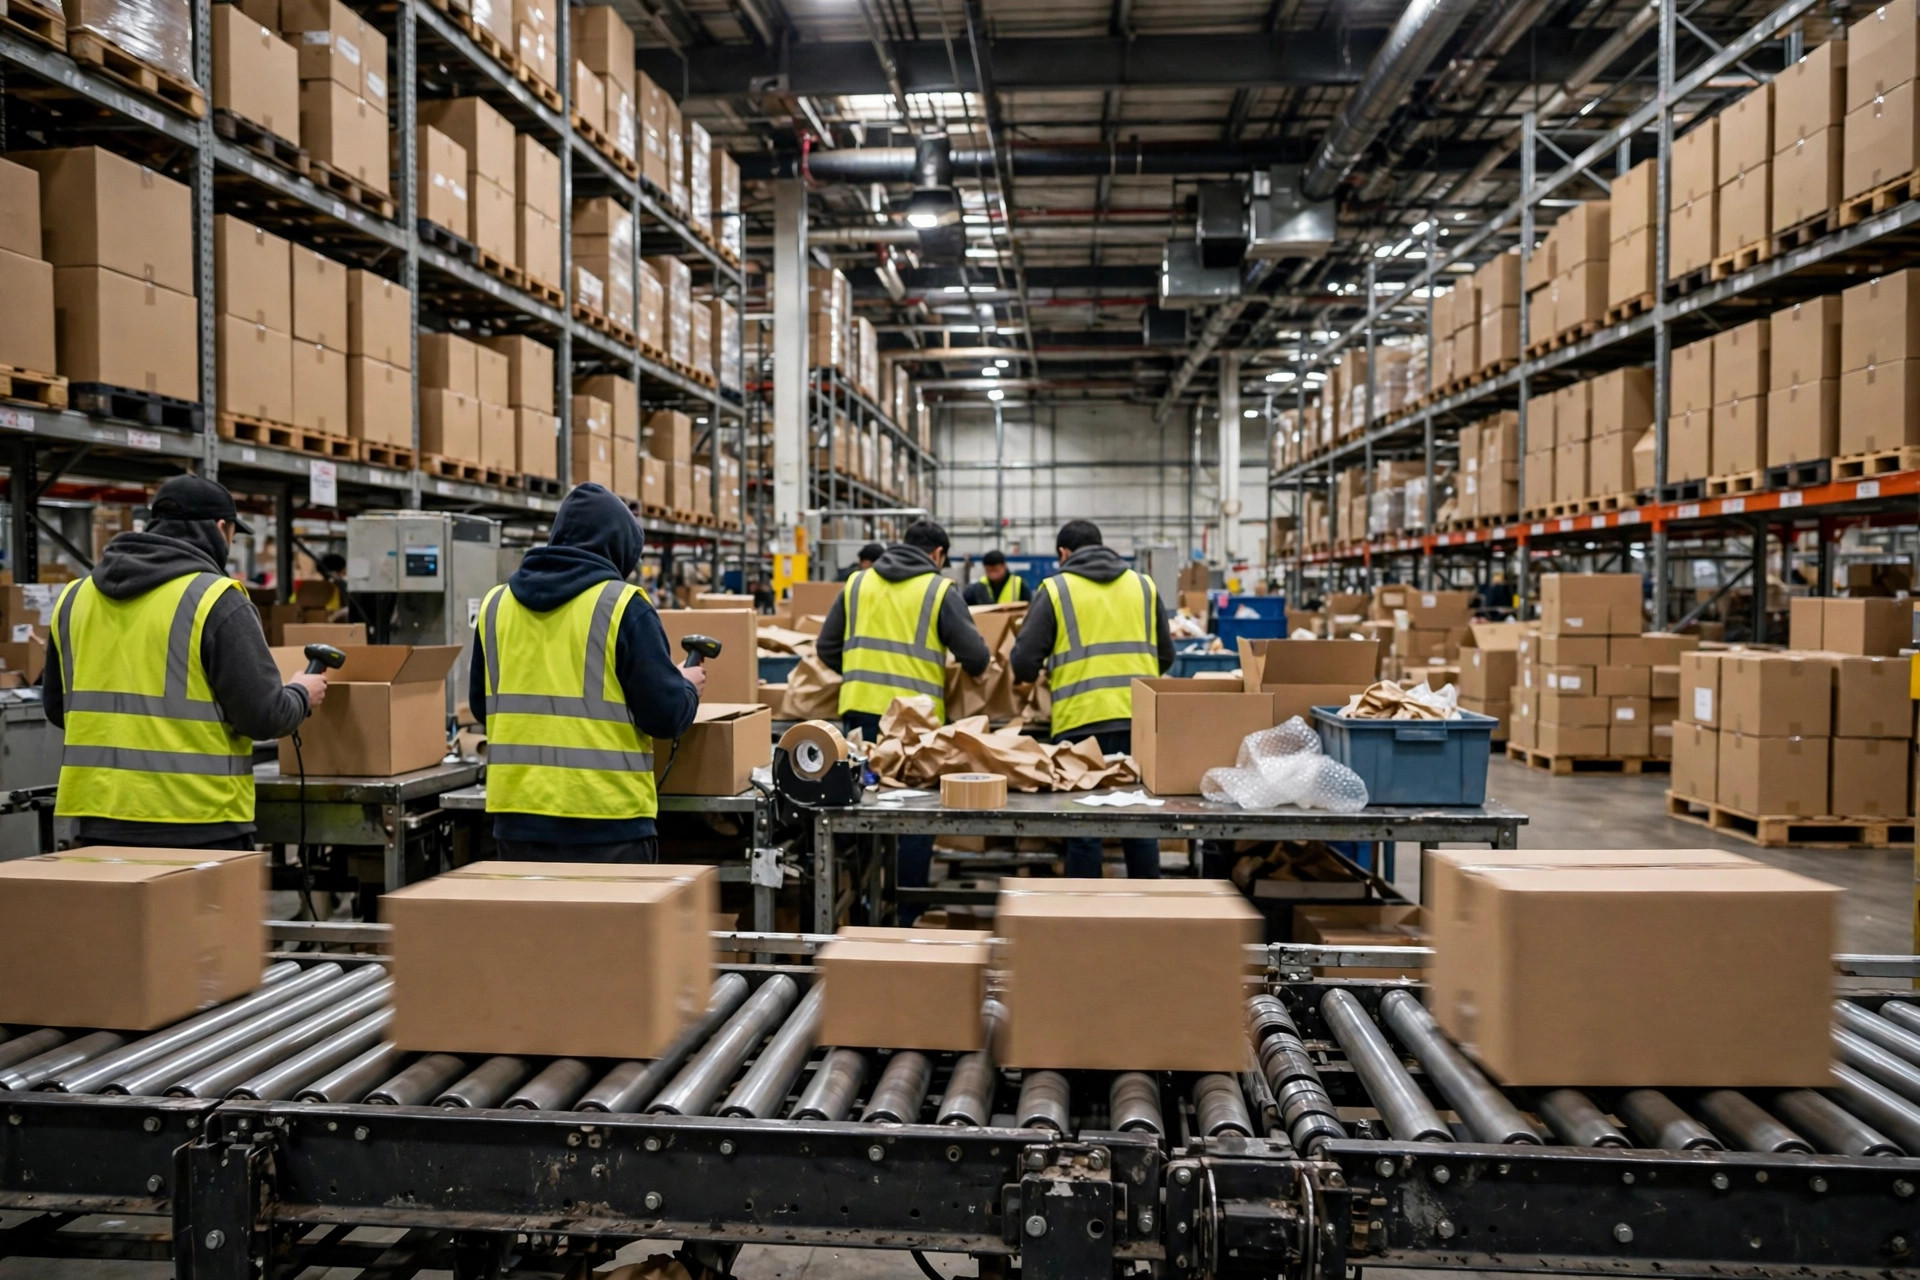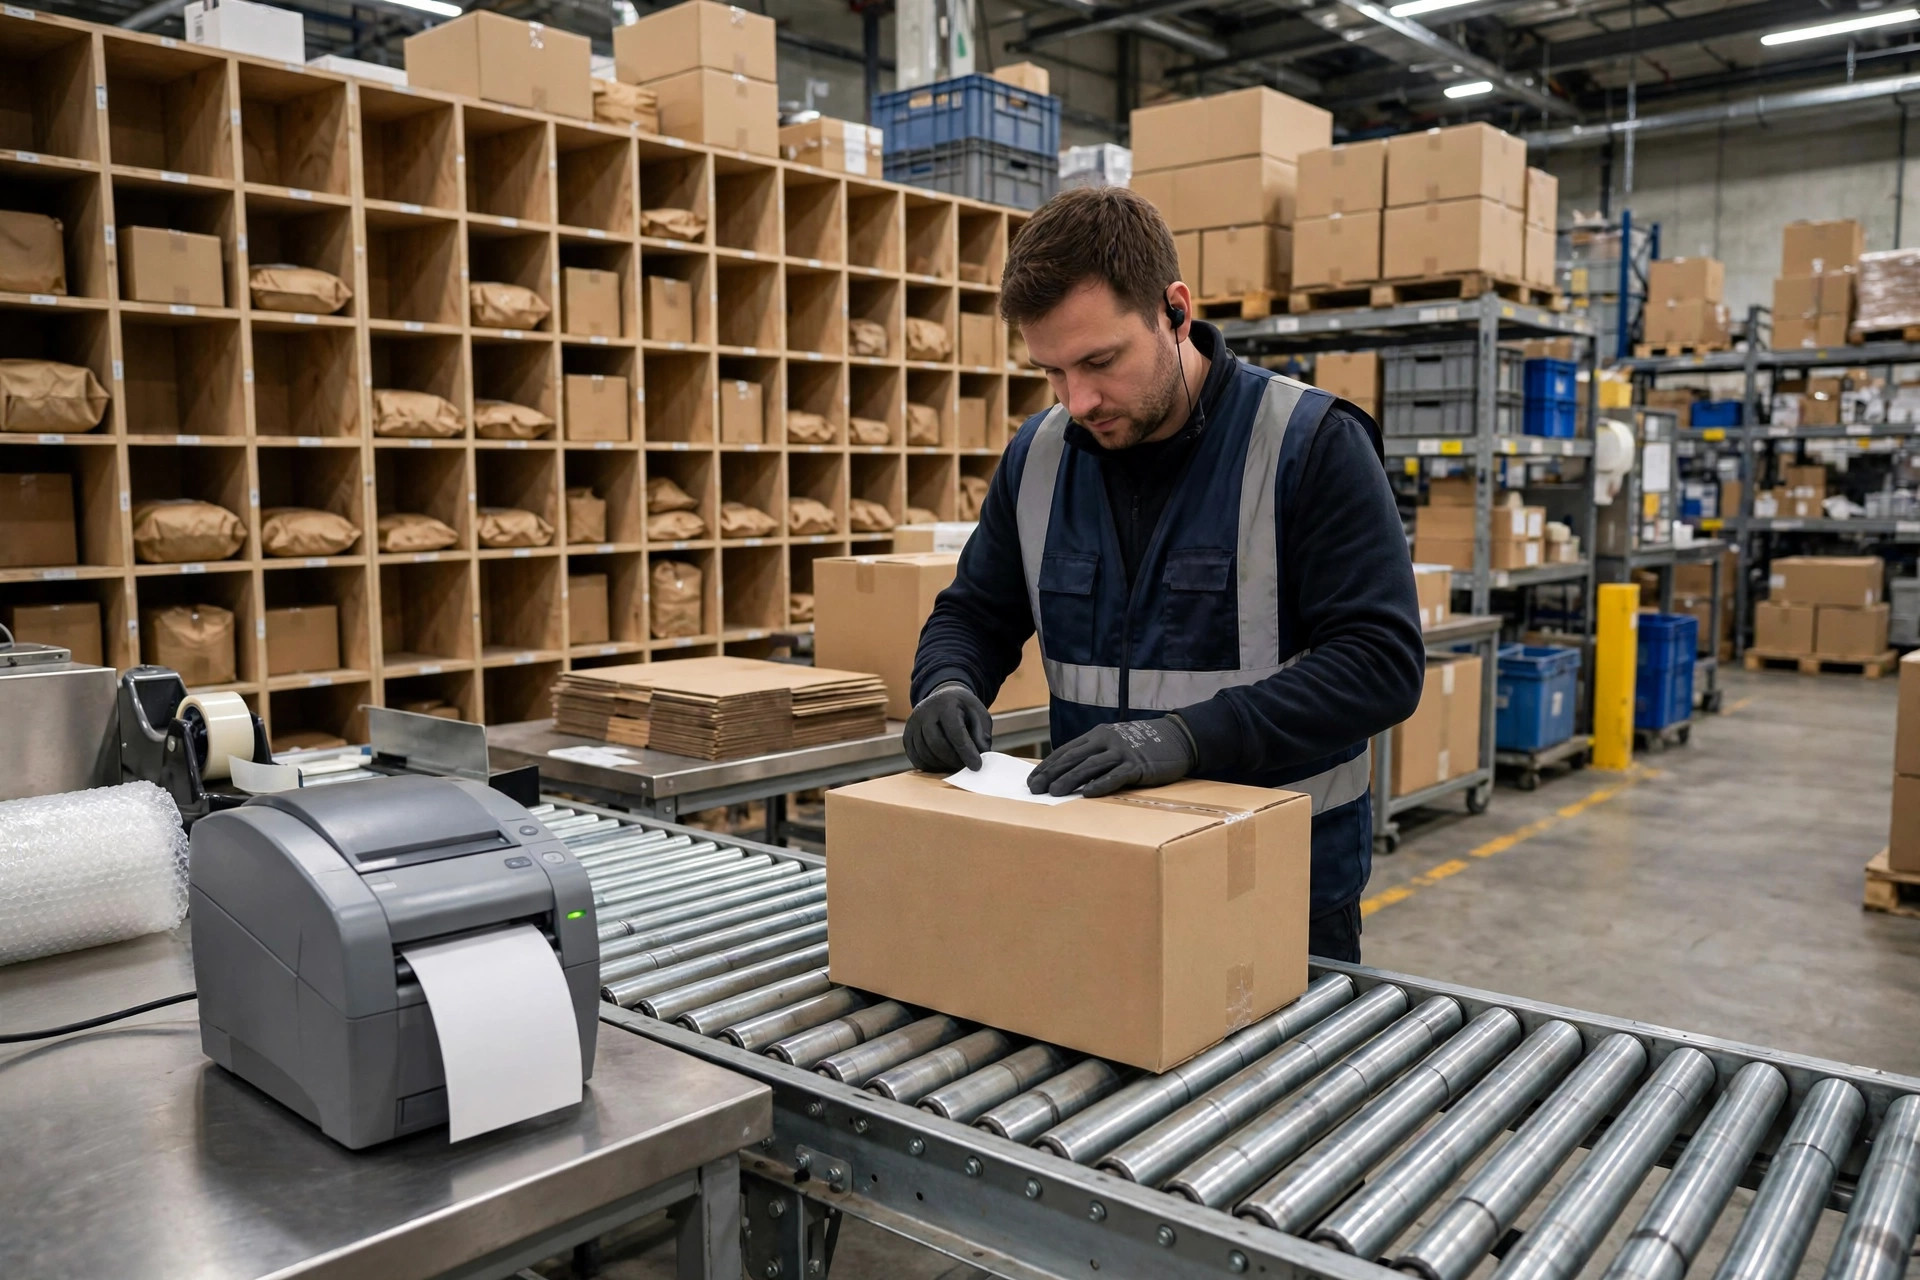
Em 2019, num armazém 3PL em Ontario, Califórnia, eu vi essa cena ao vivo: trinta ou quarenta pacotes empilhados na estação de embalagem, um operador escaneando cada um com um leitor portátil, o sistema mostrando "etiqueta criada" para cada pedido — mas só metade das etiquetas estava realmente sobre a mesa. A impressora alimentava o papel sem problema. Era só... pouco. As chamadas do atendimento ao cliente já estavam chegando: compradores perguntando por que o rastreamento nunca era atualizado. Naquela tarde, nós vasculhamos toda a cadeia e, no fim, a transportadora não teve nada a ver com isso. Nossa própria lógica de tentativas não enviava uma chave de idempotência. Uma solicitação com tempo esgotado na verdade tinha tido sucesso do lado da transportadora; o sistema assumiu falha e disparou de novo. A segunda chamada devolveu a mesma etiqueta, sobrescreveu o primeiro registro, e o primeiro pacote já tinha saído com a outra etiqueta impressa colada. A que não fechava era a etiqueta sobrescrita.
Meu veredito de entrada: quando as APIs de etiquetas da transportadora "perdem" etiquetas, 90% das vezes não é culpa da transportadora — é a sua lógica de tentativas e a sua máquina de estados. Dos 10% restantes, cerca de sete partes são a fila de impressão e três partes o lado da transportadora. Soa agressivo? Passei vinte anos em armazéns nos EUA e integrei mais APIs de etiquetas do que consigo contar com as duas mãos. A causa raiz é sempre uma das seis etapas abaixo. Aqui vai uma cadeia de depuração do sintoma à causa raiz, em ordem. Uma tarde basta para localizá-la.
Não culpe a transportadora ainda — verifique seus logs de solicitação
Quando quebra, o passo um é sempre os logs. Não o painel da transportadora — o registro do seu próprio sistema sobre se a solicitação de etiqueta realmente saiu e o que a transportadora devolveu.
Onde olhar: a tabela de logs de API do seu WMS ou do seu middleware. Como é o saudável: cada chamada tem um registro com carimbo de data/hora, número do pedido, corpo da solicitação, corpo da resposta, código de status HTTP e latência. Verifique três coisas.
Primeiro, a solicitação e a resposta completas estão persistidas? Muitos sistemas só armazenam "sucesso/falha" e jogam fora o corpo da resposta. Isso é uma caixa preta. Depurar etiquetas perdidas sem pares completos de solicitação/resposta é basicamente adivinhar. A pior configuração que vi só registrava o número do pedido e "OK" — quando quebrava, a equipe tinha que reconciliar pedido por pedido no portal da transportadora. Isso transformou uma tarde em três dias.
Segundo, houve timeouts, e quantas tentativas? Timeouts nas APIs de etiquetas são normais; as transportadoras ficam lentas no pico, às vezes além de 10 segundos. A pergunta de verdade: você tentou de novo após o timeout, e a nova tentativa levou uma chave de idempotência? Um timeout não é uma falha — a solicitação pode muito bem ter tido sucesso do lado da transportadora enquanto seu sistema nunca recebeu a resposta. Uma nova tentativa às cegas então imprime duas etiquetas — ou pior, duas etiquetas compartilhando um número de rastreamento, com seu sistema reconhecendo só a segunda. A primeira etiqueta vira um fantasma: fisicamente num pacote, invisível para o seu sistema.
Terceiro, o número de rastreamento da resposta bate com o que está armazenado no seu sistema? Algumas integrações confundem o número mestre de rastreamento da transportadora com o número em nível de pacote e armazenam o campo errado. A etiqueta não se perdeu — você está procurando no lugar errado.
Se seus logs estão completos, só este passo expõe o problema 80% das vezes. Se estão incompletos, conserte o logging antes de depurar qualquer outra coisa — sem dados, toda conclusão é superstição.
Se um pedido atinge a API duas vezes, quantas etiquetas saem?
Passo dois: idempotência. Esta é a zona de desastre, e é a causa raiz da história com que abri.
Como é o saudável: o mesmo número de pedido atingindo a API qualquer número de vezes produz exatamente uma etiqueta válida do lado da transportadora; chamadas repetidas devolvem o primeiro resultado em vez de cunhar uma etiqueta nova. Essa garantia vem de uma chave de idempotência — geralmente o número do pedido mais um identificador único de negócio, enviado com a solicitação.
Onde olhar: seu wrapper de API — a solicitação de etiqueta realmente transmite um campo de idempotência? A maioria das APIs de etiquetas de transportadoras suporta um (confira a documentação mais recente da transportadora para o nome exato do campo), mas muitas integrações de armazém nunca o enviam. A variante mais sorrateira: você envia um, mas na granularidade errada. Usar "número do pedido + carimbo de data/hora" como chave, por exemplo — o carimbo muda toda vez, então é o mesmo que não enviar nada. Cada nova tentativa cunha uma etiqueta nova.
Como verificar: pegue um pedido com etiqueta perdida e conte quantas vezes a API foi chamada nos logs, e se cada chamada devolveu o mesmo número de rastreamento. Duas chamadas devolvendo dois números de rastreamento diferentes, com só o segundo armazenado no seu sistema — a etiqueta do primeiro número de rastreamento é a sua "perdida". Ela realmente existe, colada em algum pacote. O pacote foi enviado; seu sistema não sabe. O que o atendimento ao cliente vê é "etiqueta criada, mas sem atualizações de rastreamento".
E um último recurso em nível de banco de dados: a coluna de etiqueta/número de rastreamento precisa de uma restrição de unicidade. Sem ela, escritas duplicadas nunca dão erro — dados sujos se acumulam em silêncio, e quando você percebe, nada fecha. Adicionar essa restrição não custa nada e se paga na hora.
Etiqueta gerada, status nunca gravado: verifique sua máquina de estados
Passo três: callbacks assíncronos e a máquina de estados. Algumas APIs de etiquetas são assíncronas: você envia a solicitação, a transportadora responde "aceito", e o arquivo real da etiqueta e o número de rastreamento chegam por callback segundos ou minutos depois.
Como é o saudável: o status do pedido flui limpo — digamos, pending → creating → created → printed — cada transição com carimbo de data/hora. Se o callback ainda não chegou, o pedido deveria estar em "creating", não ter virado de algum jeito "created".
Onde olhar: o log de transições de status. Cuidado com estados pulados: o callback nunca chegou, mas o status diz "created". Isso geralmente é um job de polling otimista demais ou lógica do frontend que marca sucesso no momento em que a solicitação é enviada, sem nunca esperar o callback.
A variante mais desagradável: o callback chegou, mas seu endpoint de callback deu erro — uma falha de verificação de assinatura, um timeout de lock do banco de dados — então a transportadora mostra "entregue" enquanto o seu lado nunca persistiu. Cada lado conta sua própria história. Verifique os logs de erro do endpoint de callback; a evidência quase sempre está lá. Ninguém estava lendo.
Meu veredito: a máquina de estados é a coisa que mais vale a pena acertar no pipeline de etiquetas. Uma máquina de estados que permite estados pulados não é uma máquina de estados.
A impressora: o bode expiatório mais injustiçado
Primeiros três passos limpos? Olhe a impressão. Impressoras Zebra perdem trabalhos mais do que você imagina.
Como é o saudável: o arquivo da etiqueta entra na fila de impressão, a impressora cospe folhas uma a uma, e cada folha recebe uma confirmação de impressão. Onde olhar: o log de fila do servidor de impressão — cada trabalho está "concluído" ou parado em "erro/cancelado"? Impressoras Zebra têm um hábito clássico: a fita ou o estoque de etiquetas acaba, o cabeçote de impressão superaquece, e em vez de avisar em voz alta, o trabalho simplesmente emperra na fila enquanto o frontend diz "enviado". O operador não vê papel, assume que o sistema nunca criou a etiqueta, e aperta imprimir de novo — e sem um aperto de mão de confirmação de impressão, isso imprime uma duplicata.
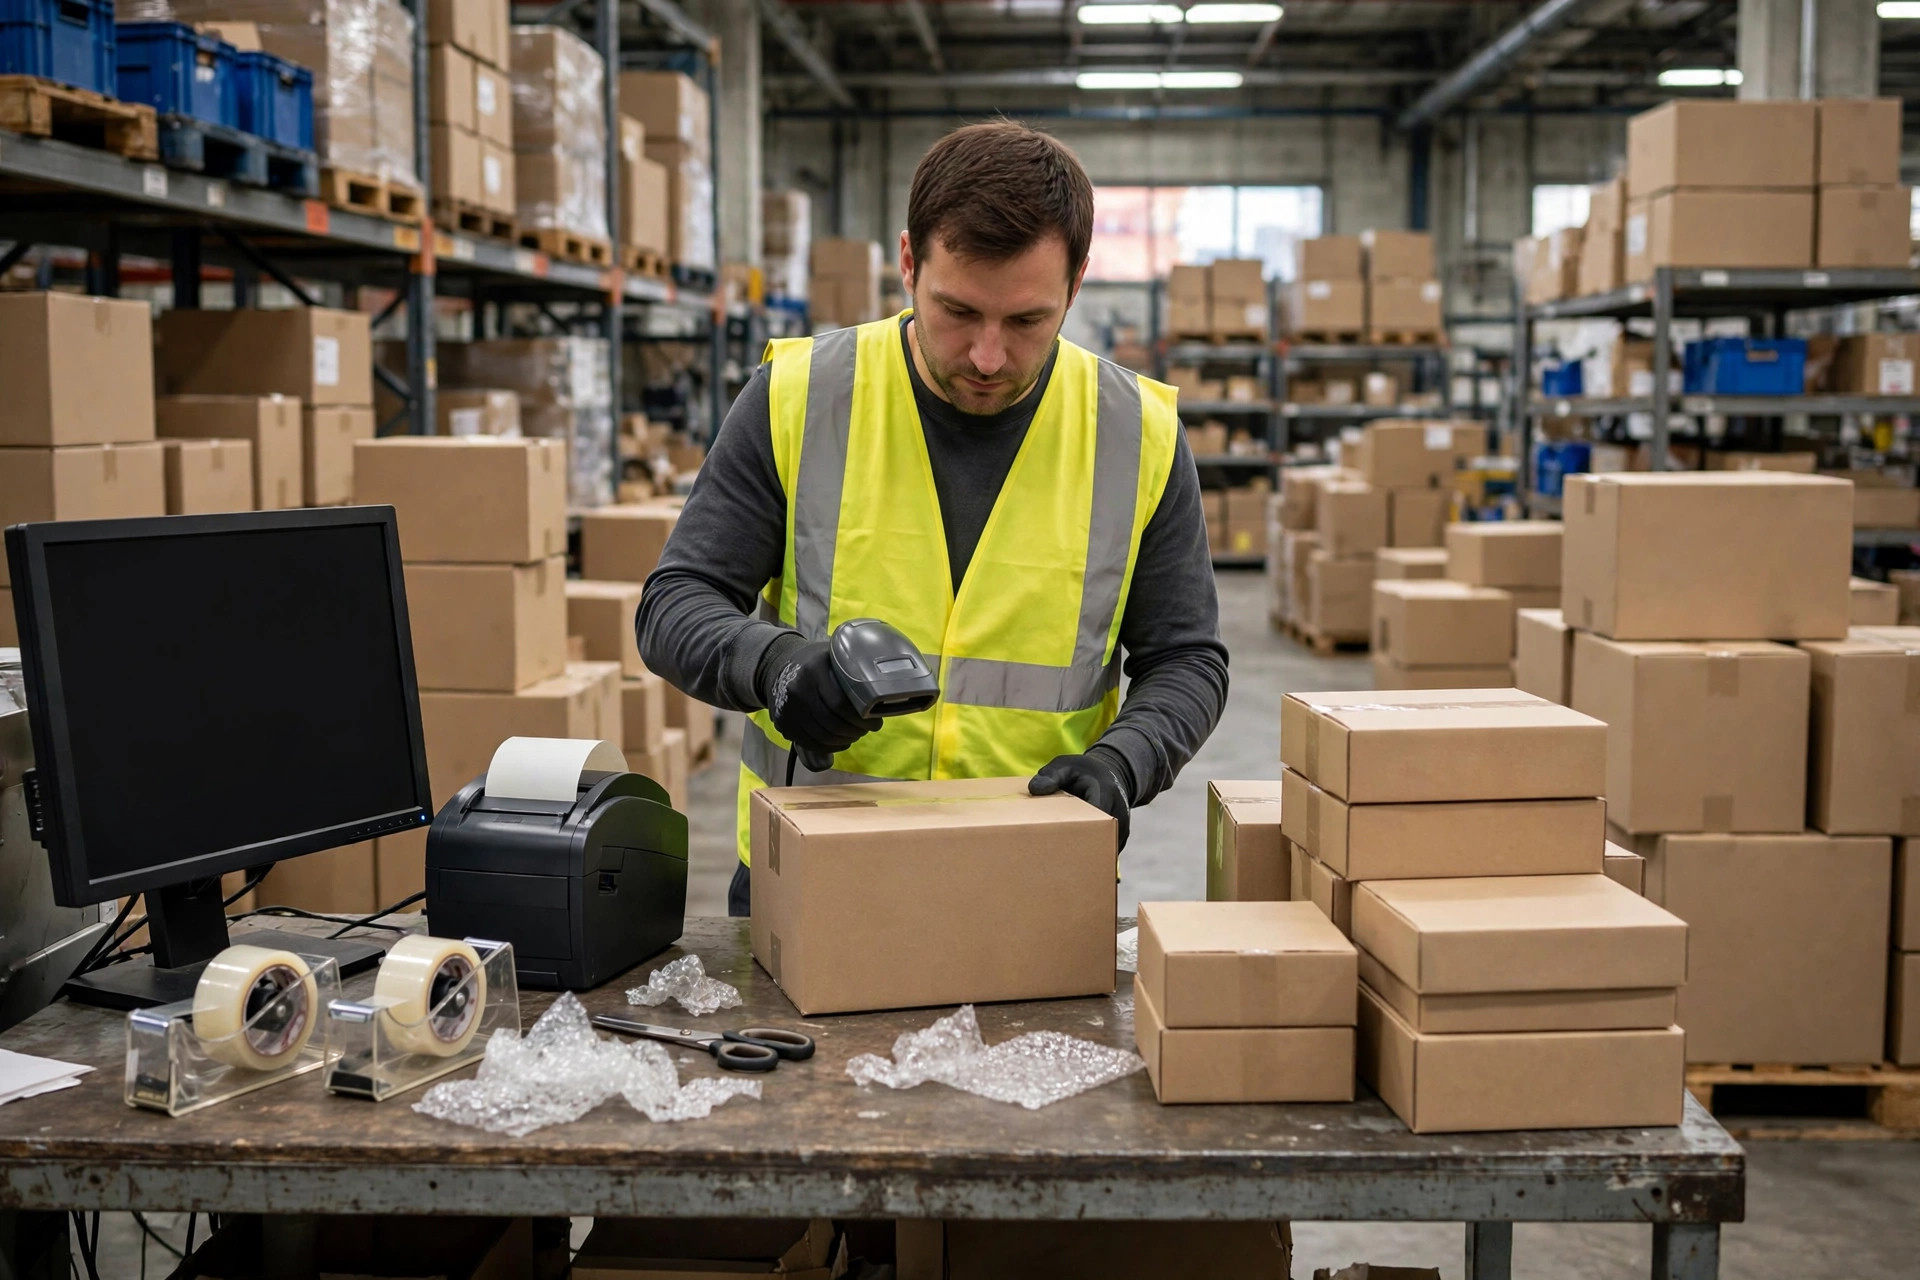
Outro clássico: uma impressora de rede cai e reconecta, e todo o atraso da fila sai de uma vez. O operador arranca algumas, cola, e o resto se mistura — etiquetas mal aplicadas e perdidas por todo lado. É por isso que meu checklist de prevenção insiste num recibo de confirmação de impressão: a impressora confirma cada folha, e só então o sistema avança o status para "printed". Uma impressão sem recibo é uma impressão que nunca aconteceu.
O lado da transportadora: limites de taxa e validação de endereço, engolidos em silêncio
Finalmente, a transportadora. A conclusão honesta: causas genuínas do lado da transportadora são raras — algumas vezes por ano, no máximo. Mas são as mais difíceis de investigar, porque o problema não está nas suas mãos.
Onde olhar: os registros de chamadas de API e códigos de erro do portal de desenvolvedor da transportadora. Foque em duas categorias.
Primeiro, limitação de taxa. Durante a temporada de promoções e picos, seu QPS excede a cota da conta e a transportadora rejeita a solicitação. Alguns devolvem um 429 limpo; outros — vou dizer claramente — uma grande transportadora devolve 200 em certos endpoints quando limitada, com uma mensagem de erro silenciosa enfiada no corpo. Se seu código só verifica o status HTTP, ele acredita que a etiqueta foi criada. Não foi. Isso é uma falha silenciosa; ao investigar, leia o corpo da resposta, não só o código de status.
Segundo, falhas de validação de endereço. Endereços nos EUA são cheios de detalhes — um dígito errado no número do apartamento ou da suíte, uma incompatibilidade de ZIP+4, e a validação do lado da transportadora rejeita o pedido. Isso deveria voltar como um erro de endereço claro, mas algumas integrações engolem os erros de validação como exceções genéricas, registrando só "falha na criação da etiqueta". O operador vê a falha, digita o pedido manualmente — com um endereço ligeiramente diferente do registro do sistema — o pacote é enviado, e nada fecha. Para esta categoria, validar o endereço antecipadamente importa dez vezes mais do que depurar depois.
Não vou citar tarifas nem números de limitação específicos aqui; as políticas das transportadoras mudam rápido, então siga a política publicada mais recente no site oficial.
Reconcile diariamente: a última rede de segurança, e a primeira coisa que você deveria ter construído
Passo seis, e o que mais quero que você lance amanhã: reconcile sua contagem de etiquetas com a fatura da transportadora todos os dias.
A lógica é simples: a contagem de "etiquetas criadas" de ontem no seu sistema deveria igualar a contagem de etiquetas de ontem na fatura da transportadora. Onde diferirem, a diferença são suas etiquetas perdidas — seja qual for a etapa da cadeia que as engoliu, os números não mentem.
Como fazer: escreva um job de reconciliação diária que puxe a fatura ou o relatório de uso da transportadora durante a noite (a maioria dos portais de transportadoras exporta um) e o compare registro por registro com seus registros de etiquetas por número de rastreamento. A lista de exceções cai na caixa de entrada de operações e de TI toda manhã. A primeira execução pode assustar você — isso é dívida histórica vindo à tona de uma vez, o que é bom. Significa que o mecanismo rodava nu antes.
Recomendo dois níveis de alerta. Nível de negócio: alerte se nenhuma etiqueta for criada por 10 minutos durante o horário de operação — uma estação de embalagem não pode passar 10 minutos sem uma única etiqueta em operação normal, então um disparo quase certamente significa que a API caiu. Nível de reconciliação: escale para um humano se a contagem diária de exceções exceder 5. Ajuste os limiares ao seu volume, mas tenha limiares. Monitoramento sem limiares não é monitoramento.
O checklist de prevenção: faça estas cinco e as etiquetas perdidas basicamente desaparecem
Depurar cura a doença; prevenir mantém você saudável. Cinco itens, ordenados pelo retorno:
| Item | O que fazer | Custo |
|---|---|---|
| Política de tentativas em timeout | Tentar de novo só em timeout, sempre com chave de idempotência; máximo de 3 tentativas com backoff exponencial | Meio dia de desenvolvimento |
| Unicidade do número de rastreamento | Índice único na coluna do número de rastreamento; escritas duplicadas falham com barulho | Minutos |
| Aperte a máquina de estados | Sem estados pulados; pedidos ficam em "creating" até o callback chegar, depois escalar para revisão manual no timeout do callback | 1–2 dias |
| Recibos de confirmação de impressão | Confirmações da impressora conduzem a transição de status; sem recibo significa "não impresso" | Precisa da cooperação do servidor de impressão |
| Job de reconciliação diária | Comparar automático de madrugada, enviar a lista de exceções por e-mail, escalar além de 5 exceções | 1 dia |
Além disso: guarde logs completos de solicitação/resposta por pelo menos 90 dias. Não reclame do armazenamento. Quando uma disputa por etiqueta perdida cair na sua mesa, esses logs são sua evidência.
Uma pergunta de verdade para te deixar: hoje à noite, vá verificar quantos dos seus pedidos atingiram a API de etiquetas mais de uma vez no último mês. Esse número é o limite superior da sua população de etiquetas fantasma. Você pode perder o sono por isso — mas ainda é melhor do que ser acordado pelo atendimento ao cliente.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.