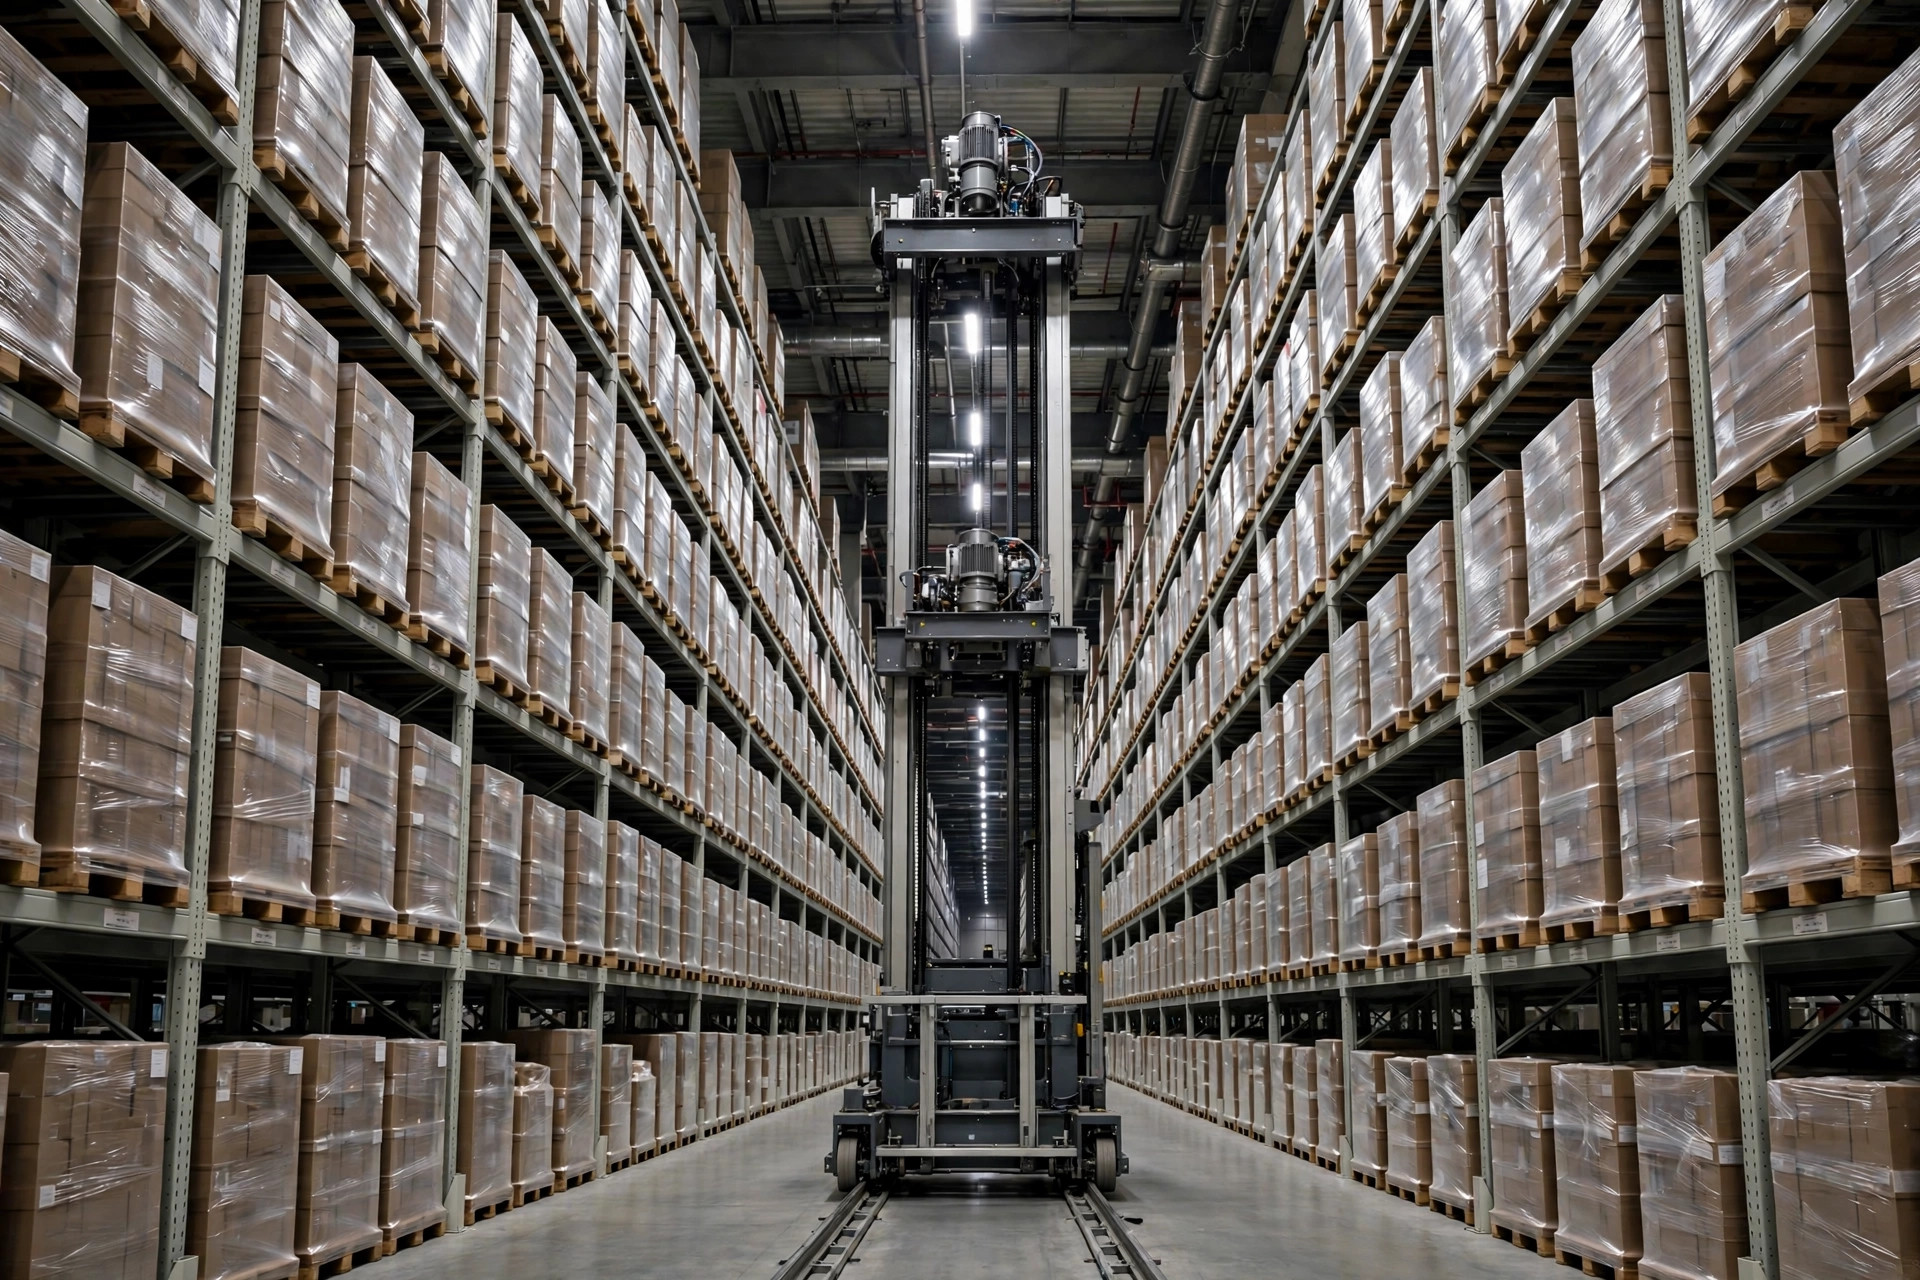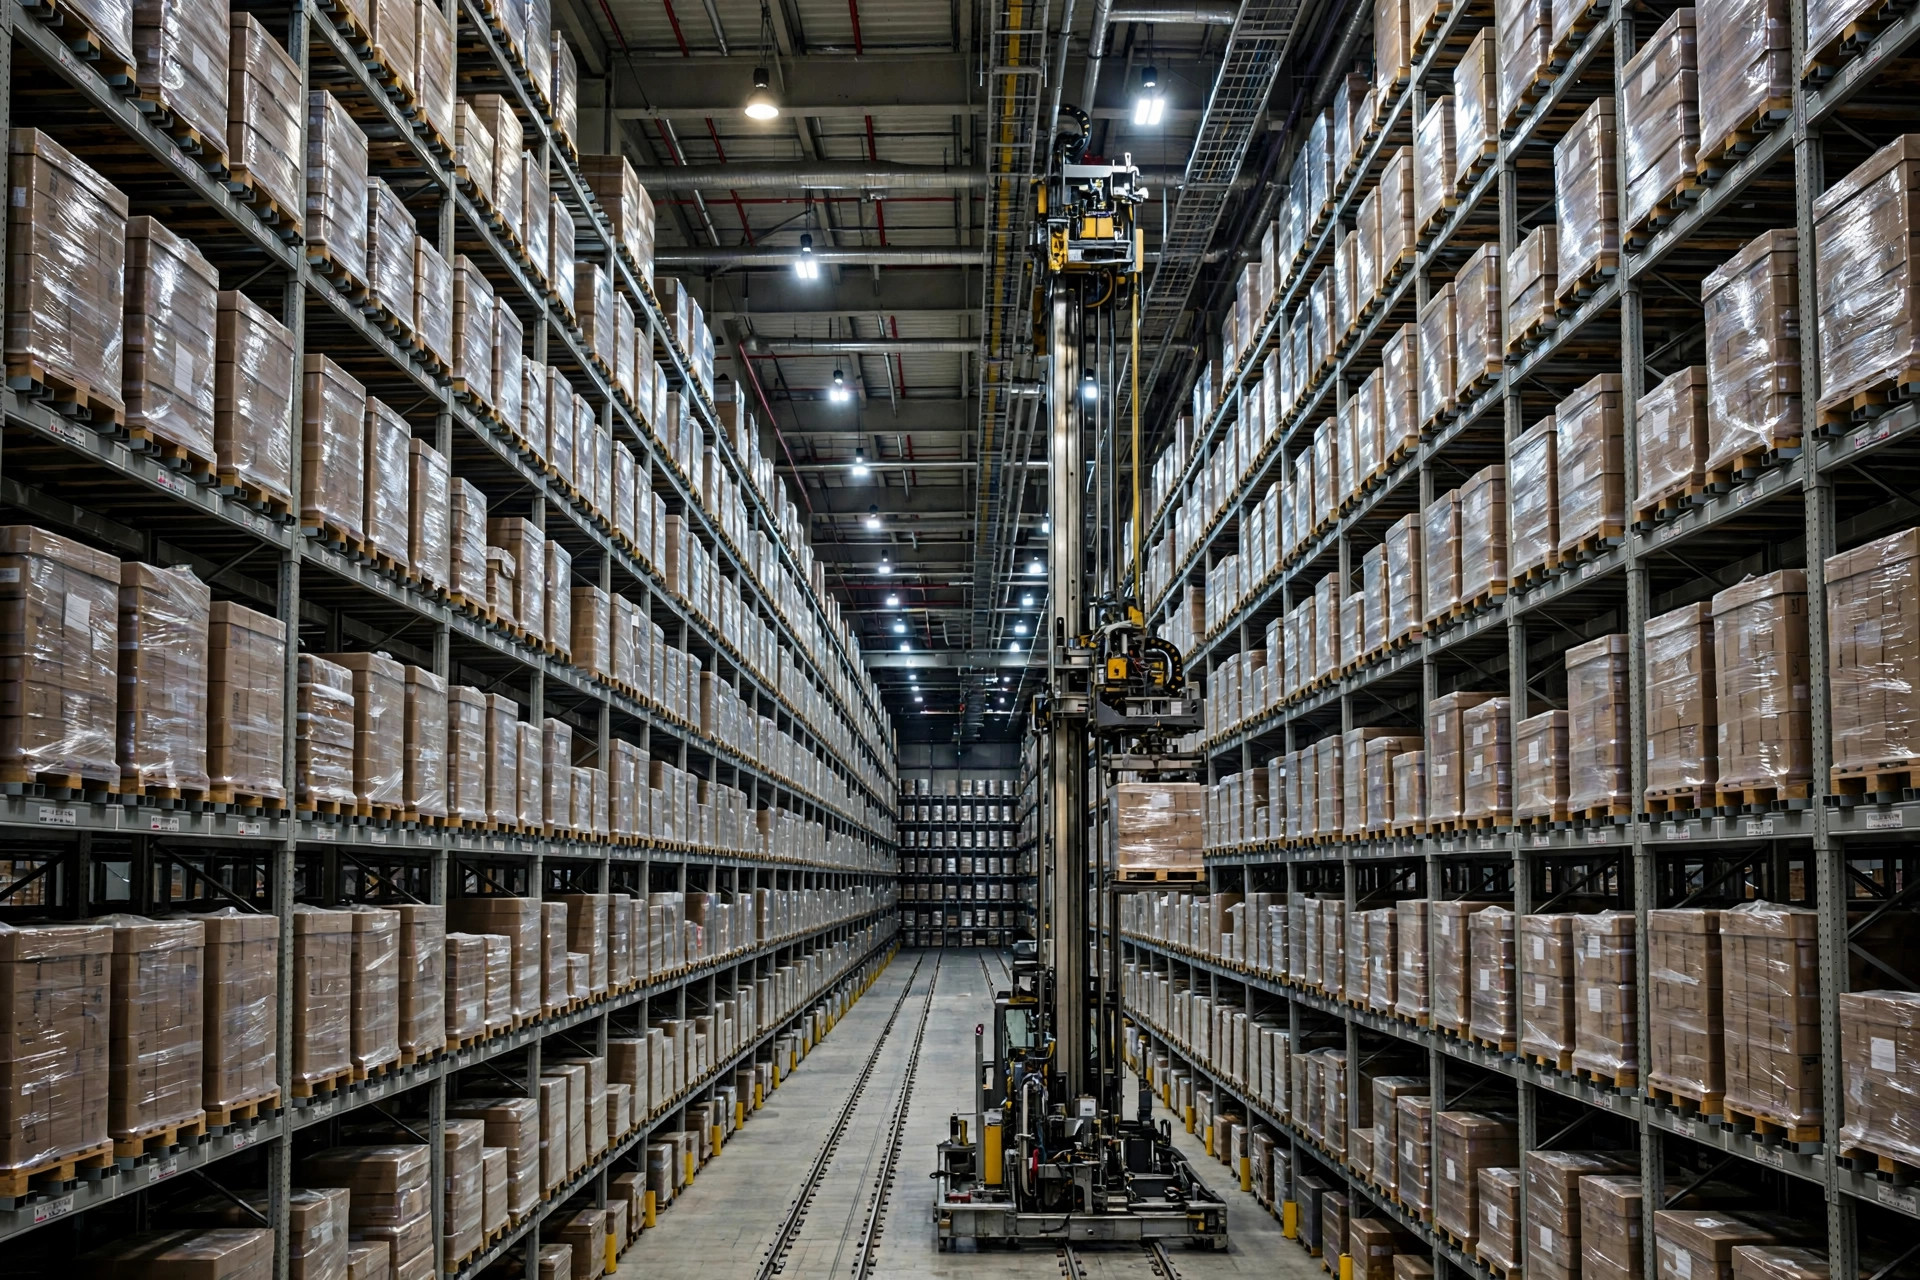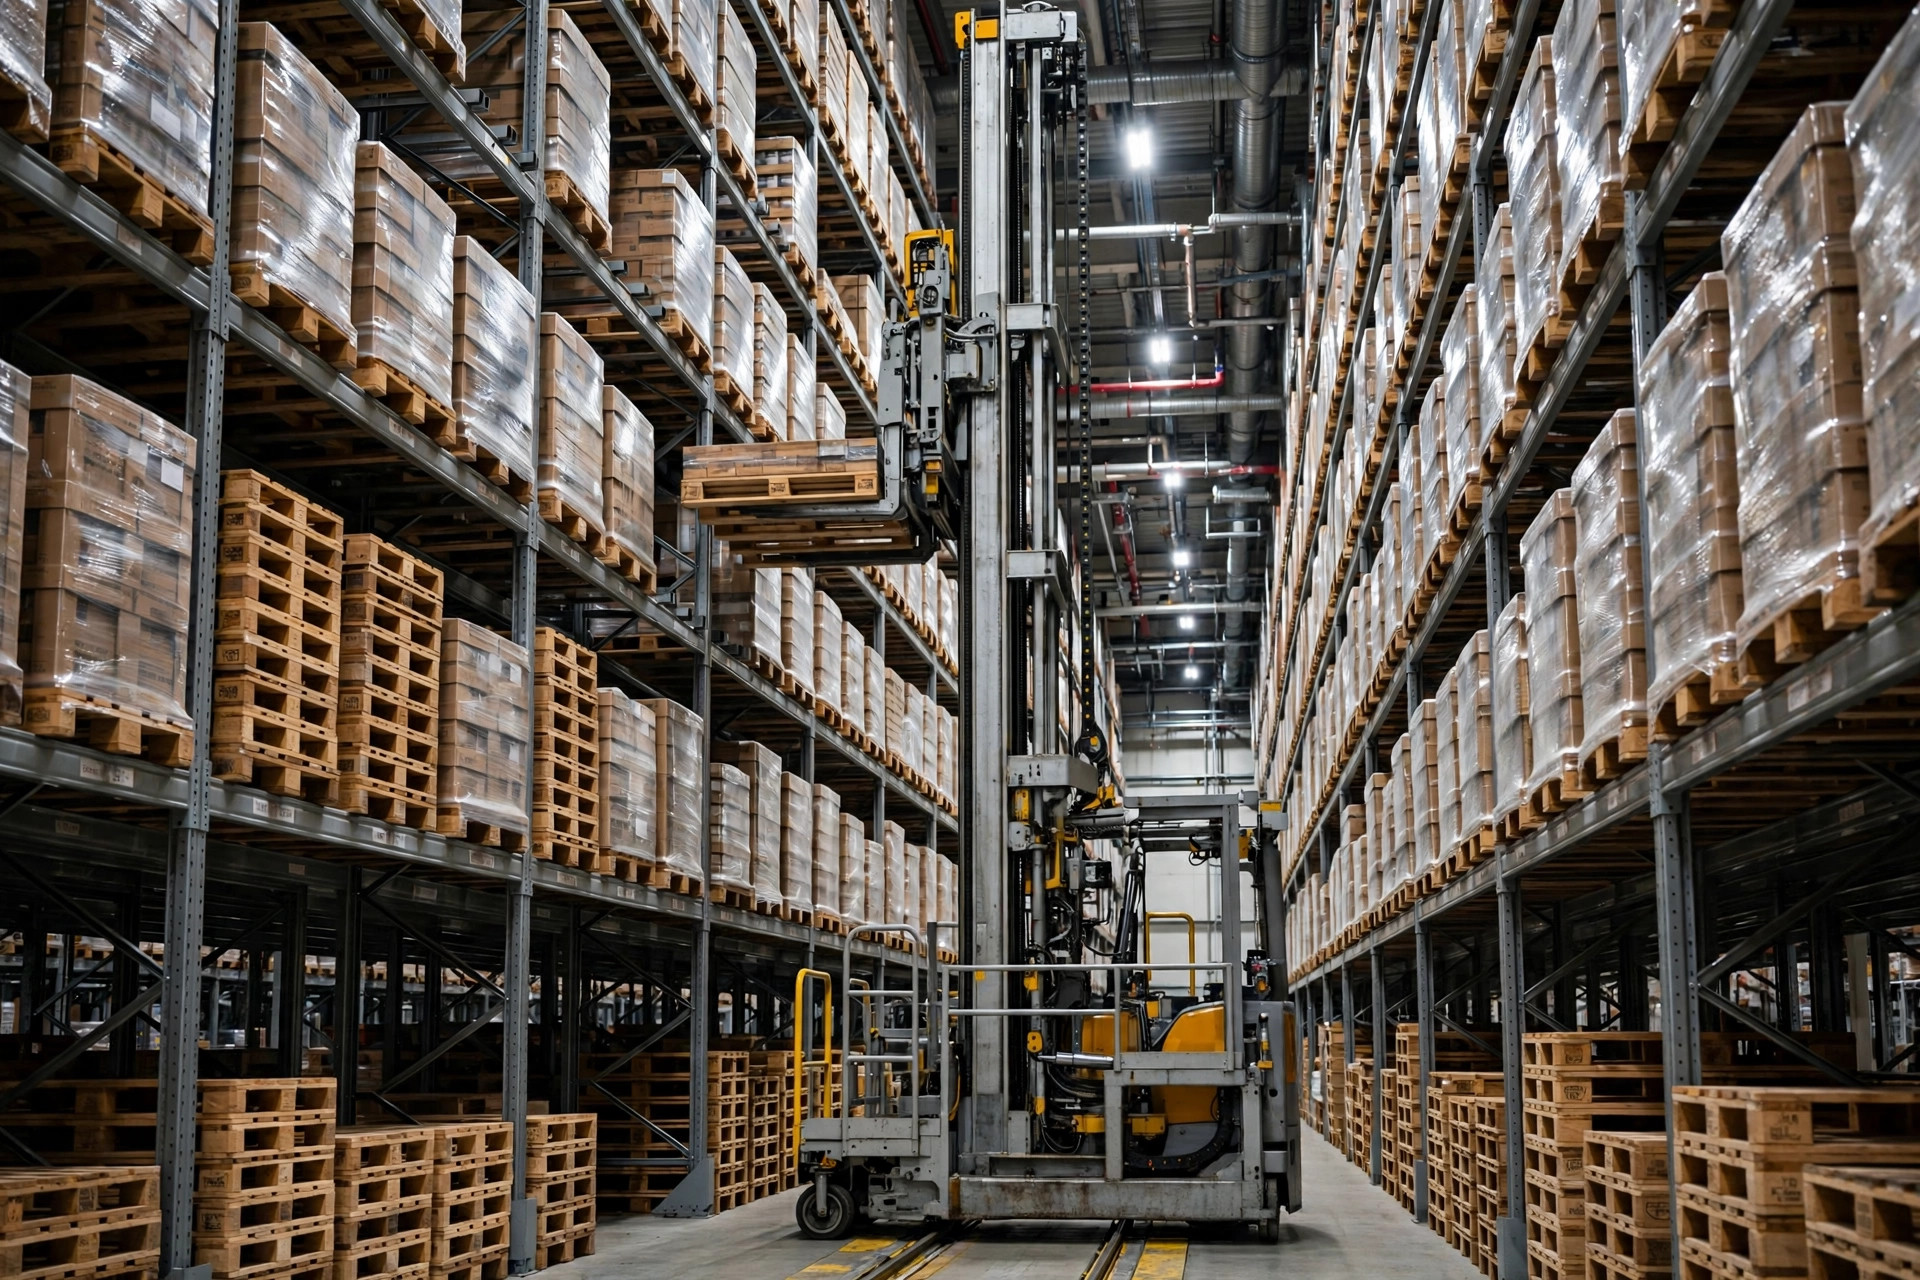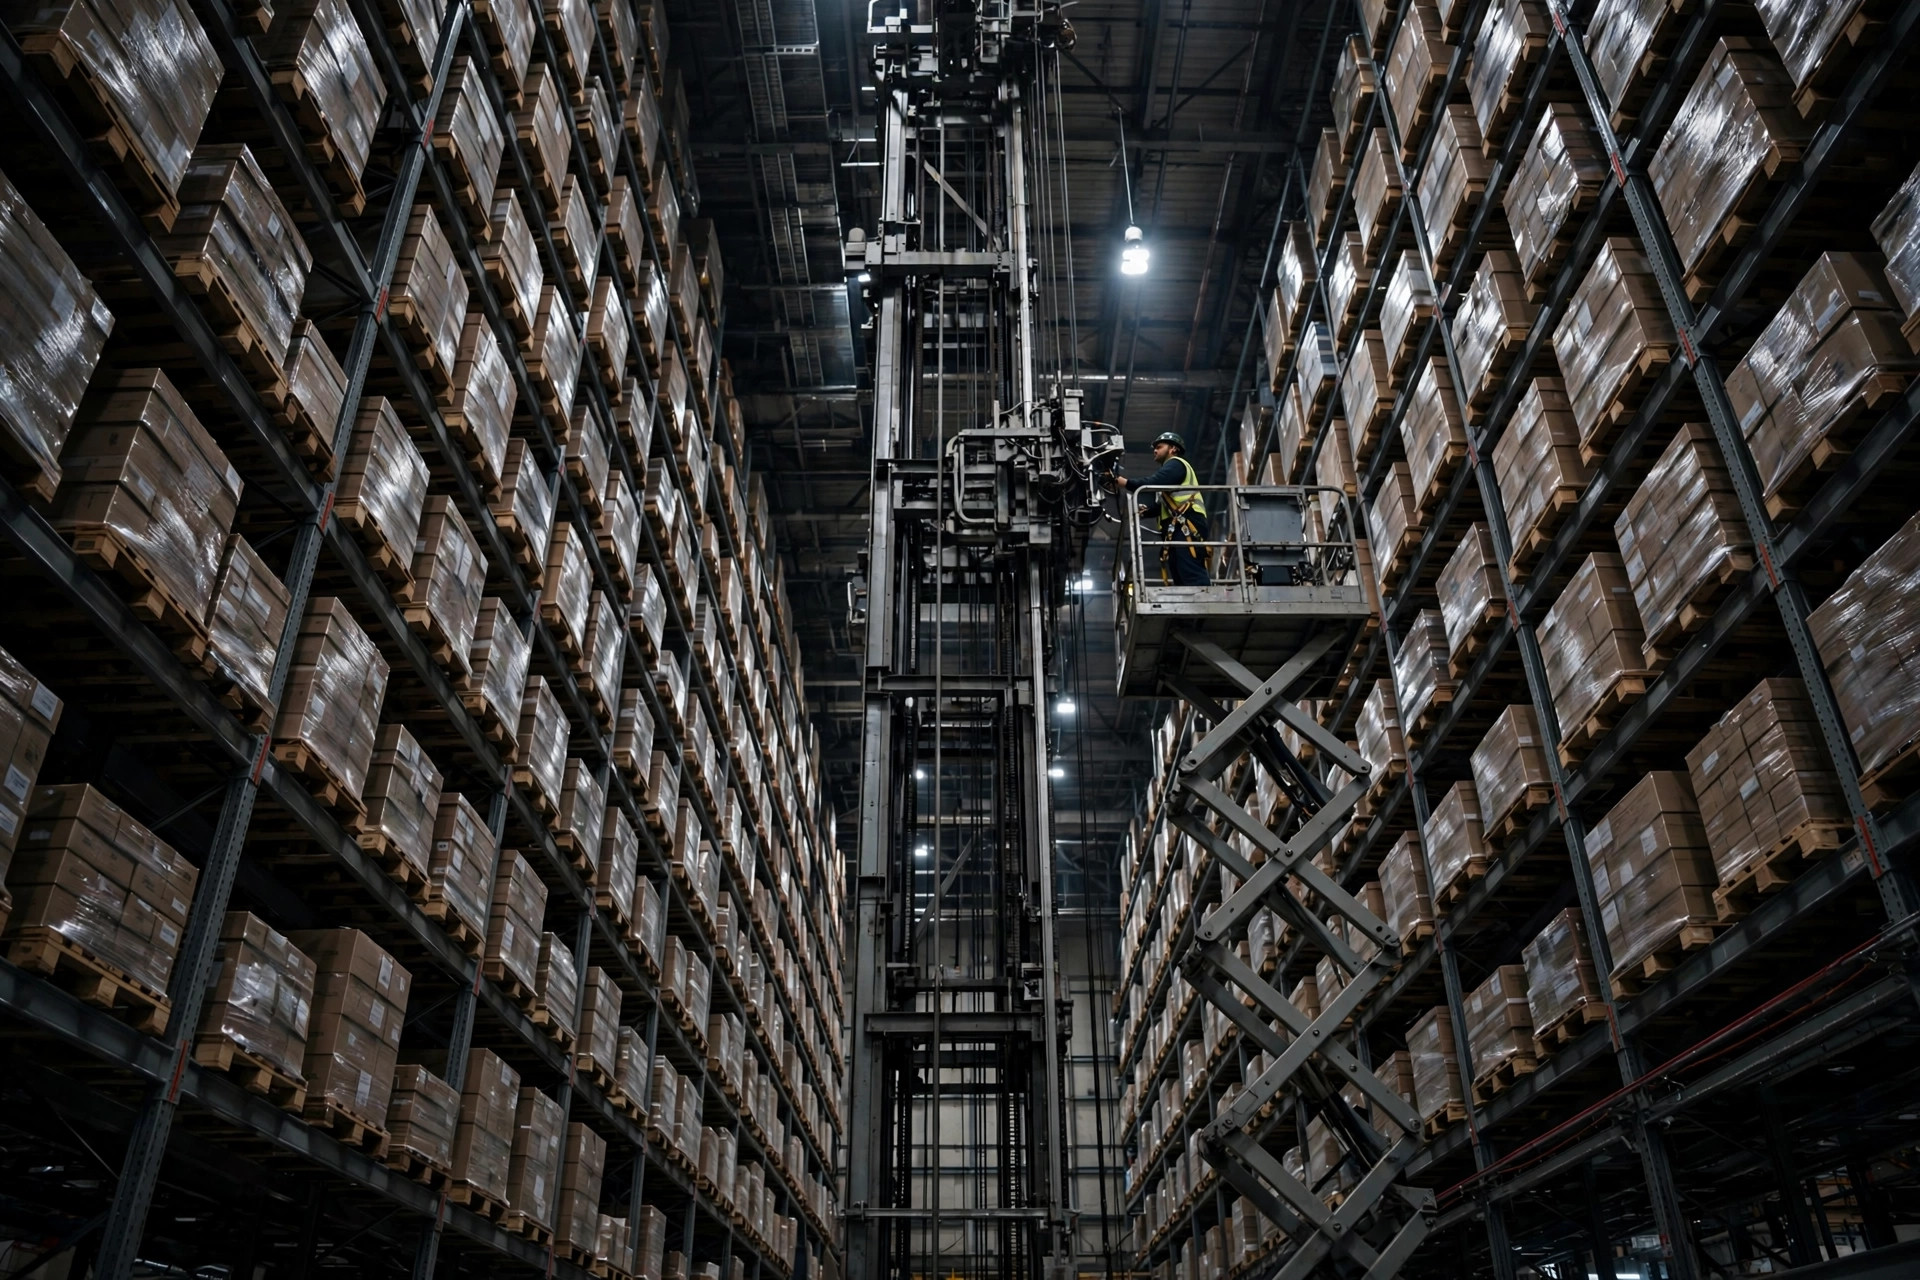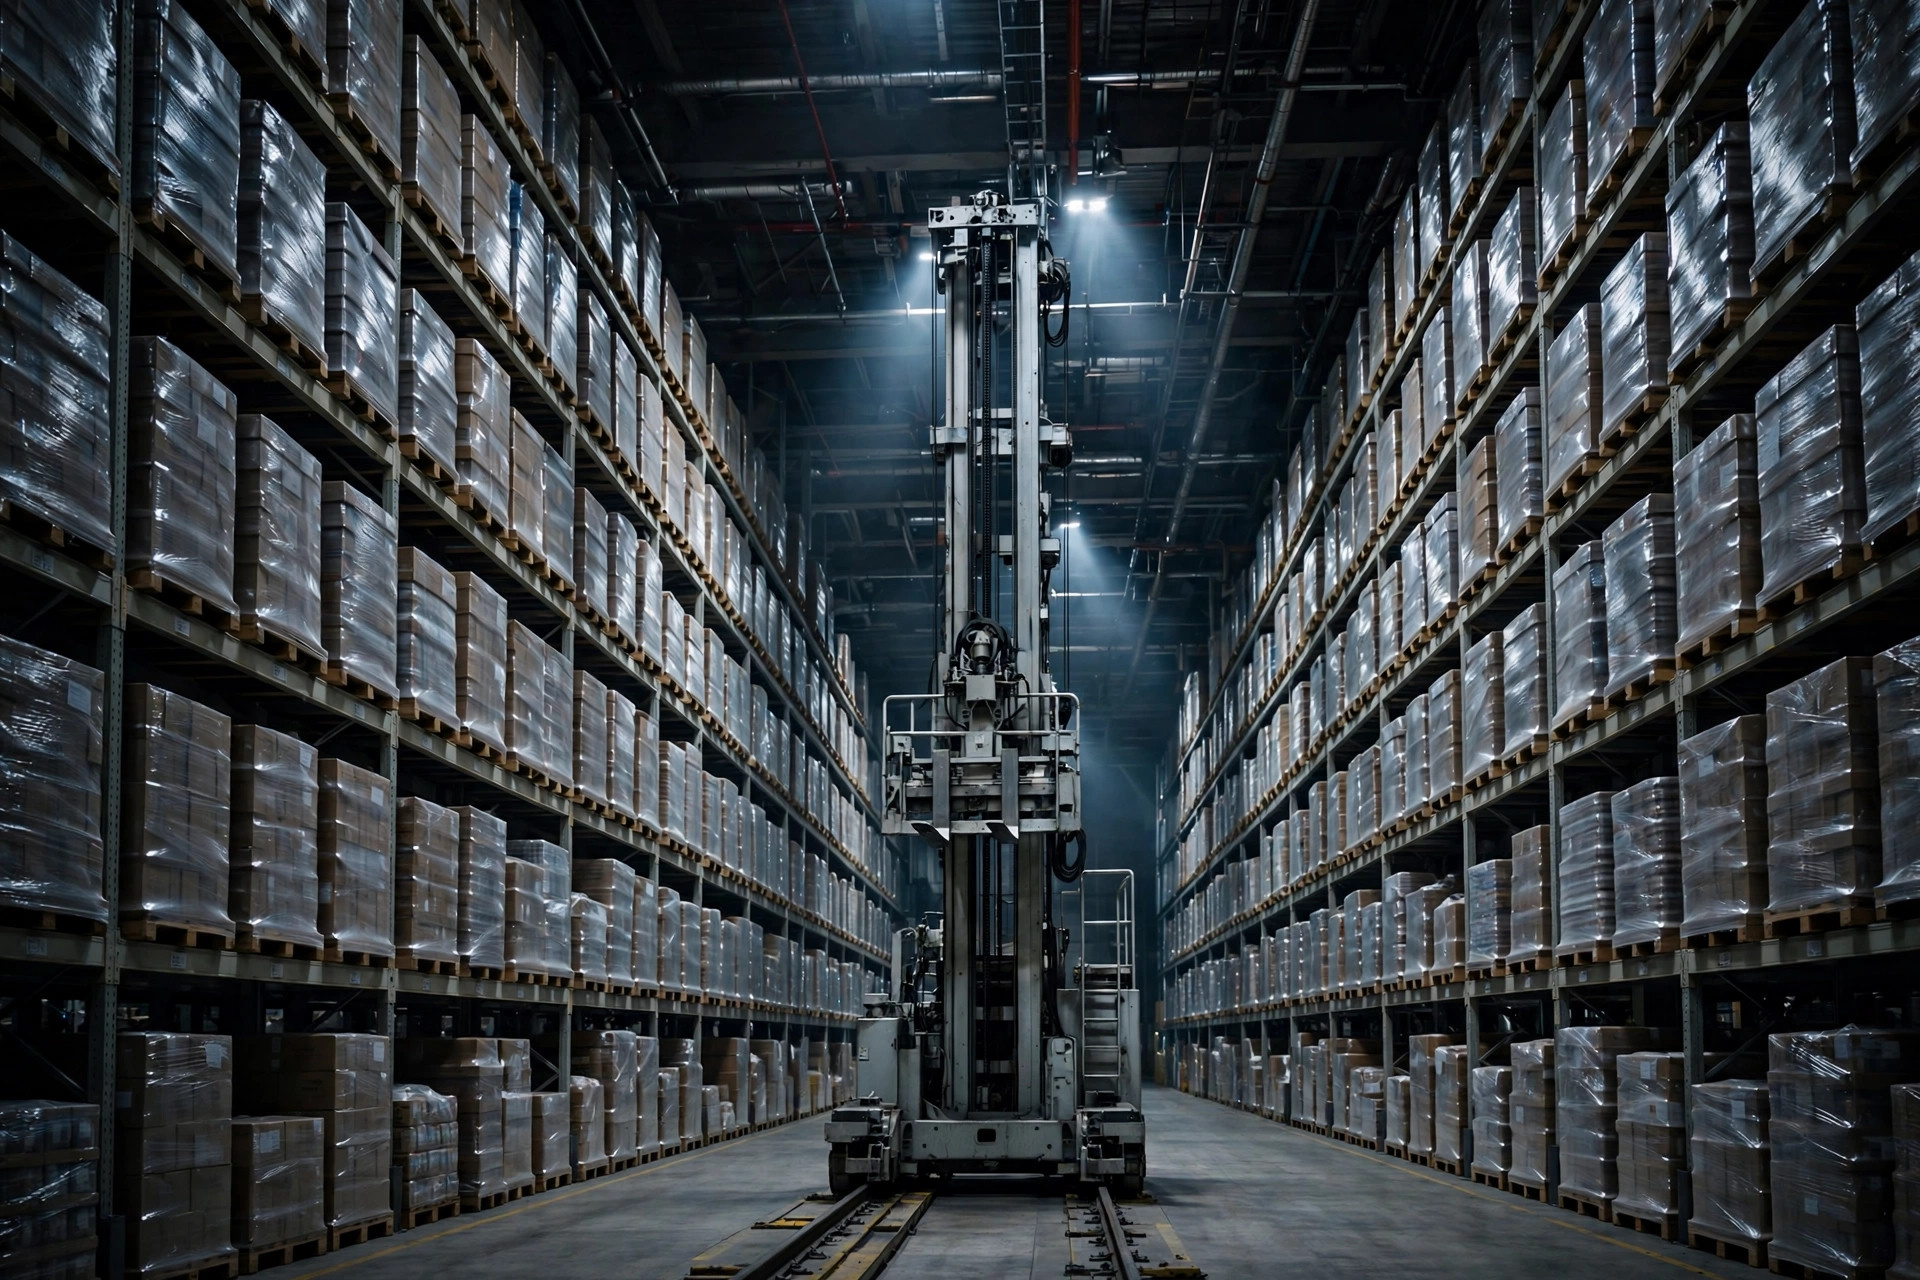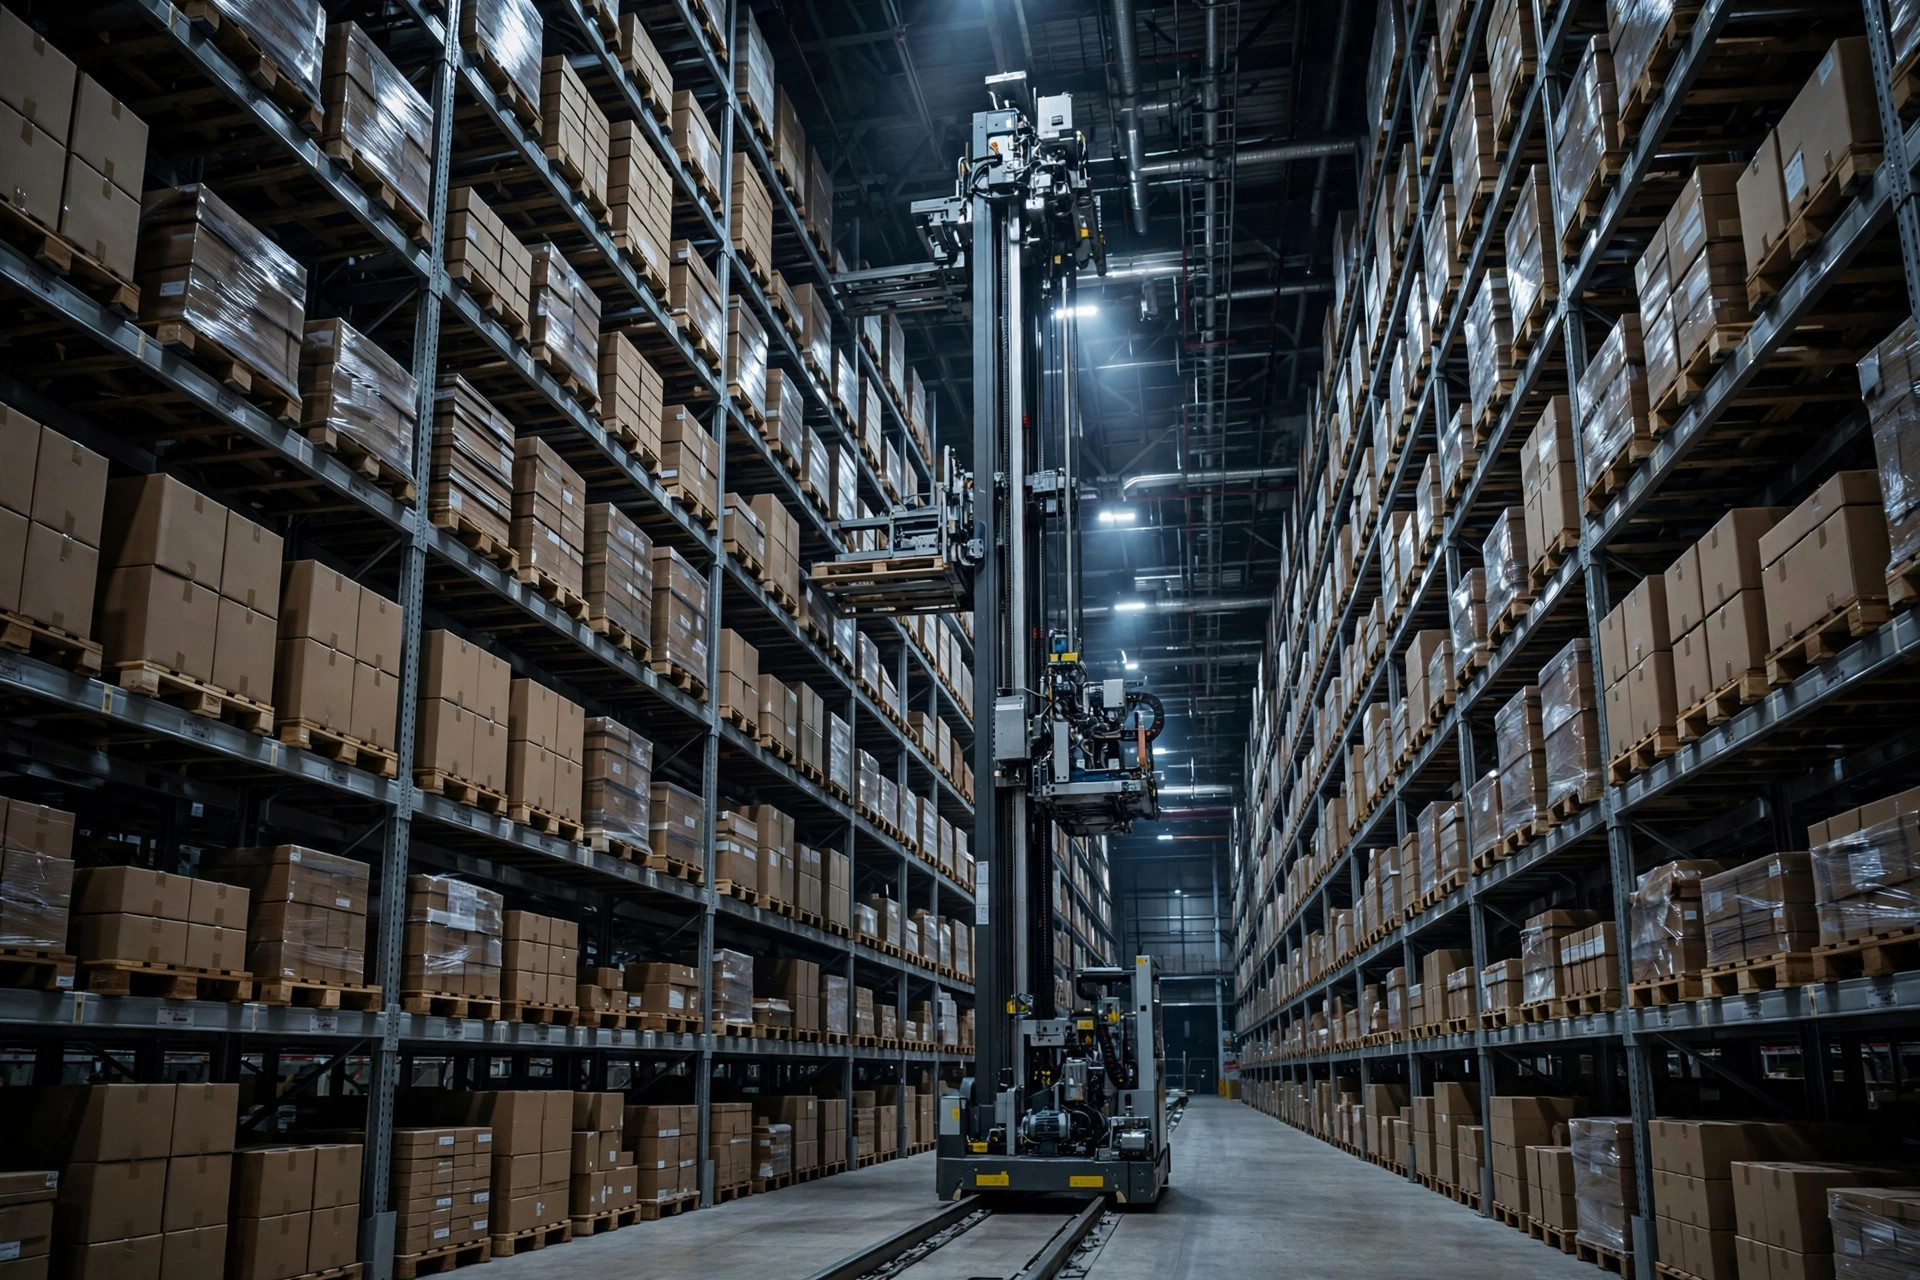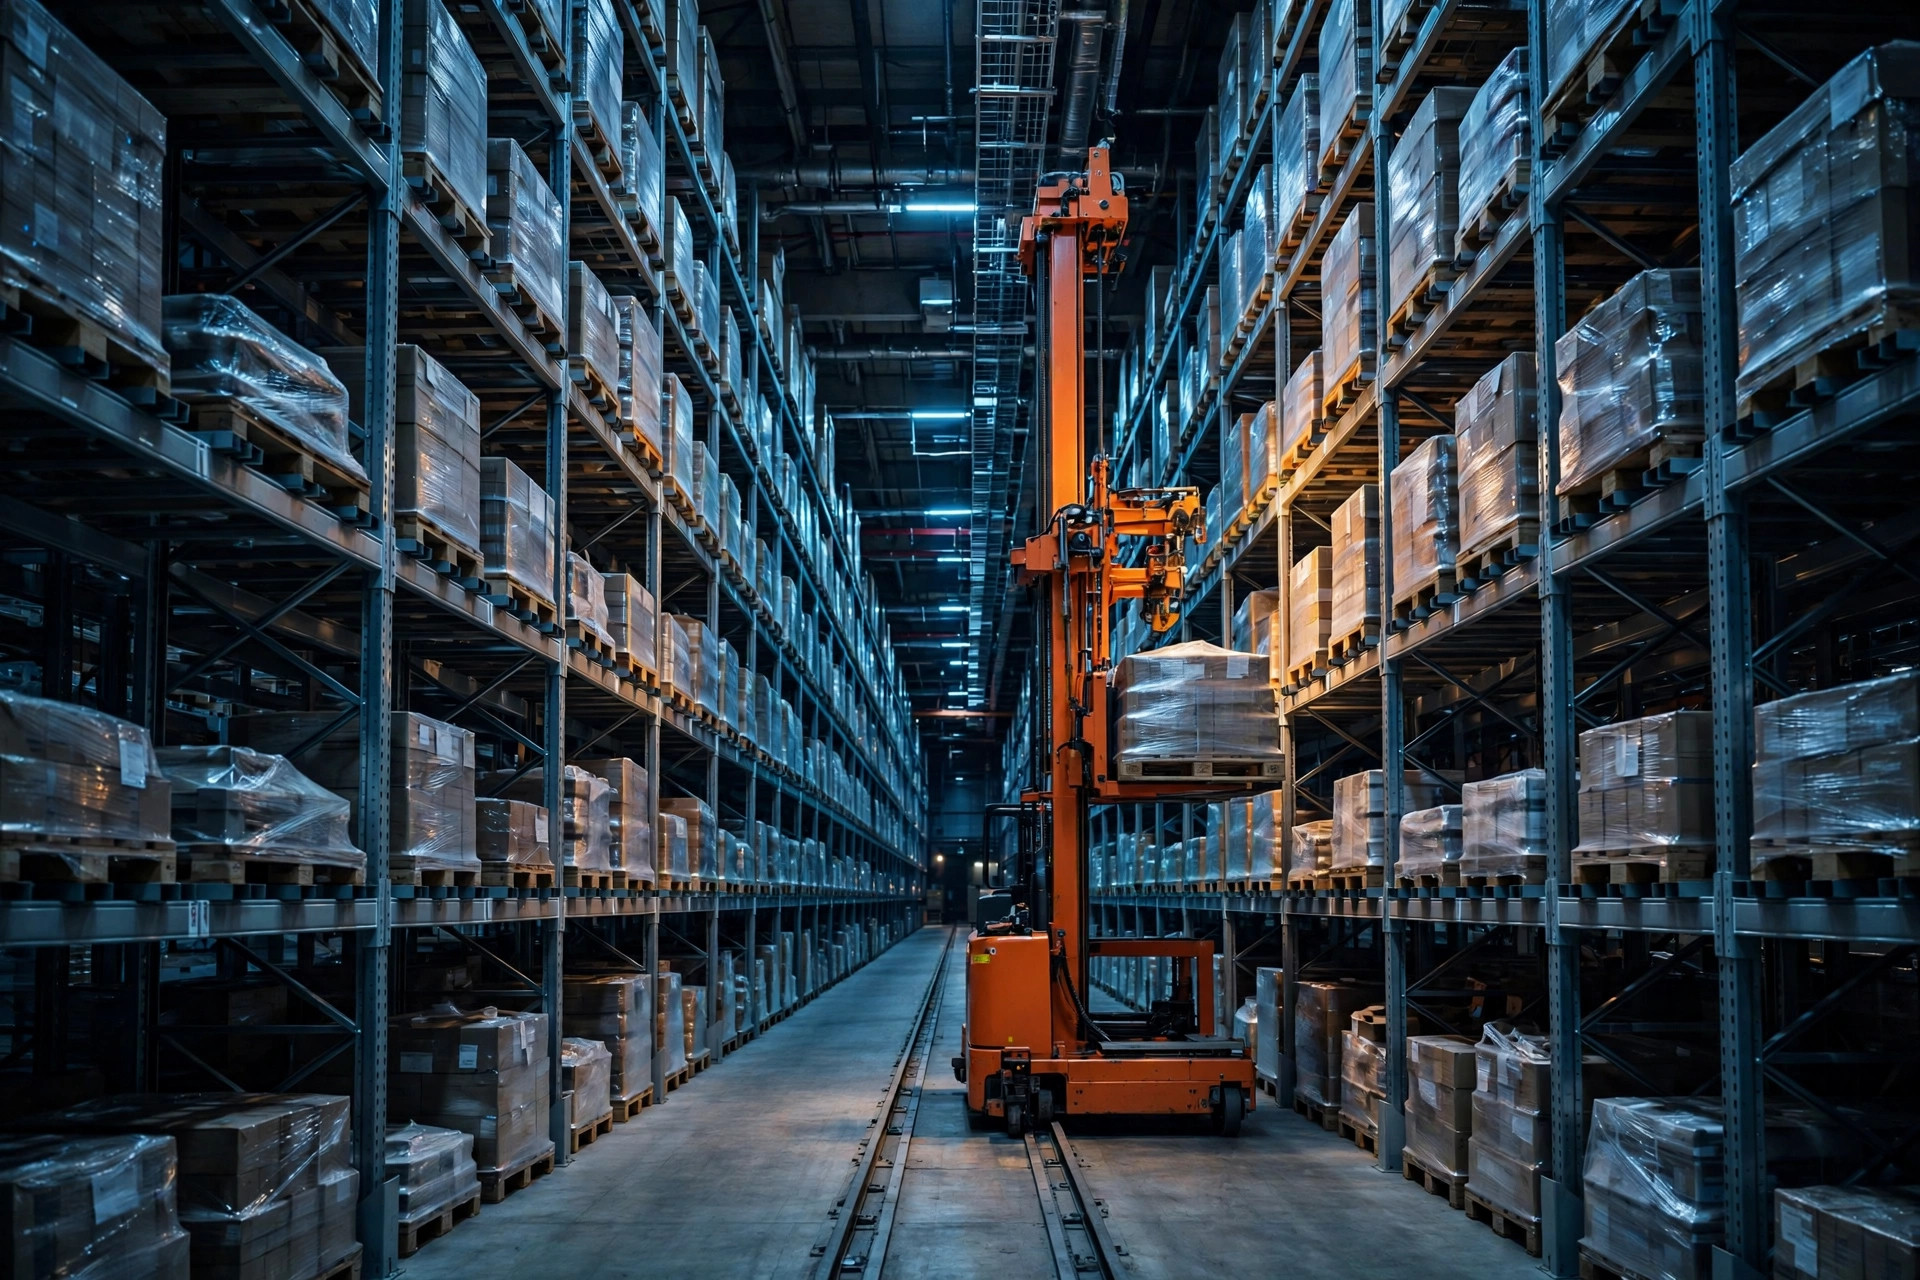
Outono de 2023, um centro de distribuição de alimentos de 140.000 pés quadrados nos arredores de Kansas City, 2:47 a.m. O supervisor do turno da noite me ligou e pude ouvir o tremor na voz dele. Oito transelevadores estavam congelados no meio dos corredores. A fila de tarefas na tela não se movia há vinte minutos: o sistema de controle do armazém acabara de receber um patch e seu agendador de tarefas estava morto. As luzes estavam acesas. A energia estava normal. Os transelevadores não estavam quebrados. O cérebro do sistema estava apenas embaralhado. Enquanto isso o WMS continuava empurrando ondas e os caminhões de saída já faziam fila nas docas.
Vamos deixar claro: isso não é um apagão. Um apagão é quase um alívio: o gerador entra, todo mundo sabe que algo grande aconteceu e o manual é óbvio. Uma falha de software é pior porque está meio viva. Tudo parece normal. Nada se move. E o primeiro instinto da equipe da noite é sempre "vamos esperar para ver se se resolve sozinho". Vi um armazém seguir esse instinto das 2 a.m. às 5:30 a.m., perder sua primeira janela de agendamento de entrega e passar a manhã pagando taxas de detenção e reagendando. Esperar é a opção mais cara do cardápio.
Primeiro, descubra qual camada realmente quebrou
Um AS/RS funciona em três camadas: o WMS emite as ordens, o WCS as agenda e os CLPs dos transelevadores as executam. Qual camada quebrou determina tudo o que você fará a seguir, então não comece a reiniciar as coisas sem pensar.
Um WCS congelado é o caso mais comum: a fila trava enquanto cada transelevador aparece online, parado no lugar, esperando instruções que nunca chegam. Um problema na camada CLP geralmente atinge um transelevador com um alarme enquanto os outros corredores continuam funcionando. A rede intermitente é a mais traiçoeira: as tarefas entram e saem, e o chão parece assombrado.
Minha lição mais cara chegou em 2019, num armazém em Ontário. O WCS parecia morto e o gerente de turno reiniciou o servidor sem pensar duas vezes. Cada tarefa em andamento perdeu seu estado. Dezenas de paletes não correspondiam mais às suas localizações do sistema, e foram necessários três dias completos de contagens cíclicas para conciliar. Três dias de verificação manual de saída a uma fração da produtividade normal. Minha regra de ferro desde então: leia os logs antes de tocar em qualquer coisa. Uma reinicialização é o último recurso, nunca o primeiro movimento. Antes de agir, confirme três coisas: o timestamp da última tarefa despachada com sucesso no monitor do WCS, se cada CLP de transelevador ainda está online e se o heartbeat da interface WMS-WCS está saudável. Dez minutos de verificação podem ser a diferença entre uma solução de trinta minutos e uma bagunça de três dias.
Esvazie a fila antes de fazer qualquer outra coisa
Depois de confirmar que é um problema de camada WCS com equipamentos saudáveis, o primeiro passo não é consertar: é esvaziar. Deixe as tarefas já despachadas aos transelevadores terminarem naturalmente, enquanto congela o WMS para não liberar nada novo. A ordem importa: os paletes nos garfos e nos transportadores pertencem a alguém. Uma parada brusca os abandona no meio do caminho, e boa sorte para encontrá-los depois.
Durante o esvaziamento, o chão faz exatamente três coisas: congelar a liberação de ondas no WMS, permitir que as tarefas em andamento se concluam sozinhas e registrar manualmente a posição de qualquer palete preso num transportador. Parece lento (geralmente dezenas de minutos) e sempre haverá alguém pressionando para ir mais rápido. Não vá. O que o esvaziamento compra é a acurácia do inventário. Lembre-se do armazém de Ontário: pularam um esvaziamento de trinta minutos e pagaram com três dias de conciliação. Essa é uma lição que só precisa aprender uma vez.
Como o modo degradado funciona na prática: semiautomático e manual
Quando o WCS não vai voltar tão cedo mas os caminhões de hoje não podem esperar, você opera em degradado. Há duas marchas, dependendo de quantas pessoas você tem.
A primeira marcha é semiautomática: coloque os transelevadores em modo standalone e ponha um operador na boca de cada corredor para despachar armazenagens e retiradas a partir de folhas de tarefas impressas. A produtividade cai para cerca de um terço à metade do normal, mas o fluxo nunca para e os caminhões continuam carregando um atrás do outro. A segunda marcha é totalmente manual: empilhadeiras trabalham nas extremidades dos corredores, os operadores separam à mão e cada movimento é lançado como uma transação manual de inventário no WMS. Parece primitivo, mas naquela noite em Kansas City o semiautomático nos sustentou por seis horas e batemos o plano de saída do dia sem perder um único caminhão.
Dois detalhes decidem se o modo degradado salva você ou enterra você. Primeiro, o WMS precisa mudar para o modo de tarefa manual. Se continuar liberando ondas no ritmo da automação, as tarefas se acumulam mais rápido do que o chão consegue despachar: é jogar gasolina no fogo enquanto tenta apagá-lo. Segundo, registre cada movimento manual: quem tocou, qual palete, de qual localização para qual. Quando o WCS voltar, você reconcilia o físico contra o sistema. Sem esse rastro manuscrito, as divergências ficam enterradas até a próxima contagem física, e aí ninguém consegue dizer quem moveu o quê errado.
A lista do simulado: com que frequência é suficiente
Um procedimento de modo degradado que você nunca ensaiou não existe. Às 2 a.m. durante uma falha real, ninguém está lendo um manual de quarenta páginas. É tudo memória muscular.
Minha recomendação: um exercício de mesa a cada trimestre: gerente de turno, fornecedor do WCS e TI numa sala, trinta minutos, percorrendo toda a sequência. E um simulado ao vivo por ano: escolha um turno da noite de baixo volume e realmente opere em modo manual por duas horas. O simulado ao vivo sempre revela algo quebrado. Nunca vi um primeiro simulado sair bem.
Antes de tudo isso, deixe isto pronto:
- O contato de emergência do fornecedor do WCS impresso e colado na parede da sala de controle: não apenas salvo no celular de alguém, porque às 2 a.m. esse alguém pode não atender;
- Modelos de folhas de tarefas manuais em branco pré-impressos e prontos na estação do chão: não vá caçar uma impressora no meio da crise;
- Os passos de troca para o modo manual do WMS numa única folha, colados ao lado do console;
- Uma pessoa nomeada, e só uma, autorizada a ordenar o esvaziamento e a troca para degradado, porque três pessoas dando ordens às 3 a.m. já é um desastre por si só;
- Depois de cada simulado, registre um número: minutos da detecção da falha ao modo degradado em operação. Anote. Essa é a sua munição da próxima vez que pedir orçamento e pessoal ao chefe.
Então fica a pergunta para você: da última vez que seu WCS falhou, quanto tempo levou para colocar o modo degradado em operação? Se a resposta for "nunca tentamos", então da próxima vez que o telefone tocar às 2 a.m., a primeira coisa a entrar em pânico não será o equipamento. Serão as pessoas.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.