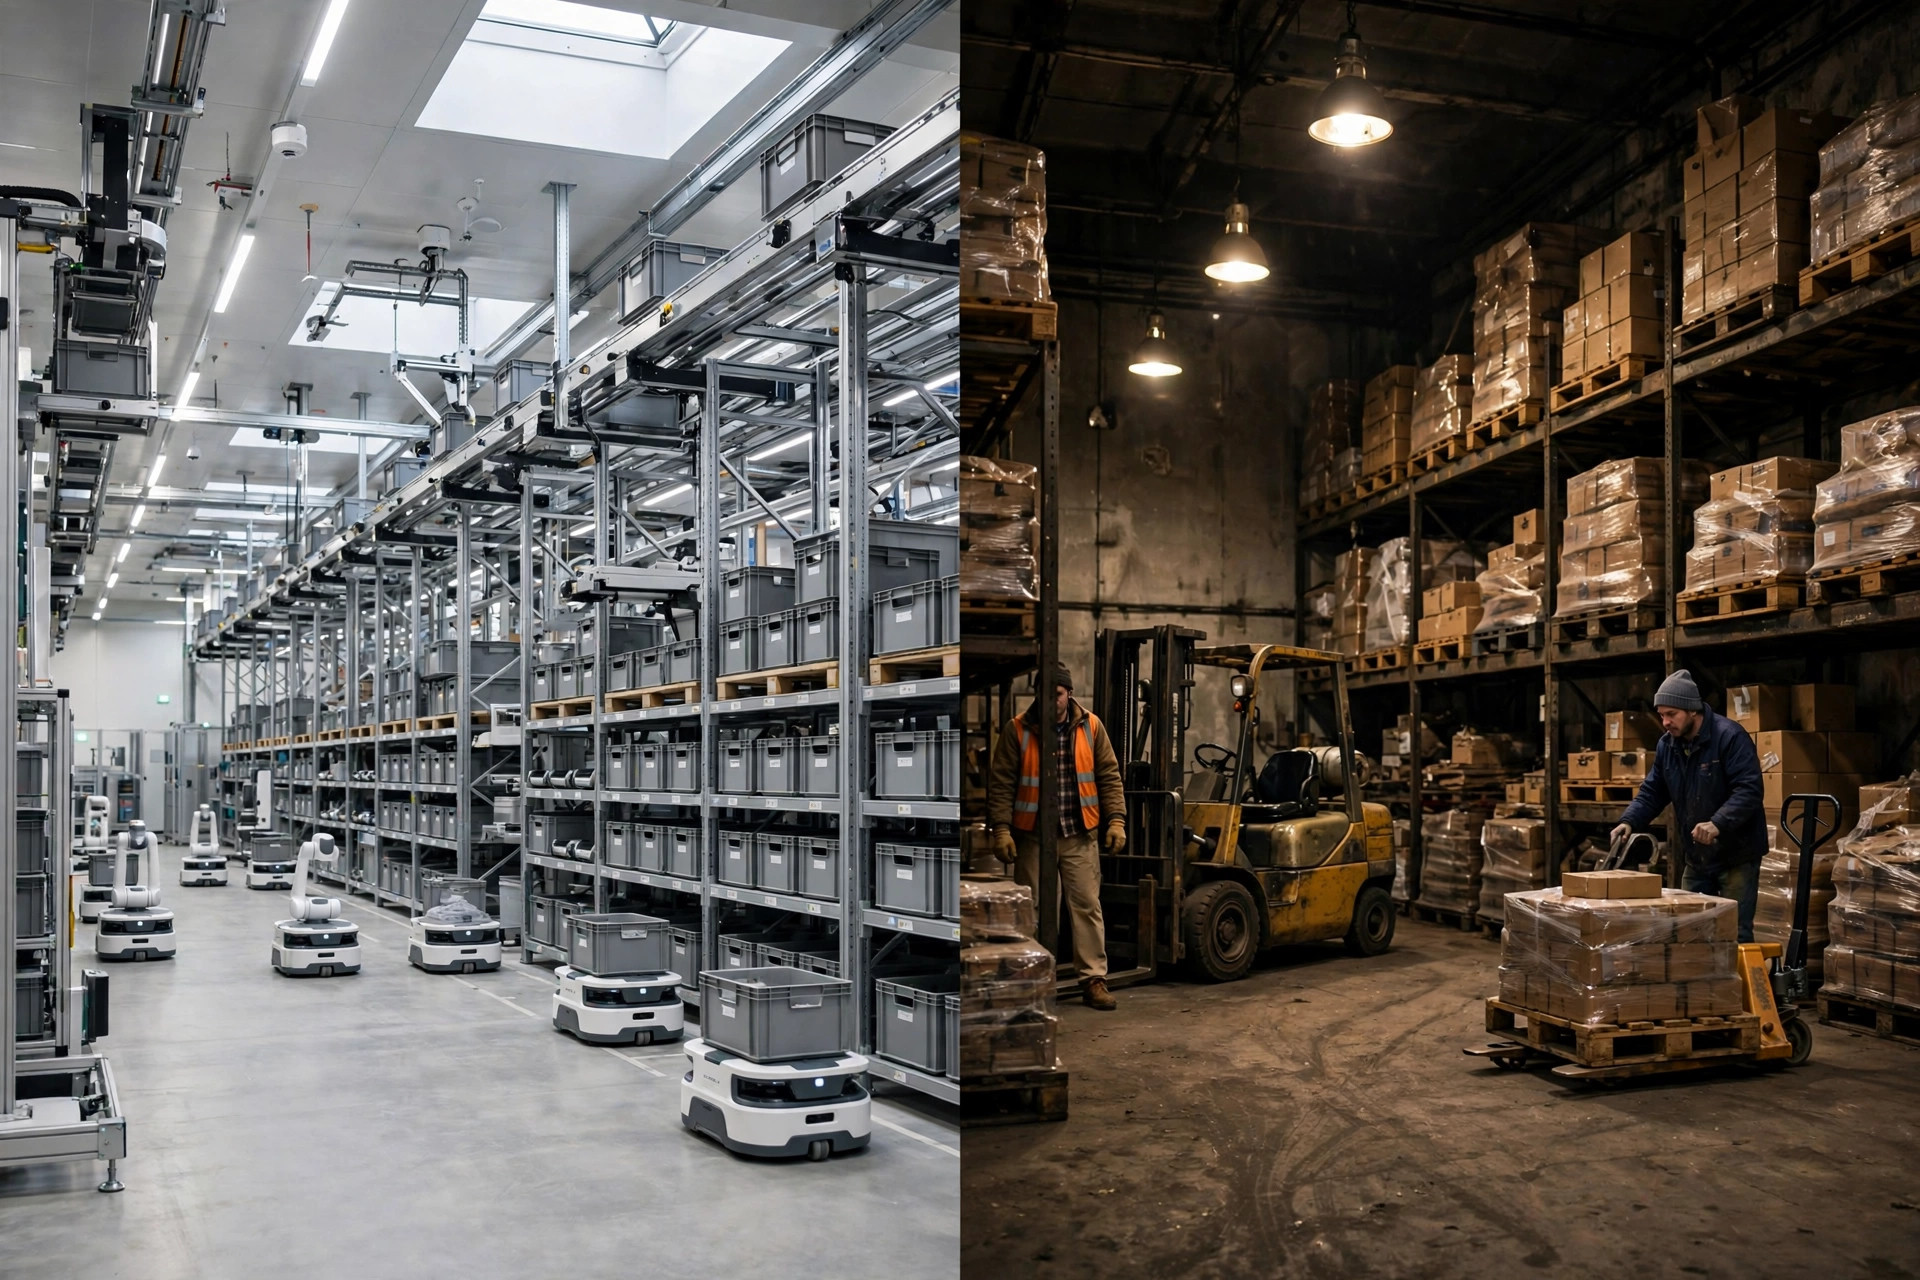
Nos últimos dois anos, em entrevistas com mais de vinte empresas de armazenagem e varejo que conduziram pilotos de IA, notei um padrão de consistência surpreendente: o piloto quase sempre pousa na melhor instalação da empresa — o centro de distribuição emblemático com a rede mais estável, os dados mestres de SKU mais limpos, os processos mais padronizados, a força de trabalho mais cooperativa e a gestão mais solidária. A lógica parece impecável: colocar o piloto onde o sucesso é mais provável, provar o conceito e depois replicar. No entanto, seis a doze meses depois, quando essas empresas implantam a solução em seu segundo e terceiro sites, surge um fenômeno igualmente consistente: os impressionantes números do piloto encolhem drasticamente, e alguns projetos são discretamente engavetados durante a implantação. O piloto "teve sucesso", mas a implantação fracassou. Esse paradoxo merece um olhar mais atento.
Os números: uma lacuna entre pilotar e escalar
Segundo o relatório do MIT Project NANDA "The GenAI Divide: State of AI in Business 2025", publicado em agosto de 2025, cerca de 95% dos pilotos empresariais de IA generativa não produziram nenhum retorno mensurável na demonstração de resultados; apenas cerca de 5% das organizações capturaram valor real em escala. Uma nota sobre a metodologia é necessária aqui: o número de 95% usa todas as organizações pesquisadas como denominador, enquanto entre as organizações que realmente conduziram pilotos, cerca de uma em cada quatro acabou chegando à escala de produção. De qualquer forma, a conclusão se mantém — uma ampla lacuna separa pilotar de escalar, e a maioria das organizações nunca a atravessa. Minha observação é que o primeiro passo dessa lacuna é frequentemente dado no momento em que o site do piloto é escolhido: a seleção do site é em si uma forma de amostragem, e pilotar no seu melhor armazém é, em termos estatísticos, uma amostra enviesada.
Por que o melhor armazém é a pior amostra de piloto
Três mecanismos explicam o paradoxo.
Primeiro, a confusão de dotação. As vantagens inerentes do site emblemático — dados limpos, processos padronizados, redes estáveis, uma equipe cooperativa — fazem qualquer solução parecer mais eficaz do que realmente é. Os estatísticos chamam isso de viés de seleção: você acredita estar medindo o efeito da IA, mas na verdade está medindo o efeito combinado de "um ótimo armazém mais IA", e atribuindo tudo à IA. Uma parcela significativa do ROI do piloto é paga pela dotação do armazém, não pelo algoritmo.
Segundo, a distorção de recursos. Um período de piloto é incomumente mimado: engenheiros do fornecedor estacionados no local, gerentes de projeto da sede fazendo acompanhamento diário, as melhores pessoas do armazém realocadas para apoiar os testes. Esses insumos ocultos nunca aparecem no denominador de custos do piloto, mas são reais, e genuinamente inflam o desempenho do piloto. Quando os recursos são retirados durante a implantação, o desempenho regride — não porque a IA quebrou, mas porque as condições de estufa desapareceram.
Terceiro, o viés de sobrevivência na narrativa. Pilotos com números bonitos se tornam estudos de caso contados e recontados; pilotos medíocres são discretamente encerrados e nunca mais mencionados. Os números de "ROI do piloto" que circulam no setor vêm de uma amostra filtrada que sistematicamente superestima a realidade — e por sua vez reforça o instinto aparentemente óbvio de pilotar no melhor armazém.
Considere o primeiro caso. Na segunda metade de 2024, um 3PL lançou um piloto de auditoria baseado em visão por IA em seu armazém emblemático perto de Suzhou. Após três meses, a precisão da auditoria subiu de 99.2% para 99.6%, as interceptações de exceções quase dobraram, e a equipe do projeto estimou economias anualizadas de mão de obra de cerca de RMB 400,000. O piloto foi classificado como um "sucesso acima das expectativas". No início de 2025, o mesmo equipamento e a mesma versão do algoritmo foram implantados em armazéns regionais em Wuxi e Hefei — a precisão melhorou em menos de 0.1 ponto percentual, essencialmente ruído. A autópsia encontrou a diferença-chave: as estações de auditoria do emblemático haviam sido renovadas em 2023, com iluminação uniforme e paletes e caixas totalmente padronizados, enquanto os sites regionais tinham iluminação envelhecida e uma mistura desordenada de tamanhos de caixas. O que o modelo de visão havia "aprendido" durante o piloto era a assinatura visual de um ambiente padronizado. Em outras palavras, o piloto não mediu a capacidade de generalização do algoritmo, mas a amabilidade do ambiente do piloto.
O segundo caso vem do primeiro trimestre de 2025, quando uma rede varejista dos EUA pilotou IA de previsão de demanda em seu centro de distribuição emblemático perto de Dallas, atendendo cerca de 120 lojas, com 98% de integridade dos dados mestres de SKU. Seis meses depois, o erro de previsão (MAPE) havia caído cerca de 4 pontos percentuais e as taxas de ruptura em 1.2 ponto; o veredito foi "sucesso, implantação recomendada". Replicado em dois centros de distribuição no Meio-Oeste — onde a integridade dos dados mestres mal passava de 80% e os registros de promoções eram irregulares — o modelo entregou apenas cerca de 30% dos ganhos do piloto. A equipe então repetiu o piloto em um armazém deliberadamente "médio": lacunas de dados, exceções de processo, cooperação morna. Os números foram menos lisonjeiros do que os do primeiro piloto, mas a lista de verificação de governança de dados e o manual de implantação construídos a partir desse segundo piloto pousaram com sucesso nos quatro armazéns seguintes na primeira tentativa. O líder do projeto disse claramente: o primeiro piloto provou que a IA podia funcionar em condições ideais; o segundo provou que podia funcionar em nossas condições reais. A gestão só precisou da segunda prova.
Aqui está a inferência desconfortável: um piloto cujo ROI supera as expectativas merece escrutínio extra, não celebração, porque a superação pode dever menos à IA e mais ao fato de o site do piloto ser incomumente bom. Um piloto conduzido em um armazém abaixo da média, com números 20-30% mais feios, mede o piso da solução; um piloto conduzido no emblemático mede apenas o seu teto. O que a gestão realmente quer nunca foi o "sucesso do piloto", mas o "sucesso da implantação" — e a lógica de seleção de site para esses dois objetivos aponta em direções opostas: a primeira busca segurança, a segunda busca verdade.
Três linhas para a seleção do site do piloto
| Tipo de site | Perfil típico | Estratégia de piloto |
|---|---|---|
| Emblemático (melhores condições) | Dados limpos, processos padronizados, viés de recursos | Validar apenas a viabilidade técnica; não fazer compromissos de ROI; rotular as conclusões como "referência de teto" |
| Site representativo de nível médio (recomendado) | Escala, mix de SKUs e força de trabalho próximos à média da empresa | A arena principal para medir o ROI; as conclusões podem apoiar diretamente as decisões de implantação |
| Site problemático arquetípico | Um ponto de dor real representativo, p. ex., altos erros de auditoria ou rupturas crônicas | Valida se a solução corrige problemas reais; a atribuição mais limpa de causa e efeito |
| Evitar: sites novos, em mudança ou sob estresse de pico | Linhas de base instáveis, variáveis demais | Inadequados para pilotos; os resultados não podem ser atribuídos |
Vale a pena acrescentar mais um elemento: um controle. Se possível, designe um "controle sombra" — um site comparável na mesma região que não recebe a IA, mas registra dados de linha de base no mesmo período — ou execute comparações por categoria ou por tempo dentro do mesmo armazém. Um ROI de piloto sem grupo de controle é, em sentido estrito, um número infalsificável; seu poder de persuasão existe apenas dentro da apresentação de slides.
Uma mudança já em curso
À medida que o gasto empresarial em IA passa da fase de experimentação para a fase de escala, a metodologia de pilotos está mudando. A lógica inicial era "fazer funcionar primeiro", com a seleção do site otimizada para segurança e velocidade. A lógica emergente é "tornar replicável primeiro", com a seleção do site otimizada para verdade e representatividade. Minha expectativa: por volta de 2027, a avaliação da representatividade do site do piloto se tornará uma etapa padrão na governança empresarial de IA — não porque o setor de repente se tornou rigoroso, mas porque empresas suficientes já pagaram a mensalidade. Quem corrigir primeiro a seleção do site pagará a mensalidade mais baixa na fase de implantação.
Por fim, uma pergunta para levar com você. Se uma solução de IA só produz números bonitos no seu melhor armazém e falha em todos os outros, deveríamos perguntar "a IA funciona?" — ou "nossos armazéns são dignos dessa IA?" E mais: quando a escolha do site do piloto pode determinar em grande parte o resultado do piloto, quantas das celebradas "histórias de sucesso de IA" do setor nos últimos dois anos mediram a tecnologia, e quantas apenas mediram o bom gosto na seleção do site? Não há resposta padrão. Mas toda empresa prestes a lançar um piloto faria bem em fazer a si mesma essa pergunta uma vez — antes de assinar.
Por Dr. Chen, Pesquisador de Cadeia de Suprimentos
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.