먼저 청구서부터 보자.
피킹 로봇에게 카톤을 인식시키는 데는 약 100,000장의 학습 이미지가 필요하다. 손으로 라벨링하면, 공개된 벤더 가격표 기준 단순 바운딩박스 작업은 이미지당 $0.10–$0.50: 첫 패스만으로 $10,000–$50,000이다.
3개월 후 포장재 공급업체가 카톤 자재를 바꾸고, 겨울 조명이 눈부심을 바꾸면, 모델은 박스의 절반을 인식하지 못한다: 추가로 20,000장, 수천 달러가 더 사라진다.
그러니 이 글은 신경망에 대한 이야기가 아니다. 돈에 대한 이야기다: 웨어하우스 AI 비전 모델이 어떻게 학습되는지, 각 루트가 얼마인지, 함정은 어디인지——그리고 자신의 견적을 대입할 수 있는 산수 문제 하나.
먼저 청구서: 웨어하우스 AI 비전 모델 학습법은 3가지 루트로 귀결된다
비전 모델 학습 데이터의 공급원은 정확히 세 가지다: 사람이 찍은 사진, 사람이 그린 것, 기계가 생성한 것.
루트 1: 실제 사진 + 사람 라벨링. 웨어하우스 현장에서 촬영하고 손으로 박스를 그린다——"이것은 카톤, 이것은 팔레트, 이것은 파손".
루트 2: CAD 시뮬레이션 렌더링. 정확한 3D CAD 도면이 있으면 가상 부품을 가상 빈에 떨어뜨리고, 조명·수량·텍스처·노이즈를 무작위화한 뒤 수백 장의 이미지를 렌더링한다. 라벨은 자동 생성된다——엔진이 모든 부품의 위치를 알기 때문이다. 사람의 시간은 파라미터 조정에 쓴다.
루트 3: 생성 AI 합성 데이터. 도면이 필요 없다. 생성 AI가 어노테이션된 웨어하우스 장면을 직접 "그린다"——찌그러진 카톤, 먼지, 스트레치 랩 같은 추한 상태까지. 비용 비교표는 아래에 있다. 하나씩 가자.
루트 1: 실제 사진 + 사람 라벨링——가장 멍청하고, 가장 비싸고, 가장 정직하다
가장 오래된 루트이자, 지금도 대부분의 웨어하우스 비전 프로젝트가 택하는 길이다. 마법은 없다: 촬영, 박스 그리기, QA, 학습.
계산은 공개 벤더 가격표(Basic.ai) 기준: 박스당 $0.03–$1.00, 단순 작업은 이미지당 $0.10–$0.50. 이미지당 4개 박스, $0.30/이미지라면 100,000장 = $30,000——QA는 별도다. 2회 통과 리뷰가 표준이고, 총비용 1.5–2배 승수가 보통이다.
2024년에 실제 건을 견적했다: 쿤산의 3PL 현장, 피킹 로봇, 2,000개 이상의 SKU, 촬영 80,000장. 벤더 견적: 박스당 $0.08, 이미지당 4개 박스——80,000 × 4 × 0.08 = $25,600(서류상). 프로젝트 관리와 약 15%의 재작업을 더하면 실제 지출은 $30,000을 넘었다.
가동 개시 6개월 후, 카톤 공급업체가 크라프트지에서 백색 코팅지로 바꿨다. 반사율이 바뀌고 인식률이 6포인트 떨어졌다. 추가로 20,000장——거의 $10,000의 추가 비용.
루트 1의 진실: 실제 데이터는 일회성 구매가 아니라 구독이다. 포장재·조명·계절이 바뀔 때마다 라벨링 라운드가 추가될 수 있다. 계약 하나에 사인하는 게 아니라, 상시 청구서에 사인하는 것이다.
장점도 진짜다: 충실도. 실제 데이터로 학습한 모델은 sim-to-real 격차가 가장 작다——학습 환경과 배포 환경이 같은 장소이기 때문이다.
루트 2: CAD 시뮬레이션 렌더링——도면이 있을 때 가장 저렴하다
정확한 3D CAD 모델이 있으면 일이 단순해진다: 시뮬레이션 도구가 가상 부품을 가상 빈에 떨어뜨리고, 수량·조명·텍스처·카메라 노이즈를 바꿔가며 수백 장의 이미지를 렌더링한다. 어노테이션은 무료다——엔진이 모든 부품의 위치를 안다.
2026년 5월 RoboticsTomorrow 기사가 정확히 짚었다: 정확한 CAD 모델이 있으면 이는 "가장 신뢰할 수 있고 자원을 가장 적게 쓰는 접근법"이다——엔지니어의 시간은 박스 그리기가 아니라 파라미터 조정에 쓰인다.
치명적 결함 두 가지. 첫째, 도면이 없으면 끝이다——레거시 부품, 공급업체 부품, 실물과의 괴리는 시뮬레이션에게 기댈 곳을 주지 않는다. 둘째, 렌더가 너무 깨끗하게 나온다: 실제 이미지에는 기름·스크래치·깜빡이는 조명이 있지만 렌더에는 없다. 너무 깨끗한 데이터로 학습한 모델은 현장에서 무너진다.
직관에 반하는 결론: CAD 시뮬레이션의 문제는 "충분히 리얼하지 않다"가 아니라 "진짜라고 믿기엔 너무 깔끔하다"는 것이다. 웨어하우스는 클린룸이 아니다. 모델이 두려워하는 것은 추함이 아니라, 본 적 없는 더러움이다.
루트 3: 생성 AI 합성 데이터——Zebra의 STRIPES가 실제로 풀고 있는 것
루트 3은 2026년 웨어하우스 AI 비전 모델 학습법에 대한 가장 뜨거운 답이다. 간판은 Zebra의 STRIPES 데이터셋(Sim-to-Real Industrial Perception for Warehouse Scenes), 2026년 9월 공개.
숫자는: 30,000장 이미지, 3,000종의 고유 박스 텍스처와 형상, 1,000,000개의 라벨링된 박스——사람이 그린 것은 하나도 없다.
STRIPES의 3가지 혁신은 정확히 루트 2의 약점을 찌른다: 정적 3D 모델 없는 생성 AI 이미지 생성으로 장면 다양성이 도면 라이브러리의 굴레를 벗어난다. 마모·손상 시뮬레이션——찌그러진 카톤, 찌그러짐, 표면 먼지, 스트레치 랩——가장 더러운 웨어하우스 상태이자 파이프라인에서 가장 가치 있는 단계. 그리고 물리 기반 적재로, 중력 시뮬레이션이 박스를 자연스럽게 밀집·기울어·맞물린 배치로 쌓는다. 세 가지 실제 단계를 가로질러: 선반 보관, 바닥 스테이징, 트럭 적재.
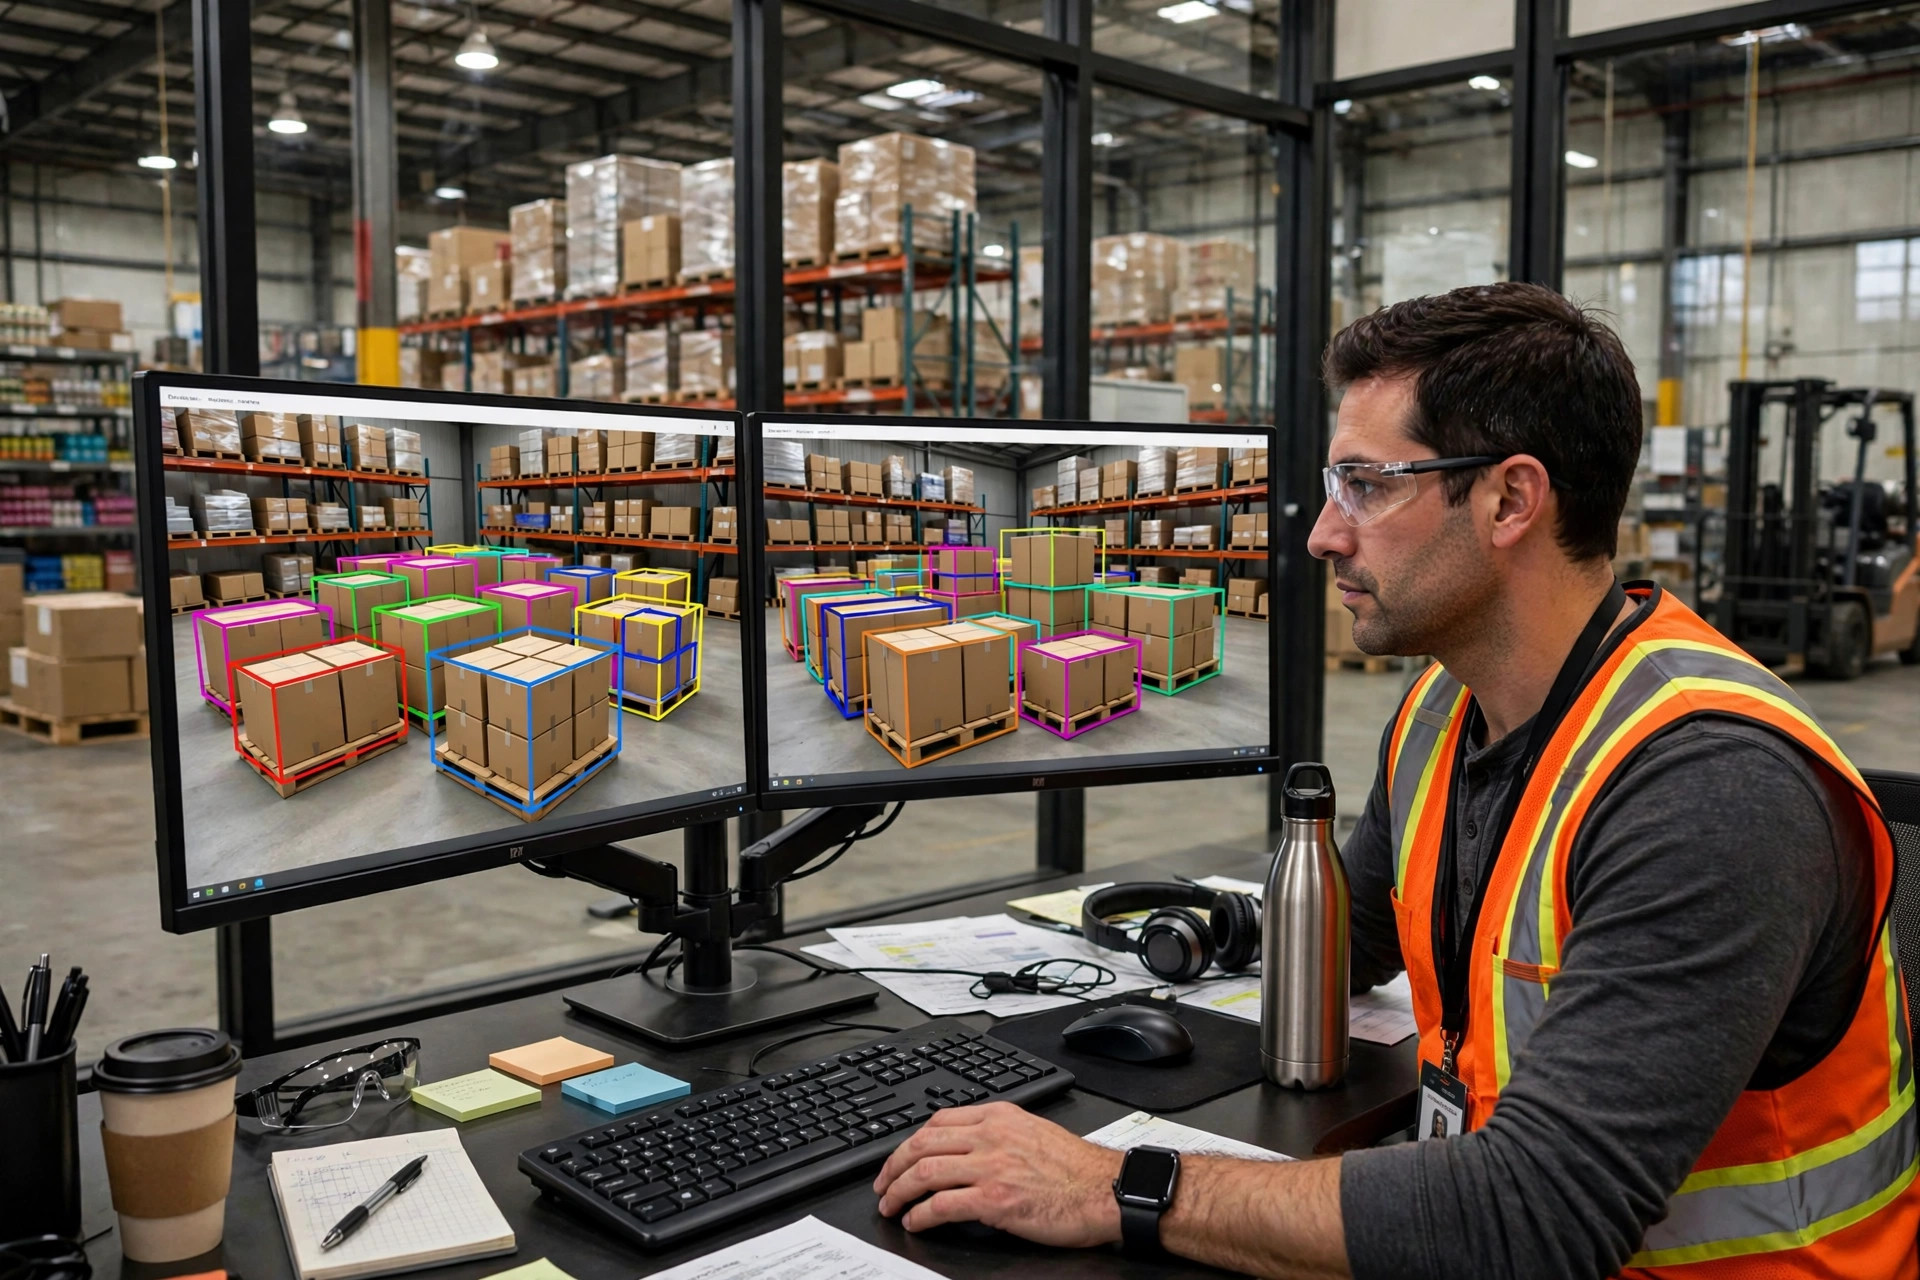
보이는가? STRIPES가 푸는 것은 "합성 데이터가 진짜처럼 보이는가"가 아니라 "충분히 더러운가"이다. 합성 데이터는 더 예뻐질 필요가 없다——더 더러워져야 한다. 시뮬레이션에서의 99는 아무 의미가 없다. 중요한 것은 모델이 거기서 몇 종류의 더러움을 봤느냐다.
비용에 대해: 30,000장 이미지와 백만 개 박스, 한계비용은 노동이 아니라 연산이다. 하지만 루트 3은 셋 중 가장 큰 고정 투자를 요구한다——생성 모델, 물리 시뮬레이션, 파이프라인 엔지니어링, 모두 선불이다. 작은 프로젝트는 입장료를 감당할 수 없다. 규모가 커지면 저렴해진다.
Sim-to-Real 격차: 연구실에서는 99, 현장에서는 92
sim-to-real 격차: 학습 환경과 배포 환경의 차이다. 2026년 5월, Robotics and Automation News는 이를 메우는 것을 "현대 로보틱스에서 가장 가치 높은 목표 중 하나"라고 불렀다.
얼마나 잔인한가? 2026년 9월: Telexistence가 NVIDIA의 DreamZero——행동과 카메라 영상을 함께 예측하는 모델——를 편의점 진열 보충용으로 파인튜닝했다. 깨끗한 시뮬레이션 피킹 데이터: 성공률 45%. 실제 텔레오퍼레이션 기록: 0%. 근본 원인: 시뮬레이션과 현실 사이의 결합 분포와 상태 스케일의 불일치.
45%에서 0%는 "조금 빗나갔다"가 아니다——다른 우주다. 격차는 이미지 수가 아니다. 분포가 일치하느냐다.
2026년 4월 TELUS Digital의 Steve Nemzer가 잘 말했다: 특정 격차를 메우는 데 합성 데이터를 쓰되, 학습의 토대는 실제 데이터에 두어라——센서 아티팩트나 생산 현장의 적대적 조건은 합성 데이터로 가르칠 수 없다.
내 번역: 합성 데이터는 패치지 토대가 아니다. 토대는 실제 데이터 그대로다. 패치는 촬영할 수도, 기다릴 여유도 없는 롱테일을 덮는다.
그 롱테일에 대해: 이 사이트의 2026년 10월 7일 글——"촬영할 수 없는 이상 샘플"——은 실전 패칭 매뉴얼이다. 이 글은 청구서가 붙은 3루트 파노라마다.
세 가지 루트, 하나의 표
| 루트 1: 실제 + 사람 라벨링 | 루트 2: CAD 시뮬레이션 | 루트 3: 생성 합성 | |
|---|---|---|---|
| 한계비용/이미지 | $0.10–$0.50(공개 벤더 요금) | 렌더 연산, 사람보다 훨씬 저렴 | 생성 연산, 사람보다 훨씬 저렴 |
| 고정 투자 | 낮음(주로 촬영 인건비) | 중간(파이프라인 + 엔지니어 조정) | 높음(생성 모델 + 물리 시뮬 + 파이프라인) |
| 100K 이미지 규모 청구 | $10K–$50K, QA 승수 1.5–2배 | 도면이 있으면 최저, 고정비 상각 | 규모가 크면 최저가, 소규모는 손익분기 불가 |
| 충실도 | 최고, 격차 최소 | 중간——"너무 깨끗함"을 두려워함 | 중상——STRIPES가 "더러움"을 고치는 중 |
| 치명적 결함 | 롱테일을 잡을 수 없음. SKU/환경 변화 때마다 재라벨링——비용은 구독 | 도면 없으면 죽음 | 선불이 무거움, 소규모에서는 비경제적 |
두 가지 더, 직관에 반하는 결론:
첫째, 데이터 라벨링 산업은 자신이 학습시키는 모델에게 잡아먹히고 있다. AI 사전 어노테이션 + 사람 리뷰가 이제 벤더의 표준 플레이북이다. 순수 수작업 박스 그리기는 끝나가고 있고, 단가는 계속 떨어진다. 지금 순수 수작업 대형 장기 계약을 맺는다는 것은 고점 매수를 의미할 가능성이 높다.
둘째, 가장 비싼 데이터는 라벨링 요금이 아니다——잡을 수 없는 데이터다. 롱테일 이상 샘플의 한계비용은 무한대에 수렴한다: 3개월 기다리면 "지게차가 팔레트를 박살냈다"의 표준 사진은 영원히 얻지 못한다. 합성 데이터의 진짜 가격 결정력은 저렴함이 아니라, 살 수 없음이다.
Lao Zhou의 결론: "웨어하우스 AI 비전 모델의 학습법"은 산수 문제다
어떤 루트인가? 감이 아니라 계산이다. 루트 1 총합 ≈ N × p × q(N: 필요한 이미지 수, p: 이미지당 견적, 공개 범위 $0.10–$0.50, q: QA 승수, 1.5–2). 루트 3 총합 ≈ F + N × m(F: 파이프라인 고정 투자, m: 이미지당 한계비용, p보다 훨씬 작음). 손익분기점 N* = F ÷ (p × q − m): N*를 넘으면 합성이 이긴다.
계산 예시(예시 입력——자신의 견적을 대입하라): F = $30,000, p = $0.30/이미지, q = 1.5, m ≈ $0.05/이미지. N* = 30,000 ÷ (0.45 − 0.05) = 75,000장.
결론: 약 75,000장을 넘으면——혹은 빠른 SKU 회전과 바뀌는 환경이 N을 계속 밀어올리면——합성 루트가 본전을 뽑는다. 아니면 사람 라벨링에 머물러라. "더 첨단"에 추가 요금을 내지 마라.
그 돈이 잘 쓰였는지는 식이 결정한다.
Lao Zhou, 물류 비용 분석가 지음
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.