이번에는 엣지 편이다——단, 조건이 있다. AI를 두 종류로 나눠야 한다. "길을 지켜보는" AI와 "운세를 읽는" AI다.
길을 지켜보는 쪽은 1밀리초도 기다릴 수 없다. 운세를 읽는 쪽은 1시간이 걸려도 아무도 죽지 않는다. 그 선이 바로 엣지와 클라우드가 갈라지는 지점이다. 지난 2년간 나는 양쪽에서 창고가 돈을 태우는 것을 봤다. 모든 것을 클라우드로 밀어넣고, 네트워크가 잠깐만 흔들려도 분류 라인 전체가 멈추는 것을 지켜보는 창고. 아니면 하루에 한 번만 돌리면 되는 리포트용 모델을 돌리려고 첫날부터 GPU 서버를 사들이는 창고.
추론을 어디에 배포할지는 서로 충돌하는 세 가지 요소로 귀결된다. 지연 시간, 대역폭, 비용이다. 유스케이스가 가장 민감한 요소가 추론이 있어야 할 자리를 정한다.
밀리초 단위로 측정되는 것은 전부 엣지의 몫
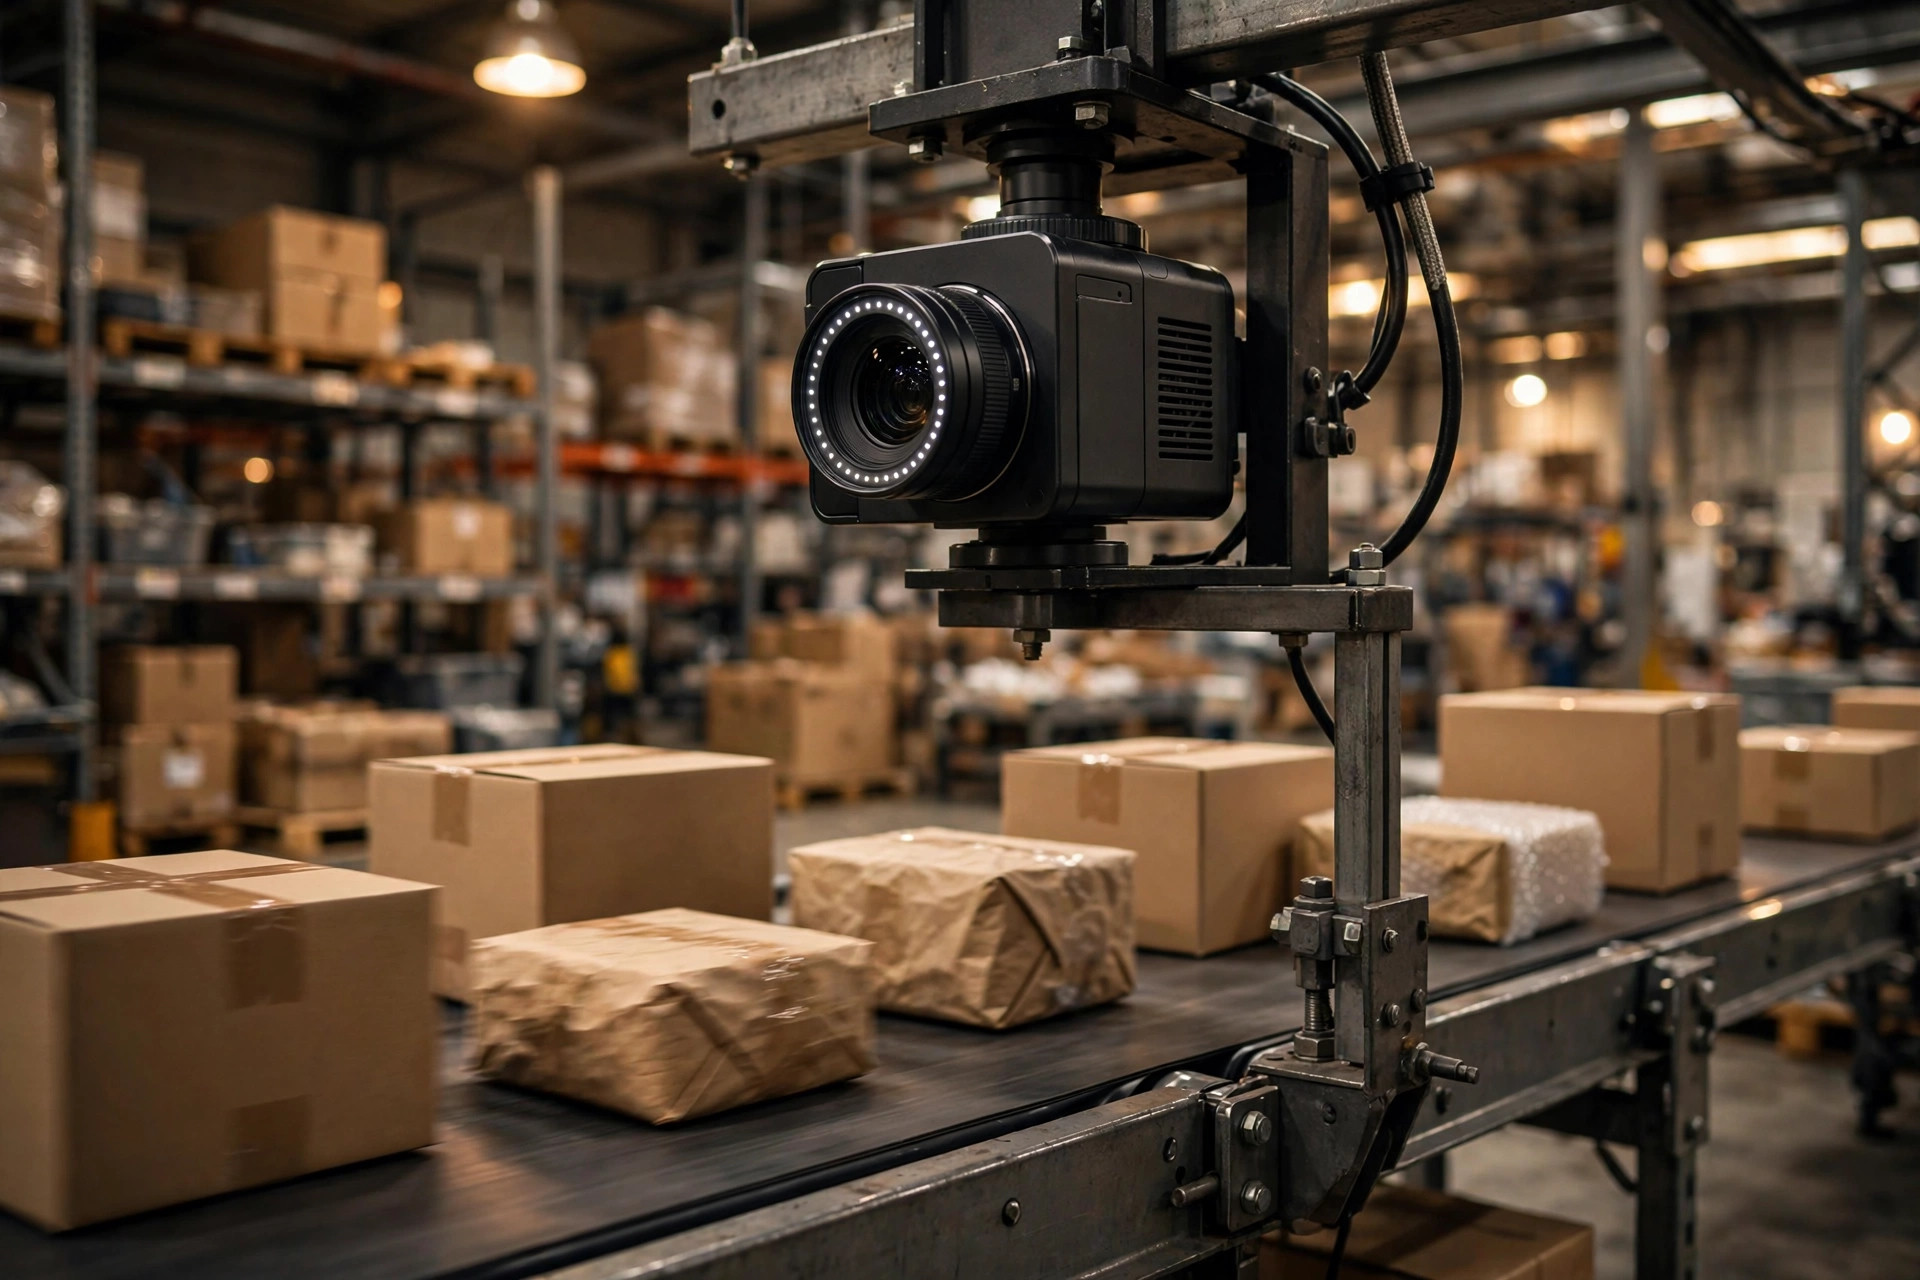
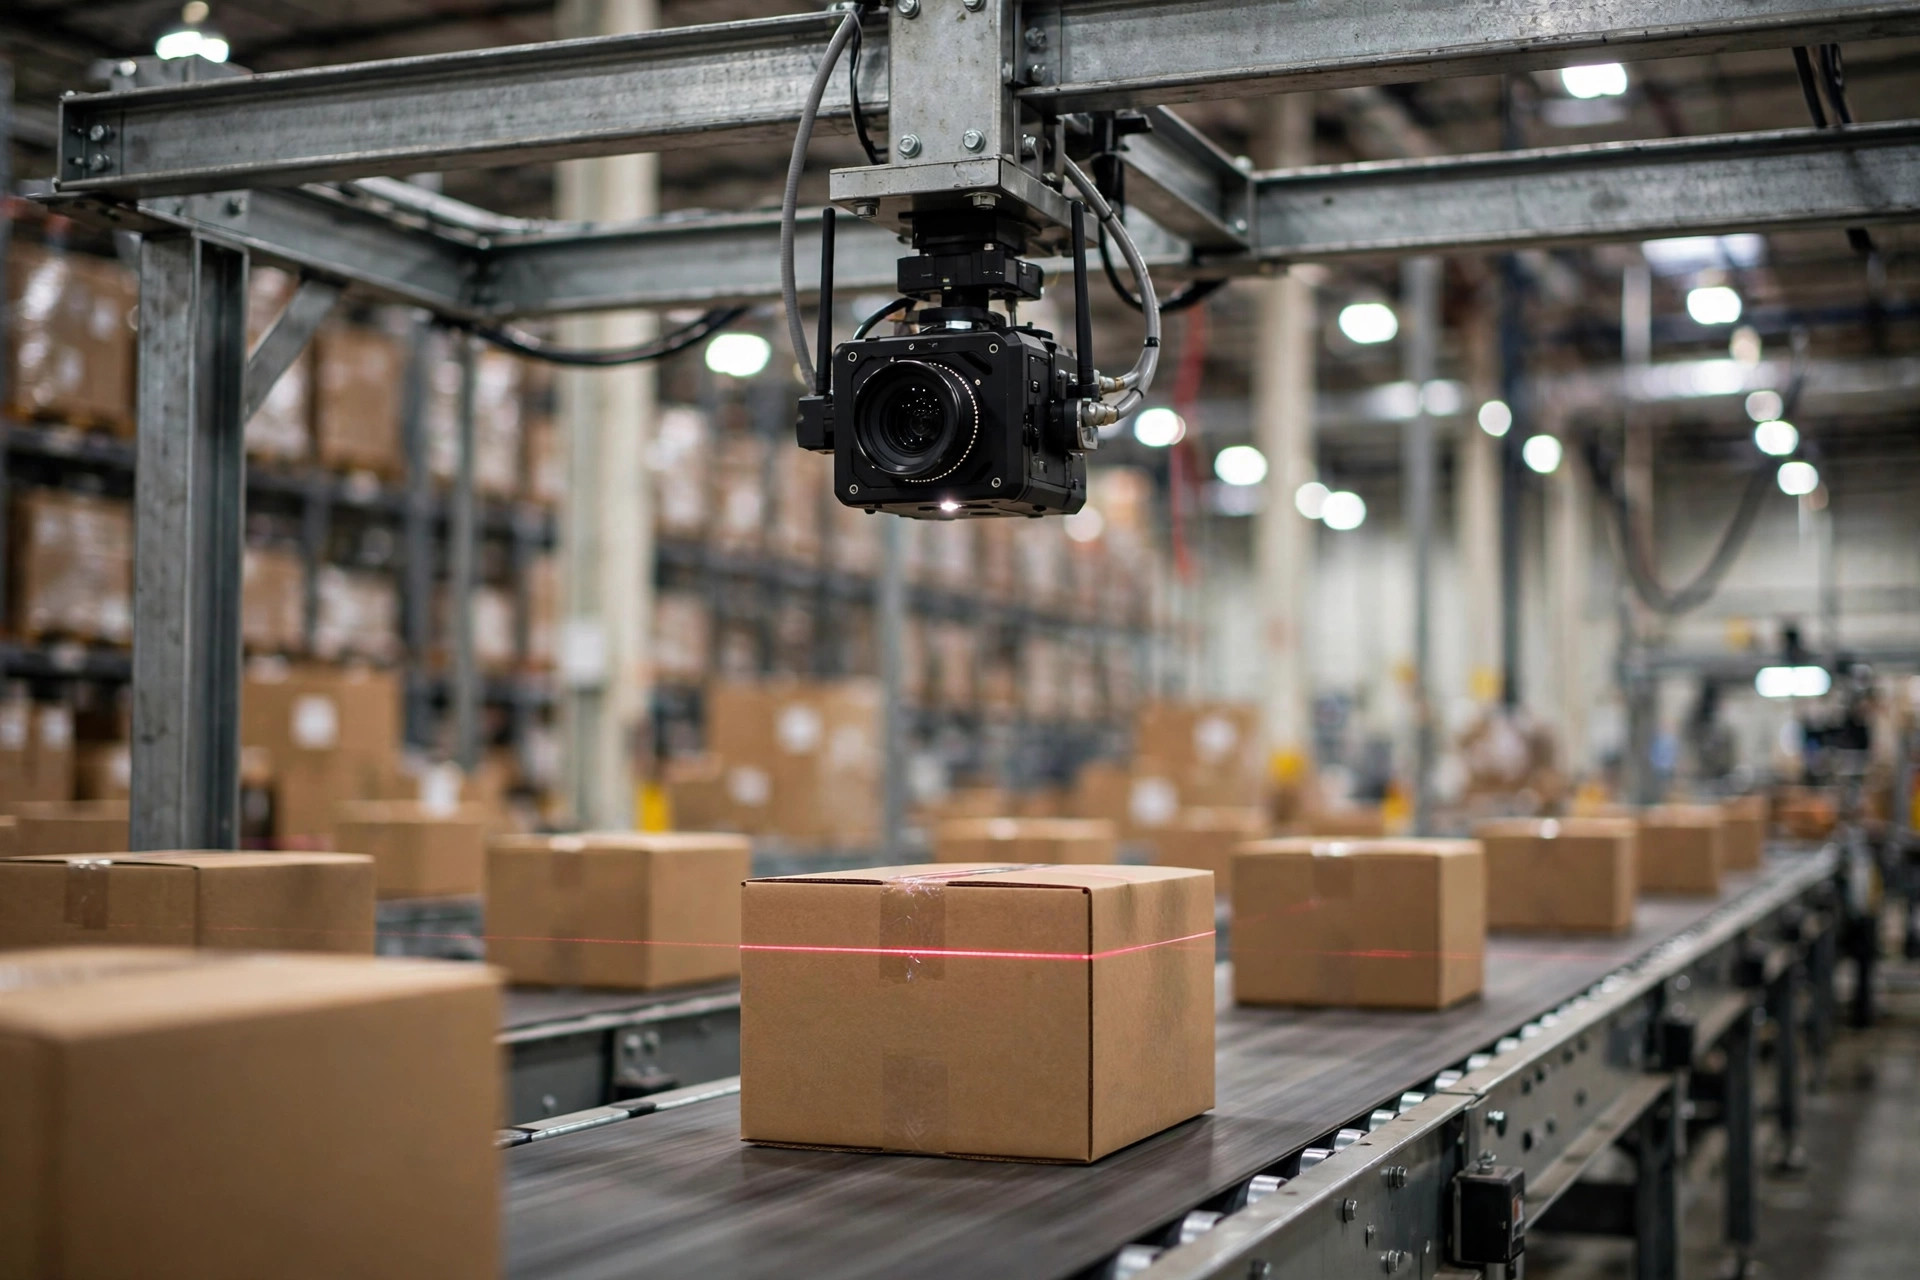
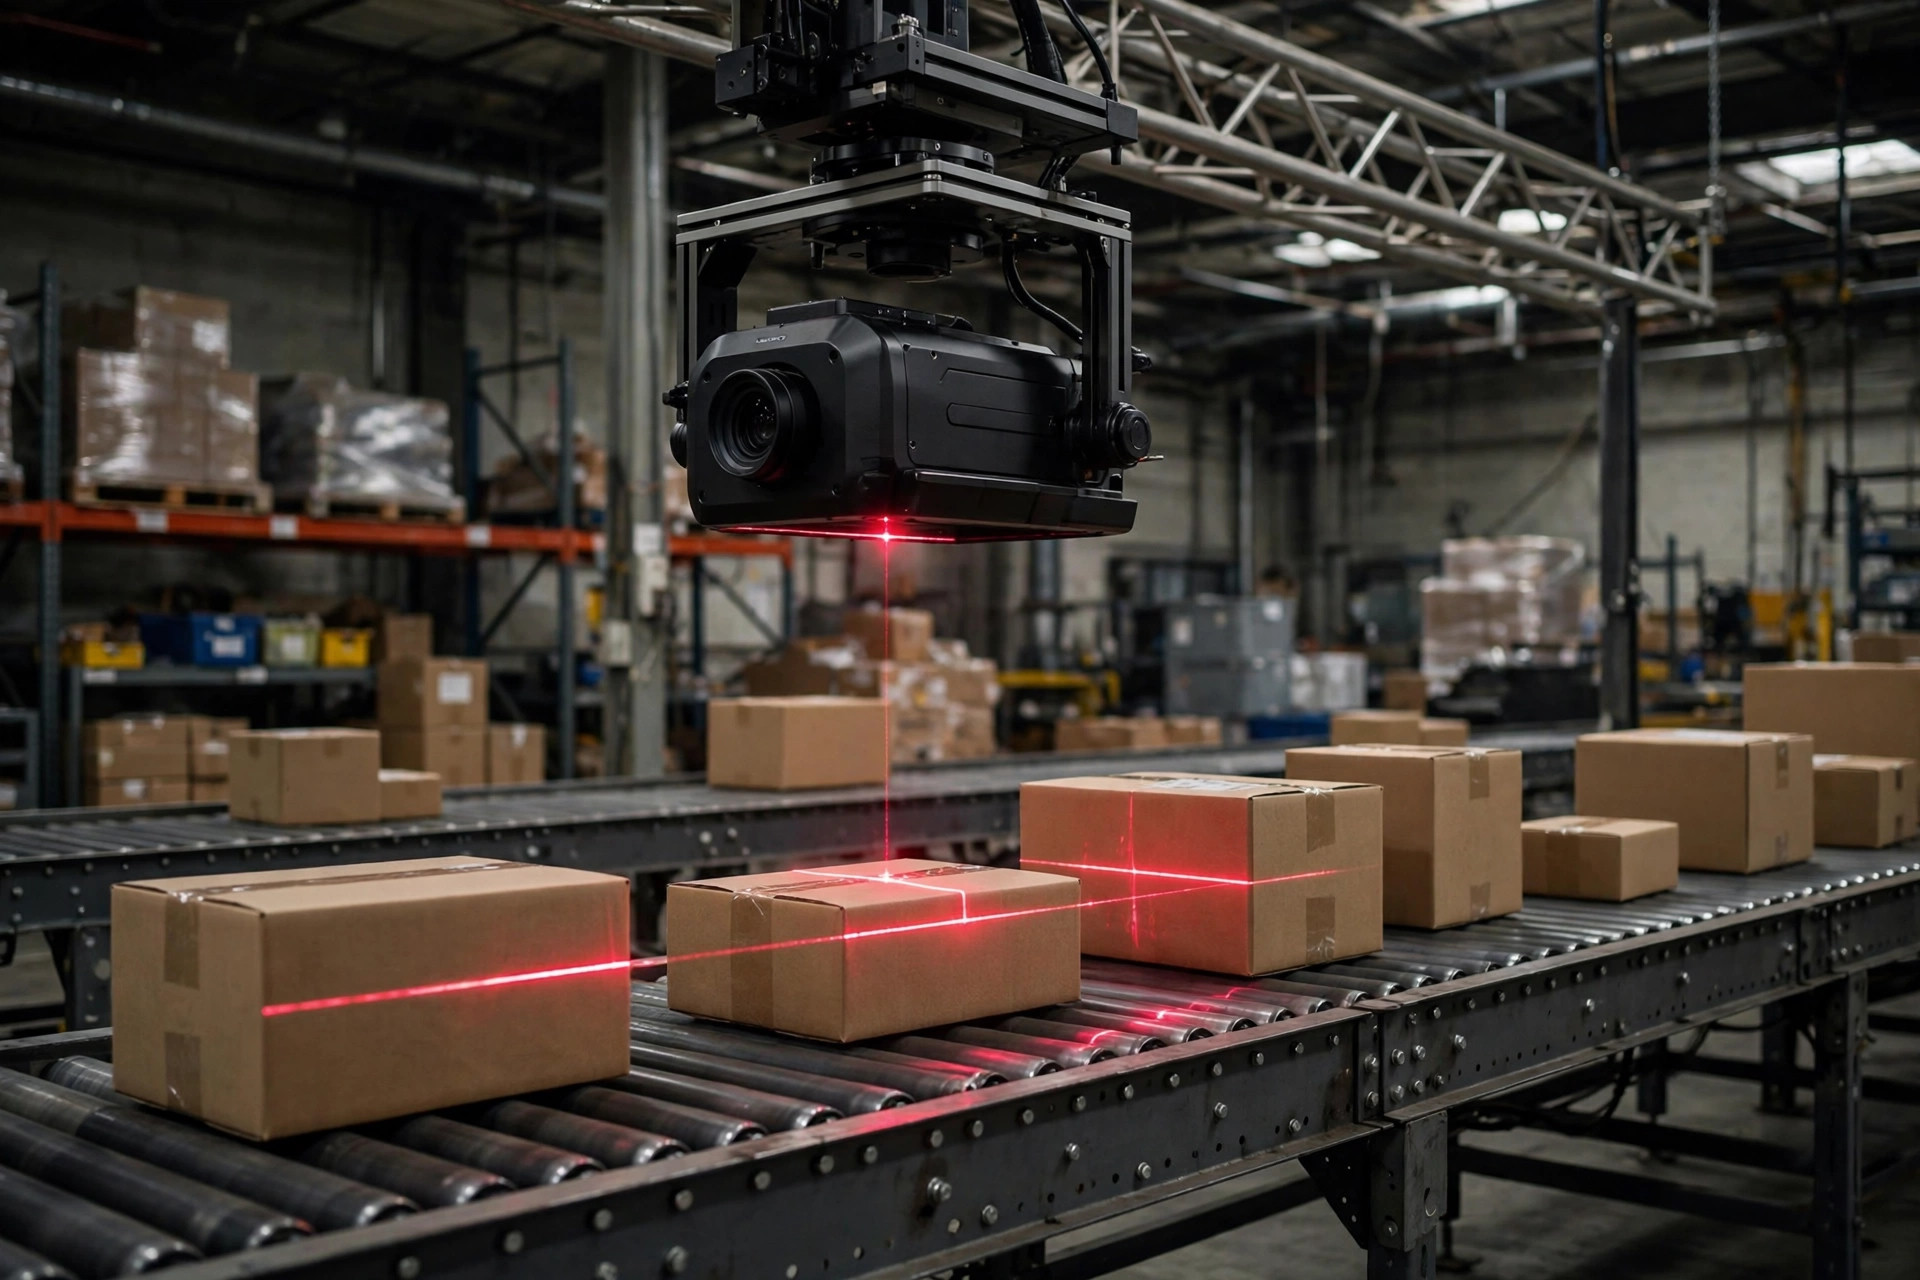
길의 파수꾼부터 시작하자. 비전 검사, AMR 장애물 회피, 로봇 피크앤플레이스. 공통점은 밀리초 단위로 측정되는 폐루프다. 분류 라인은 분당 백 개가 훨씬 넘는 소포를 움직인다. 카메라 시야에 상자가 들어오는 건 눈 깜짝할 사이이고, 인식 결과는 수십 밀리초 안에 돌아와야 한다. 클라우드 왕복은 쉽게 수백 밀리초가 걸린다——답이 도착할 때쯤 상자는 분기점을 지나쳐 있고, 푸셔 암은 조준할 대상이 없다.
다음은 대역폭 청구서다. 원본 이미지를 24시간 스트리밍하는 비전 카메라 한 대만 하루 수십 기가바이트를 만들어낸다. 몇 개 스테이션을 곱하면 월간 업링크 비용은 반올림 오차가 아니다. 그리고 창고 네트워크는 사무실 네트워크와 전혀 다르다. Wi-Fi 데드존, 철제 랙에 막히는 신호, 일상적으로 케이블을 씹어 끊는 지게차. 이 사슬에 실시간 추론을 거는 것은 라인 가동률을 운에 맡기는 것이다.
반대 사례를 작년에 캘리포니아 온타리오(Ontario, California)의 3PL에서 봤다. 그곳의 바코드 카메라는 클라우드에서 인식을 돌렸다. 어느 오후 네트워크가 흔들리자 라인 전체가 수동 재스캔으로 떨어졌다. 유지보수를 위한 액세스 포인트 교체가 전부였다——겨우 4시간 만에 처리량이 거의 3분의 1로 떨어졌다. 사장은 나중에 완전한 진지함으로 말했다. 서버에서 아낀 달러는 전부 초과근무 수당으로 사라졌다고.
AMR 장애물 회피는 더 극단적이다. 차량이 움직이는데 사람이 앞에 튀어나온다. 라이다와 비전을 융합한 추론이 로컬에서 완료되고 수십 밀리초 안에 제동 명령을 내려야 한다. 그 판단이 클라우드를 기다린다면 차량은 이미 사람을 지나쳤을 것이다. 진지한 AMR 벤더가 모두 회피 모델을 온보드로 돌리는 이유다——기술 선호가 아니라 물리다.
이 카테고리의 규칙은 한 줄이다. 추론 결과가 물리적 동작을 직접 구동하면 엣지에서 돈다. 그리고 "네트워크가 죽어도 라인은 멈추지 않는다"를 인수 조건에 넣는다.
기다릴 수 있는 것은 클라우드가 더 싸다
다른 카테고리는 운세 읽기다. 수요 예측, 보충 제안, 안전재고 계산, 월간 운영 리포트. 이런 모델은 한 번 돌리면 답이 하루나 일주일 유효하다——몇 분의 지연은 아무것도 바꾸지 않는다. 여기서 클라우드의 진짜 이점은 저렴한 컴퓨팅이 아니다. 컴퓨팅을 소유할 필요가 없다는 것이다. 살 기계도 없고, 관리할 열도 없고, 죽은 박스 때문에 새벽 2시에 전화 받을 일도 없다.
클라우드의 두 번째 이점은 학습이다. 학습은 이력 데이터를 먹어치우고, 창고 이력은 이미 클라우드에 있다. WMS 데이터베이스, 주문 이력, 노무 기록. 거기서 학습하고 반복하는 것이 자연스럽다. 엣지 디바이스의 임무는 딱 하나다. 학습된 모델을 다운로드해 추론을 실행하고, 일정에 따라 클라우드에서 새 버전을 받아오는 것.
현장에서 작동하는 것을 내가 봐 온 하이브리드 아키텍처——중소 창고라면 누구에게나 초기 템플릿으로 건네주고 싶은——는 이렇다. 엣지는 로컬 캐시와 함께 실시간 추론을 수행해 네트워크가 끊겨도 독립적으로 돌아간다. 클라우드는 학습, 모델 배포, 전체 분석을 맡는다. 역할 분담을 문서로 적어두고 어느 쪽도 상대방 일을 가져가지 못하게 한다. 모델 업데이트는 단계적으로 출시한다. 먼저 한 스테이션에 새 버전, 깨끗하게 일주일 동작한 뒤 전체 플릿으로. "원클릭 전 창고 업그레이드"는 절대 하지 마라——깨지면 창고 전체가 함께 깨진다.
그리고 인수 테스트는 물리적으로 하라. 가동일에 네트워크 케이블을 뽑고 무슨 일이 일어나는지 지켜봐라. 라인이 멈춘다면 그 아키텍처는 장식이다. 벤더의 슬라이드가 아무리 예뻐도.
소규모 창고: GPU 서버는 건너뛰고 산업용 PC로 시작하라
이제 돈 얘기다. 사람들은 "AI 추론"이라고 들으면 수만 달러짜리 GPU 서버 랙을 떠올린다. 인기 없는 말을 하겠다. 소규모 창고 10곳 중 9곳은 그게 필요 없다.
비전 검사 스테이션 한 대는 NVIDIA Jetson Orin Nano 급 엣지 디바이스에서 여유롭게 돈다——2023년에 나온 8GB 버전, 소비 전력 수십 와트, 전기 캐비닛 안에 들어간다. 몇 천 달러대의 GPU 탑재 산업용 PC 한 대면 두세 개 스테이션을 감당한다. 거기서 시작하라. 한두 개 스테이션에서 ROI를 증명하라——수동 재검사의 미스율을 낮추든, 분류 라인의 감속 정지를 없애든. 계산이 맞으면 그때 스테이션 확장을 얘기하고, 그 다음에 서버를 얘기하라.
자꾸 놓치는 환경적 세부 사항이 있다. 먼지와 열이다. 창고는 여름에 고온이 되고 먼지는 어디든 들어간다. 그런 환경에 소비자용 하드웨어를 던져 넣으면 피크 시즌을 못 버틴다. 엣지 하드웨어를 고를 때는 넓은 동작 온도 범위, 팬리스 설계, 방진 성능이 필수 요건이다——연산 스펙만 보고 쇼핑하지 마라. 산업용 PC로 시작하라고 권하는 또 다른 이유가 이것이다. 정확히 이런 환경을 위해 만들어졌기 때문이다.
그럼 GPU 서버는 진짜 누구의 것인가. 수십 개 스테이션을 동시에 돌리는 오퍼레이션, 아니면 자체 모델을 학습시키는 팀이다. 창고가 아직 거기까지 못 갔다면 사는 것은 기계실 전기료를 내는 것이고——벤더의 영업 커미션을 대주는 것이다.
내 결론은 명쾌하다. 먼저 유스케이스를 길의 파수꾼과 운세 읽기로 나눠라——전자는 엣지, 후자는 클라우드. 하드웨어는 산업용 PC 한 대로 시작해 한 스테이션을 증명한 뒤 확장하라. 다음에 AI 벤더가 영업하러 오면 세 가지를 물어봐라. 추론은 어디서 도는가, 네트워크가 죽으면 라인은 멈추는가, 모델은 얼마나 자주 업데이트되는가. 이 세 가지에 답하지 못하면 제안서는 닫아도 된다.
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.