먼저 결론부터: 3D 박스 패킹 소프트웨어는 출하에서 실제로 돈을 절약해 준다. 하지만 내가 일한 프로젝트 10건 중 8건은 알고리즘 때문에 망한 것이 아니었다. 치수 데이터가 완전히 틀렸기 때문에 망했다. 먼저 마스터 데이터를 정리하라. 알고리즘이 똑똑할수록 쓰레기 데이터 위에 만드는 혼란은 더 커진다.
왜 굳이 할까? 출하는 창고가 조용히 돈을 흘리는 곳이다. 카톤은 하나씩 사고, 운임은 팔레트 단위와 부피 단위로 산다. 주문당 카톤 하나 더, 반쯤 빈 팔레트 하나가 문밖으로 나가는 현금이다. 박스 패킹 최적화는 두 가지를 직접 겨냥한다.
먼저 돈부터 보여주겠다. 2023년의 실제 프로젝트다. 로스앤젤레스 외곽의 3PL, 자동차 부품을 출하했다. 하루 60팔레트, 팔레트 활용률 72%. 박스 패킹 최적화 후 활용률은 84%에 도달했다. 계산: 유효 부피 = 60 × 0.72 = 43.2 "만재 팔레트 환산". 이후 하루 실제 출하 팔레트 수 = 43.2 ÷ 0.84 ≈ 51.4. 하루 8.6팔레트 감소 × 250근무일 = 연간 2,150팔레트. 근거리 배송 기준 팔레트당 약 $95이면 연간 약 $204,000의 운임 절감이다. 카톤 규격도 12종에서 7종으로 줄여 포장비로 연간 $60,000-plus를 더 절약했다. 첫 해 프로젝트 총비용 — 소프트웨어 구독, 연동, 데이터 정리 — 은 $150,000 미만이었다. ROI 계산은 직접 해 보시라.
3D 박스 패킹이 실제로 계산하는 것
한 문단으로 요약하면: 3D 박스 패킹은 NP-hard다. SKU 수가 늘어나면 무차별 대입으로는 우주의 열적 죽음까지 걸린다. 시장에서 쓸 만한 제품은 모두 휴리스틱으로 돌아간다. 상자를 부피와 무게 순으로 정렬한 뒤 가장 큰 빈 공간부터 탐욕적으로 채우는 방식이다. 이른바 AI 버전이 더하는 것은 정확히 두 가지뿐이다. 과거 주문에서 함께 출하되는 경향이 있는 SKU를 학습해 미리 묶는 것, 그리고 사업 제약 — 파손되기 쉬운 물건은 하중을 받지 않음, 무거운 것은 아래에, 콜드체인 분리 — 을 흡수하는 것이다. 이론은 그게 전부다. 나머지는 모두 엔지니어링이다.
무엇에든 서명하기 전에 입력 데이터를 바로잡아라. 다음 중 하나라도 빠진 채로 프로젝트를 시작하지 마라. SKU별로 실측한 길이, 너비, 높이, 무게(실측이지, 구매팀이 수년 전에 입력한 값이 아니다), 파손 주의, 압축 금지, 뒤집기 금지 같은 제약 플래그, 그리고 주문 프로파일(대부분 풀케이스인지, 대부분 낱개 피킹인지). 세 가지가 없으면 알고리즘은 쓰레기를 조각하고 있는 셈이다.
세 가지 선택: 암묵지 vs 규칙 엔진 vs AI
| 차원 | 암묵지 | 규칙 엔진 | AI 최적화 |
|---|---|---|---|
| 적재율 | 베테랑의 기분에 따라 60–75% | 75–82%, 안정적 | 82–90%, 데이터와 함께 개선 |
| 도입 비용 | 제로 | 중간, 규칙 설정 2–4주 | 높음, 데이터 정리 최소 2–3개월 |
| 유지보수 | 사람과 함께 문밖으로 나간다 | 규칙끼리 싸우기 시작한다 | 모델은 지속적인 공급이 필요하다 |
| 적합한 경우 | 하루 200건 미만 주문 | 규칙적인 SKU를 가진 중형 물류센터 | 하루 1,000건 이상, 10,000 SKU 이상 |
| 치명적 결함 | 변동성이 크고 재현 불가 | 불규칙 품목에서 막힌다 | 쓰레기가 들어가면 쓰레기가 나온다 |
이 표를 활용하는 법: 하루 200건 미만이면 베테랑 포장 담당자 몇 명과 엄격한 규칙 몇 개로 버텨라. AI를 사지 마라. ROI가 맞지 않는다. 듣기 싫어하는 사람이 많다. 그래도 사실이다.
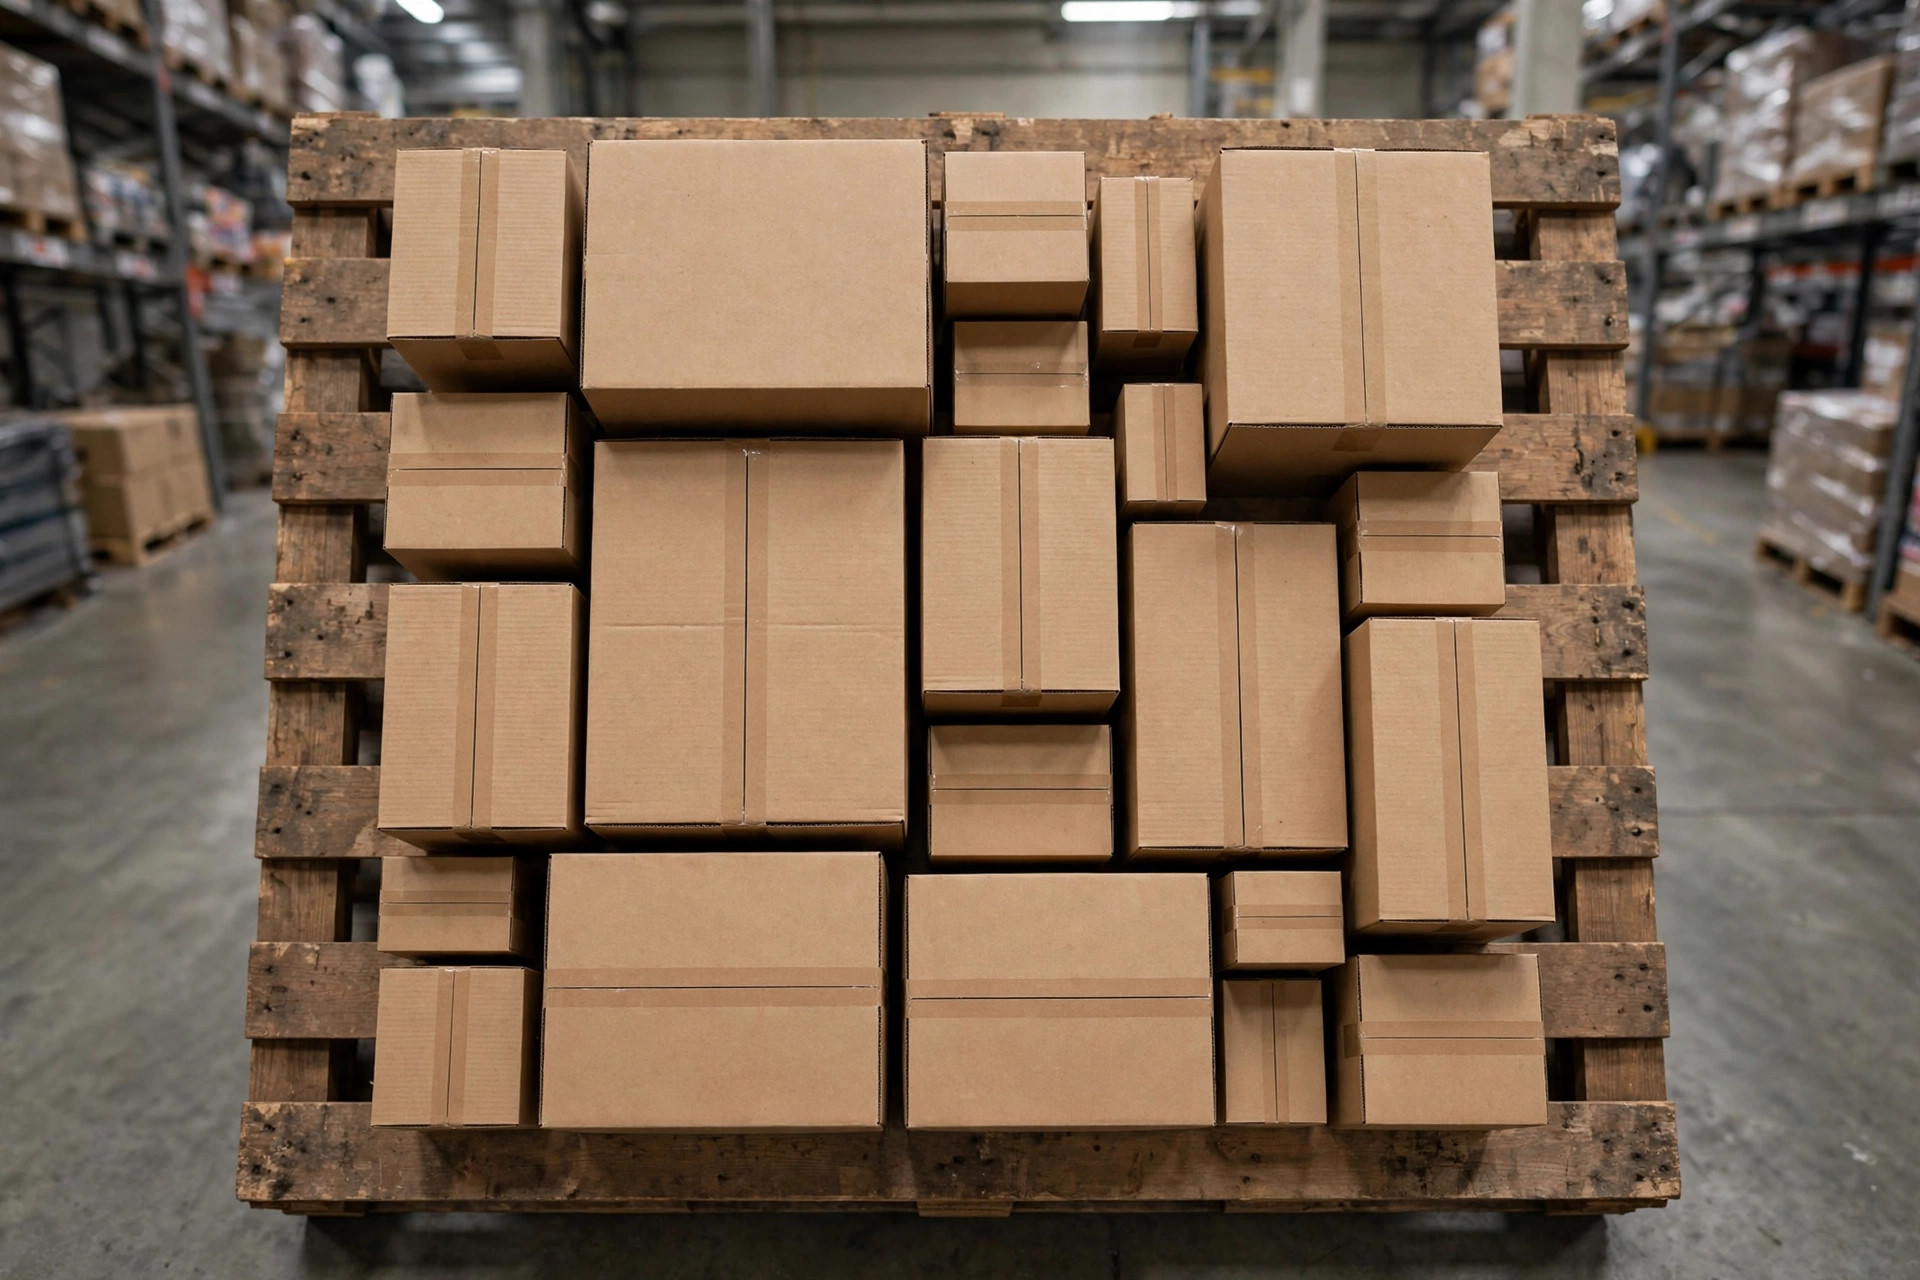
박스 패킹 가동 전야 체크리스트: 다섯 단계
- 먼저 치수 마스터 데이터를 고쳐라. 상위 500개 SKU를 실측하라 — 길이, 너비, 높이, 무게 — 시스템의 모든 불일치를 바로잡아라. 최소 10%는 샘플링하라. 이 단계를 건너뛰면 이후의 모든 것은 연극이다.
- 사업 제약을 돌에 새겨라. 파손되기 쉬운 물건은 하중을 받지 않고, 액체는 절대 뒤집지 않으며, 무거운 것은 가벼운 것 아래에 — 알고리즘은 이것을 "학습"할 수 없다. 사람이 먼저 엔진 설정에서 엄격한 규칙으로 선언해야 한다.
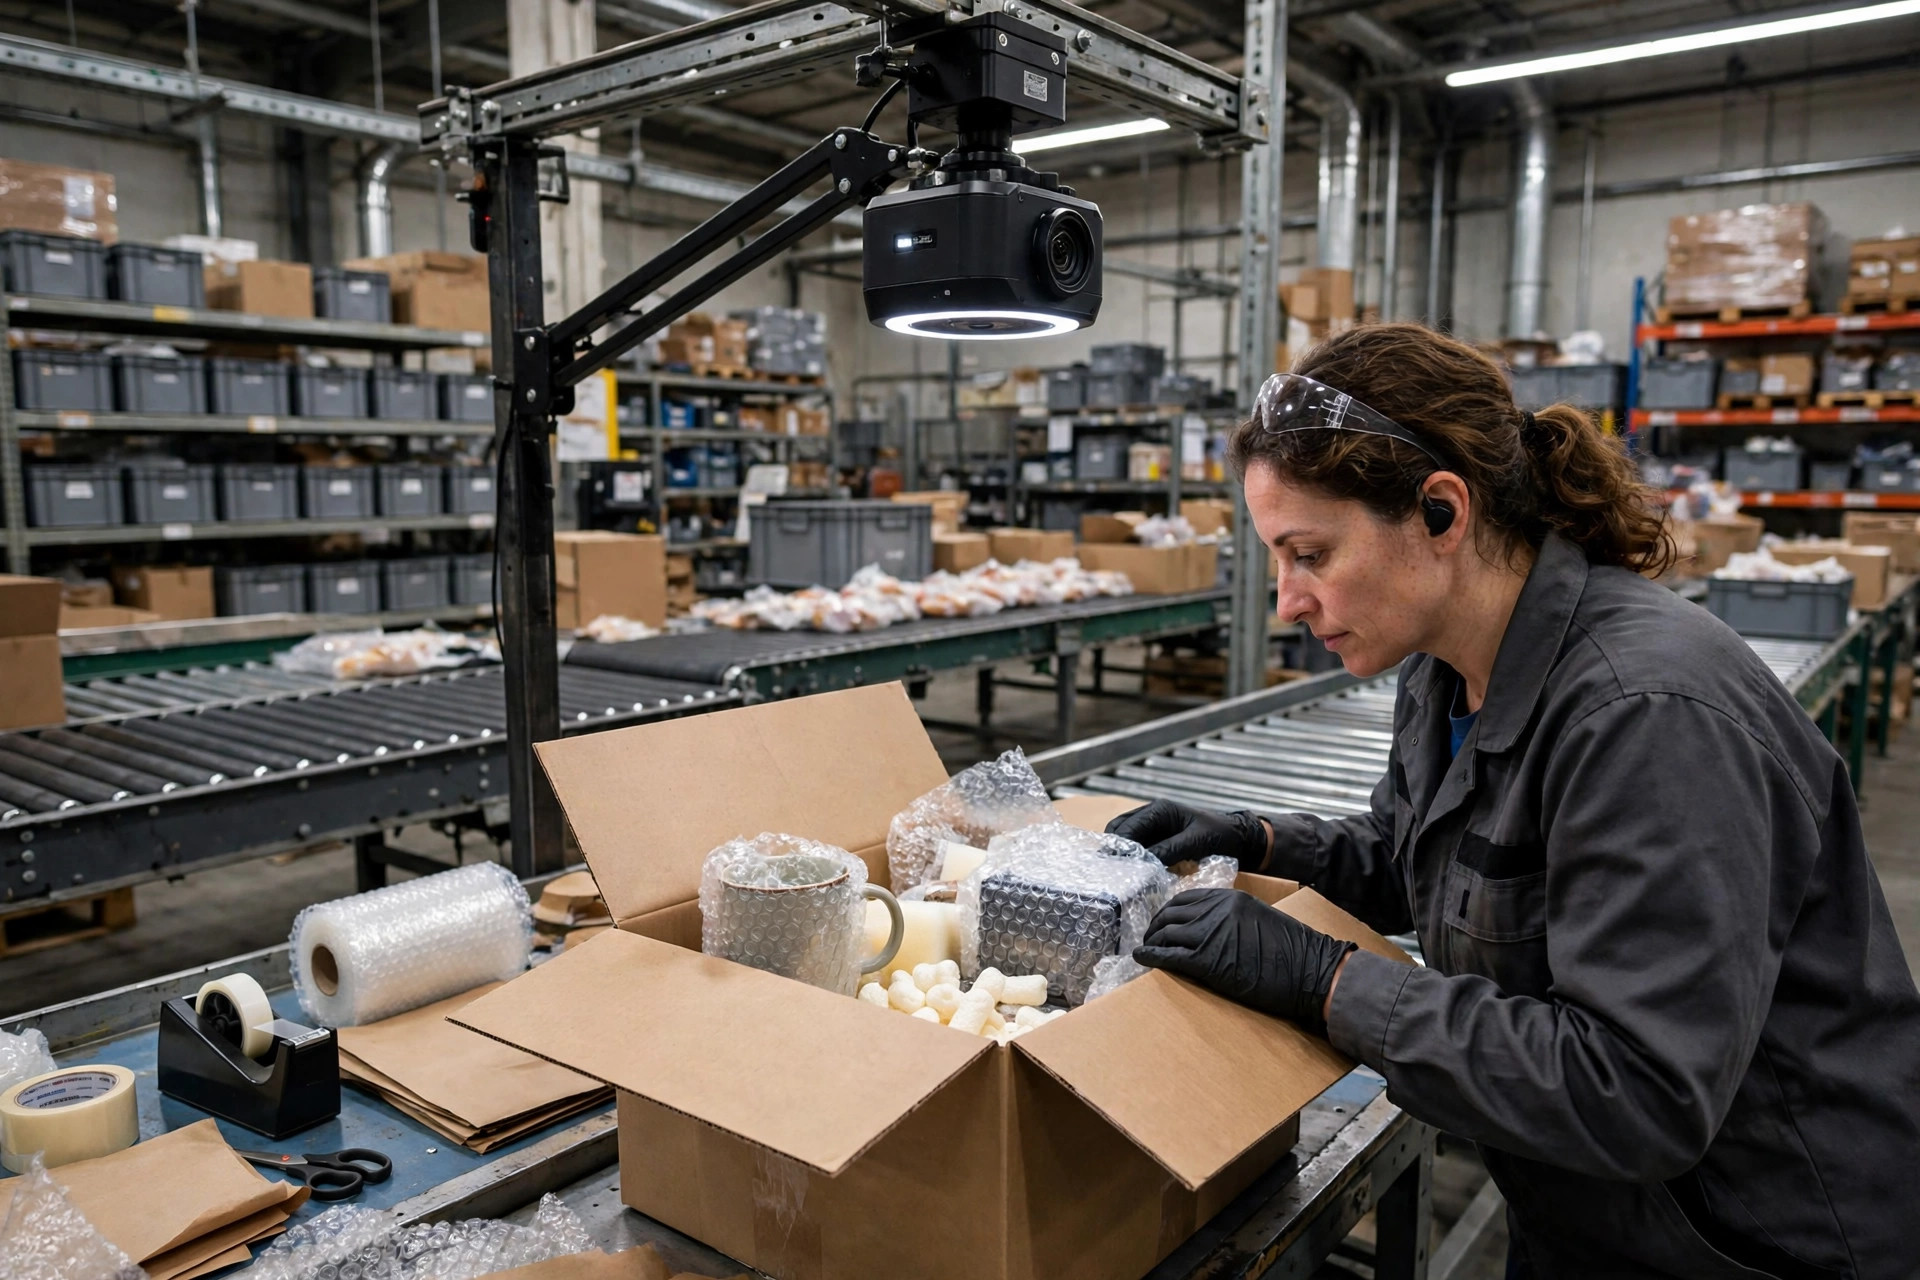
- 연동 지점을 골라라. 표준 체인: WMS가 웨이브를 릴리스한다 → 주문 라인(SKU + 수량)을 패킹 엔진에 보낸다 → 엔진이 계획(카톤 수, 각 카톤의 내용물, 패킹 순서, 팔레트 구성)을 반환한다 → 패킹 스테이션 화면에 3D 도면이 표시되고 패킹 리스트가 인쇄된다. API 지연 시간은 2초 미만으로 유지하라. 3초를 넘기면 포장 담당자는 화면을 보지 않는다.
- 한 제품 카테고리로 파일럿하라. 첫날부터 창고 전체로 가지 마라. 치수적으로 가장 지루한 제품 라인을 골라 4주간 돌리고 세 가지 숫자를 지켜봐라. 적재율, 파손율, 주문당 패킹 시간. 세 가지가 모두 양호할 때만 확장하라.
- 사람의 검토로 루프를 닫아라. 처음 2주간 주문을 표본 검사하라. 실제 패킹을 알고리즘 계획과 사진으로 대조하고 불일치를 제약에 되먹여라. 이 루프가 없으면 모델은 3개월 안에 성능이 떨어진다.
세 가지 실패 모드 — 이 실패를 나는 세 번 봤다
실패 하나: 그날 구매팀에 있던 사람이 입력한 치수. 알고리즘은 30×20×15 cm를 가정하고 계획하는데, 실물은 32×22×18이다. 현장에서 맞지 않는다. 포장 담당자들은 3일 동안 욕을 하다가 4일째에는 감으로 포장하는 방식으로 돌아갔고, 시스템은 완전히 우회되었다. 해결책은 위의 1단계다. 다른 해결책은 없다.
실패 둘: 불규칙 품목. 2024년 시카고의 가정용품 e-tailer — 램프와 타워형 선풍기가 부피의 30%를 차지했다. 알고리즘은 모든 것을 최소 경계 상자로 취급하므로, 종이 위에서 "절약"된 공간은 순전한 허구였다. 이런 창고는 먼저 불규칙 품목을 자체 패킹 라인으로 분리해야 한다. 가동 후에가 아니라 선정 시점에 받아들여라.
실패 셋: 포장 담당자가 화면을 신뢰하지 않는다. 3D 도면이 아무리 아름다워도 베테랑은 힐끗 보고 "나는 10년 동안 이렇게 포장해 왔다"고 말한다. 이에 대한 기술적 해결책은 없다. 파일럿 기간에 정면 대결을 시켜라. 주문의 절반은 알고리즘으로, 절반은 경험으로, 파손율과 카톤 수를 테이블 위에 올려놓고. 베테랑은 저절로 조용해진다.
이제 직관에 반하는 부분: 더 가득 찰수록 좋은 것이 아니다. 95%까지 채운 카톤은 장거리 운송에서 파손율이 더 높게 나타난다. 완충 여지가 남지 않아 급제동 한 번에 모든 것이 찌그러진다. 알고리즘은 공간을 최적화할 뿐 "누가 누구 위에 앉는지"를 최적화하지 않으므로, 파손 제약을 손으로 설정하고 85–90% 적재를 목표로 하라. 마지막 5%는 현실의 몫이다.
한 가지 트레이드오프를 솔직히 말하자면: 비용은 실제다. 마스터 데이터 정리 최소 2개월, 연동 개발 4–6주, 재교육과 습관 변화 1개월, 효과는 보통 6개월쯤에 보인다. 상사가 다음 달에 결과를 기대한다면 프로젝트를 시작하지 마라. 하지만 베테랑의 눈대중으로 하루 1,000건 이상의 주문을 출하하고 있다면, 기다리는 매달 수만 달러가 손가락 사이로 새고 있는 셈이다.
마무리 한 마디: 알고리즘을 논하기 전에 줄자부터 제대로 대라. 그렇지 않으면 아름다운 실수를 최적화하고 있을 뿐이다.
Lin Xiao, WMS 구현 컨설턴트 지음
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.