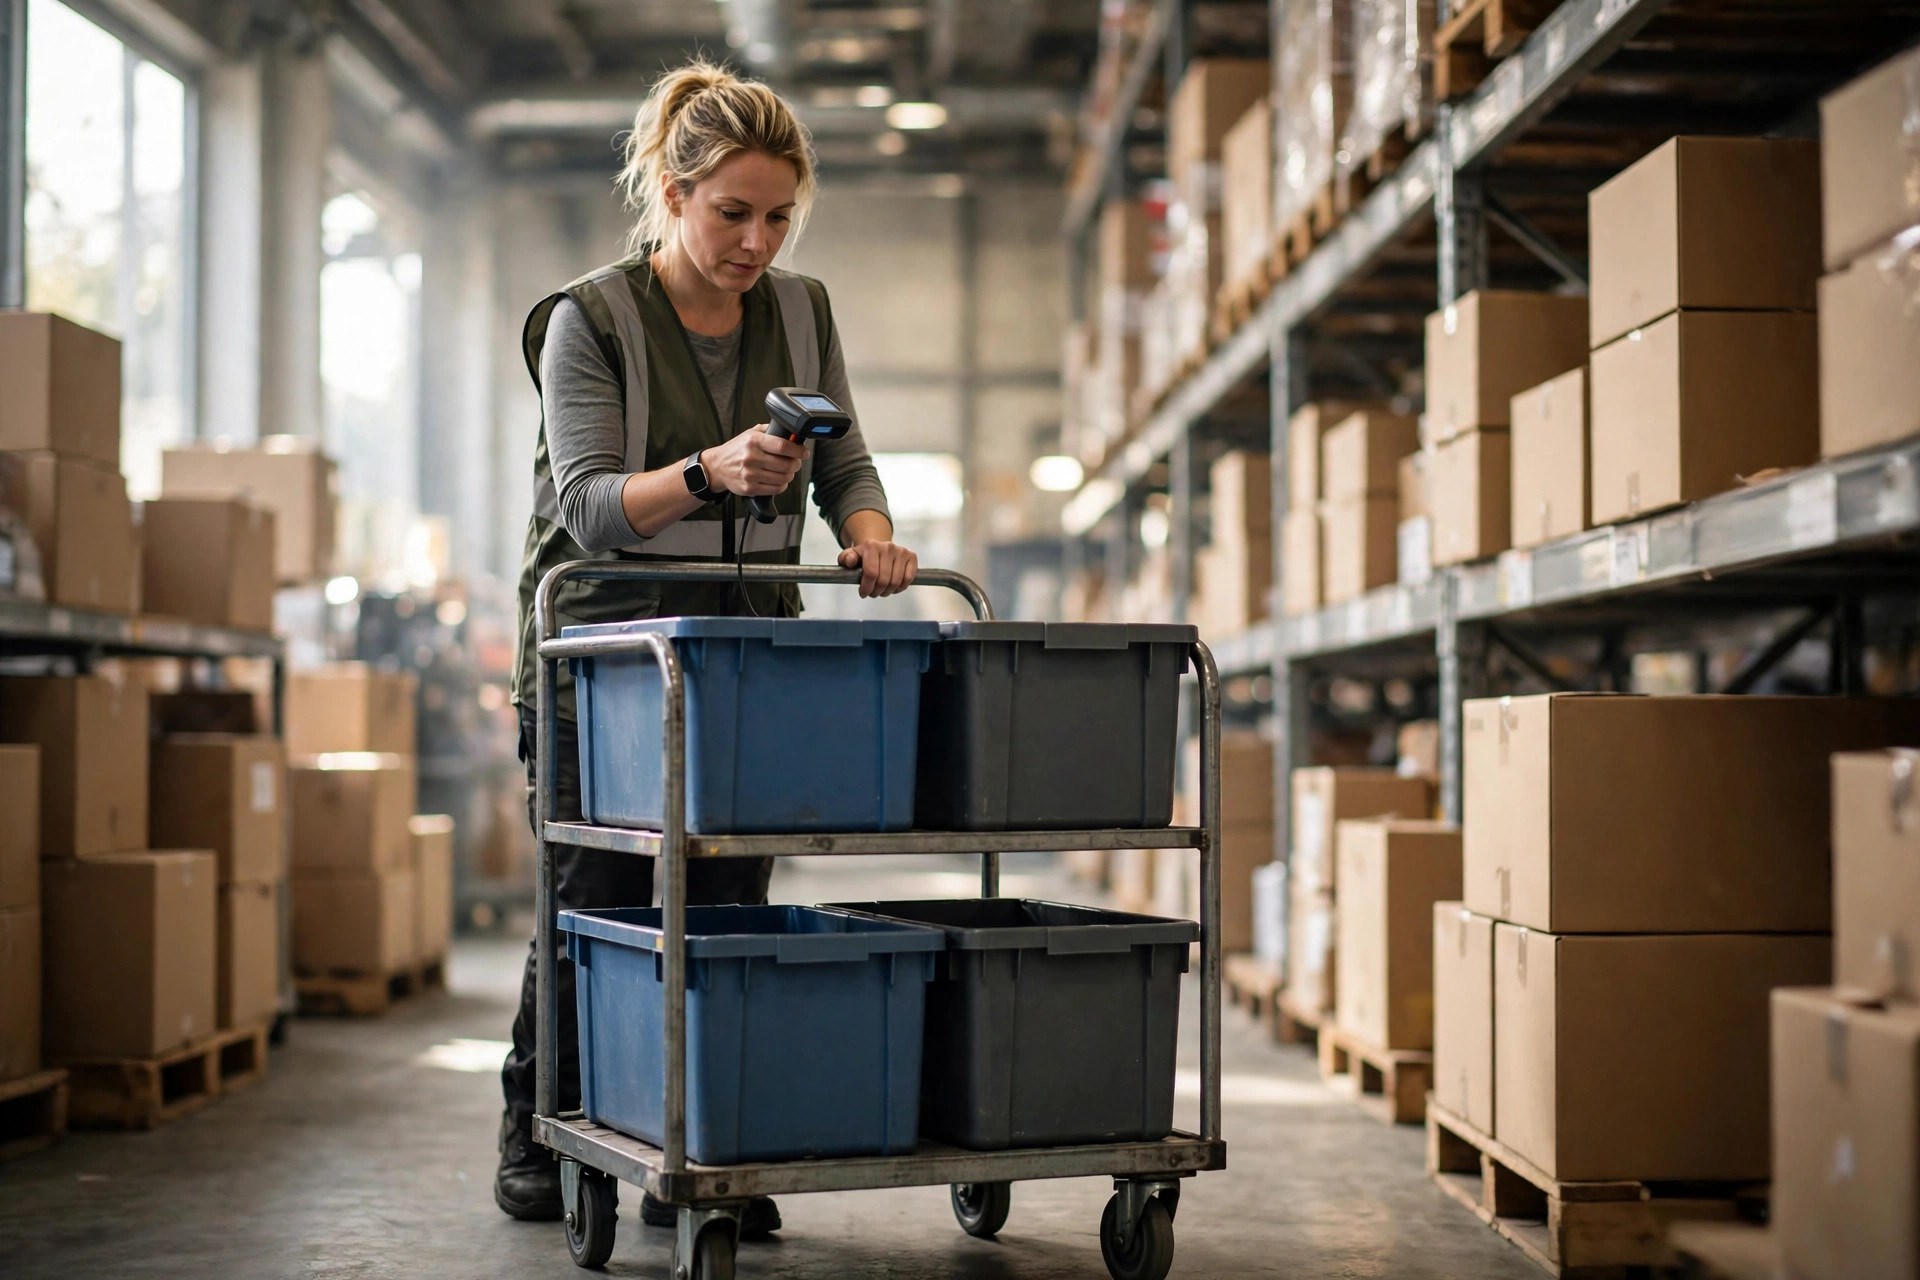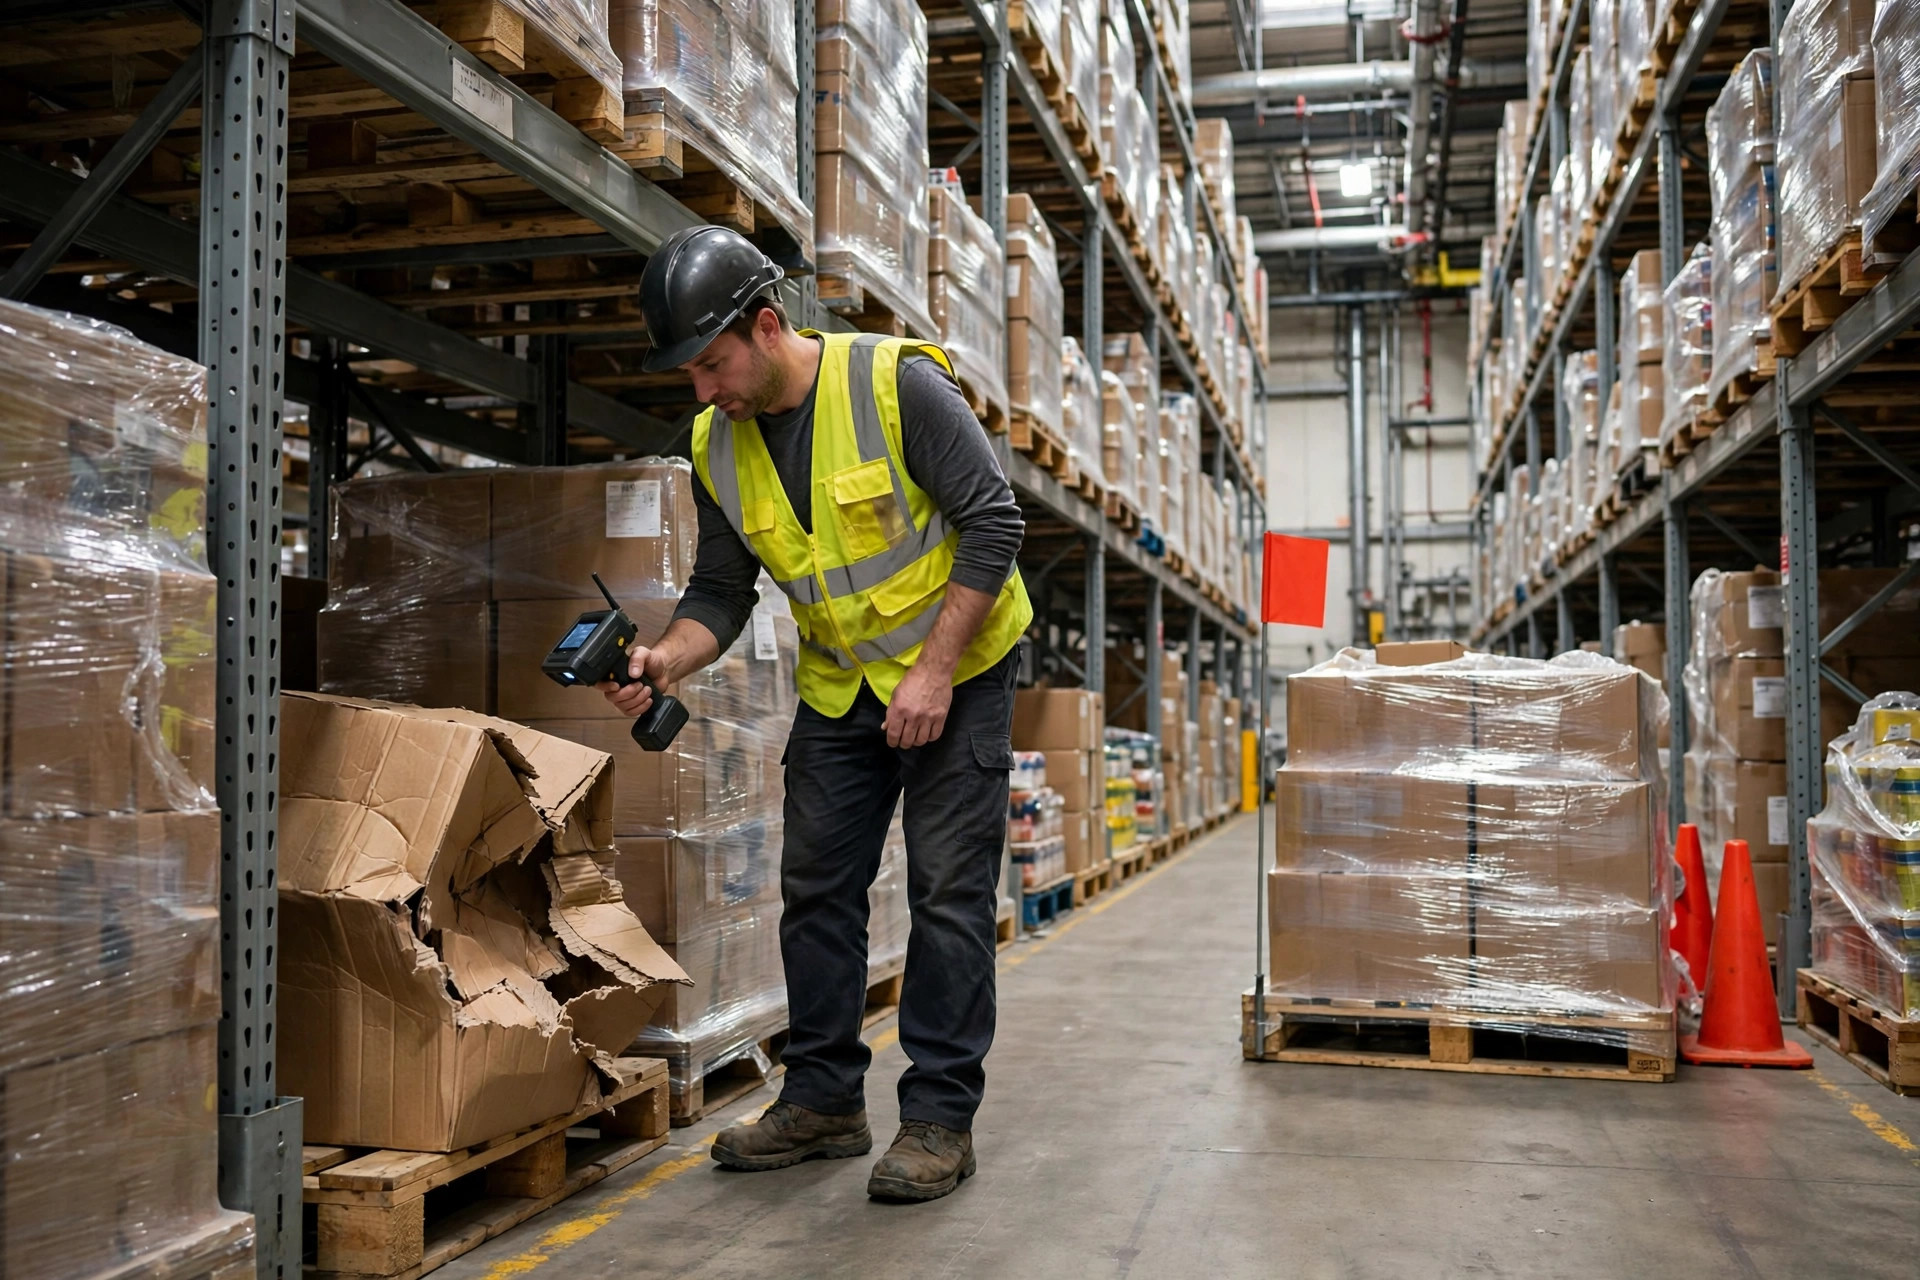
2024年3月のある水曜日の朝、私はカリフォルニア州オンタリオにある120,000平方フィートの3PL倉庫に立ち、新規導入されたWESがピーク日の最初のウェーブを処理する様子を見ていた。ピッカーがカートを押して通路C-07を進み、あるロケーションの前で止まり、RFスキャナーをじっと見つめた。タスクは12個の指示。ロケーションには7個しかなく、ラベルもそこにあるものと一致していなかった。彼は「ショートピック」と入力し、タスクをシステムに返した。
ここまでは普通のことだった。問題はその後だ。
システムは「親切心」から、そのタスクをウェーブプールにそのまま戻した。20分後、別のピッカーが同じタスクを受け取り、同じロケーションまで歩いて行き、同じ壁にぶつかった。正午までには、そのタスクは3~4人のピッカーの間を行ったり来たりし、毎回ショートピックとなり、ウェーブの統合完了ランプは一向に緑にならなかった。出荷バッチ全体がドックで待機し、外では運送会社のトラックがクラクションを鳴らしていた——すべて、誰も見つけられないたった1個のユニットのせいだった。
倉庫マネージャーは私の隣にドックに立って、忘れられないことを言った。「このシステムに大金をかけたのに、こいつが一番得意なのは、解決できない問題を送り返すことだよ。」
ほとんどの倉庫は、WESを通じてタスクを振り分けるのはうまくやる。真の分かれ目は、タスクがうまくいかなかった後に何が起きるかだ——システムがそれをどう捉え、戻し、再割り当てし、ループを閉じるか。この記事はまさにその話、例外タスクの再投入(リフロー)の仕組みについてだ。
タスクはウェーブに戻った。それからどうする?
まずは例外を種類別に分けることから始めよう。20年で、同じ5つのパターンを何度も見てきた。ショートピック(在庫不足)、ストックアウト(何もない)、損傷または品質フラグ付きユニット、スキャンの不一致(ラベル違い、ロケーション違い)、QCリリース待ちの品質保留だ。このステップは些細に見えるが、多くの倉庫がここで死ぬ——理由コードを30個も設定し、急ぐピッカーは一番上のものをタップして、後のレポートはすべてゴミになる。
再投入の経路は3つに絞る。それ以上は要らない。
一つ目、ウェーブプールに戻す。これは、別のピッカーや別のタイミングで解決できる例外に合う——たとえば、補充がすでに進行中のショートピックだ。ただし回数に上限を設けること。オンタリオの現場では、同じタスクが午前中だけで4回も再投入された。私のルール:3回再投入したら、そのタスクは自動的にマニュアルタスクに切り替わる。設定にこだわりすぎるな。統合できないウェーブの方がよほど高いコストだ。
二つ目、マニュアルタスクに変換する。これは人の判断が必要な例外用——損傷、品質保留だ。重要なポイント:「マニュアル」が「誰も見ないキューのゴミ箱」を意味してはいけない。チームにルーティングする——損傷はQCへ、ロケーションの不一致は監査チームへ——そしてRF上で見える状態に保つ。システムの奥に埋め込まない。
三つ目、保留(サスペンド)。これは一時的に解決不能なもの用——たとえばサプライヤーの確認待ちのロット問題——だが、ウェーブをブロックさせるわけにもいかない。保留は削除ではない。明確な復活条件と最大保留時間が必要で、期限が来たら自動的にエスカレーションされる。
トレードオフは現実だ。ウェーブへの再投入は一番安いが、「熱いポテト回し」のリスクがある。マニュアルタスクは最も確実だが、マニュアルキューは増え続ける。保留は一番すっきりするが、忘れられやすい。私のアプローチ:例外の理由ごとにデフォルト経路を事前に設定し、ピッカーは理由コードを選ぶだけで、システムがルールに従ってルーティングする。判断はルールに任せ、現場の足仕事は人に任せる。
手つかずのまま放置できるのは、どこまでが「本当の問題」か?
再投入は第一歩にすぎない。真のブラックホールは、誰も見ないままシステムに滞留する例外だ。
私はエスカレーションを2段階にすることを推奨する——5段階ではない。5つも誰も覚えない。第一段階:例外が作成されてから30分経っても誰も引き取らなければ、シフトリーダーにエスカレーション——RFのポップアップ+リーダー端末のアラートだ。第二段階:例外がウェーブの統合をブロックしていて、他のタスクがそれを待っている場合、15分でエスカレーション、そのままスーパーバイザーへ。
ここで大事なのは、ポップアップと端末アラートと言った点だ。メールではない。これには痛い目を見た。ある倉庫には見事なエスカレーションルールがあったが、タイムアウトのたびにスーパーバイザーへメールを送るものだった。スーパーバイザーは1日に40通以上のシステムメールを受け取り、とっくの昔に自動アーカイブのルールを作っていた。損傷したカートンは例外ケージに3日間放置され、顧客が不足のクレームを出すまで気づかれなかった。エスカレーションとは、誰かの注意を奪うことだ。メールでは奪えない。だからもっとうるさい手段が必要だ。
ここにもトレードオフがある。閾値をきつくしすぎるとアラーム疲労だ——リーダーは麻痺する。緩すぎると例外は静かに期限切れする。私のやり方:最初の2か月はきつめに始めて、実際の問題をあぶり出す。そして安定したら緩める。もう一つ:例外を誰がいつ承認・引き取ったか記録すること。これがないと、ポストモーテムはスコアボードなしの責任の押し付け合いになる。
この例外データを全部記録した。それで何を見るの?
多くの倉庫はWES例外データを山ほど記録しながら、レポートを開くと「ショートピック312件」——技術的には正しいが、まったく役に立たない。データを記録しろ、ただし正しいものを記録しろ。
例外ごとに最低8つのフィールドを記録する。タスク番号、SKU、ロケーション、理由コード、タイムスタンプ、担当者、再投入回数、最終処理結果だ。理由コードは8~10個に抑える。それ以上は誰も丁寧に選ばない。少なすぎるとポストモーテムに何も出てこない。私の定番セット:ショートピック、ストックアウト、損傷、ラベル不一致、ロケーション混同、品質保留、機器故障、その他。「その他」が15%を超えたら、コードのリストが不完全だ——コードを追加せよ。
レビューには3つの数字で十分だ。20枚のスライドはいらない。
一つ目、再投入を繰り返す上位5 SKU。ショートピックを繰り返すSKUは、ほぼ例外なくスロッティングか補充の問題で、ピッカーの問題ではない。オンタリオの現場では、あの「熱いポテト」SKUは安全在庫が1日の平均ピック量を下回っていたことが判明した。補充が一度も追いつかなかった。
二つ目、未解決のままタイムアウトする例外の割合——トレンドを見ろ。上昇していたら、マニュアル対応のキャパシティが例外の量に追いついていない。人を増やすか、プロセスを直せ。
三つ目、理由コードの構成比の変化。「ラベル不一致」がひと月で2倍になったら、ラベルサプライヤーが変わったか、新人研修が抜けた可能性が高い。データは症状であり、原因はプロセスだ。
WESの本番稼働や見直しの際に照らすチェックリストだ。理由コードは10個を超えていないか。再投入の上限はあるか。ウェーブをブロックする例外には独自のエスカレーションタイマーがあるか。エスカレーションはメールだけに頼っていないか。保留タスクには最大年齢と復活条件があるか。レポートで再投入上位5 SKUを引けるか。全部クリアできれば、例外の再投入は基本的に盤石だ。
あの水曜日に戻ろう。オンタリオの倉庫は後に再投入の上限を3回にし、4回目は自動的にマニュアル監査タスクに切り替えるようにした——そしてこの種の問題は2か月で急激に減った。でも最後に、あなたに問いを残そう。先月のあなたの倉庫の例外データを引いてみてくれ——2回以上再投入されたタスクの割合は?その数字すら引けないなら、再投入の設計がどんなに洗練されていても、飾りにすぎない。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。