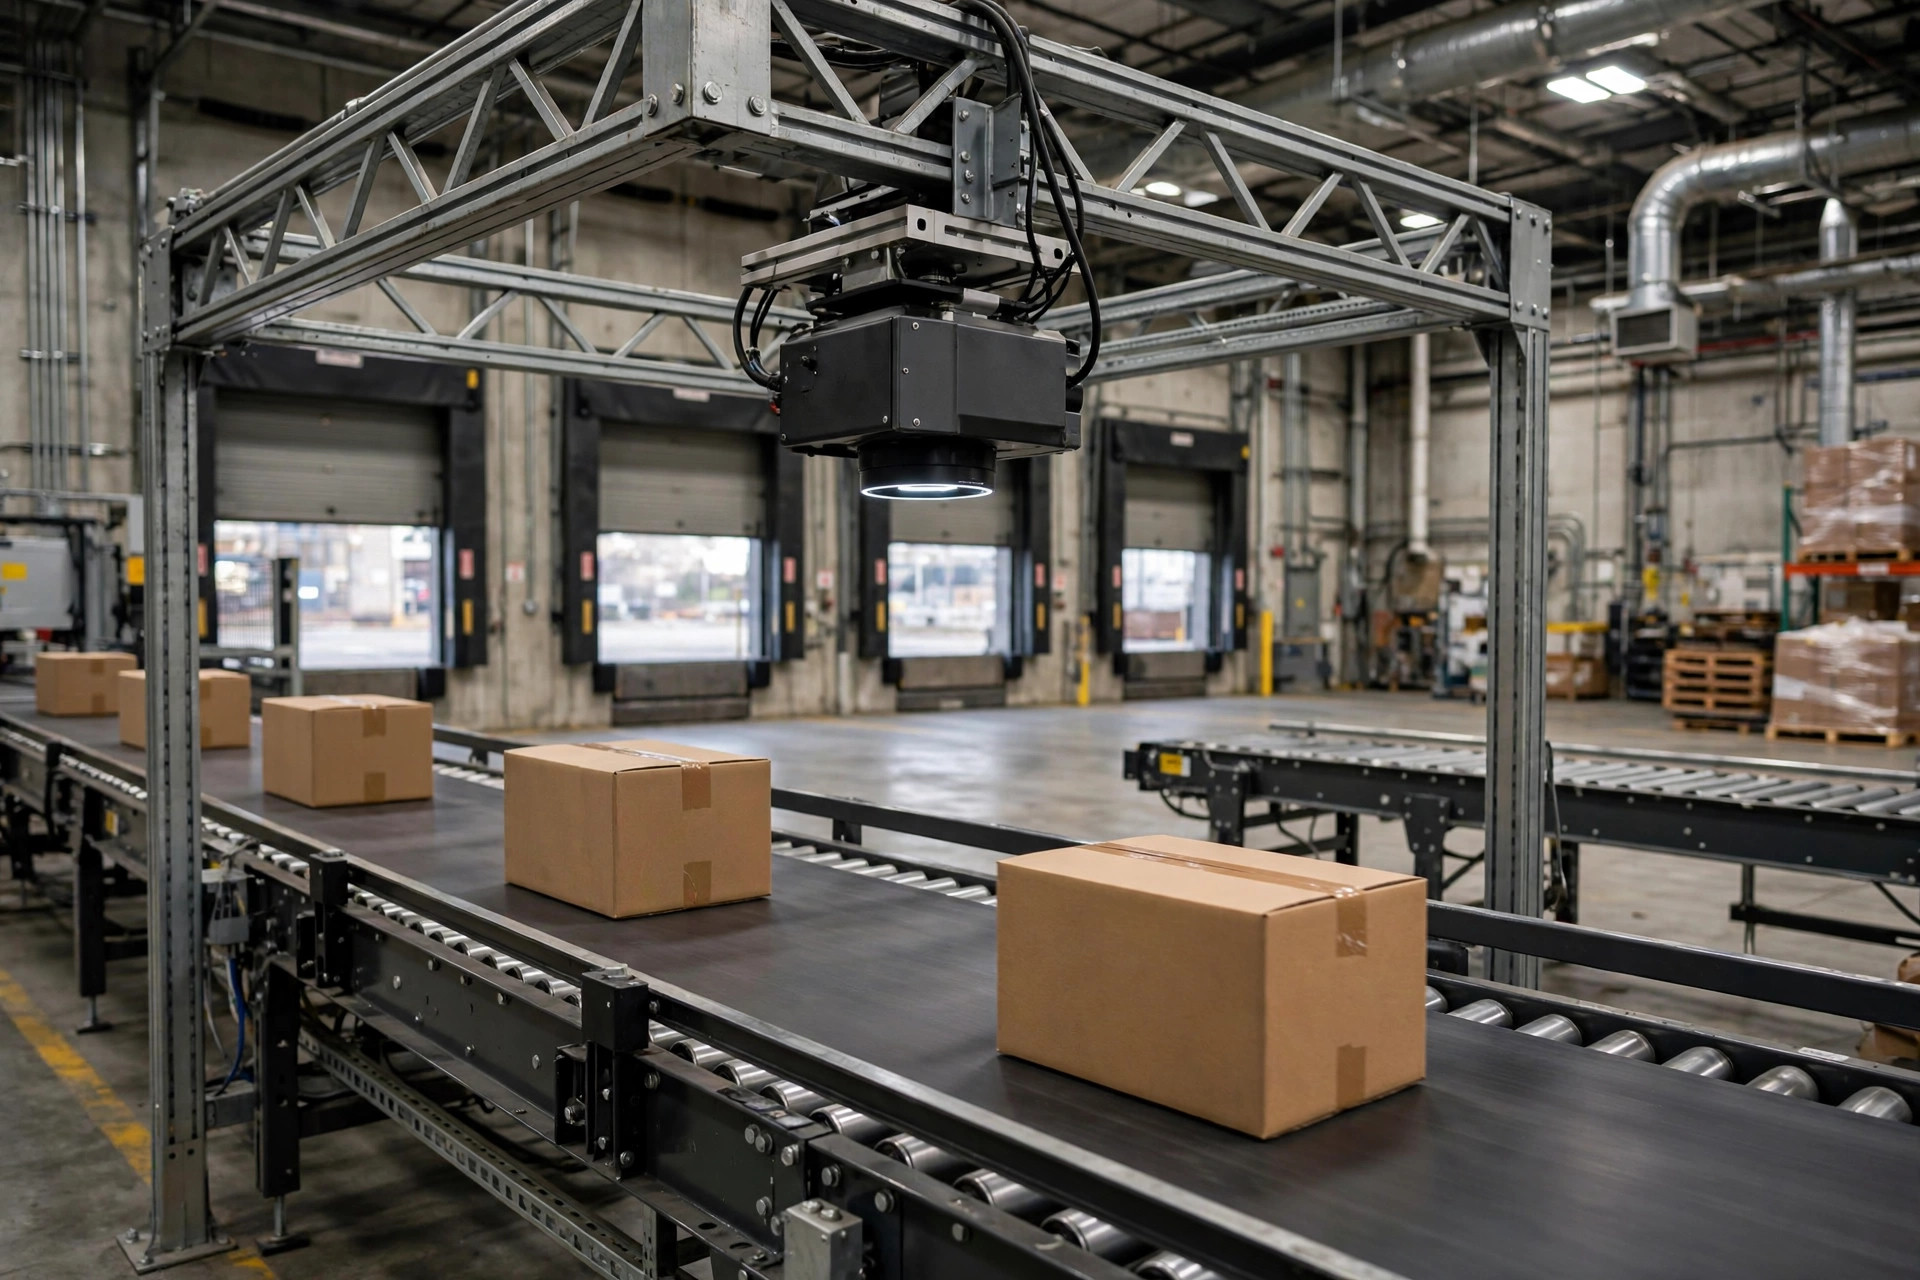
昨年、3Cアクセサリーの倉庫で、コンベヤ上の新しい画像認識システムを見ていた。仕事は段ボールのSKUラベルを読み取り、手動スキャンを置き換えることだ。デモは見事だった。ところが新製品が立ち上がると、最初の1週間で37の新SKUすべてを自信満々に旧SKUとして誤分類した。カメラは正常だった。アルゴリズムも正常だった。モデルがその顔を見たことがなかっただけだ——それでも「一番近い」旧カテゴリを選んでしまった。
これが従来の分類器の致命的欠陥だ:教えたカテゴリの中からしか選べない。試験に見たことのない問題を出しても、それでも答えを書いてしまう。Few-Shot学習はまさにこれを直すためにある。
実際に学習していること
従来の画像分類器は、各カテゴリの見た目を記憶する。製品Aの写真を数千枚見せればAの顔を覚える。新しい画像を見せれば「A、B、Cのどれに一番似ている?」と問う。この「どれかに」に注意——答えは既知のカテゴリのどれかでなければならないと仮定している。新SKUはどれだけ特徴的でも、古いバケツのどれかに無理やり当てはめられる。37の新SKUが第1週に死んだのはこうしてだ。
Few-Shot学習はこの論理を反転させる:「これは誰か」を記憶する代わりに、「これは似ているか」を学習する。学習中、モデルは画像を数字の列——エンベディング——に変換することを学ぶ。似た見た目の画像は近い数字に、違う見た目は遠い数字になる。本番開始時、新SKUが来れば参照写真を5〜20枚撮り、システムはその数字がどこにあるかを覚える。以降の新しい画像はすべて距離で判定される:最も近い参照がそのラベルを勝ち取る。
人間での例え:従来の分類器は持ち込み不可の試験——勉強したことしか出ない。Few-Shot学習は見知らぬ人の顔を覚えるようなものだ——顔を2回見て覚え、次に群衆の中で見つける。相手の名前も職業も知る必要はない。顔を覚えていれば十分だ。
よくある実装、プロトタイプネットワークはさらに字義通りだ:各カテゴリの少数の参照写真を平均して1つの「平均顔」にし、新しい画像を最も近い平均に割り当てる。実装はシンプルで、多くの倉庫業務には十分だ。
得意な場面——そして不得意な場面
まず得意な場面から。互いに明確に見た目が違うSKU——色の違うパッケージ、サイズの違う段ボール、物理的に異なる製品——が本領だ。新SKUが立ち上がり、現場が十数枚の写真を撮ってアップロードすれば、30分で動き始める。2週間のラベリングと再学習サイクルは不要だ。
安定したパッケージも助けになる。一部の消耗品は何年も同じパッケージを保つ。一度参照を撮れば長く使える。
次にNGゾーン。第一に:同じ型で5色展開のアパレル。色以外は見た目がほぼ同じで、実務上は下げ札と洗濯表示で区別している——コンベヤ速度のカメラには見えない。無理強いすれば自信満々の誤認が生まれるだけだ。バーコードをスキャンして先へ進め。
第二に:透明・反射パッケージ。照明が変われば「顔」が変わり、エンベディングの距離が崩れる。照明管理が工業グレードでない限り、動くことを期待してはいけない。
第三に:月に数百SKUが回転するカタログ。新SKUごとに参照写真の撮影・審査・ファイリングが必要——持続的な労務だ。参照ライブラリを腐らせれば、精度は四半期のうちに静かに劣化し、気づきもしない。
導入の3つの罠
罠その1:参照が「きれい」すぎる。現場にオフィスで商品をポーズさせてしまう——白背景、正面アングル、完璧な光。するとコンベヤは傾いた、ブレた、影のある画像を流してきて、何も一致しない。参照は実際のコンベヤで、実際の光で、実際の速度で撮る:1SKUあたり8〜12枚、複数アングル、少し傾け、汚れや損傷のあるパッケージも含める。参照が実戦条件に近いほど、よく動く。
罠その2:「分からない」選択肢がない。距離がどれだけ遠くても、システムはやはり一番近いものを選ぶ——常に答えを持つ。距離の閾値が必要だ:それを超えたら画像は不明と宣言し、人に回す。この閾値は勘ではない。2週間分の実データを流して、誤受理と誤棄却が釣り合うところを見つける。
罠その3:誤認識のコストを見積もらない。1回の誤認識は、誤出荷の運賃+返送+CS工数がかかる。人によるレビュー1回は数秒の労務だ。あなたの仕事は、総コストを最小化する閾値の厳しさを見つけることだ。この計算は倉庫ごとに違う——他人のパラメータをコピーしてはいけない。
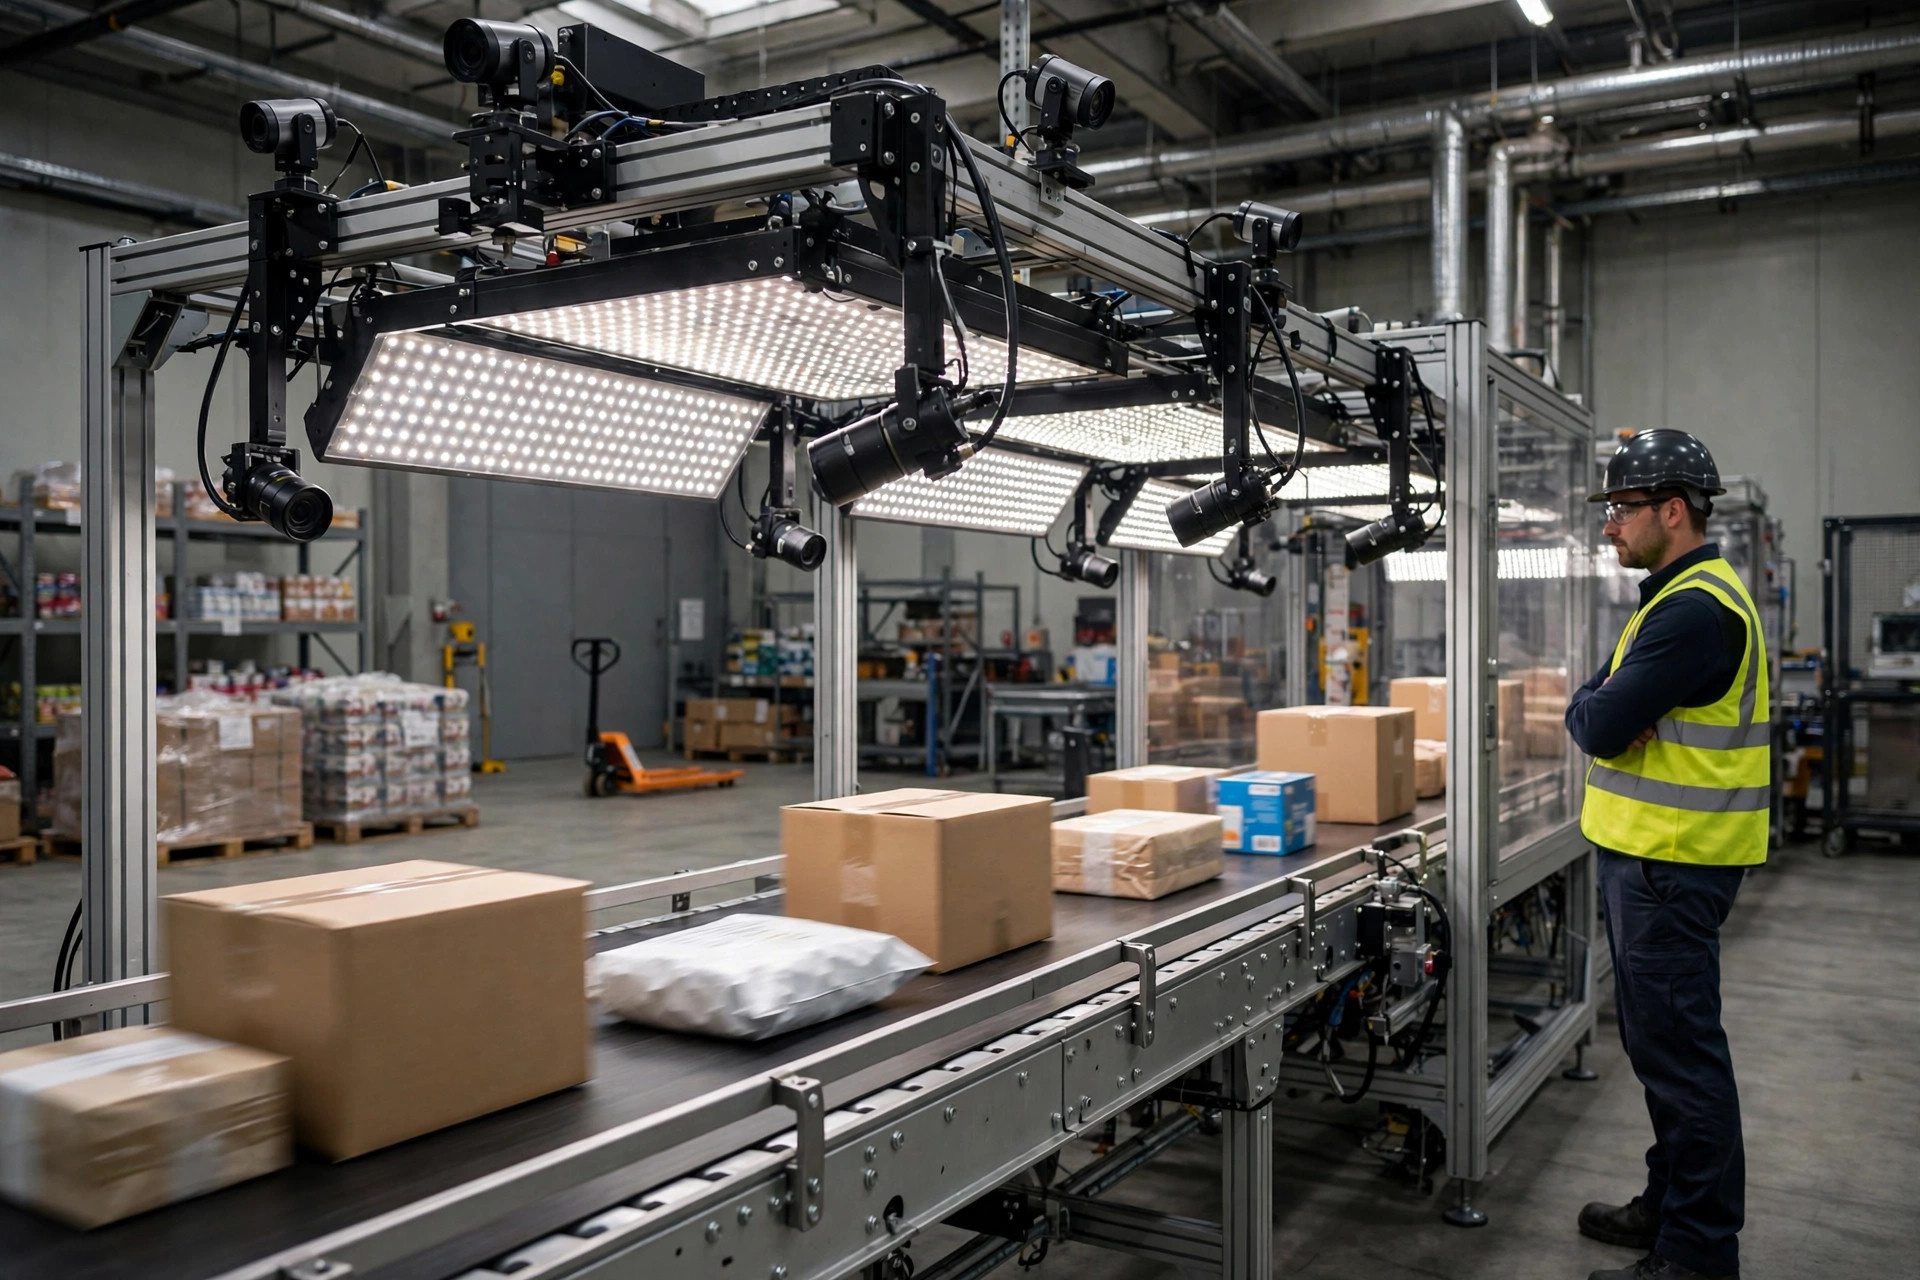
ハードウェアの注意点:カメラをケチるな。Basler aceのような工業用カメラと安定したLED照明の組み合わせは、汎用ウェブカメラよりはるかに一貫した画像を生む。Few-Shot学習は画像の一貫性に敏感だ。初期に数千ドルを節約して、後で精度を5ポイント失うのは悪い取引だ。
うまくいく4週間の立上げ
第1週:コンベヤで、実際の光で、実際の速度で参照を撮る。難しいケース——傾き、半分隠れ、しわのあるパッケージ——を含める。参照の品質が天井を決める。この週を急ぐな。
第2週:閾値を決める。2週間分の過去データを流して、誤受理と棄却のバランス点を見つける。人によるレビューを多めに、少なめではなく——誤出荷はレビュー1回分の何十倍もコストがかかる。
第3週:1つのコンベヤで、または20 SKUでパイロットする。誤認識は毎日レビューし、悪い参照を差し替える。「違って見えるけど実は違わない」SKUペアが見つかる——今対処する。
第4週:拡大し、保守プロセスを固める——誰が新SKUを撮影するか、古い参照をどれくらいの頻度で見直すか、閾値をどれくらいの頻度で再調整するか。保守プロセスのないシステムは3か月で劣化する。保証する。
ベンダーへの質問
どの画像認識ベンダーのデモも見事だ。契約前に5つの質問をする。
その1:新SKUが本番化するまでどれくらいかかるか。「モデルを再学習して2週間」が答えなら、それはFew-Shotの仮装をした従来の分類器だ。本物のFew-Shotは再学習ではなく参照の追加だ——2週間ではなく30分だ。
その2:誤認識率と「分からない」率を別々に。精度だけを言う業者は何かを隠している。精度99%で30%が人に回っていれば、仕事の3分の1は依然として手作業だ。
その3:照明のドリフトにどう対応するか。デモルームの照明を半分に落としてもう一度回させてみろ。ショールームの光で99%を出すシステムの多くは、倉庫の蛍光灯の半分が劣化すると90%に落ちる。
その4:参照ライブラリは何カテゴリのSKUを保持できるか。エンベディング検索型の中には、数千カテゴリを超えると大きく遅くなるものがある。カタログが5桁なら今聞け。
その5:オフラインで動くか。エッジかクラウドか。コンベヤは1分間に数十個の段ボールを流す。クラウド構成でのネットワークの一瞬の途切れがライン全体を止める。倉庫業務にはエッジ導入だけを勧める。
5つすべてにきれいに答えたベンダーは、価格交渉する価値がある。答えられない業者は——デモがどれだけ洗練されていても——売っているのは見本市の展示品であって、本番ツールではない。技術は魔法ではない。正しい場所で使うことが魔法だ。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。