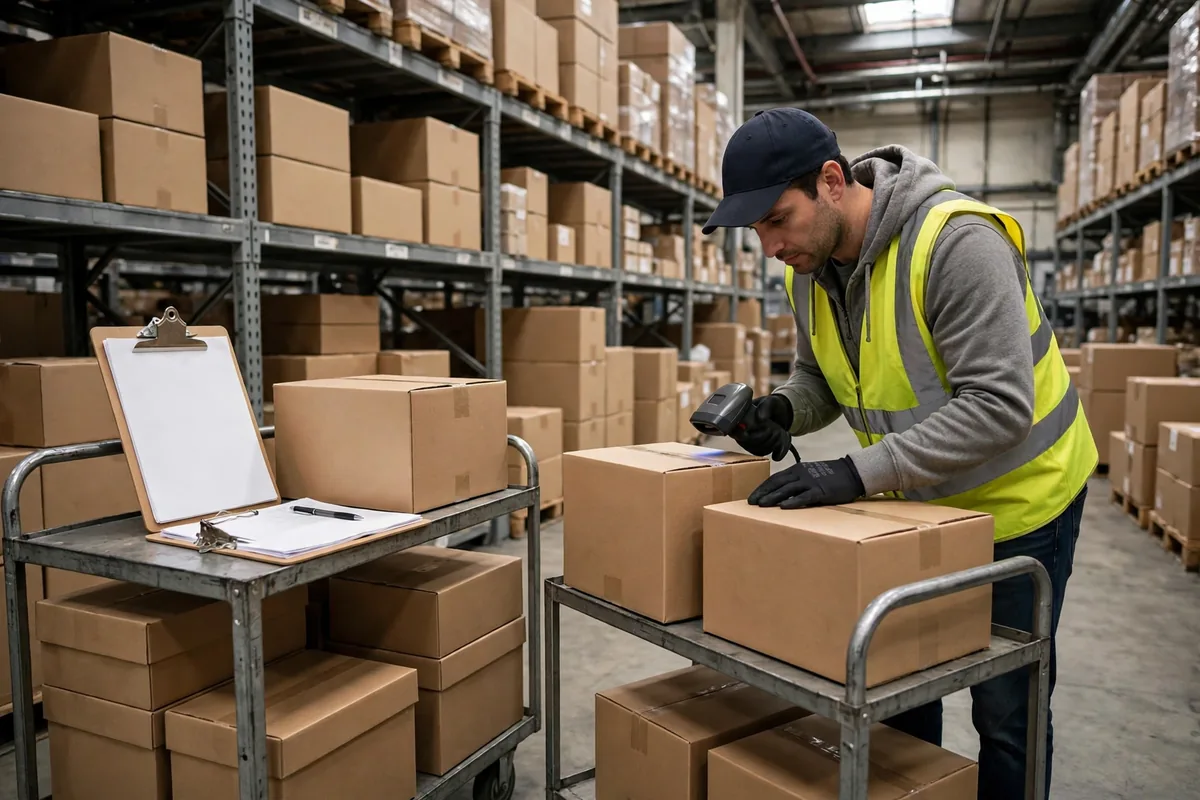
まず請求書の話から始めよう。倉庫のSKU重複コードはいつもそうやって姿を現すからだ。昨年の秋、中国東部のサードパーティ倉庫を訪ねた。そこのマネージャーは、棚卸しがどうしても合わないと繰り返し言っていた。私たちは二日間かけて調べた。棚卸し担当者がいい加減だったわけでも、システムが壊れていたわけでもない。問題はもっと静かだった。一つの商品が、システムの中で三つの異なるコードで生きていたのだ。名前は一語だけ違い、あるレコードには色が入っており、別のレコードには入っておらず、それぞれに独自のバーコードがあった。荷物を受け取る人は、その日の書類に載っているコードをそのまま選んでいた。棚の上の在庫は現実のもので、おおむね正しかった。だがシステムは三つの別々の商品を見ており、それぞれが自分の方向へずれていった。あるコードは数百単位の余剰を示し、別のコードは不足を示し、誰も自信を持って合計できなかった。
ここが、この問題について人々が誤解している点だ。これは一度きりの整理コストではない。毎月の請求であり、オペレーションのあらゆる部分が静かに徴収していく。棚卸しに時間がかかるのは、担当者が目の前の現物に三つのコードのどれが合うのかを見極めなければならず、外箱が変わっていれば立ち止まって上司に聞かなければならないからだ。ピッキングの誤りはもっと微妙な形で起きる。作業者は正しい商品を取るがコードを間違え、システムはそれでもエラーを記録し、注文は検品、返品、再ピッキングへと回される。月末になると、経理はあるコードの在庫切れを見て追加発注する一方で、その双子のコードは誰も見ていないロケーションで手つかずのまま眠っている。同じ商品に二回支払うことになる。一回は必要のなかった補充発注で、もう一回は動かない在庫の保管料としてだ。そして最悪なのは、顧客が実際に販売可能な数量を尋ねたとき、三つの数字のどれも安心して答えられないことだ。
倉庫のSKU重複コードが実際にどこでお金を奪うのか
私はコストを四つの項目に分ける。分けてしまえば、修正すべきだという議論は抽象的でなくなるからだ。第一は棚卸しの人件費だ。一回数えればよいロケーションが棚卸し表に三回現れ、あいまいな箱があるたびに会話が発生する。中規模の倉庫では、その余分な確認時間が毎月かなりの人件費になる。第二はピッキングの手戻りだ。コード違いのピッキングは商品違いのピッキングではないが、システムは同じように扱うため、修正手順がすべて走り、納期が遅れる。第三は滞留・廃棄在庫だ。何か月も動いていないコードは、隣で双子が順調に売れていることを自分からは教えてくれない。誰かが気づいた頃には包装が変わっており、在庫は値引きでしか動かないか、まったく動かないかもしれない。第四は最も高くつき、最も見えにくいもの、すなわち歪んだ意思決定だ。購買は不足コードに対して買い、営業は過剰コードに対して注文を断り、資金は両側から同時に締め付けられる。
その中国東部の倉庫では、目に見える項目だけをざっと集計した。余分な棚卸し時間、エラーの手戻り、滞留品の処理、資金に縛られた不要な補充だ。中規模のオペレーションで一年間にすると、経験豊富な倉庫スタッフ二人分の年収に相当する額になった。その数字には顧客クレームや失注はまったく含まれていない。マネージャーは重複コードをデータマスタの厄介事、付き合っていくものだと思っていた。実際には利子のように複利で膨らむ。放置するほど、課金される元本が大きくなる。
重複SKUコードはどう生まれるのか
重複は、一つの劇的なミスで生まれることはめったにない。通常は同時に三つの入口から漏れ出す。第一は、統制のないコード作成だ。新しい顧客が来て、現場が荷受けを急ぐあまり、その場でコードを作る。顧客の書類から名前を写し、任意に見える項目を飛ばす。次に同じ商品が届いたとき、別の人がコードを作り、名前をわずかに違えて書き、システムは一致を見つけられないため、二つ目のコードが生まれる。第二は、二つの採番体系の並行運用だ。顧客は自社の品番を使い、倉庫は自社の番号を使い、対照表がその間を翻訳する。その表が古くなったり、保守担当者が変わったりすると、翻訳がずれていく。第三は、変更プロセスを経ない包装・仕様変更だ。商品の包装が変わったり、ケース入り数が変わったりしても、古いコードが凍結されず、新しいコードが横に並んで稼働し、古い箱と新しい箱が同じ棚に混ざる。
返品は特別に触れておく価値がある。注意深い倉庫でさえ引っかかるからだ。商品が戻ってきて、返品書類には元の出荷注文とは異なるコードが載っている。ドックを空けたい受入担当者は、返品伝票のコードで商品を入庫する。商品は正しく、コードは間違っている。その日から、そのロットは二つの身分を持つ。次に古いコードの注文が来たとき、ピッカーはそれを見つけられず、不足を報告し、在庫は別名の下、一ロケーション隣に眠っている。
倉庫を止めずに重複コードを整理する方法
整理には順序があり、順序を間違えると二つ目の混乱が生まれる。最初のステップは出血を止めることだ。新しいコードは、名前、仕様、バーコードがすべて揃い、似た既存名の検索を先に行ったうえで、一人のチェックを経なければ稼働させない。この一つのルールだけで、新規の重複は劇的に減る。次のステップは統合で、波状に行い、決して一度に全部やらない。動きが速く、誤りの多い商品から始め、コードをまとめ、現物、外箱、入出荷履歴と照合し、進行中の注文を先に片付け、旧コードから新コードへの対応表を残して履歴が読める状態を保つ。最後のステップは扉を閉めることだ。包装変更、顧客番号の変更、返品受入はすべて同じ変更プロセスを通し、チェーンのすべてのつながりを同時に更新する。
ここが、ほとんどのチームが逆に捉えている判断だ。速くて完全な方が常に良いとは限らない。倉庫はコード統合の間も注文を受け続けなければならず、強引な統合はすでにピッキング中の注文を混乱させる。誤りの頻度で商品に順位をつけ、毎日の問題児を先に、時々のものを次に、長く眠っているコードは最後に、滞留品の処分と一緒に処理する。履歴の扱いにも、意識的に決めるべきトレードオフがある。履歴レコードを新コードで書き換えてはいけない。対応表を残し、レポートはそれを通して読み替える。履歴の書き換えはきれいに見えるが、監査証跡を説明できなくなる。一方、対応表があれば古い取引はすべて追跡可能だ。
始める前に、三つの数字を数えよう。疑わしい重複グループがいくつあるか、各グループが典型的な月に何件のエラーを起こすか、一件のエラーが人件費と手戻りでいくらかかるかだ。掛け合わせれば、あなたのオペレーションにおける倉庫のSKU重複コードの月額が得られる。整理の後、同じ三つの数字を三か月間数える。その差から、整理自体にかかった人件費を引いたものが、この作業のリターンだ。倉庫のSKU重複コードが危険なのは、主に誰も値段をつけていないからであり、だから小さな欠陥として扱われ続ける。数字をつければ、承認は容易になり、進捗は測定可能になる。値段をつけて統合された倉庫のSKU重複コードは、棚卸し表を短くし、ピッキングエラーを減らし、同じ商品を買いながらため込む購買をなくしてくれる。
Lao Zhou(物流コストアナリスト)著 英語版からの翻訳。内容に相違がある場合は英語版を優先します。