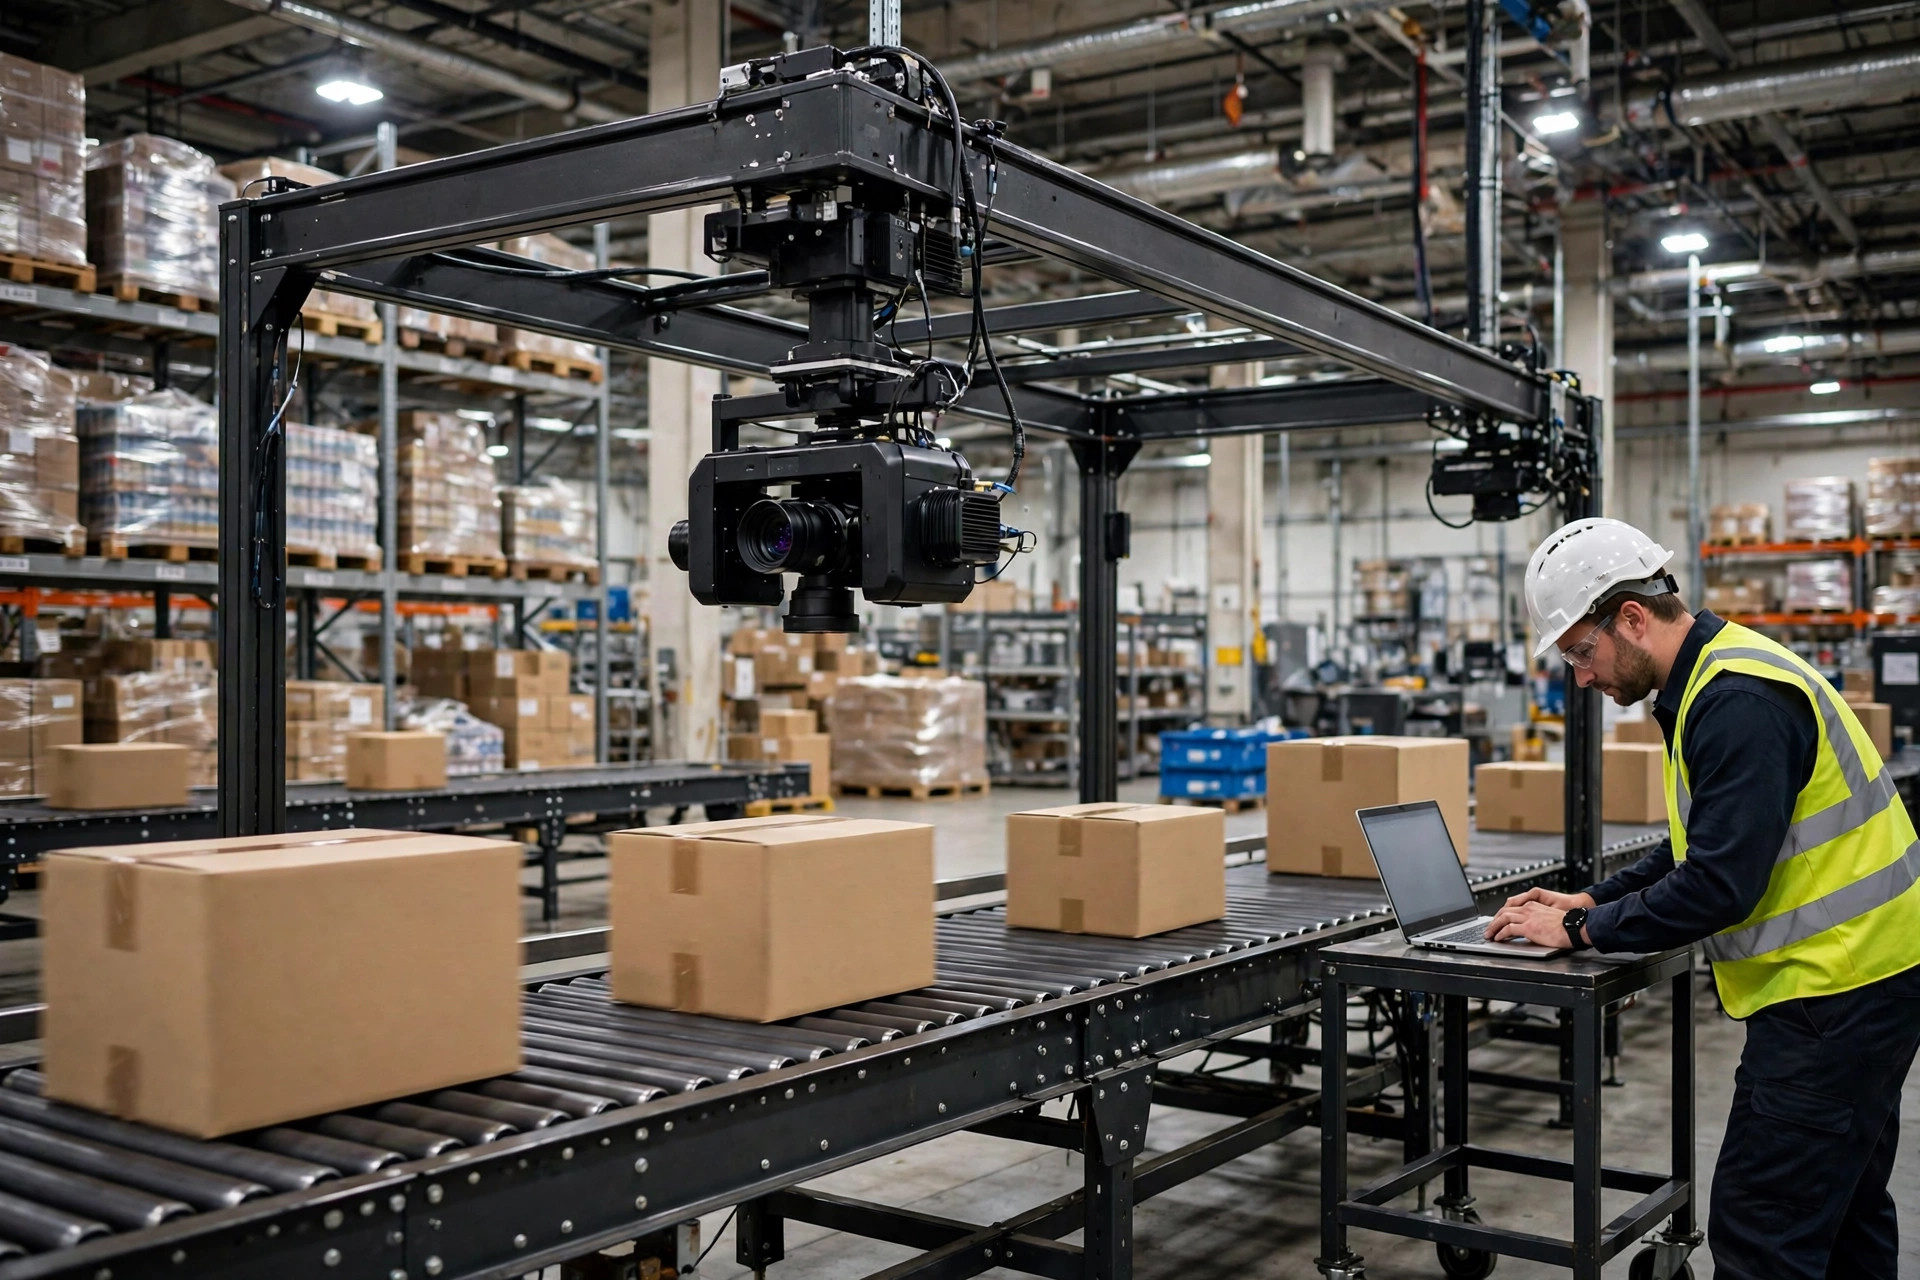
2023年後半、中国南部の3PL仕分けセンターで奇妙な問題が起きた。荷物はベルト上を秒速1.8メートルで流れ、荷物認識はクラウドのAI推論で動いていた。1往復に380ミリ秒かかり、その間に荷物は68センチメートル進む。振り分けシュートの幅はわずか60センチメートルだった。誤仕分け率は0.3%から4.7%に上昇した。1日80,000個の荷物のうち、3,700個以上が間違ったシュートに落ちた。その夜、エンジニアたちはモデルを現地のエッジボックスに移した。レイテンシは60ミリ秒未満に下がり、翌日には誤仕分け率は0.4%に戻っていた。
すべての倉庫はいずれ、AI推論のエッジ対クラウドという問いに直面する。ここではその計算式を3部構成で示す。レイテンシ、コスト、そしてネットワークが死んだときに何が起きるか、だ。
まず原則:学習と推論は別の仕事だ
運転を習うことと運転することの違いを考えてみよう。教習所で習う(クラウド——大きな計算力、急がない)。だが路上に出たら、自分でリアルタイムに反応する(エッジ——ミリ秒の反応)。AIも同じだ。クラウドでモデルを学習させるのは自明だが、推論をどこで動かすかはワークロード次第だ。
倉庫のAIワークロードは3種類ある。
- コンピュータビジョン:バーコード読み取りと再スキャン、荷物の破損検知、寸法測定、フォークリフトと歩行者の安全検知。データ量が大きい(映像ストリームが流れ込む)、リアルタイム性が厳しい。
- 音声:音声ピッキング、例外報告の音声→テキスト化。音声ストリームは実はごく小さい——だがインタラクションは閉ループで、人は待ってくれない。
- 予測:需要予測、補充提案、要員計画。バッチジョブだ。答えが1時間後に来ても誰も気にしない。
そして偽の要件についての率直な一言。ある倉庫のオーナーが、クラウドAIでコンベア上の荷物をリアルタイムに数えられるかと聞いてきた。私は言った。光電カウンタは数百ドル、ネットワーク不要、レイテンシは事実上ゼロだ、と。AIは万能のハンマーではない。すべてを釘扱いするのはやめよう。その場で却下だ。
エッジ対クラウド:レイテンシの計算式——倉庫が払えないミリ秒はいくつか
最初の分かれ目はレイテンシ予算だ。クラウド推論のレイテンシ=アップロード+クラウド演算+ダウンロード。典型的な構成では1往復が100–300 ms、ネットワークのゆらぎ時には500 msを超えるのも珍しくない。エッジ推論はローカルで動き、通常30–80 msで終わる。
レイテンシ予算で3本の線を引こう。
| レイテンシ予算 | 代表的なワークロード | 置き場所 |
|---|---|---|
| ミリ秒の閉ループ(<100 ms) | ソーターの振り分け、AMRの障害物回避、安全停止 | エッジ、議論の余地なし |
| 秒レベルのインタラクション(<1–2 s) | 音声ピッキングの確認、スキャン検証 | エッジまたは近傍ノード |
| 数分以上 | 需要予測、補充、レポート | クラウド |
レイテンシの計算をしよう。ソーターは1.8 m/s、クラウド往復380 ms、荷物の変位 = 1.8 × 0.38 = 68 cm。シュートの幅は60 cm——認識結果が戻ってくる頃には、荷物はすでに自分のシュートを通り過ぎている。これはアルゴリズムの問題ではなく物理だ。どんなモデルの精度も救えない。
ここからが直感に反する部分だ。多くの人は「クラウドの方が演算力が強いから認識精度も高い」と思い込む。間違いだ。精度はモデルと学習データで決まる——同じモデルをエッジハードウェアで動かせば精度は同一だ。クラウドが本当に優れているのは、正確に2つの点だけだ。モデルの学習と、何千ものジョブの一括処理だ。「精度向上のためにクラウドを選ぶ」は愚か者税を払うようなものだ。
エッジ対クラウド:コストの計算式——帯域料金対ハードウェア料金
2つ目の計算はお金だ。クラウドはトラフィックとAPI呼び出しに継続課金する。エッジは一度きりのハードウェア投資+電気代だ。計算式が違う。
帯域から始めよう。1080pカメラ1台、H.264、アップロード2 Mbps。2 × 86,400 / 8 ≒ 1日21.6 GB、カメラ1台あたり月約650 GBだ。20台なら月13 TBの上りトラフィックになる。GB単価は挙げない——クラウドプロバイダの最新の公表料金を見てほしい——だが数十テラバイトの規模では、その請求額でエッジボックスが何台も買える。
2024年3月、中国東部のアパレル倉庫で音声ピッキングをクラウド経由で運用していた。作業員は数量を言って確認音を1.2秒待った。1日に何百回も数量を言い直し、生産性は紙のピッキング以下に落ちた。認識を現地のエッジボックスに移すと、レイテンシは300 ms未満になった。微妙な教訓はこうだ。音声データはごく小さい。だから帯域がボトルネックだったことは一度もない——インタラクションのレイテンシが問題だった。人間を1秒待たせれば苛立ち、言い直し、システム全体が遅くなる。「小さなデータ、厳しいインタラクション」のワークロードでは、クラウドは苦しむためにお金を払っている。
比較の式はシンプルだ。エッジは、3年償却のハードウェア+電気代+保守人件費を、3年間の推論総数で割る——それが1推論あたりのコストだ。クラウドは、トラフィック+API料金を呼び出し総数で割る。小さい方が勝ちだ。24時間365日安定したワークロードはエッジで美しく償却される。断続的なバッチワークロードはクラウドの従量課金の方が安い。それがコストの分かれ目だ。
ネットワークが死んだとき:クラウドが落とすものをエッジは拾えるか
3つ目の計算は、誰もが忘れるものだ。倉庫のネットワークは死ぬ。私は見てきた。自治体の道路工事で切断された光ファイバー、ISPの障害、死んだコアスイッチ。クラウド推論が死ねば、すべて一緒に死ぬ。ローカルハードウェアのエッジ推論は動き続ける。
2024年8月、中国北部の倉庫が道路工事で光ファイバーを失った——6時間のオフラインだ。入荷スキャンの画像認識はエッジで動いていたため、その6時間で約9,000カートンをダウンタイムゼロで処理した。一方、隣のフルクラウドの倉庫は同じ6時間を手書きの入荷記録で過ごした。劣化モードは事前に設計しよう。画像認識はバーコードのみに落とす(破損検知はスキップ)、音声ピッキングはボタン確認にフォールバック、予測ジョブはネットワーク復旧まで停止だ。劣化モードは妥協ではない——設計の一部だ。
保守の罠:エッジハードウェアを不幸にする3つのこと
原則は押さえた、分かれ目は引いた——次は保守の罠だ。これこそエッジの本当のコストだ。
1つ目、熱と粉塵だ。夏に40°Cになる倉庫は普通だ。粉塵で詰まったエッジボックスが高温で動けば、定格50,000時間のMTBFはあっさり半分になる。四半期ごとの清掃を手順書に入れよう——熱スロットリングが起きてから思い出しては遅い。
2つ目、モデルのバージョン不整合だ。20台のエッジボックス、Aはv2.3、Bはv2.1で、認識結果が食い違う——そのデバッグは泣きたくなる。OTAで全ボックスに一斉配信し、配信ごとにボックス単位でバージョン検証を行い、不整合があればアラートだ。エッジデプロイが最もよく爆発するのはここだ。
3つ目、監視の死角だ。死んだクラウドサーバーは1分以内に誰かに通知が飛ぶ。片隅で死にゆくエッジボックスは、何日も気づかれない。ハートビート報告+ウォッチドッグ、5分オフラインで自動アラート——初日に設定しよう。
ではお金は見合うのか?この1つの数字を見よう
冒頭の言葉に戻ろう。1推論あたりのコストだ。3年間のエッジ総支出を3年間の推論総数で割る。クラウドのトラフィック+API料金を呼び出し総数で割る。小さい方が勝ちだ。レイテンシ予算が「可能」を決め、1推論あたりのコストが「経済的」を決め、オフラインのフォールバックが「生き残れる」を決める。3つの計算をすべて回せば、エッジ対クラウドの答えは自ずと書ける。
Da Liu(自動化エンジニア)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。