AMR ベンダーにネットワークが落ちたらどうなるか尋ねてみれば、部屋が静まり返るのが分かるだろう。デモはいつもハッピーパスばかり見せる:滑らかに動くロボット、割り当てられるタスク、緑に輝くダッシュボード。午前 2 時の電話をデモする者はいない。しかし私はその電話を受けたことがある。そして、悪い一夜と災難を分けたのはロボットでは決してなかった——誰も設定しようと思わなかった 3 つの設定だった。
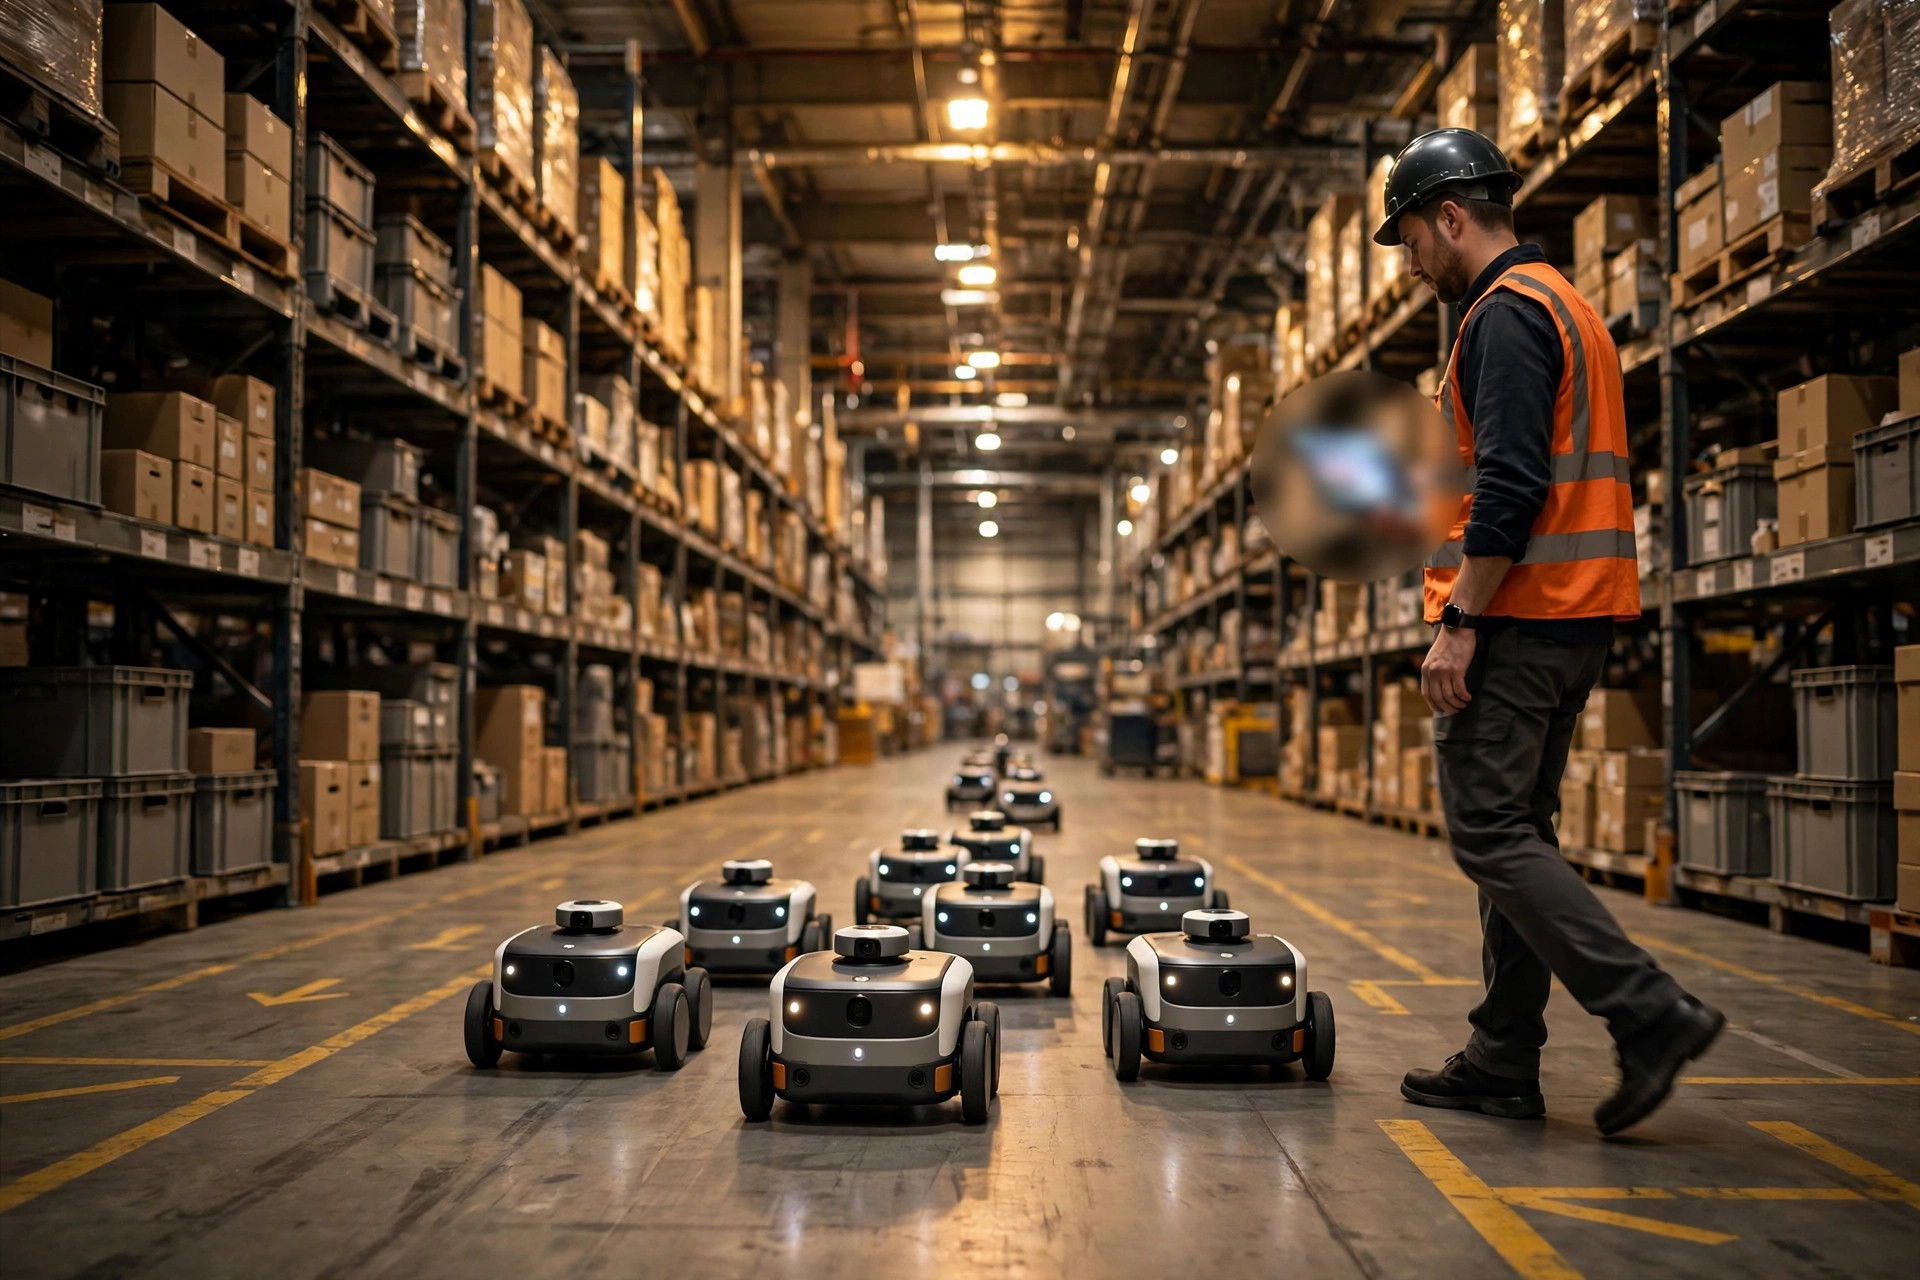
昨年の冬、シカゴ郊外の配送センターが、定期的なスイッチの再起動中に RCS を約 15 分間失った。20 台余りのロボットが通路の真ん中で凍り付いた。夜勤のクルーは訓練を受けていない人間がする通りのことをした:ロボットを 1 台ずつ再起動し始めたのだ。そのせいでタスクの状態はさらに混乱した。ネットワークが戻ってきた頃には、艦隊の半分が「オフライン」、残りの半分が「タスク例外」を表示し、混乱を解くのに 2 時間近くかかった。ロボットは無事だった。計画がなかったのだ。
ここに不快な真実がある:ロボットと RCS のリンクは脳と身体のリンクであり、脳が沈黙したときに身体が何をするかのデフォルトはベンダーごとに異なる。そのデフォルトが契約書になければ、あなたは驚きを買っていることになる。
ネットワークは死ぬまで誰もテストしない
1 つ目の設定はリンク喪失時の挙動だ:ロボットがネットワークの死を宣言するまでに心拍(ハートビート)なしでどれだけ待つか、そしてその後に何をするか。タイムアウトを短くしすぎると、Wi-Fi の一瞬の途切れごとにフロア全体の非常停止が起きる。長くしすぎると、本当に死んだネットワークの下でロボットが古い指示のまま走り続ける。
タイムアウト後、ベンダーは概ね 2 つの哲学を提供する。保守的な方:その場で止まって待つ。人とロボットが混在する交通と複雑な通路のある建物に向いている。積極的な方:ローカルモードに切り替え、機載の地図キャッシュから現在のタスクを完了させ、邪魔にならない場所に駐車する。こちらの方が賢く聞こえるが、落とし穴がある——ローカルの地図が最新でなければならない。RCS が一時的な立入禁止ゾーンを発行した直後で、ロボットがダウン前にそれを同期していなかったら、ローカルモードは封鎖された通路にまっすぐ突っ込んでいく。
私の見解:混在交通の建物はその場で停止すべきだ。閉鎖された固定ルートの生産ラインはローカル継続を検討できる。いずれにせよ、減速は譲れない——盲目で走るロボットは通常より遅く走らなければならない。それを受け入れ基準に、文書で入れよう。
ネットワーク自体について一言:ほとんどの「障害」は死んだネットワークではなく、死角だ。2 つのアクセスポイント間を移動するロボットがハンドオーバーに失敗し、ハートビートが数秒途切れ、RCS はそれを見失ったと宣言する。RCS サーバーは有線で接続しよう——Wi-Fi を巡ってロボットと争わせてはいけない。AP カバレッジに冗長性を持たせ、角や高いラックの裏側をチェックしよう。本番稼働の前に、艦隊を建物全体で走らせてローミングテストを行い、弱い箇所を先に直そう。後からタイムアウトを調整するより断然効果的だ。
契約書に埋もれた 3 つの設定
2 つ目の設定はタスクキューだ:ロボットが何を覚えているか、そしてネットワークが戻ったときにどちらの主張が勝つか。機上では、ロボットは通常、現在のタスクに加えてキューに入った 1〜2 件のタスクをキャッシュする——キャッシュの深さはベンダーによって異なる。浅いキャッシュでは、数分を超えるダウンでタスクリストが消え、回復後に RCS がすべてを再割り当てしなければならない。深いキャッシュでは、ロボットは記憶を頼りにもう少し働き続ける。
本当の罠は再会の瞬間だ。RCS はダウン前の世界のまま目覚める。ロボットはダウン中に行った作業を保持している。一部のシステムはロボット側で照合する——ロボットが報告し、RCS が受け入れ、タスクは止まったところから再開する。別のシステムは RCS 側で照合する——障害ウィンドウ中のすべてが無効化され、再割り当てされる。その 2 番目の設計では、ロボットが既にラインに届けたパレットが「未納品」と表示され、システムはもう 1 つ送ってくる。二重納品、ラインにパレットが 2 つ、そして誰のせいかの言い争いだ。
だから契約する前に:ネットワークが回復したとき、どちらのタスク状態が勝つのか、重複実行はどう重複排除されるのか。その両方の答えを契約の付属書に入れよう。選定中は、ハッピーパスのデモを見るだけでなく、5 分間のネットワークダウンと回復のデモをベンダーに求め、照合ロジックが破綻しないか観察しよう。そのデモでの躊躇がすべてを物語る。
3 つ目の設定は手動引き継ぎだ:誰がロボットを手動に切り替えられるのか、どうやって、そしてその後何が起きるのか。障害が長引くと、現場の誰かが必ず「自分で運転しよう」と思う。ルールがなければ、3 つのシフトが 3 つの異なることをする——ロボットを押す、電源を入れ切りする、バッテリーを引き抜く。私はまさにそれを一度目撃した:回復後、どのロボットがタスクの途中でどれがただ迷子なのか誰にも分からなかった。人間が艦隊の半分に触っていたからだ。
解決策は退屈で不可欠だ:シフトごとに 1 人の障害指揮官を指名する。通常はシフトリーダーだ。他の誰もロボットに触らない——手動移動も電源の入れ切りもなし。回復後、指揮官がチェックリストを回り、各ロボットの状態を確認して、それから初めて再開コマンドを出す。運用マニュアルに書き、新人研修で教えよう。そして権限は厳しく絞る:手動モードの権限はリーダーに、皆にではない。オペレーターに必要なのは状態の可視性であり、鍵ではない。
そこで最も重要な受け入れテストの話だ。本番稼働の週に、本当にプラグを抜こう——スライドでもラボのデモでもなく、実際のネットワークケーブルを、実際の建物で、実際の生産中に抜くのだ。すべてのロボットを観察しよう:喪失を宣言するまで何秒か、止まるか続けるか、どこまで進むか、回復時にタスクが照合されるか、二重割り当てが起きないか。すべて書き留めよう。その文書が障害プレイブックの初稿になる。
それを避難訓練のように四半期ごとにやろう。ネットワーク機器は老朽化し、RCS はアップグレードされ、ロボットのファームウェアは変わる——そのどれもがデフォルトを密かに変えうる。低生産の時間帯を選び、10 分間ケーブルを抜き、プレイブックがまだ機能することを確認しよう。
障害そのものは災難ではない。真の災難は、繁忙期にフェイルオーバー計画を初めて知ることだ。必要になる前にリハーサルしておけば、午前 2 時の電話はぐっと短くなる。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。