まずは請求書から。
ピッキングロボットにカートンを認識させるには、約100,000枚の訓練画像が必要だ。手作業でラベル付けすると、ベンダーの公開価格表によれば、シンプルなバウンディングボックス作業は1画像あたり$0.10–$0.50:初回パスだけで$10,000–$50,000になる。
3か月後、梱包材サプライヤーがカートン素材を変更し、冬の光でグレアが変わり、モデルは箱の半分を認識しなくなる:さらに20,000枚、何千ドルもの追加コストが消えていく。
だからこの記事はニューラルネットワークの話ではない。お金の話だ:倉庫AIビジョンモデルがどう訓練されるのか、各ルートがいくらかかるのか、落とし穴はどこか——そして自分の見積もりを当てはめるための算数の問題を一つ。
まずは請求書から:倉庫AIビジョンモデルの訓練方法は3つのルートに集約される
ビジョンモデルの訓練データには、正確に3つの供給源がある:人間が撮った写真、人間が描いたもの、機械が生成したものだ。
ルート1:実写真+人間のラベル付け。 倉庫の現場で撮影し、手で箱を描く——「これはカートン、これはパレット、これは破損」。
ルート2:CADシミュレーションのレンダリング。 正確な3D CAD図面があれば、仮想の部品を仮想のビンに落とし、照明・数量・テクスチャ・ノイズをランダム化して、数百枚の画像をレンダリングする。ラベルは自動生成される——エンジンが各部品の位置を知っているからだ。人間の時間はパラメータ調整に使う。
ルート3:生成AIによる合成データ。 図面は不要だ。生成AIが、アノテーション済みの倉庫シーンを直接「描く」——潰れたカートン、ほこり、ストレッチフィルムといった見苦しい状態も含めて。コスト比較表は後掲。まずは一つずつ。
ルート1:実写真+人間のラベル付け——いちばん愚直で、いちばん高く、いちばん正直
いちばん古いルートであり、今も倉庫ビジョンプロジェクトの大多数がたどる道。魔法はない:撮影、箱描き、QA、訓練。
計算はベンダーの公開価格表(Basic.ai)から:1箱あたり$0.03–$1.00、シンプルな作業で1画像あたり$0.10–$0.50。1画像4箱、$0.30/画像なら、100,000画像 = $30,000——QAは別だ。2回通しのレビューが標準で、合計コスト1.5–2倍の乗数が普通だ。
2024年に実案件を積算した:昆山の3PL拠点、ピッキングロボット、2,000SKU超、撮影80,000枚。ベンダーの見積もり:1箱$0.08、1画像4箱——80,000 × 4 × 0.08 = $25,600(机上)。プロジェクト管理費と約15%の手戻りを入れると、実際の支払いは$30,000を超えた。
稼働開始から半年後、カートンのサプライヤーがクラフト紙から白コート紙に切り替えた。反射率が変わり、認識率が6ポイント低下。また20,000枚——約$10,000の追加だ。
ルート1の真実:実データは買い切りではなく、サブスクリプションだ。 梱包材・照明・季節の変化があるたび、ラベル付けのラウンドが追加で発生しかねない。契約を一つ結ぶのではなく、継続請求にサインしているのだ。
長所も本物だ:忠実度。実データで訓練されたモデルはsim-to-realギャップが最小——訓練環境と展開環境が同じ場所だからだ。
ルート2:CADシミュレーションのレンダリング——図面があれば最安
正確な3D CADモデルがあれば、話はシンプルになる:シミュレーションツールが仮想の部品を仮想のビンに落とし、数量・照明・テクスチャ・カメラノイズを変えて、数百枚の画像をレンダリングする。アノテーションは無料だ——エンジンが各部品の位置を知っている。
2026年5月のRoboticsTomorrowの記事が的を射た:正確なCADモデルがあれば、これは「最も信頼性が高く、最もリソースを使わないアプローチ」だ——エンジニアの時間は箱描きではなくパラメータ調整に使われる。
致命的な欠点が二つ。第一に、図面がなければ始まらない——レガシー部品、サプライヤー部品、現物とのずれは、シミュレーションの足場にならない。第二に、レンダリングがきれいすぎる:実画像には油・傷・フリッカーする照明があるが、レンダリングにはない。きれいすぎるデータで訓練されたモデルは、現場で崩壊する。
直感に反する結論:CADシミュレーションの問題は「リアルさが足りない」ことでは決してなく、「真実とは思えないほどきれいすぎる」ことだ。 倉庫はクリーンルームではない。モデルが恐れるのは汚さではなく、見たことのない汚れだ。
ルート3:生成AIの合成データ——ZebraのSTRIPESが実際に解いているもの
ルート3は、2026年の倉庫AIビジョンモデルの訓練方法に対する最も熱い答えだ。その旗艦は、ZebraのSTRIPESデータセット(Sim-to-Real Industrial Perception for Warehouse Scenes)、2026年9月に公開された。
数字は:30,000枚の画像、3,000種の独自の箱テクスチャと形状、1,000,000個のラベル付き箱——人間が描いたものは一つもない。
STRIPESの3つの革新は、まさにルート2の弱点を突く:静的な3Dモデル不要の生成AI画像生成により、シーンの多様性は図面ライブラリの縛りから解放される。摩耗・損傷のシミュレーション——潰れたカートン、へこみ、表面のほこり、ストレッチフィルム——最も汚い倉庫の状態であり、パイプラインで最も価値あるステップ。そして物理法則に基づく混雑で、重力シミュレーションが箱を自然に密集・傾斜・噛み合った配置に積み上げる。3つの実フェーズにわたって:棚保管、フロアの仮置き、トラック積み込みだ。
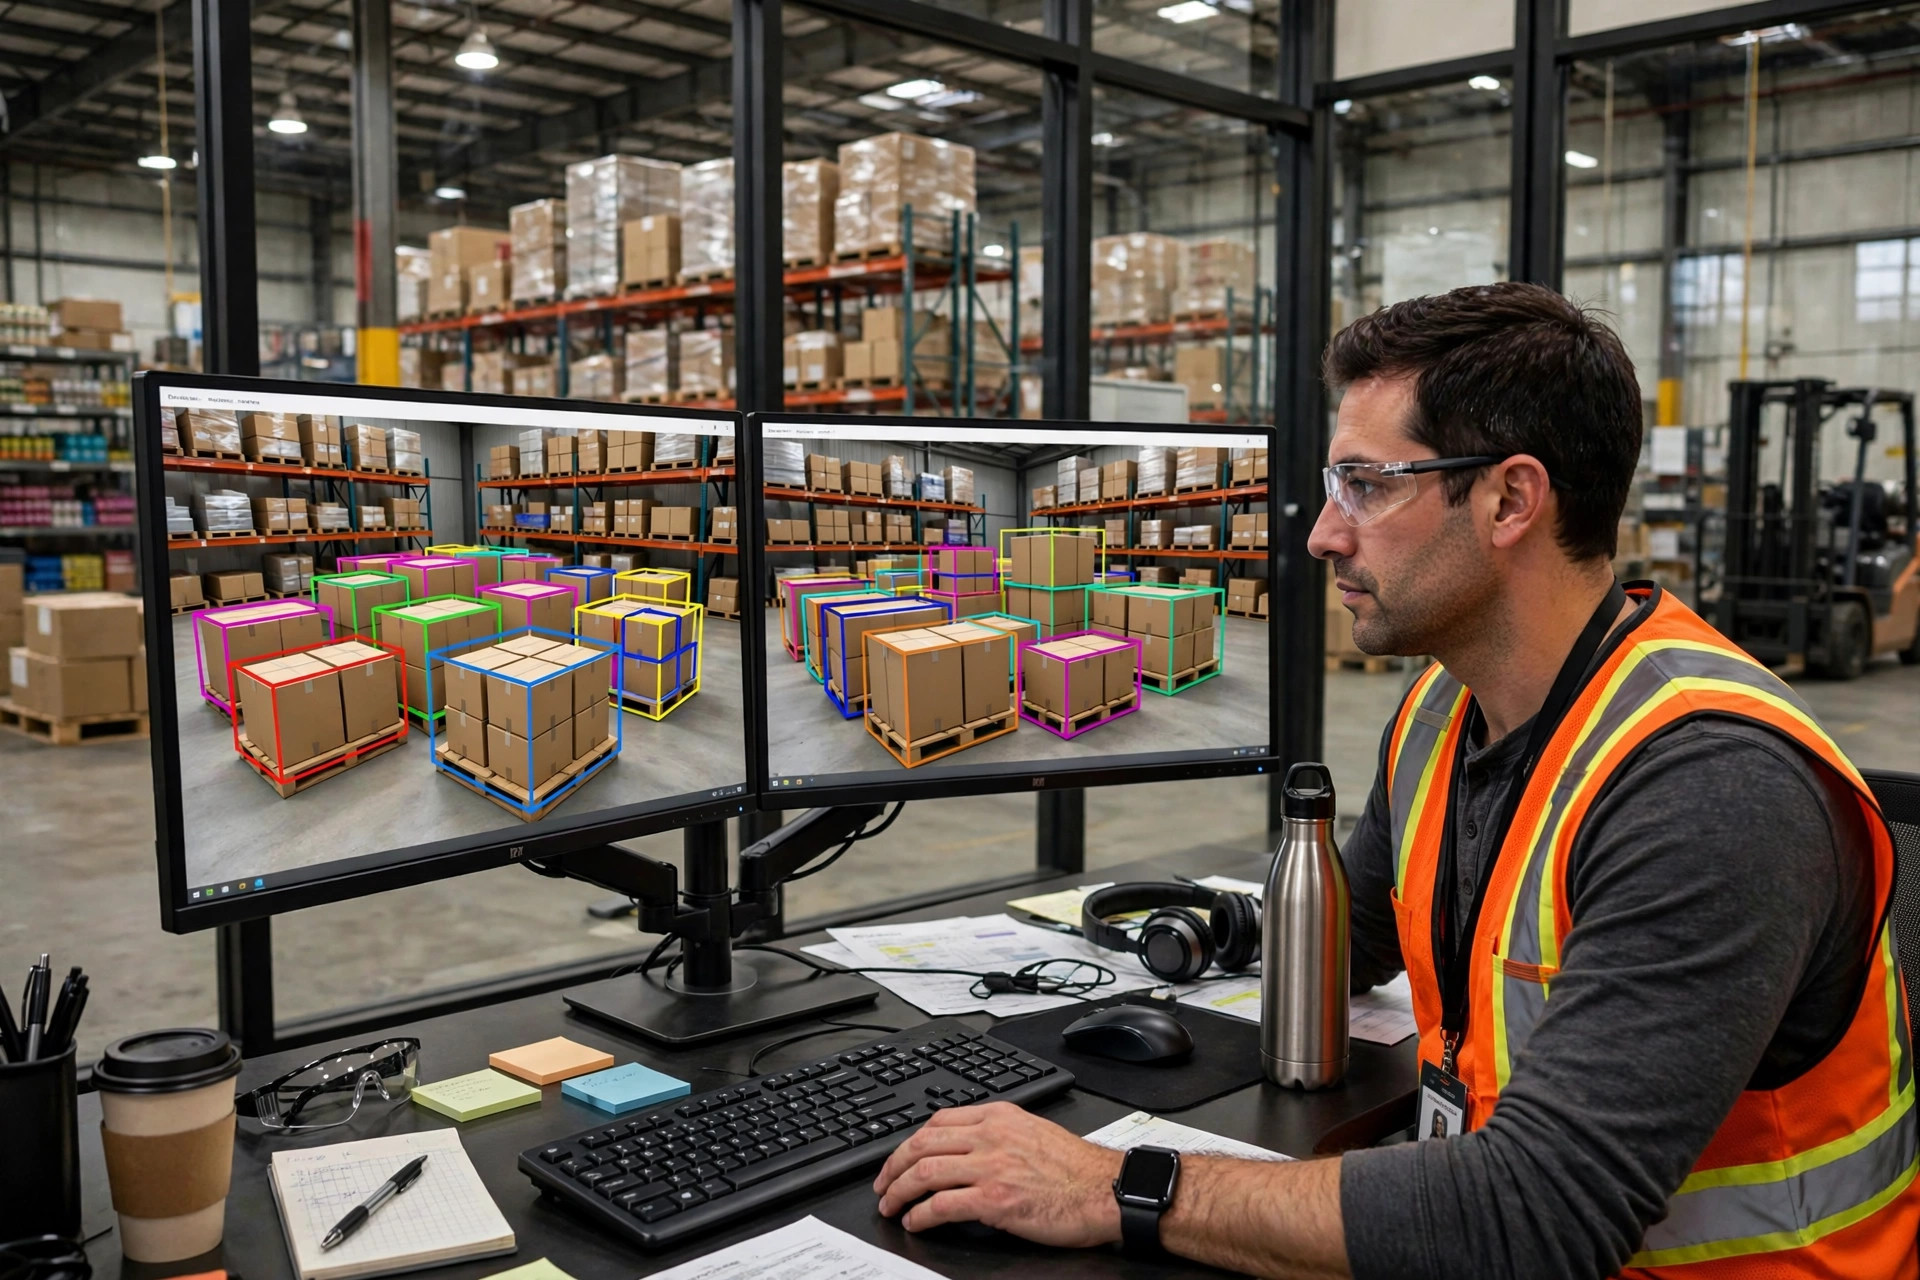
見えるだろうか?STRIPESが解いているのは「合成データはリアルに見えるか」ではなく「十分に汚いか」だ。合成データはきれいである必要はない——汚くある必要がある。 シミュレーションでの99は何の意味もない。重要なのは、モデルがそこで何種類の汚れを見たかだ。
コストについて:30,000枚の画像と1,000,000個の箱で、限界コストは労働ではなく計算だ。だがルート3は3つの中で最大の固定投資を要求する——生成モデル、物理シミュレーション、パイプラインエンジニアリング、すべて前払いだ。小規模プロジェクトには手が出ない。大規模になれば安くなる。
Sim-to-Realギャップ:ラボでは99、現場では92
sim-to-realギャップ:訓練環境と展開環境の差だ。2026年5月、Robotics and Automation Newsはこれを埋めることを「現代ロボティクスで最も価値の高い目標の一つ」と呼んだ。
どれほど残酷か?2026年9月:TelexistenceがNVIDIAのDreamZero——行動とカメラ映像を同時に予測するモデル——をコンビニの品出し向けにファインチューニングした。きれいなシミュレーションのピッキングデータ:成功率45%。実際のテレオペレーション記録:0%。根本原因:シミュレーションと現実の間での同時分布と状態スケールの不一致だった。
45%から0%は「少しずれている」ではない——別の宇宙だ。ギャップは画像数ではない。分布が一致しているかだ。
2026年4月、TELUS DigitalのSteve Nemzerがうまく言った:合成データは特定のギャップを埋めるのに使い、訓練の土台は実世界のデータに置け——センサーのアーティファクトや製造現場の敵対的条件は、合成データでは教えられない。
私の訳:合成データはパッチであり、土台ではない。 土台は実データのままだ。パッチは、撮影もできず、待つ余裕もないロングテールを覆う。
そのロングテールについて:このサイトの2026年10月7日の記事——「撮影できない異常サンプル」——は実践的なパッチングの手引書だ。この記事は、請求書付きの3ルートの全景図である。
3つのルート、1つの表
| ルート1:実物+人間ラベル付け | ルート2:CADシミュレーション | ルート3:生成合成 | |
|---|---|---|---|
| 限界コスト/画像 | $0.10–$0.50(ベンダー公開料金) | レンダリング計算、人間よりはるかに安い | 生成計算、人間よりはるかに安い |
| 固定投資 | 低(主に撮影の人件費) | 中(パイプライン+エンジニア調整) | 高(生成モデル+物理シミュ+パイプライン) |
| 100K画像規模の請求 | $10K–$50K、QA乗数1.5–2倍 | 図面があれば最低、固定費を償却 | 大規模で最安、小規模では元が取れない |
| 忠実度 | 最高、ギャップ最小 | 中——「きれいすぎる」を恐れる | 中高——STRIPESが「汚れ」を直している |
| 致命的欠点 | ロングテールを捉えられない。SKU/環境の変化ごとに再ラベル付け——コストはサブスクリプション | 図面なしでは死ぬ | 前払いが重い、小規模では非経済 |
もう二つ、直感に反する結論:
第一に、データラベリング業界は、自分が訓練するモデルに食われている。 AI事前アノテーション+人間のレビューが、今やベンダーの標準プレイブックだ。純手作業の箱描きは終わりつつあり、単価は下がり続けている。今、純手作業の大型長期契約を結ぶことは、高値掴みを意味する可能性が高い。
第二に、いちばん高いデータはラベリング料金ではなく、捉えられないデータだ。 ロングテールの異常サンプルの限界コストは無限大に近づく:3か月待てば、「フォークリフトがパレットを壊した」の標準的な写真は二度と手に入らない。合成データの真の価格力は安さではなく、買えなさだ。
Lao Zhouの結論:「倉庫AIビジョンモデルの訓練方法」は算数の問題だ
どのルートか?勘ではなく計算だ。ルート1の合計 ≈ N × p × q(N:必要な画像数、p:画像単価の見積もり、公開範囲$0.10–$0.50、q:QA乗数、1.5–2)。ルート3の合計 ≈ F + N × m(F:パイプライン固定投資、m:画像あたり限界コスト、pよりはるかに小さい)。損益分岐点N* = F ÷ (p × q − m):N*を超えれば合成が勝つ。
計算例(例示的な入力——自分の見積もりを当てはめてほしい):F = $30,000、p = $0.30/画像、q = 1.5、m ≈ $0.05/画像。N* = 30,000 ÷ (0.45 − 0.05) = 75,000画像。
結論:約75,000画像を超える場合——あるいはSKUの入れ替わりが速く、環境変化がNを押し上げ続ける場合——合成ルートが元を取る。そうでなければ人間のラベル付けに留まれ。「より先進的」に余分な金を払うな。
その金が無駄だったかどうかは、式が決める。
Lao Zhou(物流コストアナリスト)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。