生成AIの倉庫での導入は、この二年間ずっと大きな話題になっている。私は、まるでこの技術が建物を単独で運営できるかのように語るベンダーのデモや業界レポートを読んできたが、その後、実際の倉庫を歩いてみると、そこでは今も主に質問に答えているだけだった。本稿はビジョンについてのものではない。質問に答えることと意思決定をすることの距離を、段階ごとに測り、各段階に実際にどれだけのコストがかかり、どれだけの時間がかかるのかを問うものである。
倉庫は、自信たっぷりに聞こえるシステムにとって難しい場所である。誤った商品を選んでも返品できる。誤ったパレットを出荷すれば、トラック一台分まるごとのクレームに発展しかねない。言語モデルは、あいまいな表現を扱い、散らばった情報を集めるのが得意である。倉庫に必要なのは、追跡可能な記録を伴う明確な行動である。倉庫向け生成AIツールへの検索関心は上がり続けているが、検索関心は現場の準備状況とは別物である。その二つの要求の隔たりこそが本稿の主題である。
生成AIと倉庫:一段の飛躍ではなく三つの段階
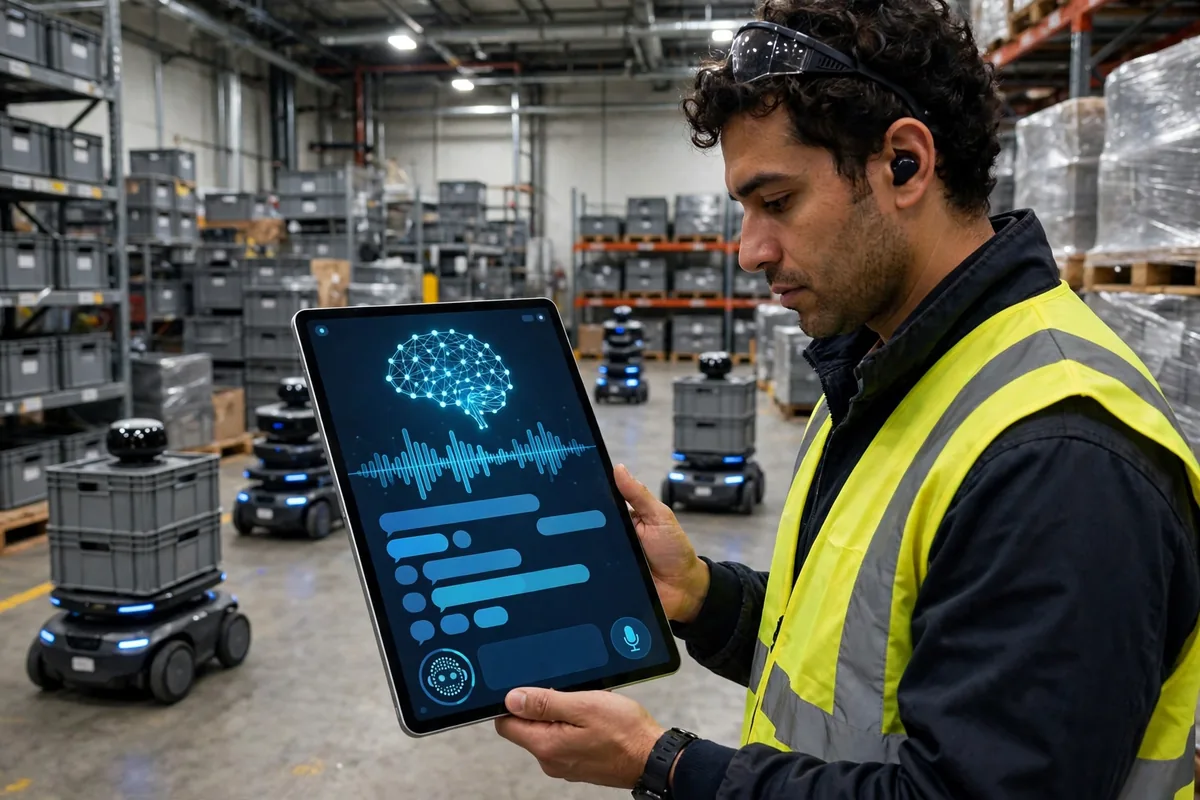
第一段階は、質問に答えるアシスタントである。作業員が電話やタブレットで、明日の朝に出荷する荷物がどこにあるかを尋ねると、システムは倉庫管理システムで場所を調べ、平易な言葉で答える。ここでの障壁は低い。何も実行されないからである。システムが触れるのは情報だけである。2024年の秋、私はカリフォルニア州オンタリオ近郊のサードパーティ倉庫で、この種のパイロットを見た。夜勤のスーパーバイザーが、朝に出荷予定のバッチがどこに保管されているかを音声で尋ねると、システムはWMSから場所を読み上げた。パイロットは六週間続き、スーパーバイザーの評価は実務的だった。時間は節約できた、と彼は言った。ただし、場所のデータがもともと正確な場合に限る、と。データが間違っていると、流暢な答えは、間違った答えをより速く届けるだけだった。
第二段階はコパイロットである。ただ答えるのをやめ、人の判断を助け始める。今回の波でどの注文をピッキングするか、今日の入荷計画からどのゾーンが詰まりそうか、あるいは次のシフトへの引き継ぎメモの下書きか。この段階はプロセスに触れる。プロセスに触れれば、責任の問題がついてくる。提案が間違っていたら、誰が責任を負うのか。システムは自分の確信度を示すのか。デモではこうした質問は決して示されない。実際の現場では毎日提起される。
第三段階は自律的な実行である。システムが補充、移動、波の変更を自ら決定し、人は例外をレビューする。最も現実に近い形は、完全な自動化ではなく、狭い範囲の自律性である。一つの商品ファミリー、一つのゾーン、一つのシフトの範囲内での権限であり、その範囲外のものはすべて人に返される。この段階を一夜にしての乗っ取りとみなすのは、倉庫の仕組みを誤解している。
飛ばすことはできない。質問に答えるアシスタントが確実に動かない倉庫では、コパイロットはその誤りを増幅するだけである。誰もレビューせず、誰も訂正しないコパイロットの提案は、自律的な実行へと育たない。各段階は、より広い範囲を与えられる前に、小規模でレビュー可能な結果を出さなければならない。
生成AIとお金の問題
研究者は、技術をヘッドラインではなく帳簿で見る。生成AIの帳簿には三つの項目があり、それぞれの前提を率直に述べておかなければ、数字は何の意味も持たない。
以下の表は仮の例である。すべての数字は方法を示すために作られたものであり、実在する倉庫の帳簿から取ったものではない。
| コストまたは利益 | 仮の例 | 確認方法 |
|---|---|---|
| 質問応答パイロット | 統合と三か月の試行を含め、約$60,000 | ベンダーの見積もりを一行ずつ確認する |
| 検索にかかるスーパーバイザーの時間の節約 | 毎日40分、時給$28と仮定する | 二週間分の時間記録を測定する |
| コパイロット段階の追加支出 | プロセス変更を含め、さらに$120,000と仮定する | ソフトウェア、統合、トレーニングに分ける |
| 波あたりの追加処理能力 | 一日あたり90件の注文増と仮定する | 実施前後で同じ時間帯の出荷量を比較する |
| 誤った回答の修正コスト | 修正作業に月$2,000と仮定する | 実際の修正チケットを数える |
計算の前に、あえて逆説的な判断を述べておく価値がある。倉庫における生成AIの最も過大評価されている利点は人員削減であり、最も過小評価されているのは手直し作業の減少である。質問に答えるアシスタントは役割をなくさない。スーパーバイザーの集中を断ち切る毎日四十回の割り込みをなくすのである。優れたコパイロットの提案が価値を持つのは、速いからではなく、経験豊富な作業員なら一目で気づくミスを新人が犯すのを防ぐからである。人員削減を前提に組まれたビジネスケースは、署名したその日に間違っている。
タイムラインにも同じ自制が必要である。質問応答アシスタントの段階は、ほとんどの中規模倉庫で一年以内に使えるパイロットに到達できる。コパイロットの段階は、まずクリーンなプロセスデータを必要とし、その準備はモデル自体の作業よりも長くかかることが多い。自律的な実行は、まず、強固なデータ基盤と安定した商品範囲を持つ少数の倉庫にのみ現れ、狭い範囲から始まる。三つの段階すべてを一年に押し込めるロードマップには、一つの質問を投げかけるべきである。計画のどこにデータ準備の作業があるのか、と。
生成AIが現場でまだできないこと
第一の障壁はデータである。倉庫のデータはWMS、ERP、スプレッドシート、経験豊富なスタッフの頭の中にあり、同じ商品でも三つのシステムで三つの異なる名前を持つことがある。生成AIは、汚いデータに対する耐性が人よりもはるかに低い。誤った場所を見た人は、経験からそれを訂正する。モデルは、誤った答えを自信を持って述べる。データガバナンスを迂回する近道はなく、それを省いた倉庫はパイロットの最中に代償を払う。
第二の障壁は責任である。コパイロットが提案し、システムが実行するとき、ミスの責任を誰が負うのかという問題は、インシデントの後に議論するのではなく、稼働前にプロセスに書き込んでおかなければならない。より堅実なアプローチは段階的な権限である。日常的な低リスクの提案は自動的に実行でき、高リスクの行動には人の確認が必要であり、自動化されたすべての意思決定は、追跡、レビュー、停止ができる記録を残す。
第三の障壁は現場での受け入れである。最前線の作業員は、新しいツールを一つのテストで判断する。役に立つか、邪魔になるか。質問応答アシスタントが十回に二回役に立たない答えを出せば、作業員は三回目には尋ねるのをやめる。パイロットの最中に最も重要な数字はデモのスコアではなく、実際の使用回数と回避策の回数である。その二つの数字は、どんな満足度調査よりも正直である。
まとめると、順序は明確である。質問に答えるアシスタントを、作業員が本当に使うほど確かなものにする。コパイロットを一つか二つの具体的なシナリオに置き、提案がレビューできるようになるまで動かす。自律的な実行について語るのは、データ、責任、信頼のすべてが揃ってからにすること。その順序は遅いが、倉庫の中で機能する唯一の順序である。
三年後を見据えると、倉庫における生成AI技術の最も可能性の高い姿は、話すロボットではなく、目に見えない支援の層である。WMSの検索ボックスの中に、波の計画提案の中に、引き継ぎメモの中に。倉庫がそれを本当に使っているかどうかを判断するには、ローンチイベントを飛ばして二つのことを確認すること。作業員が毎日実際に質問しているか、そしてスーパーバイザーがシフトや波を計画するときに実際にその提案を参考にしているか。両方の答えがイエスなら、第三段階はそう遠くない。どちらかの答えがノーなら、正直な問いは、何がまだ足りないのかであり、その答えは通常、データ、責任、信頼のいずれかである。
Dr. Chen(サプライチェーン研究者)著 英語版からの翻訳。内容に相違がある場合は英語版を優先します。