20,000のSKUを扱う返品倉庫を想像してください。従来のコンピュータービジョンの流儀では、SKUあたり500枚の学習画像を撮影します。合計10 millionです。計算はお任せください——この道はどこにも通じていません。
最近、few-shot learningについて質問するオペレーターが増えています。売り文句はいつも同じです。「SKUが多すぎて従来の学習ができません。few-shotなら製品あたり数枚の画像でいいと聞きましたが、これが抜け道ですか?」私の答えもいつも同じです。はい、抜け道です——使いどころの約半分に限っては。残りの半分には、ドアすら通れません。今日はその線引きをします。
Few-shotを一言で説明
従来の深層学習は暗記します。各SKUがどう見えるかをゼロから学習しなければならず、製品あたり数百〜数千枚の画像を食わせる必要があります。Few-shot learningは代わりに「いとこ同士の似顔」を見分けます。基盤モデルはすでに数千万枚の画像を見て、形・色・質感の一般的な文法を学習しています。各SKUの写真を3〜5枚見せれば、類似度で製品を識別します——教科書を暗唱するというより、いとこを見分けるようなものです。
これは新しい科学ではありません。研究者は何年も前から取り組んでいます。公開データセットSKU-110Kには11,743枚の画像、1.7 million超のアノテーション付きボックス、110,000超のユニークSKUが収録され(CVPR 2019)、2024年の論文では単一プロトタイプ画像からのone-shot SKU分類が実現されました。変わったのは、ここ数年で基盤モデルが十分に強くなり、実際に導入できるようになったことです。技術は準備できていました。足りなかったのは、オペレーターが「どこで使うべきか」を知ることでした。
Few-shotで十分な場面
私のテストはシンプルです。質問は二つだけ。「どれだけ間違いを許せるか」と「SKUカタログがどれだけ速く入れ替わるか」です。
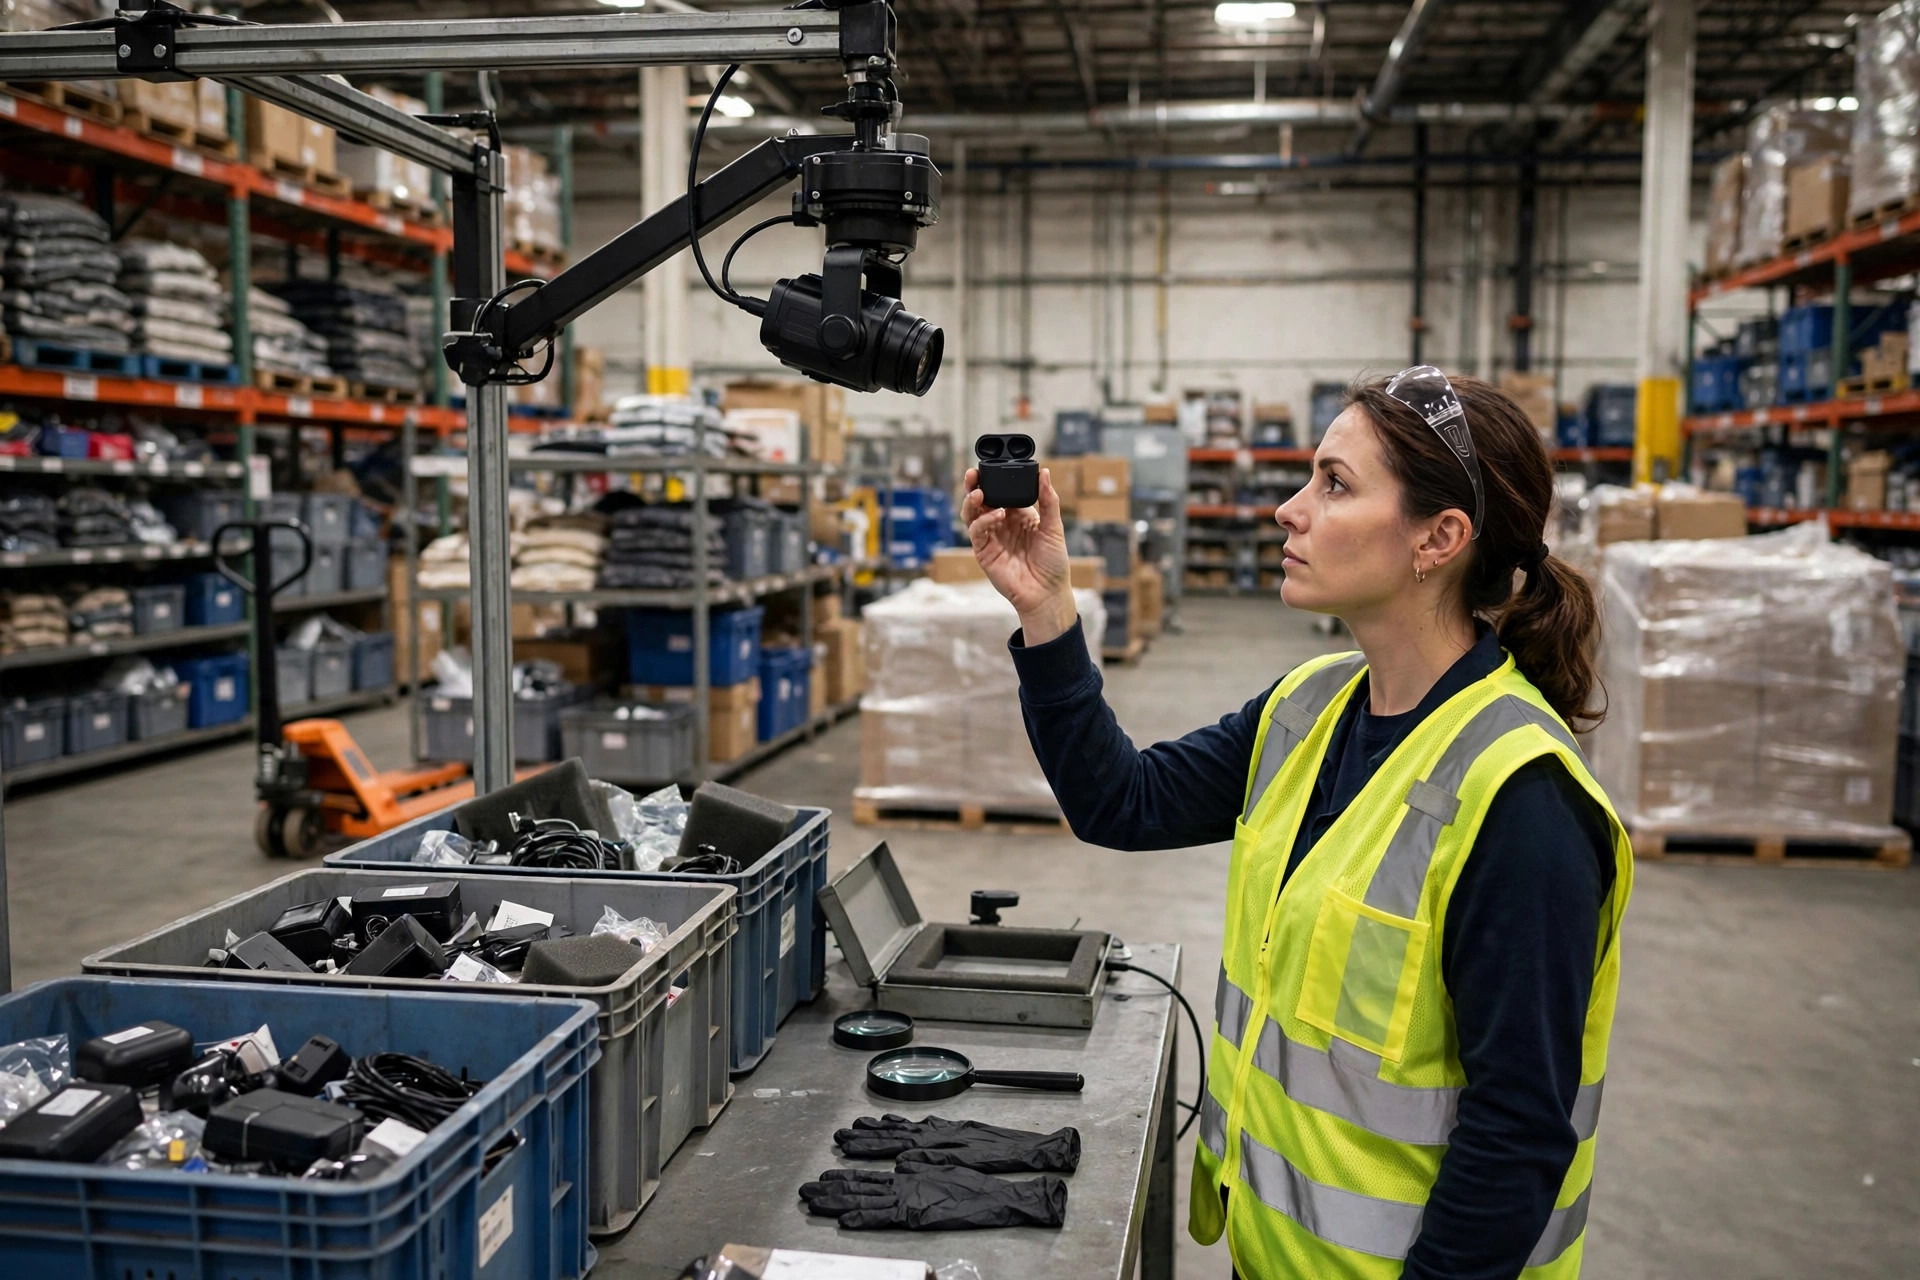
返品検査が、これまで見た中で最高のフィットです。返品はごちゃ混ぜのロングテールです——年間数十個しか売れないSKUが山ほどあり、そんな商品のために数百枚の学習画像を集めることなどあり得ません。検査員がカメラの前に商品をかざすと、システムがSKUを識別して商品レコードを引き当て、検査員が目視で確認します。間違えたら?人が修正し、その画像が新たなサンプルとして戻ってきて、次はもっと賢くなります。
もう一つのフィットは、「セカンドオピニオン」としての目視仕分けです。バーコードのないバラ物が山積みの越境倉庫や、ラベルが斜めに貼られてスキャンできないカートンを想像してください。Few-shotビジョンが候補を提示し、最終判断は人かバーコードスキャンが行います。「候補」という言葉に注目してください——提案はしますが、決定はしません。
これらの現場に共通するのは、低速・低ボリューム、そしてモデルの背後にいる「人のセーフティネット」です。SKUが多いほど各SKUのサンプルは少なく、テールは長くなり、few-shotの優位は大きくなります。こうした場面では、従来のアプローチは高いだけでなく、そもそも成立しません。年間30個しか動かないロングテールSKUのために500枚の写真を撮る人はいません。
避けるべき場面
まず明らかなものから。高速仕分けです。毎分数百箱をさばくソーターには極めて高い認識精度が求められ(自前のデータで検証してください)、各SKUの写真を3枚しか見ていないモデルには無理です。高速ラインで誠実なアプローチは、大規模なフルラベル学習か、ビジョン自体を捨ててバーコード+重量・寸法センサーに寄せることです。ラインが速いほど、few-shotが息をつく余地は小さくなります。これは物理であり、チューニングの問題ではありません。
二つ目の罠。そっくりなSKUです。同じブランドラインのシャンプー2種、パッケージは同じで、違いは小さな文字で印刷されたボトルサイズだけ——ここは「いとこ同士の見分け」が最も苦手とする場面そのものです。あるチームがここで何ヶ月も燃え尽きるのを見ました。モデルは自信満々で誤識別し、人が全品を再チェックし、ラインは完全手作業より遅くなり、ハードウェアのコストだけが残りました。
三つ目。撮影条件が安定しない場所です。倉庫の現場は実験室ではありません。コンベヤ上のカメラ、ちらつく照明、傾いたカートン——精度は崖から落ちます。SKUあたり数枚のサンプルしかないのに、1枚のブレた写真が学習データの5分の1を汚染しかねません。皮肉なことに、few-shotはフル学習よりも厳格な撮影規律を要求します。そこで導入の話に移ります。
導入:4つのステップ
ステップ1。基盤モデルを選び、ゼロから学習しないこと。オープンも商用も、ビジョン基盤モデルは十分に実力があります。本当に問うべきは、汎用ベンチマークの順位ではなく「自社の商品画像でどれだけ性能が出るか」です。自社の商品を2週間通して、top-1精度を自分で測ってください。ベンダーのスライドを信じないこと。誠実な2週間のテストは、6ヶ月の手戻りより安いです。
ステップ2。撮影スペックを固定すること。プロジェクト全体で最も過小評価される部分です。カメラ位置固定、照明固定、背景固定、SKUあたり3〜5アングル。1枚1枚が命です。スペックを印刷してラミネートし、検査台に貼ってください。シフト交代も新人も生き延びます。
ステップ3。バッドケース・ループを作ること。モデルが間違えたもの・低信頼度でフラグしたものはすべてレビューキューへ。人が正しいラベルを確認したら、その画像が新たなサンプルとして戻ります。このループが回り始めれば、モデルは複利で成長します——使うほど賢くなるのです。従来の学習に対するfew-shot最大の運用上の強みはここです。新SKUの追加は、数枚の写真を撮って数分で本番投入。データセットを集めて再学習する必要はありません。
ステップ4。人をループに残すこと、恒久的に。信頼度の閾値を下回るものはすべて人の目視レビューへ。この項目は任意ではありません。倉庫では、AIの最適な席はいつも副操縦士です。ハンドルは人が握り続けます。
計算:3つのアプローチを並べる
まずフルラベル学習。業界の料金ガイドでは、基本的な画像分類のアノテーションは1枚あたり$0.03〜$0.10程度(basic.aiのラベリングコストガイドより)。安く聞こえますが——収集を数えてください。撮影、整理、QA、バージョン管理、すべて人の手作業です。20,000 SKU × 500枚 = 10 million。その人件費の請求書は中規模オペレーションを押しつぶします。フル学習が成立するのは、SKUが少なく、安定し、精度要求が極端な場合だけです。
few-shotのルート:SKUあたり3〜5枚なら、20,000 SKUが60,000〜100,000枚に——2桁少なくなります。アノテーションコストはほぼ消えます。撮影時に自然にラベル付けされるからです。本当の支出は前倒しの作業です。基盤モデルの検証と撮影スペックの徹底。一回きりの投資で、複利のリターンです。
そして皆が忘れる三つ目のルート。バーコードとルールです。自社製品にまともなバーコードが付いているなら、ただスキャンしてください——ビジョンは純粋なオーバーヘッドです。クライアントへの私の定番の助言:「スキャナーで解決できるならビジョンを作るな。ルールで解決できるなら学習を作るな。AIはオペレーションを直せません。SKUマスタがぐちゃぐちゃでラベルが斜めに貼られるなら、AIの話の前にプロセスを直してください。この順序は譲れません。」
返品が独自セクションに値する理由
NRFとHappy Returnsによると、2024年の米国小売の返品は$890 billionの見込み——小売業者の年間売上の16.9%です。返品エリアはどんな倉庫でも最も混沌とした一角です。最もワイルドなSKU構成、最も高コストな人件費、最も標準化されていないプロセス。検査員は商品を識別し、状態を判定し、再販在庫に戻すか廃棄するかを決めなければなりません。この3つの仕事のうち、識別こそがfew-shotビジョンの真価を発揮する場です。返品の品揃えは本質的にロングテールだからです。
盛り上がる前に警告を一つ。SKUの識別は検査の仕事の半分にすぎません。状態の判定——新品、軽度の使用感、損傷——は、ベンダーが何と言おうと、今のfew-shotモデルが安定的にこなせる範囲を超えています。まずSKU認識をやり、状態の格付けは人に残し、2段階で進めてください。一度に全部飲み込もうとしないこと。
明日できること
返品検査台があるなら、午後一つの実験をどうぞ。最も返品の多いSKUを50品番選び、各5アングルを撮影して、オープンなビジョン基盤モデルに類似検索テストとして通してください。top-1精度を確認します。コストはほぼゼロ、午後一つで終わり、ベンダーの売り文句では決して得られないことが分かります。この道が自社のオペレーションにとって実際にどこかに通じる道なのか。データに語らせましょう。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。