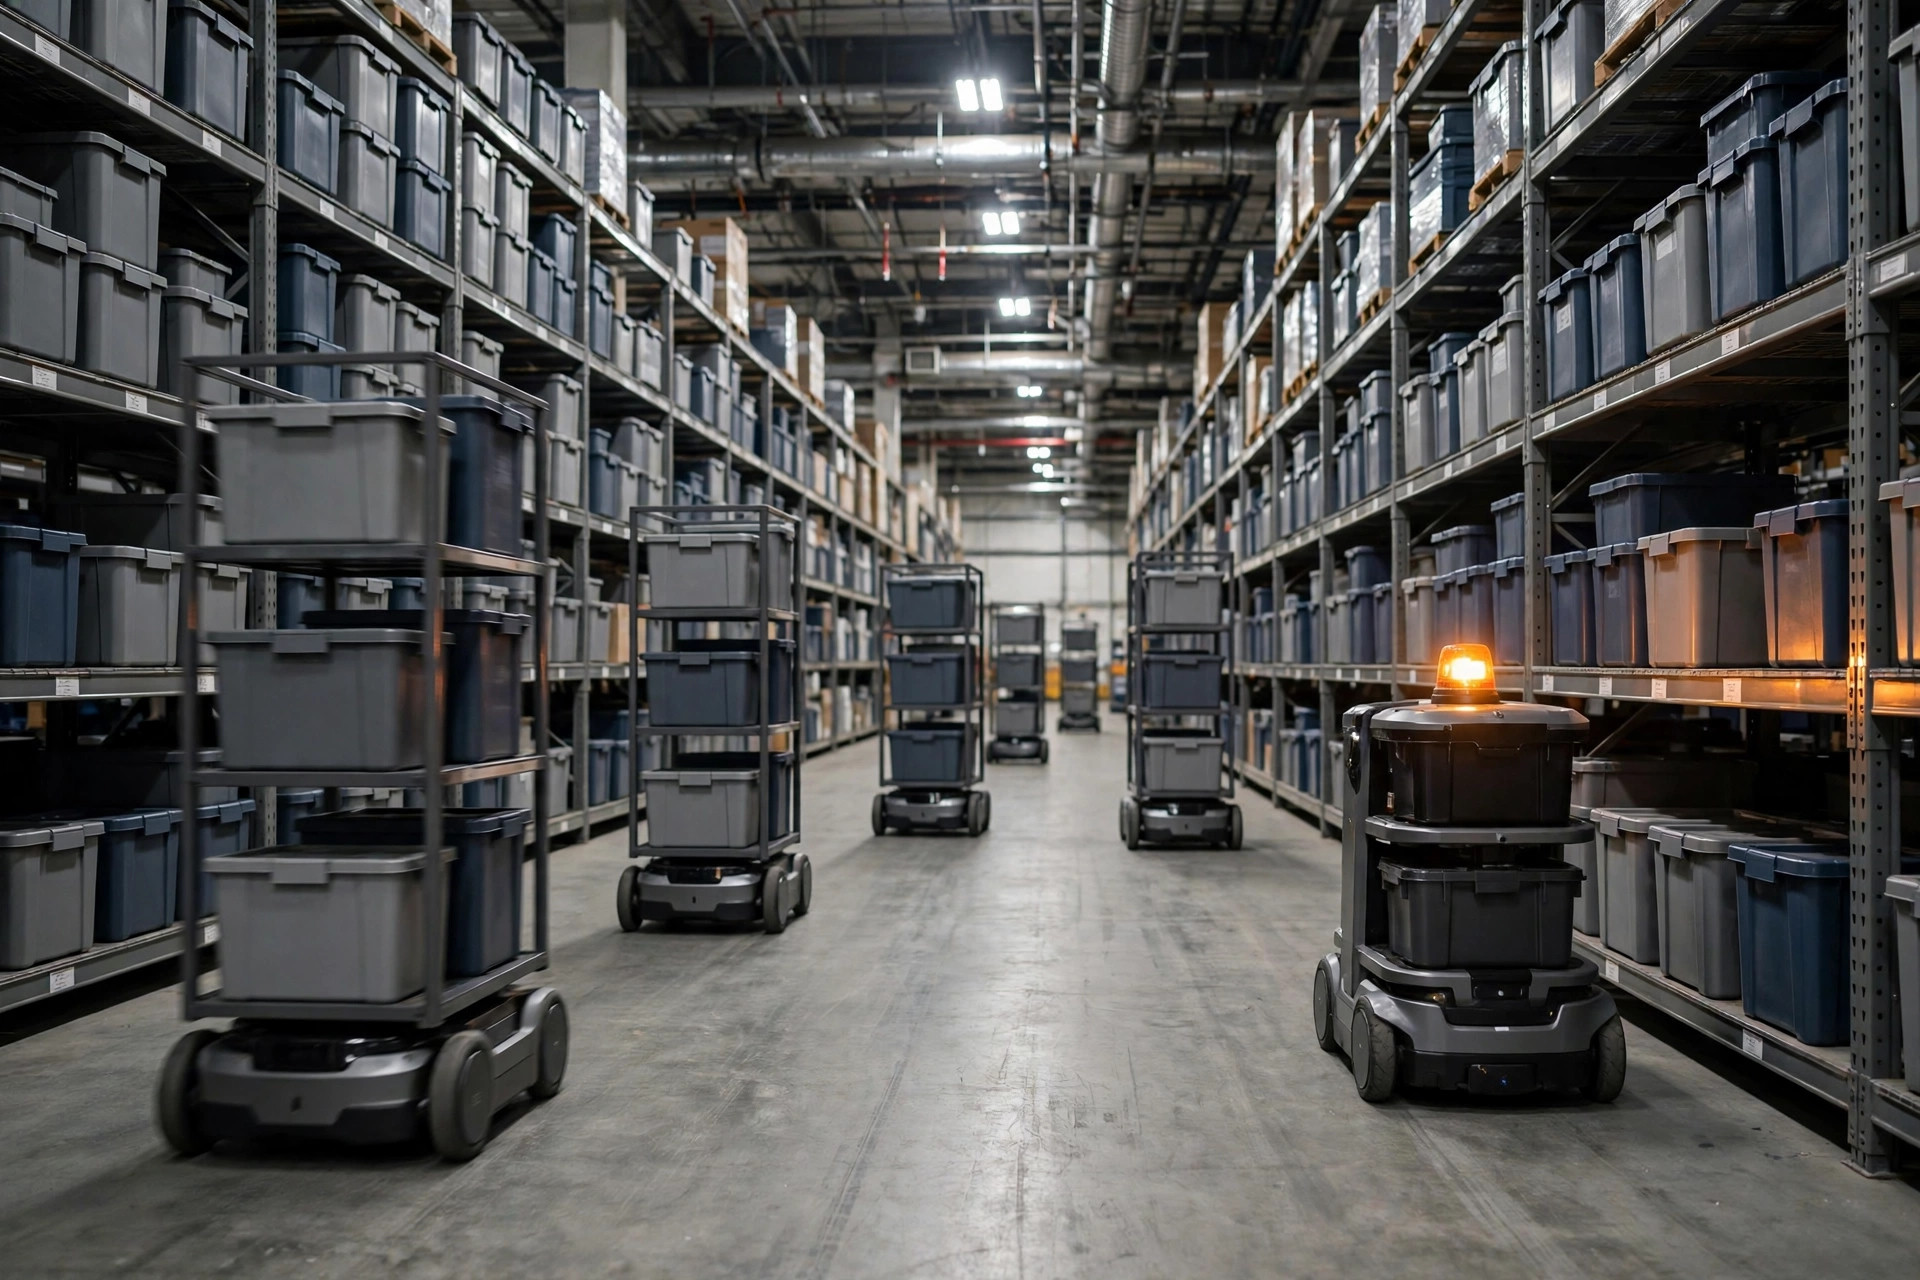
去年の8月、中国東部の3C系EC倉庫でフォローアップ訪問をしていた。棚運搬型AMRが40台、休むことなく動いていた。午前10時、サーバールームのエアコンが壊れ、フリート管理サーバが過熱して再起動した——教科書通りの単一障害点だ。15分間、指令が一切出なかった。すべてのロボットが保護停止を発動して凍りついた。午前波の出荷は2時間近く遅れた。
事後検証は謙虚にさせられた。サーバ自体は無事で、再起動で直ったのだ。しかしその15分間が真実を突きつけた——この「インテリジェント」なシステムにおいて、単一障害点は一番つまらない場所に隠れていた。本記事ではAMRの単一障害点を3つの層に分けて解説する——どこに潜み、どう固め、どこで線を引くのか。さらに検収時にわざとシステムを壊す方法も紹介する。開示:以下の引用なしの数値はプロジェクト後の私の推定値である。桁は合っているが、入札書には転記しないこと。
AMRの単一障害点は実際にどこに潜んでいるか
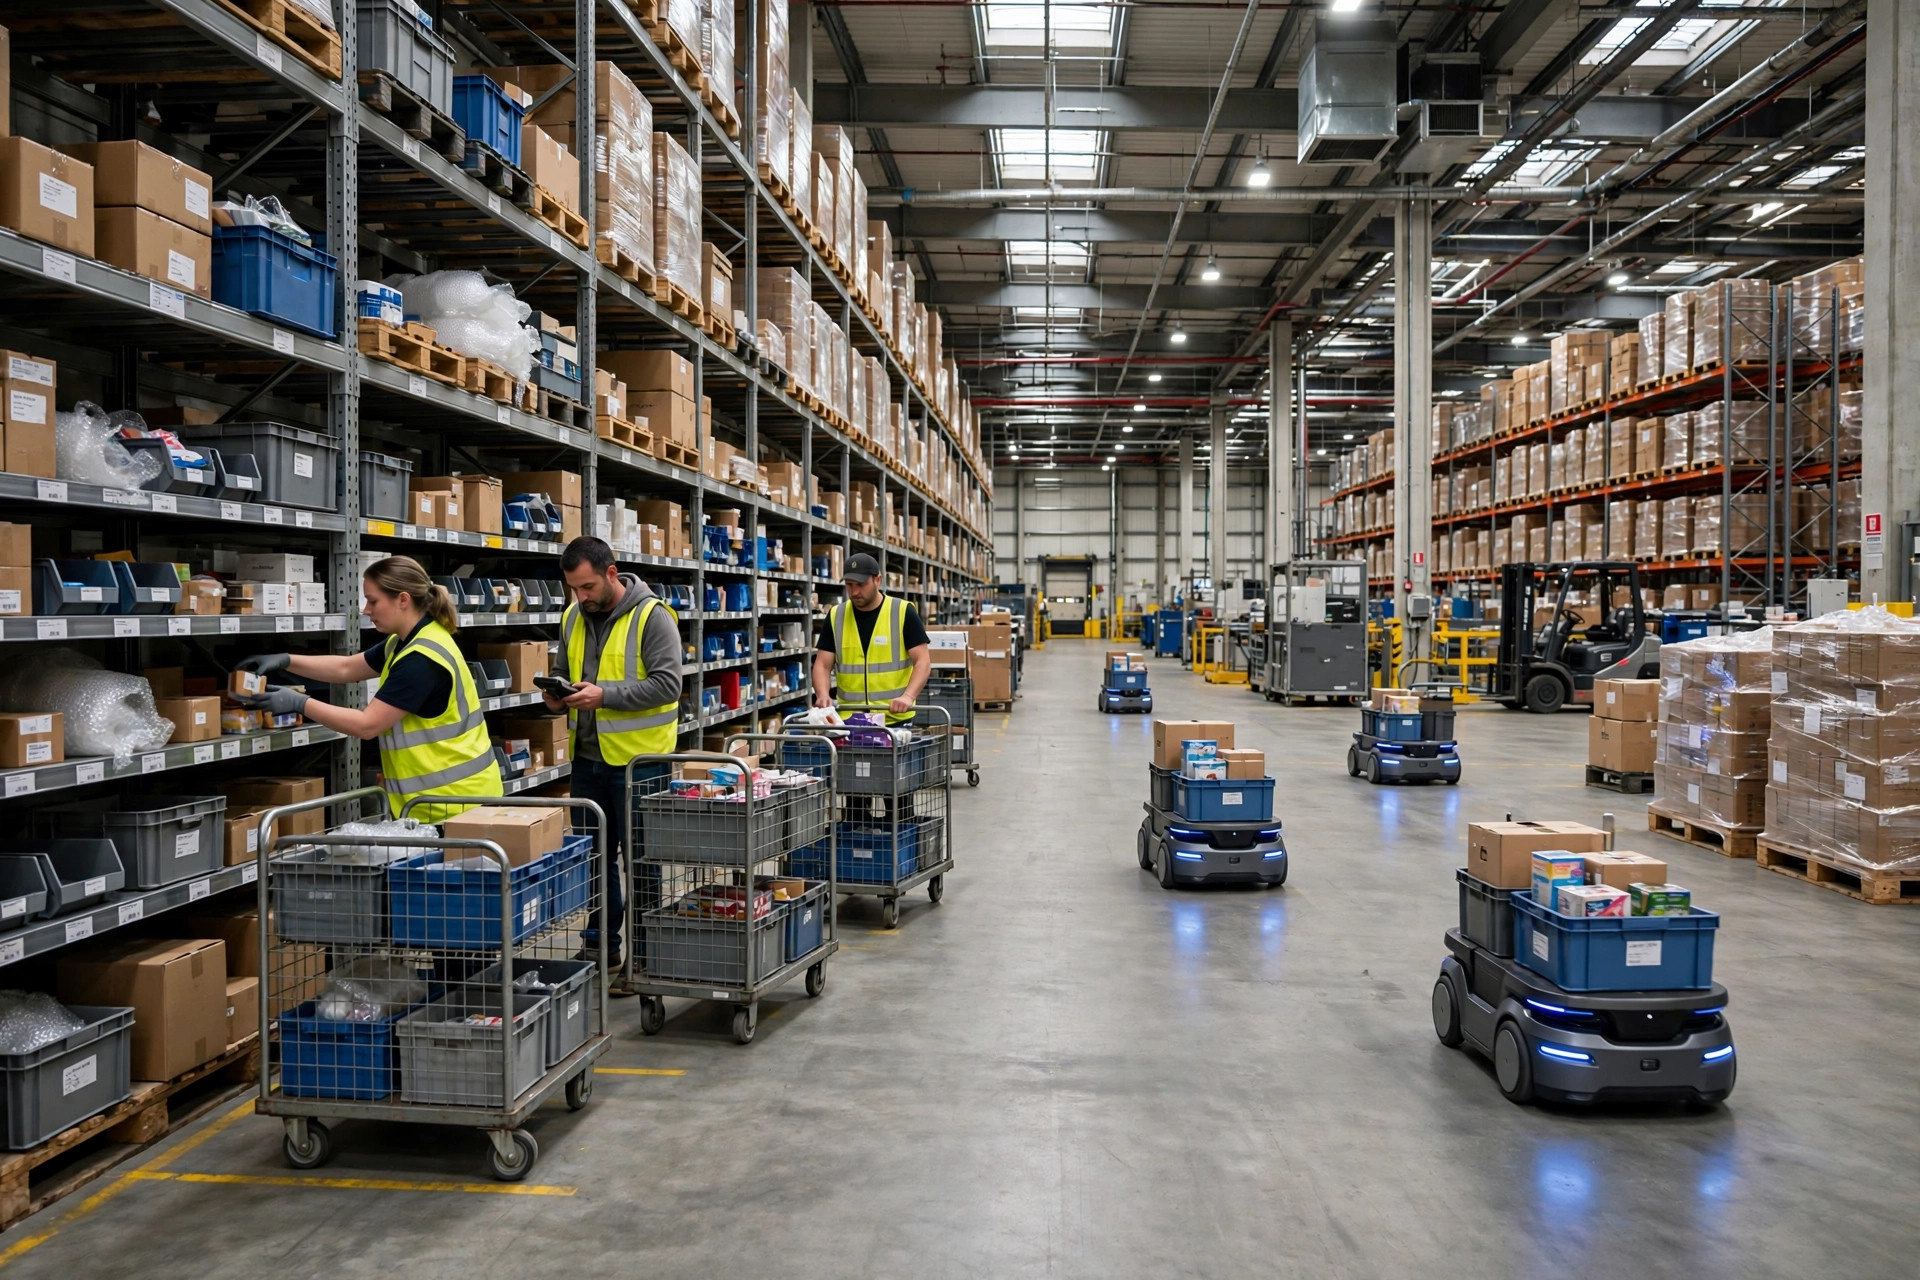
都市の交通にたとえて考えよう。AMRフリートは車の流れ、フリート管理システム(FMS)は信号制御センター、Wi-Fiネットワークはすべての運転手の手にある無線機だ。都市を麻痺させるのは決して1台の故障車ではなく、この3つのうちどれかが壊れることだ。
第1層:個々の車両。 1台のロボットがダウンする——バッテリーの過放電、lidarの汚れ、駆動輪への異物の挟み込み。最も一般的で、最も危険度が低い。40台のフリートで1台ダウンはスループットの2.5%だ。
第2層:指令系。 FMSサーバがクラッシュする、スケジューリングソフトにバグが出る、データベースがデッドロックする。1台のサーバがつまずけばフリート全体が耳を失う——あの15分間の停止はこの層だった。真の単一障害点:1台の機械がすべてを指揮していること。
第3層:ネットワーク。 アクセスポイントが死ぬ、ローミングが失敗する、デッドゾーンが生まれる。ロボットは指令系との通信を失い、「リンク喪失」ポリシーを実行する——多くの場合、幹線通路のど真ん中でその場停止する。
3つの層のうち、90%のプロジェクトは金を第1層に注ぎ込む——高性能なロボット、多くのセンサ——一方で第2層と第3層には残り物が回る。だから事故が起きるたびにフロア全体のシャットダウンになる。金が間違った層に行ったのだ。
3層の冗長化:金を使うべき場所
まず原則、次に線引きだ。バックアップが多いほど自動的に良いわけではない——正しい層に金を使うことが大事だ。
車両のバックアップとは予備ロボットであり、予備部品ではない。 正しいアプローチはN+1だ。40台のフリートなら、ホットスペアとして1〜2台多く買っておく。ロボットが死ねば引きずり出し、スペアが引き継ぎ、スループットは落ちない。線引き:2シフトの24時間稼働ならN+1は必須。日勤1シフトなら拠点間でスペアプールを共有するか、見送ってもよい。正午に死んだロボットは夕方までに直ればよい。
ここで1つ、偽要件を指摘しておく。一部のベンダーは「デュアルlidar、デュアルバッテリー」を売り込み、ロボット価格を30%つり上げる。それは工学ではなくベンダーへの寄付だ。主流の産業用AMRのベンダー公称MTBFは5,000時間を超えている。指令系の1つのつまずきでフリート全体がどうせ死ぬのに、単体故障を年数回から年1〜2回に減らすために30%のプレミアムを払うのは無意味だ。その金は第2層に回せ。
指令系のバックアップ——アクティブ・スタンバイサーバ——は命を守る金だ。 FMSサーバを2台——1台がアクティブ、1台がスタンバイ——ハートビート監視と自動フェイルオーバ付き。双発機を想像してほしい——エンジンが1つ死んでも飛び続けられる。線引きはフェイルオーバ時間だ。ロボットの「リンク喪失保護停止」閾値を下回らなければならない、ベンダーによるが通常5〜10秒(現場経験——この数値を要求し、技術合意書に書き込め)。30秒以内のフェイルオーバは合格。1分を超えたらバックアップなしと同じ——ロボットは自ら停止してしまい、スタンバイサーバが引き継ぐのは1台ずつ手動で復旧しなければならない死体のフロアだ。
ネットワークのバックアップとはAPカバレッジの重なりだ。 すべてのゾーンは少なくとも2つのアクセスポイントの届く範囲に入っていなければならず、1つのAPが死んだら隣が負荷を引き継ぐ。線引き:APが1台ダウンした状態で、隣がそのゾーンの少なくとも90%をカバーし、ローミングハンドオフは1秒未満でなければならない。これらの数値を出せない「デュアルAP設計」は飾りだ。
典型的な40台フリートの3段階コスト(パーセンテージは私の経験値の範囲):
| 段階 | 追加コスト(プロジェクトの%) | 複雑さ | 典型的な復旧時間 | 向いているところ |
|---|---|---|---|---|
| ベーシック:FMS単体+AP単体+予備ロボットなし | +0% | 低い | 手動復旧、30分〜2時間 | 停止できる単一シフトの小規模倉庫 |
| スタンダード:FMSアクティブ・スタンバイ+APカバレッジ重複+予備ロボット1台 | +8%〜12% | 中 | 30秒以内のフェイルオーバ、単体ロボット故障は10分でカバー | ほとんどの24時間倉庫 |
| 高可用性:FMSアクティブ・アクティブ+デュアルバンドネットワーク+10%の予備プール | +20%〜30% | 高 | 秒単位のフェイルオーバ、スループットはほぼ落ちない | 医薬、自動車——ライン停止がペナルティになる現場 |
形が見えただろうか?ベーシックからスタンダードへは約10%の追加コストで、復旧は数時間から数分に短縮される——ここがドル当たりの価値が最も高い。高可用性は、停止1分が本物の金になる現場のためのものだ。普通のEC倉庫は近づくな。複雑さが跳ね返ってくる。
障害隔離:まず死んだロボットを交通網から引きずり出せ
バックアップはシステムを生かし続ける。障害隔離は、死んだ部分が生きている部分を巻き込まないようにする。高速道路の故障と同じだ。まずやるべきは車を路肩に引きずり出すことであり、走行車線で修理することではない。
適切な障害隔離チェーン:ロボットの自己診断が異常を検知する(バッテリー、自己位置の喪失、駆動系の故障)→3秒以内にFMSに報告→FMSがその道路区間を一時立入禁止ゾーンとしてマーク→死んだロボットの未完了タスクを健全なロボットに再割当て→人またはスペアロボットがけん引する。すべて自動で、人がやるのは最後のけん引だけだ。
逆の例も見てきた。2024年3月、中国北部の自動車部品倉庫で、APの電源モジュールが焼けた。そのゾーンの6台のロボットが5秒以上リンクを失い、保護停止した——うち2台は幹線通路の上だった。FMSの隔離ロジックにバグがあった。リンク喪失ロボットの位置データが10秒以上古いと古いものとして扱われ、迂回指令が出なかったのだ。健全な4台のロボットが「死体」の後ろに行列を作った。40分の手動片付け、倉庫の指令の半分が凍結した。
2つの教訓。第一に、隔離は最悪の位置を想定して設計せよ——死んだロボットは必ず最も重要な通路で止まるものと仮定する。第二に、最後に報告された位置をもとに迂回してはならない。立入禁止ゾーンは「最終既知位置+安全半径」から描け。迂回は遠回りしすぎるくらいがよく、突っ込むな。
次にグレースフルデグラデーション——障害隔離の後半だ。極端な例:フリートの30%が同時にダウンする(バッテリーの不良ロットは起きる)。システムは横たわってはいけない。自動的に縮退すべきだ。速度を1段階落とす、タスクを再優先付けする(出荷波を守り、入荷を後回しにする)、手動ピッキングゾーンを広げる。これをFMSにハードな閾値付きで事前設定する——「健全なロボットが70%を下回ったら自動的に縮退モードに入る」。午前3時に夜勤オペレータの即興に頼るな。
検収前に:外せない単一障害点ドリル
メンテナンスの落とし穴:設計書は立派だが、検収でわざとシステムを壊す勇気のある人は誰もいない。各ドリルを手動で実行せよ。1つでも失敗したらサインするな。
- 指令サーバの電源プラグを抜く。 スタンバイの切替えを計測し、集団保護停止がないか確認する。1分超えは不合格。
- 電源を切らずに指令プロセスを殺す。 ソフトウェアクラッシュをシミュレートする——ハートビート検知が「偽生存」のスプリットブレイン(プロセスは動いているがサービスは死んでいる)を捉えられるか検証する。
- APを1台電源オフする。 スムーズなローミングを確認し、リンク喪失停止がないか確認する。
- ランダムなロボットを非常停止する。 立入禁止ゾーンとタスク再割当ての時間を計測する。3分超えは隔離失敗。
- 充電列全体の電源を落とす。 低バッテリ指令ポリシーが持ちこたえるか確認する——ここで最も見落とされる項目だ。低バッテリーのロボットが充電に並び、電源がなく、集団で死ぬのを2回見てきた。
- フリートの30%がオフラインをシミュレートする。 縮退モードが自動で発動し、出荷波が生き残るか確認する。
各ドリルを記録せよ:発動時刻、復旧時刻、人の介入の有無。ベンダーが「弊社のラボでテスト済みです」と言ったら、返答はこうだ。あなたのロボット、うちのフロア、今すぐ。ラボでテストされた99.99%の可用性は、本物のラックとフォークリフトに出会った瞬間に少なくとも20%削れる。
最終会計だ。この金を使う価値があるかどうかは1つの数値に帰着する。あなたのピークシーズンにおける停止1時間のコスト。 ピーク時の時間当たり出荷量×注文当たり平均マージン、さらに遅延ペナルティと遊休人件費——中規模EC倉庫なら簡単に$3,000以上になる。スタンダード段階は約10%の追加コストだ。3年の減価償却で割れば1時間あたり数十ドルだ。1時間あたり数十ドルで、1時間あたり数千ドルの損失に備える——計算は自分でしてくれ。ただし、あなたの倉庫が1シフトで量もそこそこ、2時間の停止が午後の遅れで済むなら——ベーシックで十分だ。その予算は予備部品に回した方がよい。バックアップの支出は信念体系ではない。算術だ。
Da Liu(自動化エンジニア)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。