結論から言います。AIベンダーの契約にモデル劣化の条項がなければ、署名は考え直してください。受入テストの精度数値は、その日のその条件下でのみ真実でした。稼働開始後、劣化は「可能性」ではなく「物理法則」です。そして契約が沈黙しているなら、すべてのリスクを抱えるのはあなたです。
劣化はバグではない。デフォルトだ。
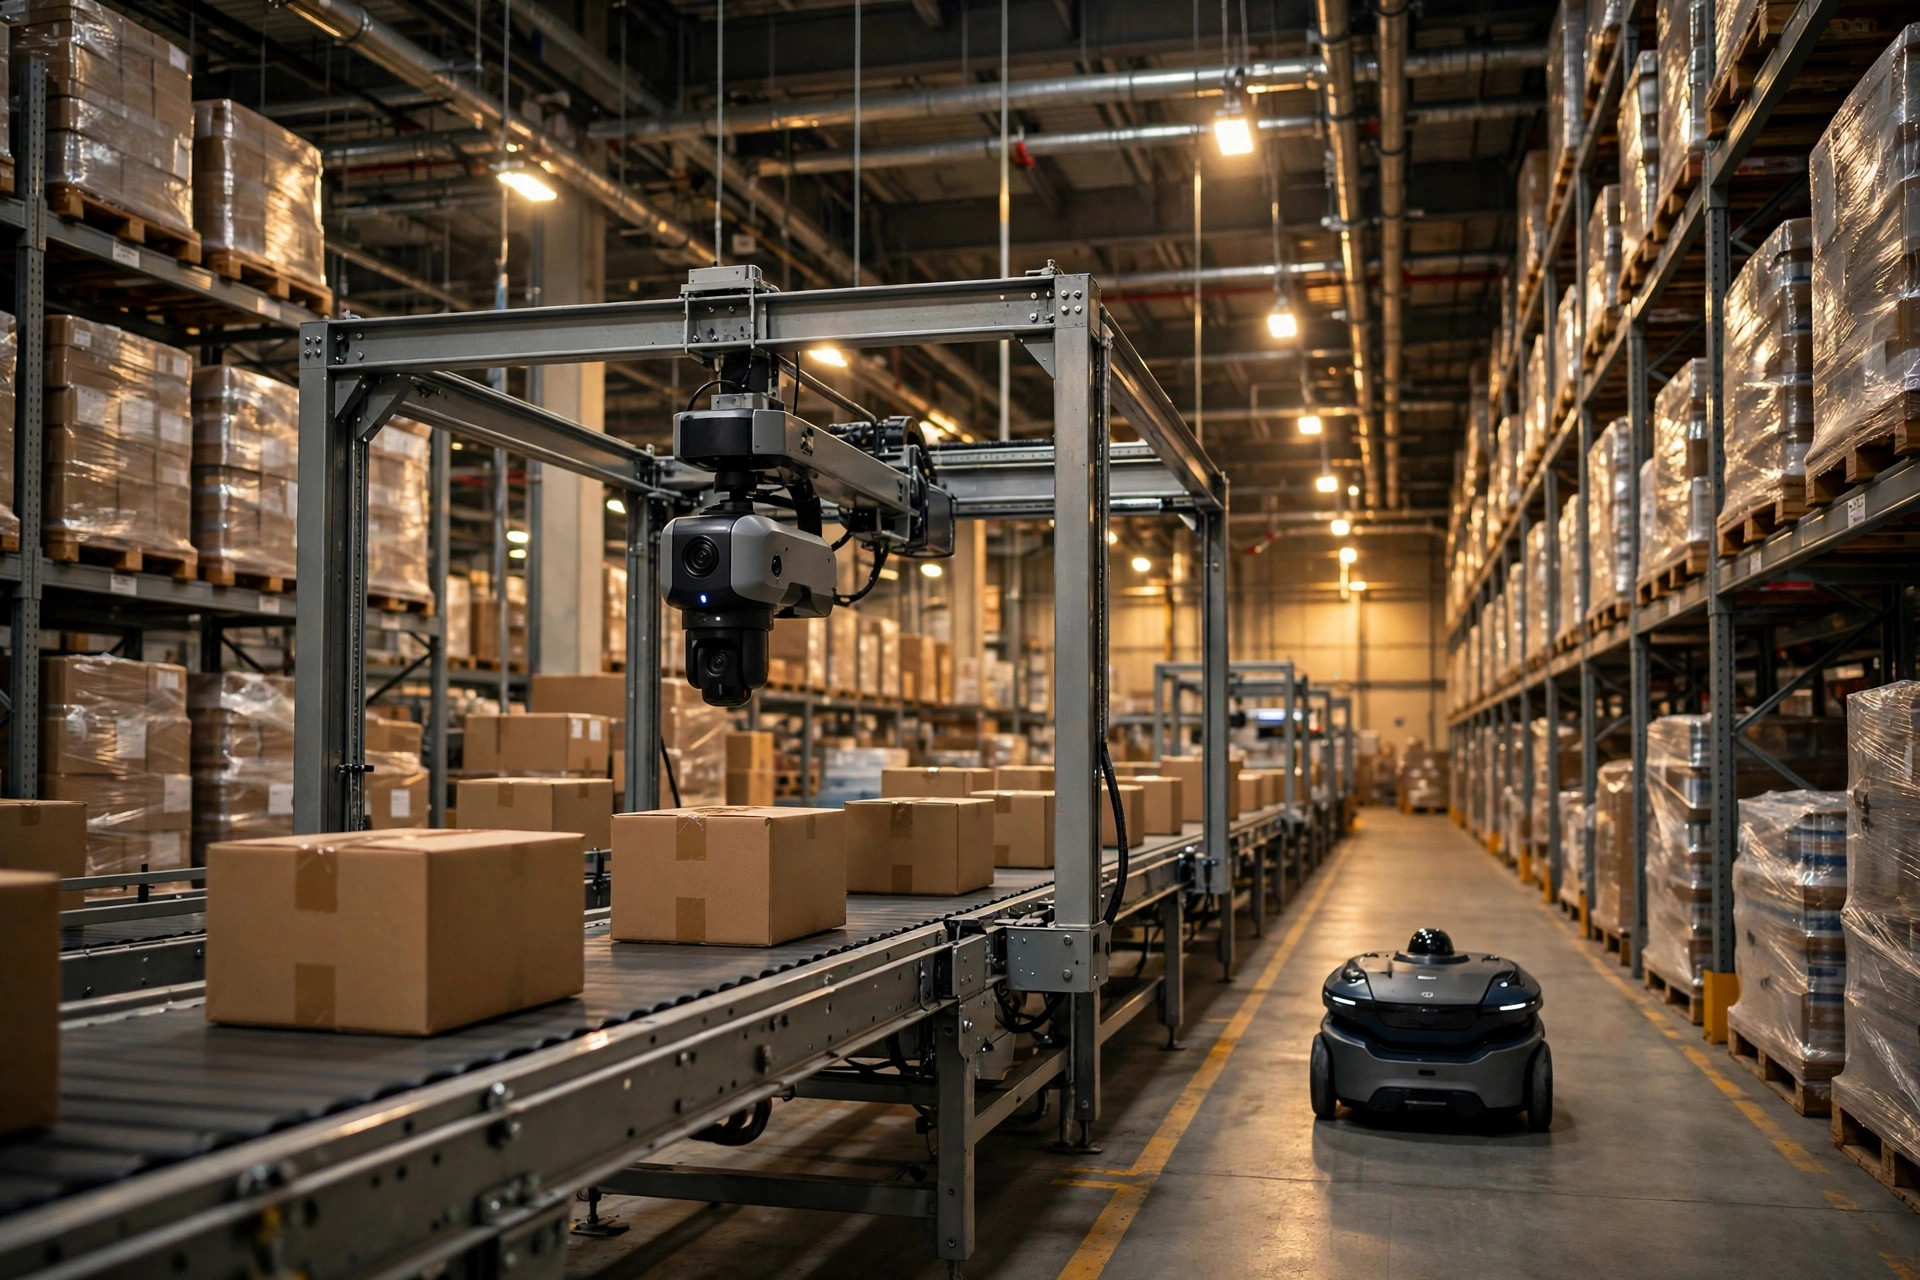
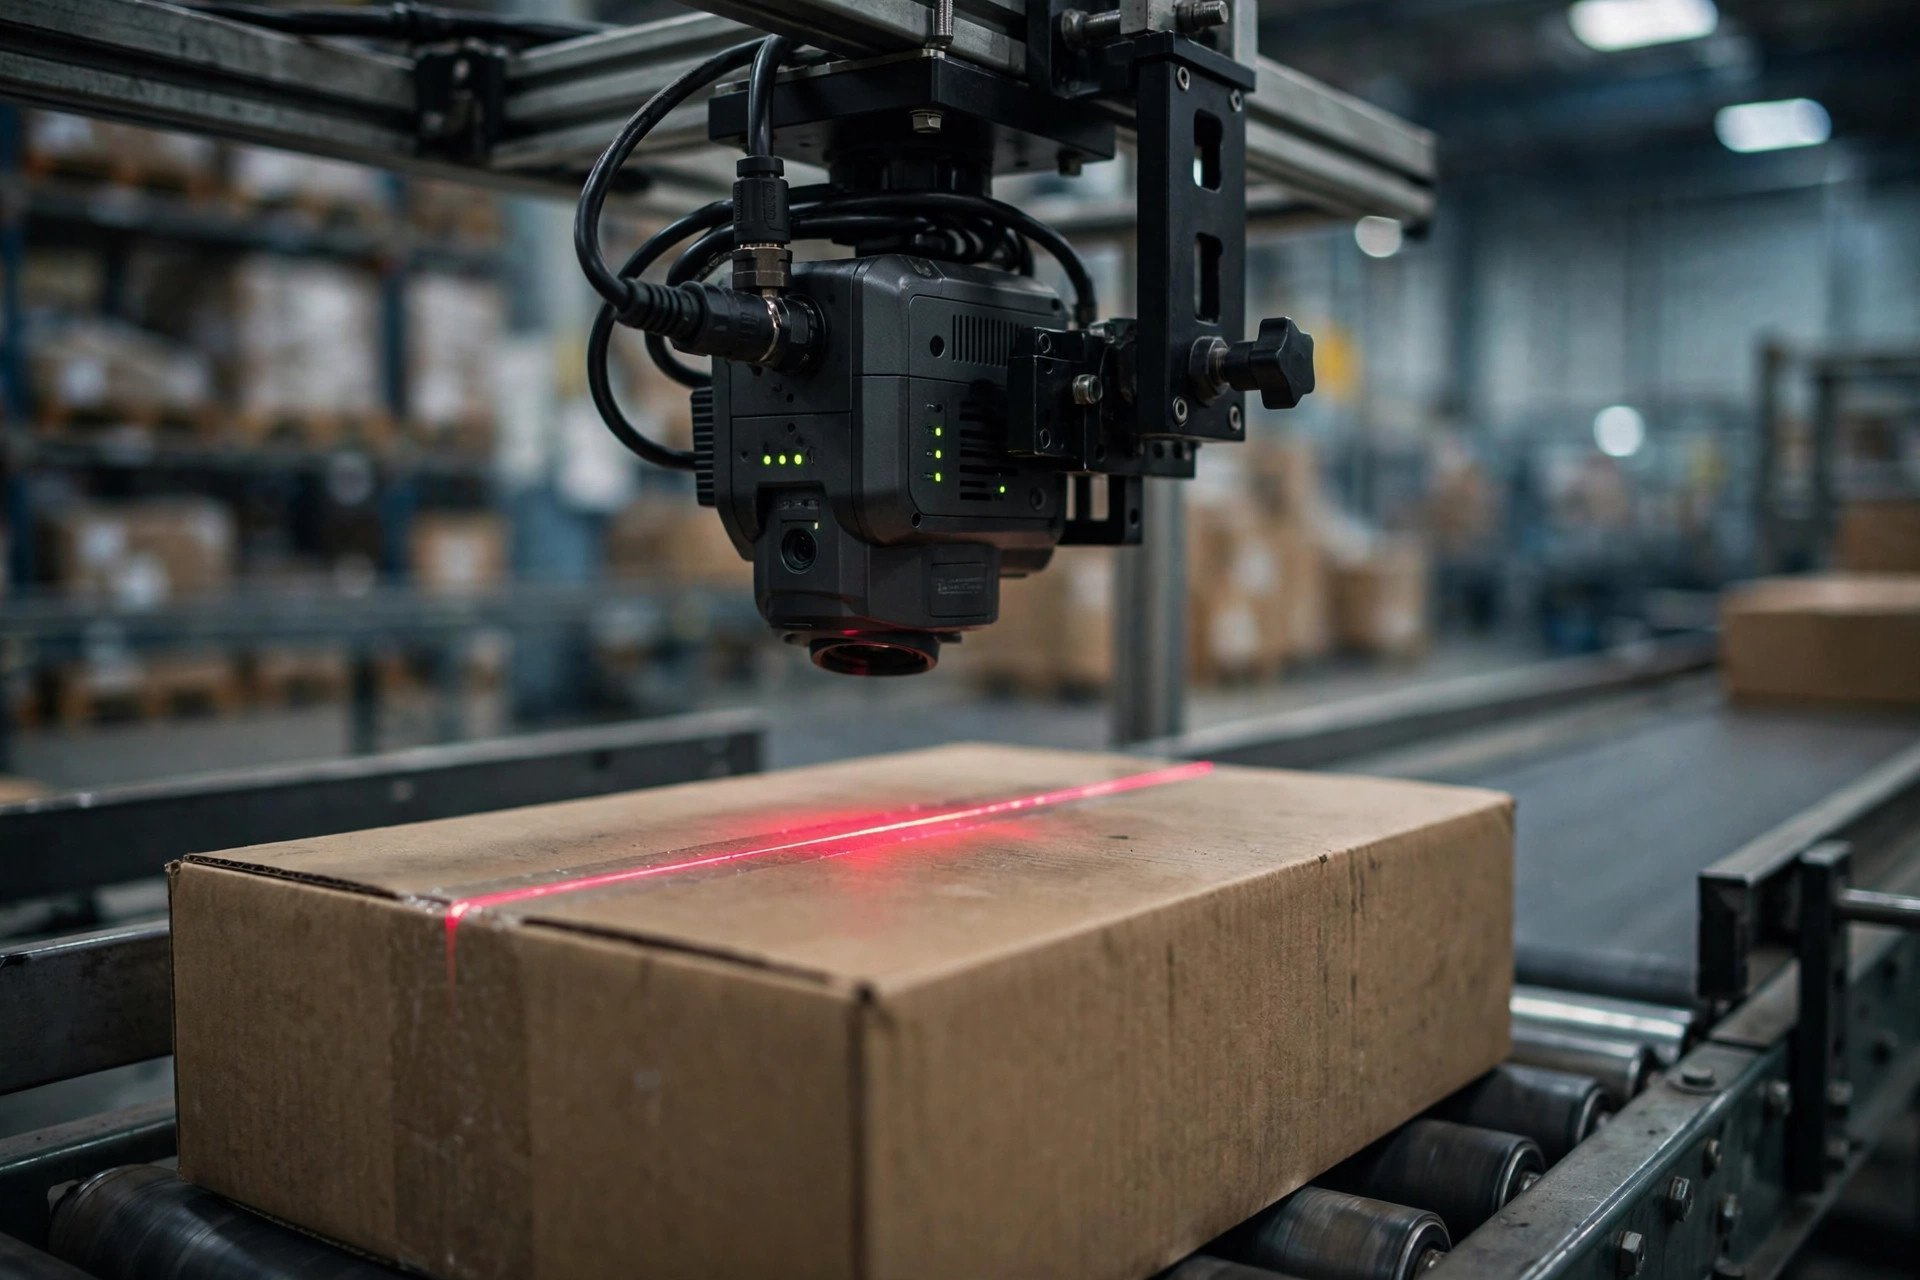
2023年、私はフェニックス郊外の3PL倉庫にいました。約100,000平方フィート、家庭用品のEC倉庫です。仕分けラインの監査ステーションに画像認識システムが導入されていました。カメラが各荷物の配送ラベルと商品外観を撮影し、SKUが正しいかを自動で照合します。受入週、ベンダーは認識精度99.2%のテストレポートを持ってきました。倉庫マネージャーは大喜びで、3年間のサービス契約に署名しました。
8か月後、苦情が出始めました。監査ステーションの誤報が増え続け、オペレーターはすべてを手で再確認しなければならず、スループットは導入前を下回ってしまいました。データを調べると、精度は95%強まで低下していました。この8か月で何が起きたのか? 3つのことです。しかも誰のせいでもありませんでした。
1つ目はSKU構成の変化です。家庭用品は季節で入れ替わりが激しい。8か月で400以上の新規SKUが追加され、その多くは既存商品の再包装版でした。新しい色、微妙に変わった寸法。モデルは苦戦し始めました。2つ目は季節性です。感謝祭からクリスマスにかけて、荷物の量は倍増し、コンベヤーは高速化され、カメラの撮像品質が低下しました。3つ目は小さなプロセス変更です。倉庫が監査ステーションの蛍光灯を明るいLEDに交換しました。色温度が変わり、モデルの色ベースの特徴量はターゲットから外れていきました。
これが平たく言えば「データ分布のドリフト」です。モデルが毎日見るデータは、学習時のデータと少しずつ似なくなっていきます。被害者は画像認識だけではありません。私はアパレル倉庫で、消費者の購買パターン変化後に補充予測モデルの誤差が倍増した例を見ました。システムは数年前の需要曲線に基づいて発注し続けていたのです。覚えておいてください。劣化はバグではなくデフォルトです。倉庫で稼働するすべてのモデル——画像認識も、需要予測も、異常検知も——劣化します。問題は速度だけです。
劣化条項がなければ、受入数値は飾りだ
フェニックスの事例を痛いものにしたのは技術ではありませんでした。契約です。3年間の契約の中で、精度が登場したのは受入条項のたった1回だけでした。99%を達成、合格、終わり。受入後、契約は精度について何も語っていませんでした。モデルが95%まで低下したとき、ベンダーの回答は完璧に「理にかなって」いました。契約は稼働後の指標をカバーしていないので、再学習は新規サービスであり、別料金です。
倉庫マネージャーが電話してきたとき、彼は激怒していました。「受入は99.2%だったのに、今は95%だ。これが違反じゃないなんてあり得ない」。私は不愉快な答えを返しました。契約の文言上は、違反ではないのです。受入条項が規定したのは1日だけ。その後については何も書かれていません。彼が署名したのは「3年間99%の精度」ではありません。「受入日に99%、その後はご幸運を」だったのです。
この形の契約は1つだけではありません。AIベンダーは必ず受入数値を売ってきます。99%、99.5%、美しい数字です。でも受入は、ベンダーが丁寧に用意したデータセットで測ります。理想的な照明、理想的な角度、理想的なSKU分布。稼働中の倉庫はまったくの別物です。
多くの人が見落とすもう1つの層があります。ベンダーには劣化条項を自発的に出すインセンティブがないのです。彼らのビジネスモデルはソフトウェアライセンスと導入サービスであり、サイクルごとの再学習料金は素敵なリカーリング収益です。モデルが早く劣化するほど、再学習が売れます。契約に劣化義務を書くこと——たとえば保証期間中の無料再学習——は自分の収入を削ることです。あなたが言い出さなければ、彼らも言いません。これは交渉のテーブルで買い手が要求すべきことです。
私の判断は変わりません。受入は語るが劣化に触れない契約は、100%の劣化リスクを静かにあなたへ移転します。ベンダーは報酬を受け取り、あなたは結果と共に生きることになります。
再学習をベンダーの義務にする
では、契約には実際何を盛り込むべきか? 1つの論理チェーンです。ベースラインを定義し、トリガーを設定し、再学習の義務を割り当て、継続的な失敗の結果を明記する。1つでも欠ければ、チェーン全体が崩れます。
ベースライン指標と測定方法を固定してください。「精度が98%を下回らない」だけでは何の価値もありません。何のデータで測るのか? サンプル数は? 日次集計か週次集計か? ピークシーズンとオフシーズンは同じ重みか? 方法を文書化しなければ、あらゆる紛争は罵り合いになります。私の推奨文言はこうです。受入テストセットをベースラインデータセットとして採用し、新規ラベリング済みサンプルで同サイズ・同分布のセットに対して四半期ごとに再テストし、4週間の移動平均で判定する。方法が契約に入れば、ベンダーは「こちらでは正常に見えます」とごまかせなくなります。
トリガーは具体的にする必要があります。たとえば、移動平均の精度がベースラインを2ポイント以上下回る状態が4週連続で続けば、ベンダーは再学習サイクルをあなたに負う。あるいは5%を超える相対的な低下でも構いません。具体的な数値は交渉可能ですが、数値は必ず必要です。トリガーがなければ「劣化したら再学習する」は空文です。何が「劣化」とカウントされるかを誰が決めるのか? モデルを直す代わりに、その議論に時間を使うことになります。
再学習の主体と費用は、契約で最も価値のある条項です。明記してください。トリガー後、ベンダーが再学習済みモデルを納品するまでの営業日数。保証期間中の再学習は無料か、課金ならサイクルごとの上限を書面で設定するか。新規SKU用のラベル済みデータを何日前に提供しなければならず、ラベルの質が悪い場合の手直し費用は誰が負担するか。フェニックスの倉庫はまさにここで行き詰まりました。ベンダーの再学習見積もりは、新規導入に近い金額でした。そしてラベリングの罠を見落とさないでください。多くの倉庫では、ラベリングはオペレーターが片手間に行い、品質にばらつきがあります。ラベリング基準とサンプリング/検査比率を契約に入れなければ、性能の落ちた再学習モデルと、互いに責任をなすり合う2者が残ります。
最後に、継続的な失敗への結果です。サービスクレジットが標準的な手段です。ある月に指標を満たせなければ、その月の料金を定められた割合で減額する。より重要なのは契約解除条項です。再学習を行っても指標未達が3か月連続で続けば、違約金なしで解約でき、ベンダーはモデル、学習データ、ドキュメントを引き渡し、移行に協力しなければなりません。解除条項がなければ、あなたは閉じ込められます。モデルは劣化し続け、ベンダー変更には莫大な費用がかかり、鼻をつまんで契約更新するしかなくなります。
署名前チェックリスト——署名前にすべての項目を確認してください。
- ベースライン指標の固定。受入数値+測定方法(テストセットの構成、サンプルサイズ、測定ウィンドウ、移動平均の計算式)。
- 劣化トリガー。ベースラインを何ポイント下回り、何週続けば、ベンダーの再学習義務が発動するか。
- 再学習の納期。トリガー後、何営業日で再学習済みモデルを納品するか、何を「納品」とみなすか。
- 費用分担。保証期間中の再学習は無料か。課金なら、契約にサイクルごとの上限を明記。
- データ提供義務。新規SKUやプロセス変更用のラベル済みデータを何日前に提供するか、不良ラベルの手直しは誰が負担するか。
- モニタリングレポート。ベンダーは精度曲線とドリフト指標を月次または四半期ごとに提出。生データの監査権を保持する。
- サービスクレジット。指標未達の月は料金を具体的な割合で減額。
- 契約解除条項。継続的な未達(例:3か月)で違約金なしの解約が可能。ベンダーはモデル、データ、ドキュメントを引き渡し、移行に協力する。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。