過去2年間、AIパイロットを実施した20社以上の倉庫・小売企業へのインタビューで、私は驚くほど一貫したパターンに気づいた。パイロットはほぼ必ずその企業の最良の拠点——最も安定したネットワーク、最もクリーンなSKUマスタデータ、最も標準化されたプロセス、最も協力的で、最も支援的なマネジメントを持つ旗艦配送センター——に着地する。そのロジックは申し分なく見える。成功の可能性が最も高い場所にパイロットを置き、コンセプトを実証し、複製するのだ。しかし6〜12カ月後、これらの企業が同じソリューションを2番目、3番目の拠点に展開すると、同様に一貫した現象が現れる。見事だったパイロットの数字は劇的に縮み、一部のプロジェクトは展開中に静かに棚上げされる。パイロットは「成功」したのに、展開は失敗したのだ。そのパラドックスを詳しく見てみよう。
数字:パイロットとスケーリングのギャップ
MIT Project NANDAのレポート「The GenAI Divide: State of AI in Business 2025」(2025年8月発行)によると、企業生成AIパイロットの約95%は損益計算書上で測定可能なリターンを生み出さず、約5%の組織だけがスケールで真の価値を獲得した。方法論についての注記が必要だ。この95%という数字は、調査対象の全組織を分母としている。実際にパイロットを実施した組織の中では、およそ4社に1社が最終的に本番スケールに到達した。いずれにせよ結論は変わらない。パイロットとスケーリングの間には大きなギャップがあり、ほとんどの組織はそれを越えられない。私の観察では、そのギャップの最初の一歩は、パイロットサイトを選んだ瞬間に置かれることが多い。サイト選定そのものがサンプリングの一形態であり、最良の倉庫でパイロットを行うことは、統計学的にはバイアスのかかったサンプルなのだ。
なぜ最良の倉庫が最悪のパイロットサンプルになるのか
このパラドックスを説明する3つのメカニズムがある。
第一に、賦与の取り違えだ。旗艦サイトの持つ本来的な優位性——クリーンなデータ、標準化されたプロセス、安定したネットワーク、協力的なチーム——は、どんなソリューションも実際より効果的に見せてしまう。統計学者はこれを選択バイアスと呼ぶ。あなたはAIの効果を測っているつもりだが、実際に測っているのは「素晴らしい倉庫+AI」の複合効果であり、そのすべてをAIの功績にしているのだ。パイロットのROIの意味のある部分は、アルゴリズムではなく、倉庫の賦与が支払っている。
第二に、リソースの歪みだ。パイロット期間は異例なほど優遇されている。ベンダーのエンジニアが常駐し、本社のプロジェクトマネージャーが毎日フォローし、倉庫のベスト人材がテスト支援に振り向けられる。これらの隠れたインプットはパイロットのコスト分母に決して現れないが、現実に存在し、パイロットのパフォーマンスを本当に押し上げる。展開時にリソースが引き上げられると、パフォーマンスは回帰する。AIが壊れたからではなく、温室条件が消えたからだ。
第三に、語りの中の生存バイアスだ。美しい数字のパイロットは語り継がれるケーススタディになるが、平凡なパイロットは静かに閉じられ、二度と言及されない。業界を流通する「パイロットROI」の数字は、現実を体系的に誇張するフィルタリングされたサンプルから来ており、逆に「最良の倉庫でパイロットを行う」という一見明白な本能を強化する。
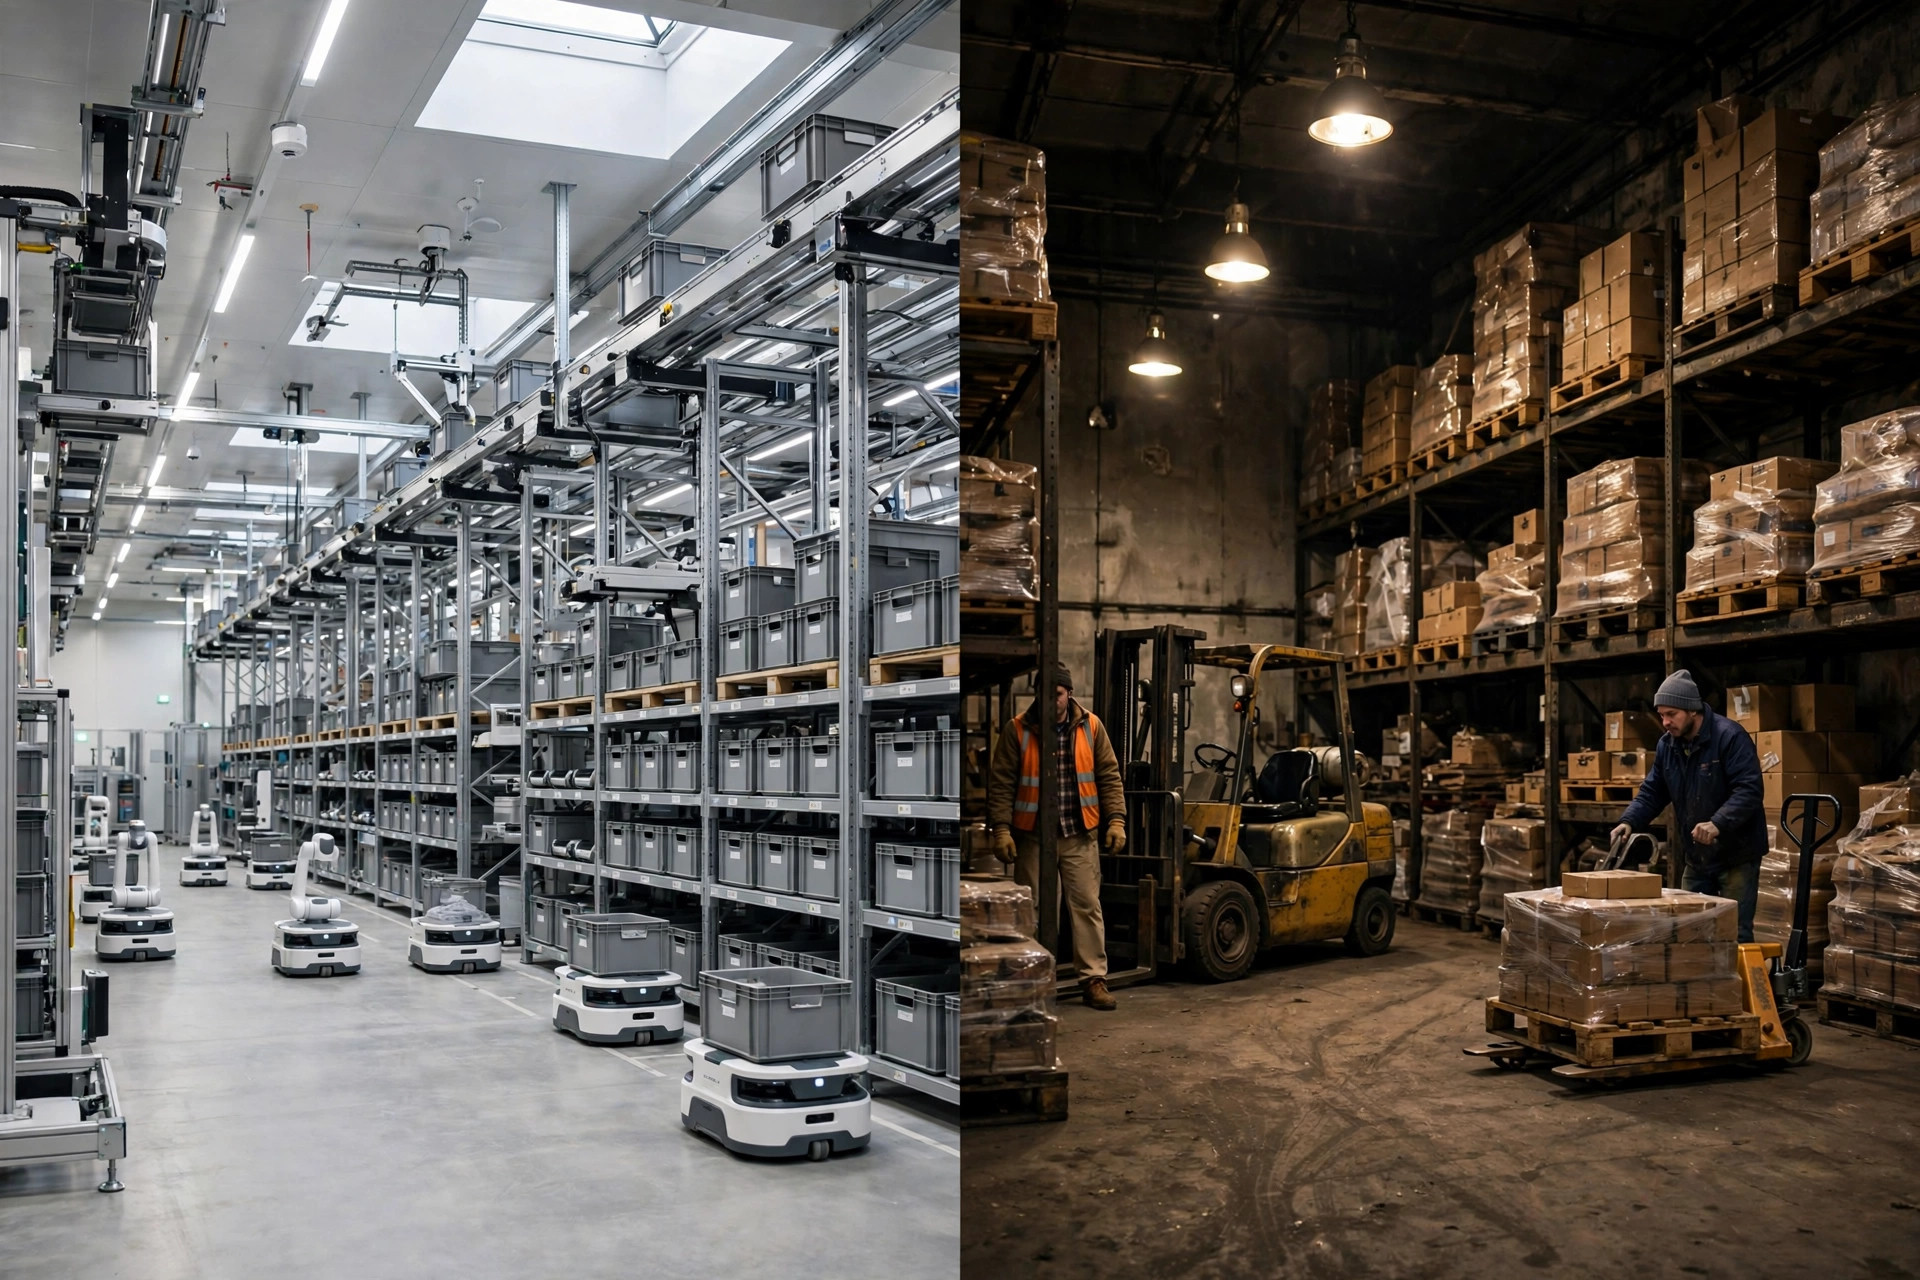
最初のケースを考えてみよう。2024年下半期、ある3PLが蘇州近郊の旗艦倉庫でAI画像認識による監査パイロットを開始した。3カ月後、監査精度は99.2%から99.6%に上昇し、例外の捕捉はほぼ2倍になり、プロジェクトチームは年間換算で約RMB 400,000の人件費削減を見積もった。パイロットは「期待以上の成功」と評価された。2025年初め、同じ機器と同バージョンのアルゴリズムが無錫と合肥の地域倉庫に展開されたが、精度の改善は0.1ポイント未満、事実上ノイズだった。事後分析で判明した決定的な違いは、旗艦の監査ステーションが2023年に改装済みで、均一な照明と完全に標準化されたパレット・コンテナを備えていた一方、地域拠点は老朽化した照明と不揃いな段ボールサイズの混在だったことだ。ビジョンモデルがパイロット中に「学習」したのは、標準化された環境の視覚的特徴だった。言い換えれば、パイロットが測ったのはアルゴリズムの汎化能力ではなく、パイロット環境の親切さだったのだ。
2つ目のケースは2025年第1四半期のもので、ある米国小売チェーンがダラス近郊の旗艦配送センター(約120店舗を管轄、SKUマスタデータの完全性98%)で需要予測AIのパイロットを行った。6カ月後、予測誤差(MAPE)は約4ポイント、欠品率は1.2ポイント低下し、「成功、展開推奨」との判断が下された。これを中西部の2つの配送センターに複製したところ——マスタデータの完全性は80%をかろうじて超える程度で、販促記録もまちまちだった——モデルの効果はパイロットの約30%にとどまった。チームはその後、意図的に「平均的」な倉庫でもう一度パイロットを実施した。データの欠け、プロセスの例外、さほど協力的でない現場だ。数字は最初のパイロットほど華やかではなかったが、この2回目のパイロットから作られたデータガバナンスのチェックリストと展開プレイブックは、その後4つの倉庫すべてに初回で展開成功した。プロジェクトリーダーは率直に言った。最初のパイロットは「AIが理想条件で動くこと」を証明し、2回目は「AIが私たちの現実の条件で動くこと」を証明した。マネジメントが本当に必要だったのは2回目の証明だけだったのだ。
不快な推論はここにある。期待を上回るROIを出したパイロットは、祝福ではなく追加の精査に値する。というのも、その上振れはAIの力というより、パイロットサイトが異例に良かったことによる可能性があるからだ。平均以下の倉庫で実施されたパイロット——数字が20-30%見劣りする——は、そのソリューションの下限を測る。旗艦で実施されたパイロットは上限しか測らない。マネジメントが本当に欲しかったのは「パイロットの成功」ではなく「展開の成功」だった。そしてこの2つの目標に対するサイト選定のロジックは正反対を向いている。前者は安全を求め、後者は真実を求めるのだ。
パイロットサイト選定の3つの指針
| サイトのタイプ | 典型的なプロファイル | パイロット戦略 |
|---|---|---|
| 旗艦(最良条件) | クリーンなデータ、標準化されたプロセス、リソースの偏り | 技術的実現可能性の検証のみ。ROIのコミットはしない。結論は「上限の参考」と明示する |
| 代表的な中位サイト(推奨) | 規模、SKU構成、人員が社内平均に近い | ROI測定の主戦場。結論を展開判断に直結できる |
| 典型的な問題サイト | 代表的な実在の痛点(監査エラー多発や慢性的な欠品など) | ソリューションが実問題を解決するか検証。原因と結果の帰属が最もクリーン |
| 避けるべき:新規・移転中・ピークで逼迫したサイト | 不安定なベースライン、変数が多すぎる | パイロットに不適。結果の帰属ができない |
もう一つ付け加える価値のある要素がある。それは対照群だ。可能なら「シャドー対照」を指定する。同じ地域の同等のサイトで、AIは入れないが同期間ベースラインのデータを記録するものだ。あるいは同一倉庫内でカテゴリ別・期間別の比較を行う。対照群のないパイロットROIは、厳密には反証不能な数字であり、その説得力はスライドデッキの中にしか存在しない。
すでに始まっている変化
企業のAI支出が実験フェーズからスケーリングフェーズに移るにつれ、パイロットの方法論も変わりつつある。初期のロジックは「まず動かす」で、サイト選定は安全と速度に最適化されていた。新たなロジックは「まず複製可能にする」で、サイト選定は真実と代表性に最適化される。私の予想では、2027年頃までには、パイロットサイトの代表性評価が企業AIガバナンスの標準ステップになる。それは業界が急に厳密になったからではなく、十分な数の企業がすでに授業料を払ったからだ。サイト選定を最初に修正した者が、展開フェーズで最も低い授業料を払うことになる。
最後に、持ち帰ってほしい問いかけを一つ。AIソリューションがあなたの最良の倉庫でのみ美しい数字を出し、他のすべての倉庫でつまずくのなら、私たちが問うべきは「AIは機能するのか」か、それとも「私たちの倉庫はこのAIに値するのか」か。そしてさらに、パイロットサイトの選択がパイロットの結果を大きく左右しうるなら、過去2年間に業界が称えた「AI成功物語」のうち、技術を測ったものはいくつ、サイト選定のセンスの良さを測っただけのものはいくつあるのか。標準的な答えはない。しかしパイロットを立ち上げようとするすべての企業は、この問いを一度自問する価値がある。署名する前に。
Dr. Chen(サプライチェーン研究者)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。