結論を先に言います。倉庫でAIプロジェクトが失敗するとき、少なくとも半分はモデルのせいではありません。データが先に整理されていなかったのです。私はこの落とし穴を3回見てきました。毎回、本番前夜に破綻し、毎回チームは手を止めてデータの宿題に戻らざるを得ませんでした。AIのデータ準備は本番移行の前に行います。整理すべきデータは3種類——マスタデータ、トランザクションデータ、ラベル付けデータです。「十分にきれい」とは何か、そしてそれぞれをどう点検しどう直すか。この記事ではそれを1つずつ具体的に書きます。
なぜデータ準備が最初の関門なのか
こう考えてください。モデルは生徒、データは教科書です。ページの半分が誤植だらけの教科書を生徒に渡せば、どんなに優秀な生徒でも試験に落ちます。倉庫でAIがやること——ロケーションの認識、補充の予測、顧客からの質問への回答——のすべては、1つの前提の上に成り立っています。システムのデータが現場の実態と一致している、という前提です。ところが現実には、ほとんどの倉庫でこの2つにはズレがあります。1つのバーコードを共有するSKU、重複したロケーションラベル、作業の何時間も後に入力される入出庫記録。現場を見ている人間なら、こうしたズレは目で見て自分で補正できます。AIにはそれができません。エラーをもっと「らしく」学習するだけです。
だからデータ準備は「ついでにやる」下準備ではありません。それ自体がプロジェクトです。私が携わったAI関連プロジェクトでは、データ準備が平均でプロジェクト全体の工数の半分以上を占め、予算の3〜4割をデータガバナンスに確保しておく必要があります。キックオフの時点でこの計算をテーブルに出してください。モデルだけ予算を取って、プロジェクト途中で「データの関門を通れない」ことに気づく事態を防ぐためです。
1種類ずつ、整理していく
その1:マスタデータ——1コード1モノ、例外なし
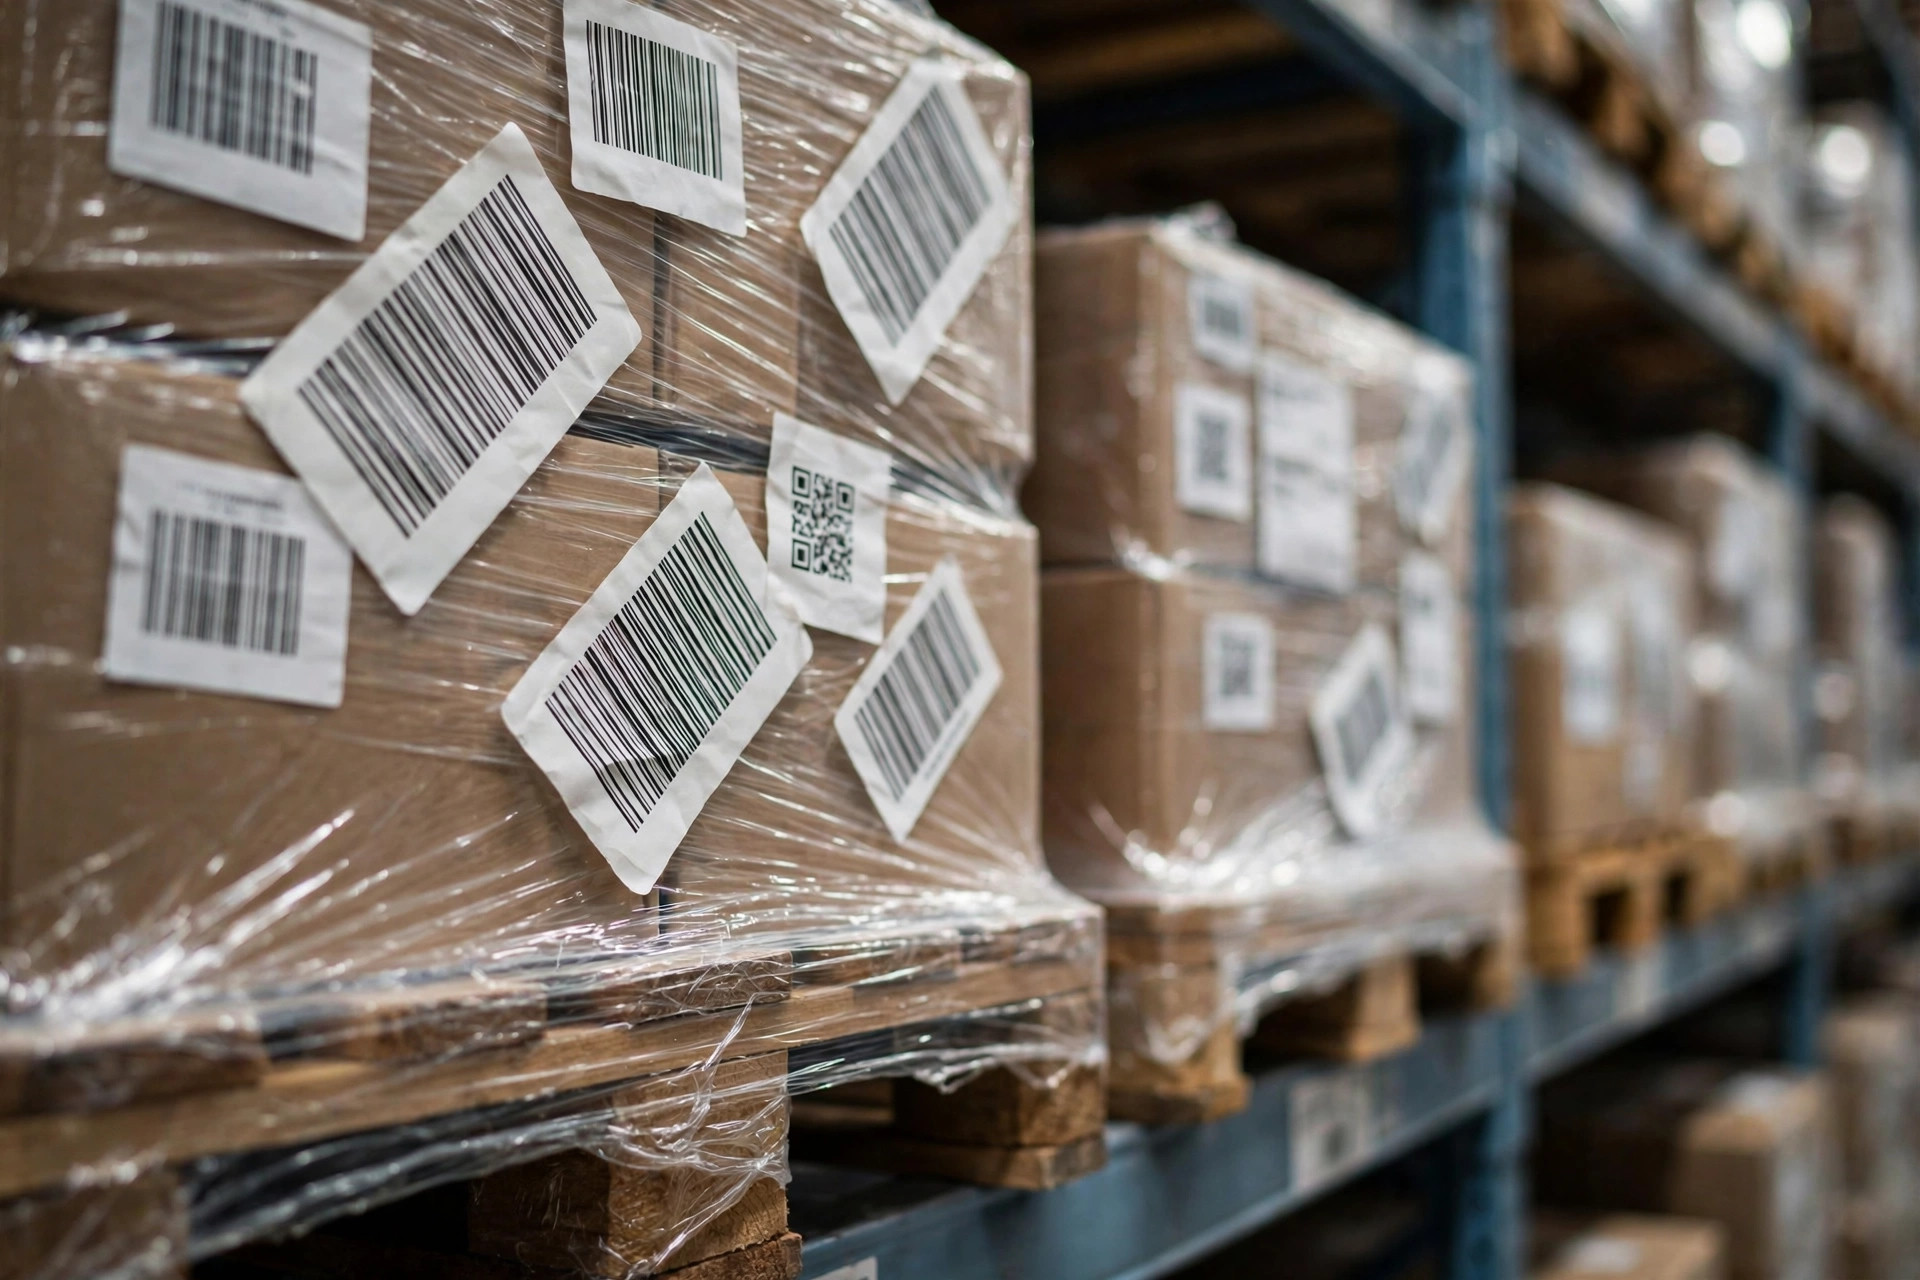
マスタデータは「辞書」です。SKU、ロケーション、仕入先。AI導入の最初の要件:1つのバーコードは正確に1つのモノに対応すること。
汚れの見つけ方:SKUマスタを全件エクスポートして3つのチェックをかけます。第1に、空コード(バーコード欄が空白またはゼロだらけ)。第2に、重複コード(1つのバーコードが複数のSKUを指している)。第3に、1コード多品目(現場を歩いてスキャンしてみる——1つのラベルが2つの違う商品に貼られていませんか?)。ロケーションも同じ扱いです。ロケーションマスタをエクスポートして重複ラベルを探し、システムには存在するのに現場で見つからない「ゴーストロケーション」を狩り出します。
直し方:空コードや重複コードは、対象SKUの入出庫を凍結し、1つずつ現場で確認してコードを振り直します。1コード多品目のケースは、1コード1品目になるまで分割します。近道はありません。仕入先マスタの古典的な混乱は「1つの仕入先、3つの名前」——同じ業者が3通りの名前で登録され、AIのリコンサイルがそれを3つの違う会社として扱ってしまいます。
合格基準:500SKUをランダムにサンプルし、現場でスキャンします。全スキャンがシステムと完全に一致しなければなりません。200ロケーションも同じ方法でサンプルします。サンプルが1つでも落ちたら全数再棚卸に拡大し、連続2回のサンプルがきれいに通るまで先に進まないこと。
その2:トランザクションデータ——タイムスタンプはAIの目
入出庫記録、棚卸記録、タスク記録——これはAIが「倉庫の動き」を学ぶ教科書です。教科書の最低要件:タイムスタンプが完備され、記録に抜けがないこと。
汚れの見つけ方:過去90日間の入出庫トランザクションを抜き出して3つを確認します。第1に、タイムスタンプの欠損や1970のようなデフォルト値。第2に、未来のタイムスタンプ(システム時計を誰かが変えた)。第3に、在庫のマイナス(在庫がマイナスということは出庫記録の漏れがある)。次に「事後入力率」を確認します。実際の作業から24時間以上遅れて作成された伝票がどれだけあるか——事後入力の伝票は偽のタイムスタンプを持っており、そこから「繁忙と閑散」のパターンを学んだAIは曲がって覚えます。
直し方:タイムスタンプの欠損は、元の記録が復元できる場合だけ補完します。復元できない場合はその区間ごと切り捨ててマークします。「だいたいの時間を推測して埋める」は絶対にダメ。在庫のマイナスは、AIの話をする前に必ず棚卸してゼロに戻します。事後入力率が高い工程(通常は返品とクロスドック)は、まずプロセスをリアルタイムスキャンに変えてからデータを蓄積します。
合格基準:90日連続のトランザクション記録に抜けなし、タイムスタンプ完備率100%、在庫マイナスゼロ、事後入力率5%未満。この基準を下回る状態では、予測系AI(需要予測、補充提案)を導入しないこと。エラーを増幅するだけです。
その3:ラベル付けデータ——AI導入の弾薬
画像認識システムには「異常画像」(破損した包装、誤ってラベル付けされたカートン、空パレット)が必要です。カスタマーサービスAIにはQ&Aペア(実際の顧客の質問と承認済みの回答)が必要です。倉庫にこうしたデータが自然にあることはありません。ゼロからラベル付けしなければなりません。
評価の仕方:3つの問いを立てます。量は足りているか(画像認識タスクは、始めるのに最低でも数千枚の使える画像が必要。Q&Aは最低1000ペアが必要)。カバレッジは完全か(異常写真はすべて1つのゾーンの昼間撮影ばかりではないか)。ラベル付けは正確か(同じバッチを2人が独立にラベル付けし、200件をサンプルして一致を確認したか)。
直し方:量が足りなければ、計画的に収集します。現場スタッフにチェックリストに沿って2週間撮影してもらいます。カバレッジが薄ければ、見落としがちなシナリオ(夜勤、雨季の屋外ドック)を追加します。精度が足りなければ、1ページのラベル付け仕様書を書いて「損傷と正常の境界」を明確に定義し、サンプルを再点検して、不合格のバッチは作り直します。
合格基準:200件のラベル付きデータをサンプルし、2人の独立したラベラーが目標一致率で合意すること(私は画像認識で95%以上、Q&Aで90%以上を推奨します)。主要なシナリオとシフトをすべてカバーすること。ラベリング品質基準は口約束ではなく、契約の付属文書に入れること。
この落とし穴を3回見てきた:救出劇
2025年半ば、中国東部の3PL倉庫がAI支援の棚卸を始めました。各通路をカメラ搭載のAGVが走り、AIがロケーションラベルと商品を読み取り、帳簿在庫と自動で照合する仕組みです。良いアイデアでした。本番開始の最初の1週間、棚卸の差異率は下がるどころか上がり、現場チームは怒り、プロジェクトは殺されかけました。
問題はどこにあったのか。1週間の掘り下げで、データのその1にたどり着きました。その倉庫では、ロケーションラベルのほぼ10枚に1枚が重複していました。ゾーンはこれまでに2回組み替えられ、古いラベルは完全には剥がされず、新しいラベルが上から貼られていました。1つのロケーションに2つのコードです。バーコードを共有するSKUも加わり、AIはロケーションAの商品をロケーションBのものとして読み続けました。数えれば数えるほど、現場は混乱しました。重複ラベルを見た人間の棚卸担当者なら判断を使います。AIにはそれがありません。
救出は3つのステップと、丸2週間の全面停止で行われました。ステップ1:倉庫全体の1コード1モノの整理——重複ラベルをすべて剥がし、コードを振り直し、凍結期間中の入出庫はすべて人手のダブルチェックを通します。ステップ2:SKUマスタの整理。1コード多品目のケースをすべて分割します。ステップ3:きれいになったデータで認識モデルを再学習し、小さなエリアで2週間パイロット運用し、差異率が人手棚卸の水準を下回ってから本格展開します。
データ準備はそのプロジェクトの全工数の60%を占めました。教訓は1文です。AIプロジェクトのキックオフでは、データガバナンスの工数を独自の費目として列挙し、スケジュールに組み込むこと。「導入」という言葉の中に隠さないこと。この落とし穴を私は3回見てきましたが、シナリオは毎回同じです。モデルが間違っていたことは一度もありません。キックオフ前に現場に降りて500のコードをスキャンした人がいなかっただけです。
本番前夜チェックリスト:データ編
まず直感に反する注意点を1つ。本番移行前に「完璧な」データを待たないこと。完璧なデータなど存在しません。まずリリースして、回して、モデルは運用の中で新しいデータの問題を浮き彫りにします。ただし、3種類のデータの最低基準は譲れません。マスタデータの1コード1モノ、トランザクションのタイムスタンプ完備、検査済みのラベリング。この基準を下回ると、モデルは稼働が長いほどドリフトします。リリースしない方がましです。
本番前夜、このリストを1つずつチェックします。1つでも未チェックがあれば、本番切り替えはなしです。
- マスタデータ:500SKUをランダムにサンプルして現場でスキャン、全件システムと一致
- ロケーション:200ロケーションをランダムにサンプル、重複なし、ゴーストなし
- トランザクションデータ:過去90日間の記録に抜けなし、タイムスタンプ完備、在庫マイナスゼロ
- 事後入力率:24時間以上遅れて作成された伝票が5%未満
- ラベル付けデータ:200件のサンプルが独立ラベラーの一致確認を通過、主要シナリオをすべてカバー
- 汚いデータの取り扱いルールを文書化:責任者は誰か、実行頻度は、例外は誰にエスカレーションするか
すべてチェックしてから本番へ。明日にできることは1つだけです。100SKUをランダムにサンプルして現場でスキャンしてください。一致しない割合——それがあなたのデータ準備の真の出発点です。
Lin Xiao(WMS導入コンサルタント)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。