2026年10月5日、欧州の物流システムインテグレーターであるLogistics Replyは、AIエージェントの権限モデルを発表した。同時に、倉庫管理システム(WMS)に書き戻すよう設計された5つの事前構築エージェントも発表している:欠品原因を診断するもの、労働力を平準化するもの、ABC分類を再計算するもの、自然言語の会話でドックドアの枠を予約するもの、タスクの遅れ時にカメラ映像を引いてAMRの通路を何かが塞いでいないか確認するものだ。これは発表に関する公開報道による。
これは、多くの人が知る倉庫AIとはもはや別種のものだ。ここ2年、倉庫のAIといえばSOP文書に対するRAGがほとんどだった:作業者が返品プロセスの手順を尋ねると、アシスタントがナレッジベースから段落を取ってくる。どのシステムにも触れず、データも変えない。間違った回答のコストは、ため息と2回目の検索程度だ。倉庫AIエージェントの普及を分ける本当の境界線はツールへのアクセスだ:WMSのAPIを呼ぶ権限、補充推奨を生成すること、更新したABC分類を品目マスタに書き戻すことまで。
AIエージェントとチャットボットを分けるのは知能ではなくアクセスだ
発表の背後には、精読に値する調査数字がある。2025年11月に実施された、北米の物流幹部2,000人超を対象とするORTECの調査によれば、物流組織の42パーセントがエージェント型AIをまったく検討しておらず、一方で23パーセントが今後12ヶ月以内にパイロットを始めると答えた。業界は事実上、2026年を試行と学習の年に指定した。
倉庫現場により近い第2の調査はLogistics Replyによるもの:AIが現在、自律的に運用判断を下していると答えたのはわずか2.5パーセント、82.4パーセントが行動前にAIの推奨を通常レビューすると答え、ほぼ4分の3が従業員はAIの推奨や判断を上書きできると答えた。混乱が起きたとき、47.5パーセントがAIは問題を指摘し人間が対応を調整すると答え、AIがシステム横断で自動的に対応を調整すると答えたのはわずか3.8パーセントだった。
合わせ読みすると、パターンは明確だ:倉庫AIエージェントの問いは「動くのか」から「組織は任せる勇気があるか」へ移った。モデルの能力はボトルネックではない。委譲された権限がそうだ。
AIエージェントが本当に定着しうる倉庫タスク3つ
研究の観点から、問いは「AIに何ができるか」ではなかった。エラーコストと人件費の構造が、機械を先行させられるタスクはどれか、だ。公開された事例は3つの領域に集まる。
第1は在庫診断と補充推奨だ。上記の欠品エージェントは、真の欠品と、まだ受け入れられていない輸送中の商品のような一時的な状態を区別し、手作業のSKU単位の調査を機械スクリーニングに変える。これらのタスクは構造化された入力(在庫、輸送中、販売履歴)を取り、命令ではなく推奨を出す。人が確認し、エラーのコストは封じ込められたままだ。
第2は自律的な例外連絡だ。ドック予約エージェントは、運送業者が予約ルールに統制された誘導会話を通じてドック枠を検索・予約できるようにする。従来はプランナーが1日に何十通もの往復メールをこなす、反復的でルール縛りの強い仕事だった。AIは会話を構造化された予約アクションに変換する。
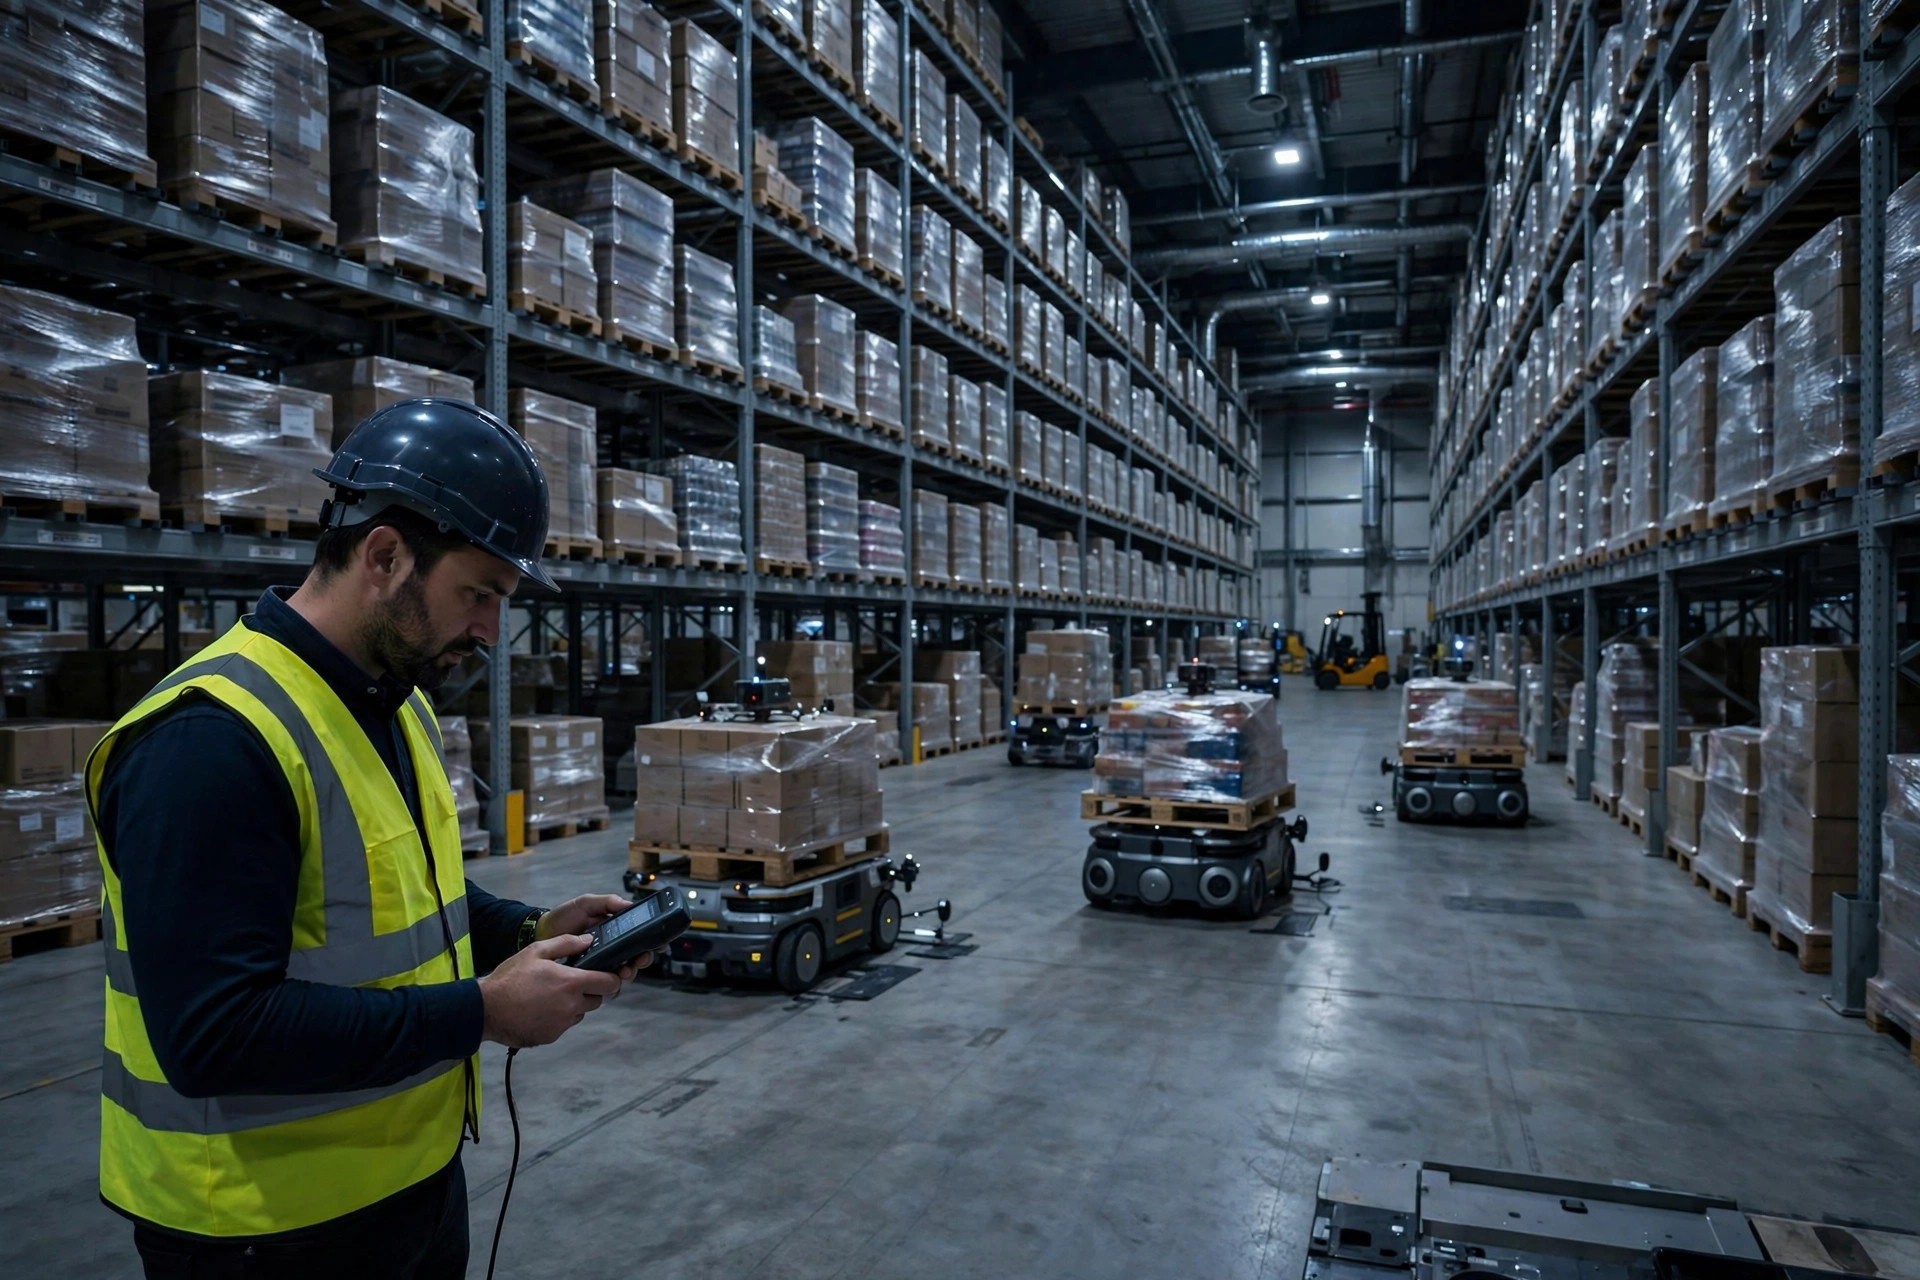
第3は棚卸トライアージとマスタデータ保守だ。ABC再配分エージェントは移動データから分類を再計算し、人の承認後にのみWMS品目マスタへ書き戻す再分類レポートを作る。遅延タスクのエージェントはカメラ入力で遅延原因を診断する。共通するのは高頻度で1件あたりの価値が低いこと:誰もやりたがらないが誰かがやらねばならない仕事だ。
3つの領域はシンプルな判断フレームに収まる:
| タスク種別 | エラーコスト | 1件あたりの手作業コスト | ふさわしい権限レベル |
|---|---|---|---|
| 在庫診断/補充助言 | 中(推奨はレビューで止められる) | 高(SKU単位の調査) | 推奨、人が承認 |
| 例外連絡/ドック予約 | 低〜中(ルール内で可逆) | 高(反復的な連絡) | 半自律的な実行 |
| 棚卸トライアージ/マスタデータ | 高(書き戻しが全システムに影響) | 中(定期的なバッチ作業) | 報告、承認、実行 |
経験則:アクションがシステムへの書き込みに近づくほど人の署名が必要になり、スクリーニングと推奨にとどまるほど機械が先行できる時期が早い。
2026年に多くの倉庫が倉庫AIエージェントを使えない理由
数字は関心と導入のギャップも説明する。2026年7月に在庫専門家400人を対象としたinFlowの調査では、81パーセントが倉庫にAIを望む一方、現在使っているのは11パーセントのみ。85パーセントは今も主なツールとしてスプレッドシートで在庫を回している。
ORTECは障害を順位付けした:既存システムとの統合コストが高いこと(32パーセント)が首位、次いでモデルの説明可能性の欠如(26パーセント)、データ品質の低さ(22パーセント)。42パーセントが自律的な判断を支えるには業務プロセスの再設計が必要と答え、22パーセントが信頼できるリアルタイムのデータフィードの必要性を挙げた。
3つの構造的障壁が浮かぶ。
第1に、権限と監査だ。WMSへの書き込みはすべて説明責任を伴う:発注書を作ったのは誰か、ABC分類を変えたのは誰か、失敗したら誰が答えるのか。自律的な実行には、今日の監査フレームワークに自然な所有者がいない。その組織の問題は技術の問題より難しい。
第2に、非対称なエラーコストだ。間違って答えるチャットボットには2回目の質問が来る。間違った発注書を出すエージェントやマスタデータを壊すエージェントは本物の金を失う。倉庫は1つのミスでラインが止まる環境だ。エラー許容度は構造的にオフィスより低い。
第3に、APIとデータの土台だ。多くの倉庫はAPIが不完全だったり文書が貧弱だったりするWMSプラットフォームで動いており、エージェントは呼べない。在庫精度自体もぐらつき、inFlow回答者の49.5パーセントが最大の改善領域に挙げた。汚いデータの上に組んだ自動化は、エラーを増幅するだけだ。
直感に反する発見:倉庫のAIエージェント普及のペースを決めるのは、モデルがどれだけ賢くなるかではなく、倉庫自身のエラーコスト構造とAPI成熟度だ。技術メディアはパラメータとベンチマークを報じる。倉庫管理者が気にするのは2つだけ:機械は自分のデータに触る前に自分のサインが必要か、そしてやったことを取り消せるか、だ。
倉庫におけるAIエージェントのタイムライン:研究者の見立て
まとめると、タイムラインの判断はこうだ。参考として提示する。
2026年はパイロットの年(根拠:ORTEC調査で12ヶ月以内にパイロットを計画する企業が23パーセント)。今年の主流は助言型エージェント:スクリーニング、レポート、下書きで、人の承認後に実行される。ベンダーは既に事前構築エージェントを売っており、買い手は主に大手3PLと小売直営のDCだ。
2027年から2028年は半自律化:チェーンの中の高頻度・低リスクの区間(ドック予約、例外トライアージ、補充の下書き)は、監査証跡とロールバック機構が追いつくことを条件に、人間が例外を処理する形でデフォルト実行へ移る。根拠:権限モデルと監査ツールは、通常モデルの能力より12〜18ヶ月遅れて成熟する。
完全自律のタスク実行が当たり前になるのは、どれかのタスク領域が人間の水準を下回るエラー率を恒常的に示し、契約と保険がミスの責任の所在を明記するまで待たねばならない。研究の作法として、その時点を正確に日付で言うべきではないが、2028年より前に来る可能性は低い。
だから問いは「AIエージェントがいつ倉庫に入るか」ではないのかもしれない。こうだ:機械があなたに代わって判断し始めたら、あなたの現場のどの判断に署名する気があり、どの判断は二度と見たくないのか? そのリストこそ、各倉庫の本当のAIロードマップだ。
Dr. Chen(サプライチェーン研究者)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。