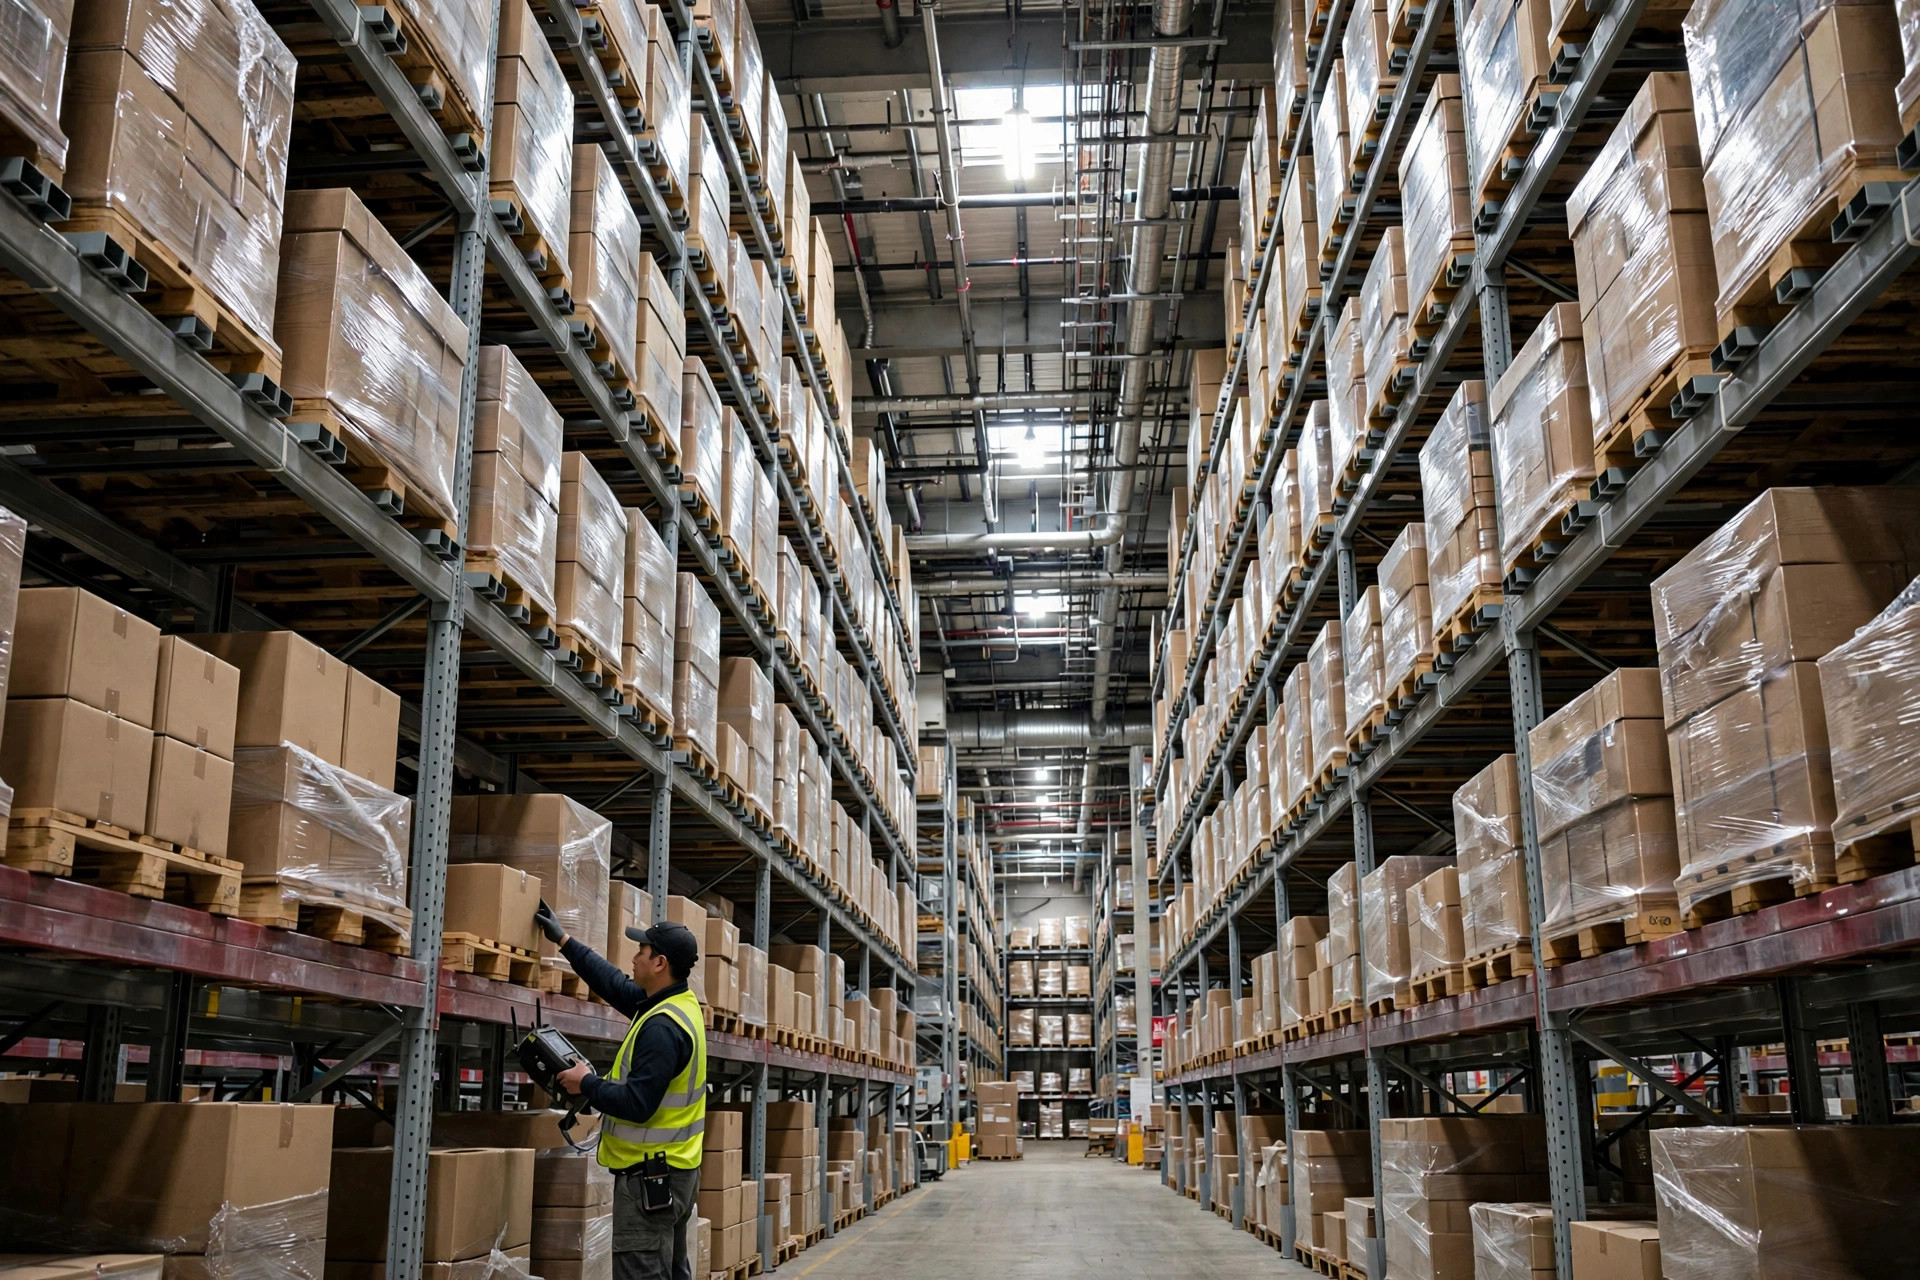
Verdict d'emblée : une panne réseau en entrepôt se présente sous deux formes. Le lien entre vos pistolets RF et le WMS tombe — appelez ça un bras cassé. Le serveur WMS lui-même meurt — c'est un arrêt cardiaque. Un bras cassé se traite avec le mode hors ligne des terminaux ; un arrêt cardiaque ne se surmonte qu'avec des bons papier plus une réconciliation après coup. La préparation de commandes et la réception doivent disposer d'un plan de contingence hors ligne. Les tableaux de bord et les rapports, on peut jouer à pile ou face : perdu ce pari, on les regardera plus tard ; le fret part quand même.
En 2021, je dirigeais un démarrage de WMS dans un entrepôt 3PL de 90 000 pieds carrés à Ontario, Californie : 30 terminaux Zebra TC52 au sol, plus de 4 000 commandes de sortie par jour en haute saison, tout piloté par scans RF. Un après-midi, la climatisation de la salle informatique est tombée en panne, le commutateur central a surchauffé et redémarré, et le WiFi s'est éteint pendant 40 minutes. Chaque écran de terminal s'est allumé avec « connexion échouée » pendant que les préparateurs restaient dans les allées sans rien faire. Pendant 40 minutes, l'entrepôt a été effectivement à l'arrêt — non par manque de fret, mais parce que personne ne savait quoi préparer ni où le mettre. Après ce jour-là, la contingence hors ligne est entrée dans la liste d'acceptation de chaque projet WMS que je touche. Pas de contingence, pas de démarrage.
Quand le réseau tombe, les pistolets RF peuvent-ils continuer à scanner ?
Oui — mais seulement si l'application du terminal dispose d'un vrai mode hors ligne, pas de celui dont parle le dossier commercial.
Beaucoup de fournisseurs WMS revendiquent un support hors ligne alors que leur application mobile ne met en cache que l'écran de connexion, sans aucune donnée de tâche stockée localement. Ne prenez pas la démo au pied de la lettre. Pendant l'acceptation, débranchez et testez : le réseau tombé, pouvez-vous toujours préparer, ranger et inventorier par scan, chaque lecture étant stockée sur l'appareil ? Si oui, c'est du mode hors ligne.
Deux choses doivent être vraies pour que ça marche. Avant le début du poste, le système doit pousser vers chaque terminal les tâches de la vague du jour, le référentiel des emplacements et la bibliothèque de codes-barres des articles — un appareil Android de classe Zebra TC52 contient des dizaines de milliers d'enregistrements de tâches sans sourciller (consultez la documentation de votre fournisseur pour les limites exactes). Une fois le réseau tombé, chaque scan est horodaté et mis en file d'attente localement, puis téléversé dans l'ordre au retour de la connectivité. Manquez l'une ou l'autre moitié et tout n'est que théâtre.
Voici un piège dans lequel je suis tombé en plein. À Ontario, dès que le réseau est revenu, 30 terminaux ont déversé leurs scans en file d'attente sur le serveur d'un coup et ont fait tomber l'interface de données du WMS en timeouts : environ la moitié des enregistrements n'a jamais été écrite, et l'autre moitié a été écrite deux fois. Nous avons réglé ça avec deux configurations. La limitation du téléversement côté terminal — des lots échelonnés, pas une inondation. Et des contrôles d'idempotence côté serveur — numéro de série de l'appareil plus horodatage comme clé unique, doublons écartés à l'arrivée. Si ces deux-là ne sont pas dans votre liste d'acceptation, votre mode hors ligne est de la décoration.
Reprendre au point d'interruption, c'est la même idée appliquée aux tâches. Une vague de préparation meurt au milieu d'une coupure ; au retour du lien, la tâche devrait continuer à partir de la ligne interrompue, pas retélécharger toute la vague. Cela signifie que la progression de la tâche est écrite localement en temps réel et que le téléversement porte un marqueur « lignes terminées ». Testez-le explicitement pendant l'acceptation : coupez le réseau à la ligne 20, terminez le reste hors ligne, restaurez, et vérifiez si le système honore ces 20 lignes. Si ce n'est pas le cas, on renvoie.
Si le serveur meurt vraiment, comment tourner au papier sans chaos ?
Un serveur mort est hors de portée du mode hors ligne — les quelques données mises en cache sur un terminal ne tiendront pas un poste entier. C'est là que les bons papier prennent le relais. Mais du papier fait sans soin, c'est pire que de rester planté : une fois les livres en désordre, vous passerez trois jours à les démêler après la reprise.
Trois choses doivent être prêtes avant que le désastre ne frappe, et les trois sont non négociables. Des bons de préparation d'urgence préimprimés, gardés dans l'armoire du bureau du superviseur. Chaque ligne du modèle porte un emplacement pour code-barres — code-barres d'emplacement, code-barres d'article, champ quantité — toujours code-barres plus chiffres lisibles ensemble. Pourquoi ? Parce que pendant la saisie après coup, le commis peut scanner le papier au lieu de taper les SKU à la main : plus rapide, et bien moins d'erreurs. Dans notre échantillonnage post mortem à Ontario, les bons SKU purement manuscrits sont revenus avec un taux d'erreur de saisie de 3 à 5 fois le niveau normal (mesuré sur ce projet, approximatif) ; les bons avec codes-barres étaient essentiellement propres.
La numérotation des bons est la deuxième pièce. Chaque bon d'urgence a besoin d'un numéro unique — quelque chose comme EMRG-date-séquence. Le superviseur consigne à la main quels bons ont été remis à qui et lesquels sont revenus. Du papier sans numéros signifie qu'à l'heure de la réconciliation, vous ne saurez jamais si un bon a disparu, et un bon disparu est un gâchis insoluble.
La troisième pièce est la règle des deux personnes pour la saisie après coup. Après le retour du réseau, une personne saisit les données papier dans le WMS pendant qu'une autre contrôle par échantillonnage environ dix pour cent (approximatif — fixez votre propre tolérance). Jusqu'à la fin de la saisie après coup, les emplacements concernés restent verrouillés : aucun mouvement en direct autorisé. Mélangez transactions en direct et saisie après coup et les livres ne s'équilibreront jamais.
Une partie du repli papier est constamment négligée : la réception. Le serveur tombé, aucun ASN n'arrive, donc le fret entrant va directement dans une zone de transit, consigné sur papier par plaque du camion, nombre de pièces et marques, avec photos prises. Les transactions de réception attendent le retour du système. Cette zone de transit doit être balisée à l'avance — n'allez pas chasser de l'espace au sol en pleine crise.
Une fois le réseau revenu, qu'est-ce qu'on réconcilie en premier ?
Réseau rétabli ne veut pas dire retour à la normale. Je passe en revue trois choses dans un ordre fixe, et l'ordre compte.
D'abord les horodatages. Le fait que les horodatages enregistrés hors ligne s'alignent sur l'heure du serveur décide de la séquence de votre grand-livre d'inventaire. Terminaux et serveurs doivent tous se synchroniser sur une source NTP ; dérivez de quelques minutes et les enregistrements hors ligne et en ligne s'entremêlent mal, et les écarts de comptage qui en résultent vous rendront fou. Quand j'accepte une conception hors ligne, je décale délibérément l'horloge d'un terminal de 10 minutes, je coupe son réseau, et je regarde si le système le détecte. Une conception qui ne peut pas détecter ça échoue à l'acceptation.
Ensuite les doublons et les pertes. Exportez le journal de téléversement de la file hors ligne et comparez-le ligne par ligne à la table des transactions d'inventaire du WMS : un scan a-t-il été écrit deux fois (lacune d'idempotence) ? Un scan a-t-il disparu (timeout de téléversement) ? Vérifiez d'abord la préparation et le rangement — ce sont les mouvements à haute fréquence ; la réception et les inventaires tournants peuvent attendre leur tour.
En dernier, la clôture du papier. Retirez les bons d'urgence un par un : bons émis, bons retournés, bons saisis — les trois nombres doivent correspondre avant de considérer que c'est terminé. S'il en manque un, suivez le registre manuscrit du superviseur vers le bas. Cette panne de 40 minutes à Ontario a pris un après-midi entier à réconcilier (mesuré sur le projet). Quarante minutes à l'arrêt, quatre heures de réconciliation — briefez la direction sur ce ratio à l'avance, ou elle supposera que tout va bien dès que les barres du WiFi reviendront.
Et ne déclarez pas « rétabli » tant que le rapport de réconciliation n'est pas signé. Ma règle : jusqu'à cette signature, le statut de l'entrepôt reste « opérations restreintes » vis-à-vis de l'extérieur.
Trois choses que vous pouvez faire cette semaine
- Faites un test de débranchement. Choisissez une fenêtre hors pointe, coupez un point d'accès dans la zone de préparation — ou mettez simplement un terminal en mode avion — et voyez si l'application peut terminer une vague hors ligne avec toutes les données intactes après la reconnexion. En vingt minutes, vous saurez si le mode hors ligne de votre WMS est réel.
- Imprimez 50 modèles de bons de préparation d'urgence. Fabriquez-les au format code-barres plus chiffres ci-dessus et enfermez-les dans le bureau du superviseur. À la prochaine panne de serveur, vous aurez au moins du papier.
- Synchronisez NTP sur chaque terminal et serveur. Connectez-vous à chaque terminal, comparez son horloge à celle du serveur, et corrigez toute dérive de plus d'une minute. C'est l'investissement de contingence le moins cher que vous ferez jamais.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.