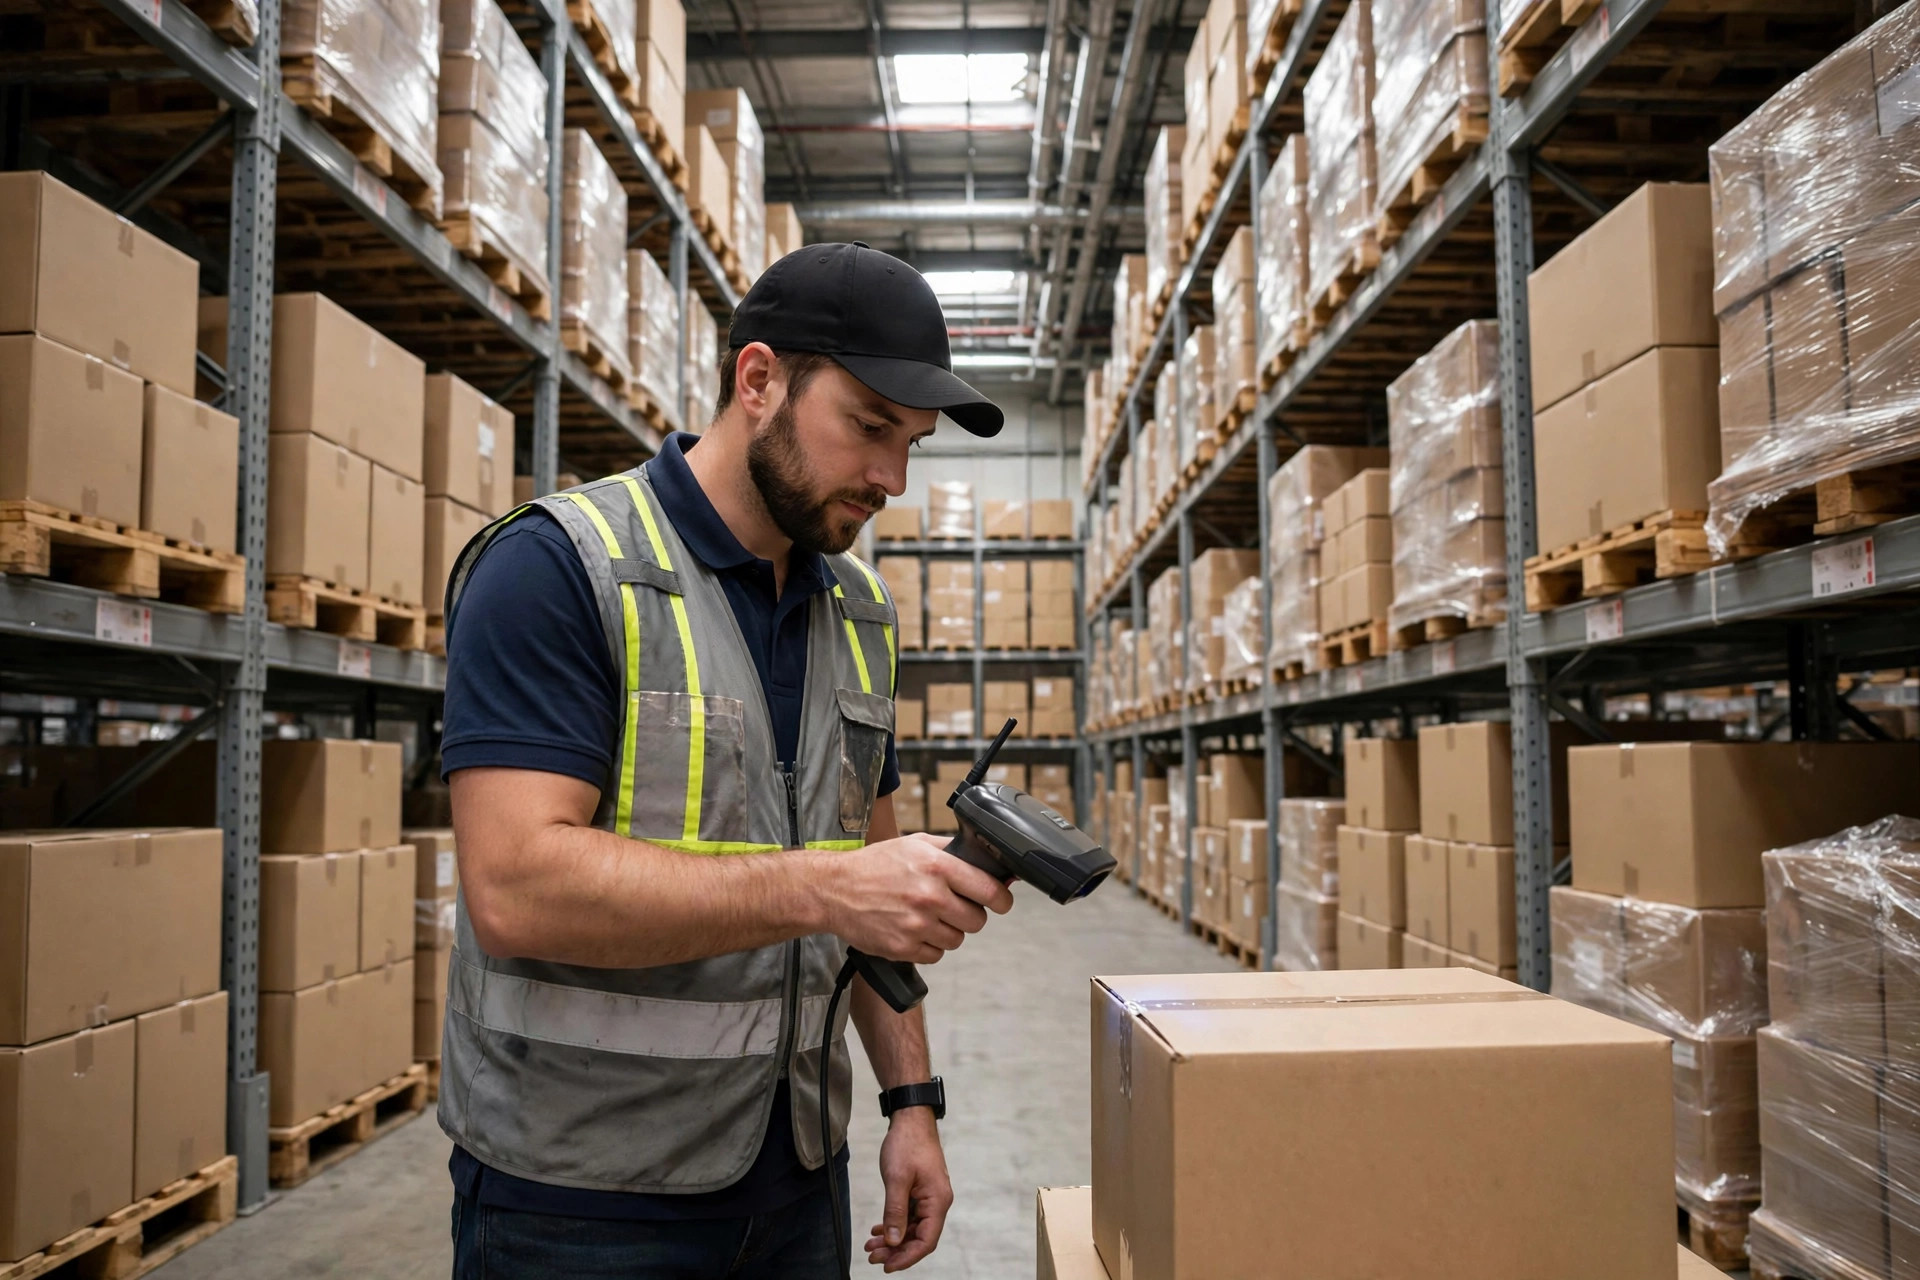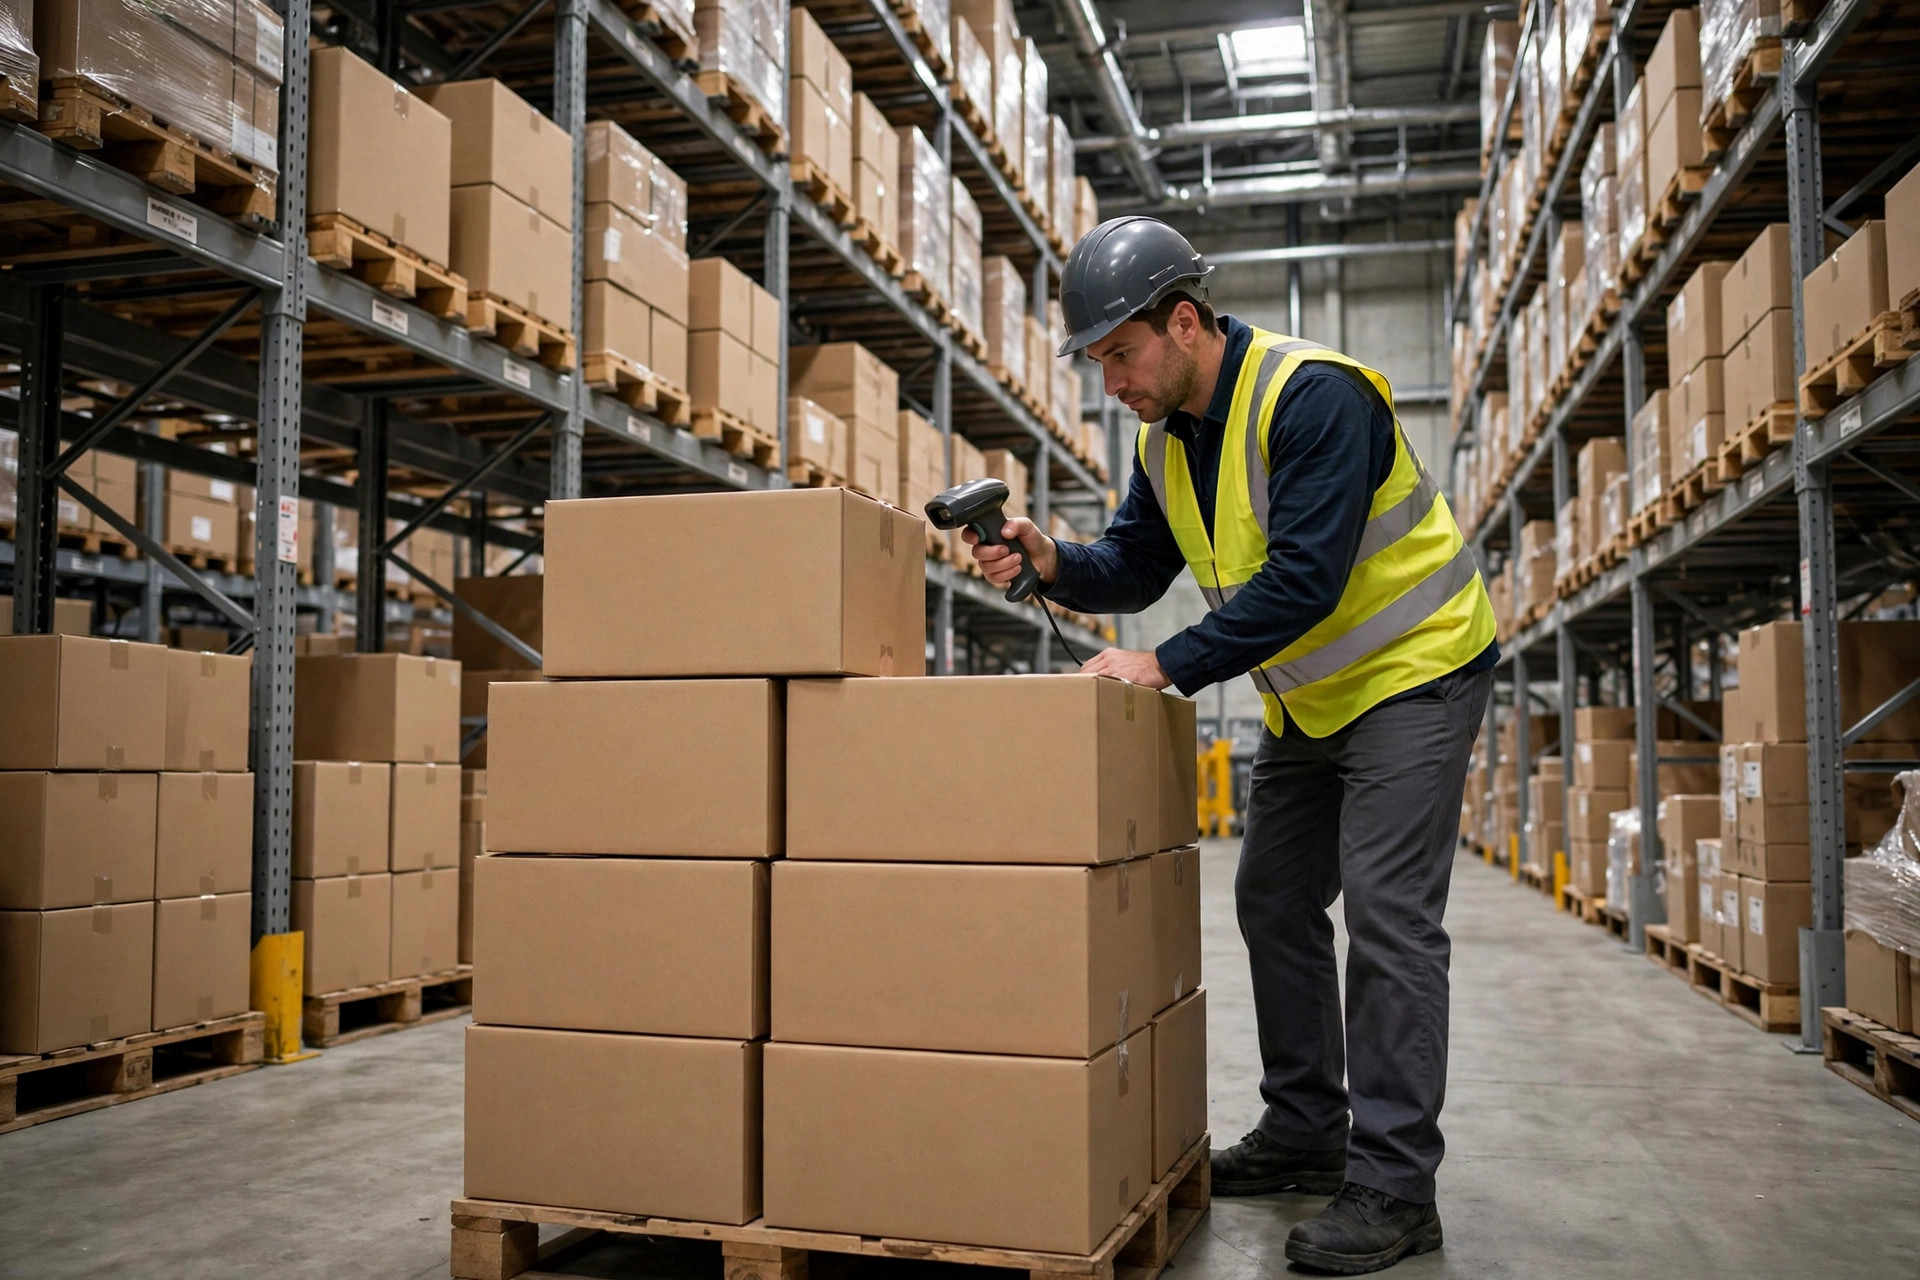
En 2019, j'ai travaillé sur un go-live WMS dans un entrepôt 3PL à Ontario, en Californie : 80 000 pieds carrés, 12 000 SKU. La première semaine après la bascule, le taux d'erreurs de picking est passé de 2% à 9%. Le service client s'est retrouvé noyé sous les appels. Le logiciel fonctionnait bien. Les intégrations fonctionnaient bien. Après trois jours d'investigation, l'équipe de mise en œuvre a trouvé le vrai problème : les données migrées de l'ancien système. Plus de 800 SKU n'avaient aucun code-barres, plus de 300 avaient des unités de mesure sens dessus dessous (colis et unités mélangés) et environ 50 codes d'emplacement ne correspondaient pas entre l'ancien et le nouveau système. Le propriétaire avait dépensé $400,000 dans un nouveau système et s'est fait mettre à genoux par une poignée de feuilles de calcul.
Mon verdict d'emblée : le nettoyage des données de référence est le travail le plus rentable de tout projet WMS. Il ne coûte presque rien, et si vous le sautez, chaque dollar dépensé ensuite servira à réparer ses dégâts. La plupart des retards de go-live que j'ai vus n'avaient rien à voir avec le logiciel. C'étaient des problèmes de données.
Beaucoup pensent que migrer des données, c'est exporter un tableau. Ce n'est pas ça. Les données du système ancien sont écrites pour les humains ; les données du WMS sont écrites pour les machines. Une personne lit « environ 2 colis » et comprend. Une machine non : de mauvaises unités cassent l'algorithme de réapprovisionnement, des codes-barres manquants bloquent le flux de scan, et de mauvais emplacements envoient les tâches dans le vide.
Check-list un : les données de référence SKU, cinq champs, aucune exception
Les SKU sont la partie la plus sale des données de référence. Passez cette liste en revue point par point :
Codes-barres. Chaque SKU a besoin d'au moins un code-barres scannable, un UPC ou un code interne. Le pire cas que j'aie vu : 800 SKU sur 12 000 sans code-barres, et la réception se faisait à l'œil en regardant les cartons. La solution n'a rien de glamour mais elle marche : quatre semaines avant le go-live, sortez tous les SKU sans code-barres et collez-leur une étiquette de code-barres interne. Ne vous dites pas que vous les « ajouterez après le go-live ». Après le go-live, vous n'aurez pas le temps d'étiqueter quoi que ce soit.
Unités et conversions. Unités à l'unité, suremballages, colis, palettes : chaque niveau a besoin d'un facteur de conversion. Le piège classique, c'est un SKU avec plusieurs unités : les achats réceptionnent en colis, les ventes expédient à l'unité, et l'ancien système n'enregistrait que les colis. Avant d'importer dans le WMS, renseignez chaque conversion « 1 colis = 24 unités », sinon chaque quantité de tâche de picking sera fausse.
Poids et dimensions. Ces deux champs alimentent le calcul des frais de transport et le slotting. Les SKU sans poids ne peuvent pas servir à l'optimisation du chargement ; les SKU sans dimensions cassent le calcul de cube du moteur de réapprovisionnement. La méthode pratique : pesez et mesurez 200 SKU représentatifs, estimez le reste par famille de produits. Tout vaut mieux que de laisser les champs vides.
Attributs de lot et de péremption. Les entrepôts alimentaires, pharmaceutiques et cosmétiques doivent signaler si un SKU est géré à la date de péremption. Ce seul champ décide si le WMS active la logique FEFO, et le changer plus tard signifie reconstruire le processus.
Marqueurs de matières dangereuses. Les SKU avec des batteries ou des liquides sont signalés tôt : cela détermine s'ils peuvent partager des zones avec la marchandise générale. Le réparer quand le chef des pompiers se présente, c'est trop tard.
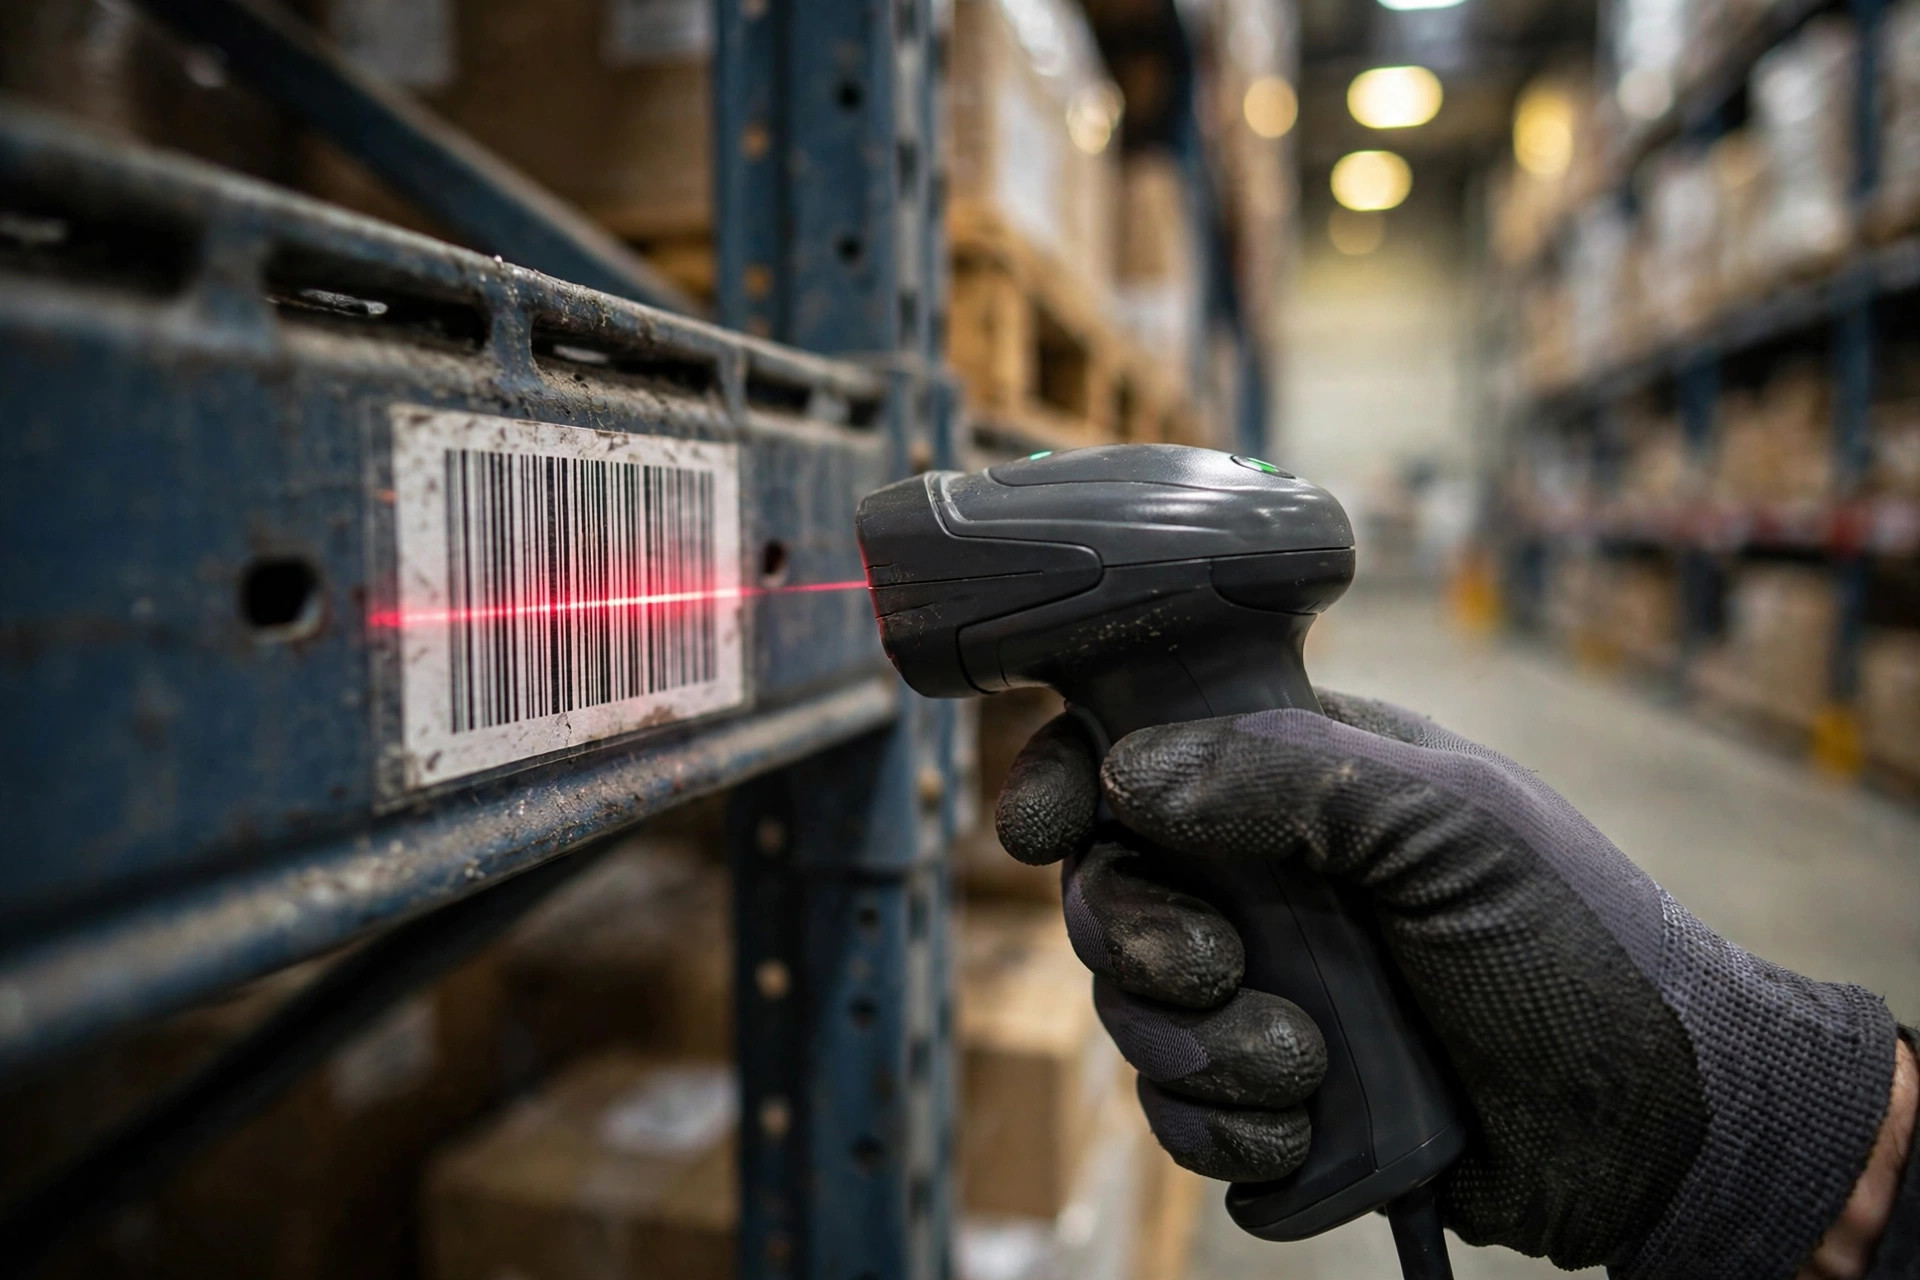
Check-list deux : les données de référence emplacements, où les emplacements fantômes sont le tueur numéro un
Les données d'emplacements sont plus sournoises que les données SKU parce que personne ne les regarde au quotidien. Trois points :
Un seul schéma de codification. Les codes d'emplacements anciens et nouveaux doivent correspondre un pour un. J'ai vu un ancien système utilisant « A-01-02 » face à un nouveau système attendant « A0102 » : l'import a tronqué les codes et 300 emplacements n'existaient tout simplement pas dans le nouveau système. La table de correspondance doit être confirmée par un humain, ligne par ligne. Ne faites pas confiance au script.
Attributs d'emplacement. Chaque emplacement est étiqueté : face de picking, stockage de masse, zone de retours ou zone d'exception. Si les attributs sont faux, le système réapprovisionnera des palettes entières dans un slot de picking de 6 pieds qui ne peut physiquement pas les contenir.
Tuez les emplacements fantômes. Les emplacements qui existent dans le système mais pas sur le terrain - ou sur le terrain mais pas dans le système - doivent être parcourus avant le go-live. Ma méthode : deux équipes qui se contrôlent mutuellement. Une personne prend la liste du système et chasse chaque emplacement sur le terrain ; une autre parcourt le terrain en étiquetant et en réconciliant vers le système. Deux personnes peuvent parcourir 80 000 pieds carrés en deux jours.
Check-list trois : les soldes d'ouverture - mieux vaut trois jours de retard qu'une saisie erronée
Une fois les données dedans, les soldes d'inventaire doivent être justes. Ma règle de fer : faire un inventaire complet mur à mur avant le go-live, pas un inventaire par échantillonnage. Une précision d'échantillonnage de 98% semble correcte, mais les 2% restants d'écarts exploseront tous en exceptions de picking la première semaine.
Utilisez le comptage pour faire trois choses à la fois : signalez le stock mort et liquidez ce que vous pouvez - n'emportez pas des données pourries dans le nouveau système ; réétiquetez l'ancien inventaire avec des numéros de lot non standard ; et isolez tout ce qui a moins de 30 jours de durée de vie restante pour qu'il parte en premier après le go-live.
Mon calendrier habituel : commencer le nettoyage des SKU à T moins 6 semaines, commencer la visite physique des emplacements à T moins 4, faire l'inventaire complet et geler les données à T moins 2 (après le gel, l'ancien système n'expédie que, rien n'est réceptionné), et faire la répétition de migration à T moins 1. Pour un entrepôt de 10 000 SKU, deux personnes peuvent terminer tout le nettoyage en trois semaines. Comparez avec le sauter : au moins six semaines de reprises après le go-live, plus la confiance des clients que vous brûlez.
Ce que ça coûte vraiment de le sauter
Revenons à cet entrepôt d'Ontario. Des données sales sont passées en production, les erreurs de picking ont atteint 9% la première semaine, et la deuxième semaine, le client a commencé à invoquer les pénalités de précision du contrat 3PL - la plupart s'appliquent en dessous de 98.5%. La troisième semaine, le propriétaire a stoppé toute intégration de nouveaux clients et a mobilisé deux personnes à plein temps pendant trois semaines de reprises : réétiqueter les codes-barres, combler les conversions d'unités, parcourir chaque emplacement.
Le bilan : plus de $20,000 de main-d'œuvre de reprise, plus de $10,000 de pénalités, un mois de retard de projet (encore $30,000 d'honoraires de consultants). Total au nord de $60,000. Le nettoyage sauté aurait coûté moins de $10,000 et deux semaines. Le nettoyage des données n'est pas un coût. C'est la police d'assurance la moins chère de tout le projet.
Les données ont besoin d'un responsable
Les check-lists ne servent à rien sans responsables. Neuf efforts de nettoyage sur dix qui s'enlisent le font parce que « tout le monde travaille dessus et personne n'en est responsable ». Ma répartition :
Les données SKU appartiennent aux achats ou à l'équipe produit. Eux seuls savent combien de configurations de colisage un SKU a vraiment. Le personnel de l'entrepôt qui devine depuis une feuille de calcul devinera faux. Un responsable nommé par famille de produits - sa validation signifie que le lot est terminé.
Les données d'emplacements appartiennent à l'exploitation de l'entrepôt. C'est leur entrepôt ; seuls ceux qui le parcourent chaque jour peuvent trouver les emplacements fantômes. Les chefs d'équipe parcourent, le consultant prend des notes - pas l'inverse.
Les soldes d'ouverture sont validés à double signature par la finance et l'entrepôt. Les soldes d'ouverture dans le nouveau système deviennent les chiffres d'ouverture des livres comptables. S'ils ne concordent pas, la clôture mensuelle sera un enfer. La double signature signifie que l'exploitation possède les quantités et la finance possède les dollars.
Une autre règle de fer : le consultant de mise en œuvre fournit des modèles et des règles de validation, mais n'est jamais propriétaire des données. Inscrivez au contrat que la préparation des données est la responsabilité du client, sinon chaque retard deviendra « les données n'étaient pas prêtes » - leur carte de sortie de prison.
Répétez la migration : faites-la deux fois avant la vraie
Des données propres ne vont pas directement en production. Le mouvement standard, c'est deux répétitions :
Premier passage, échantillon de 10%, vérification de la logique : codes-barres en double, conversions d'unités vides, codes d'emplacements que le nouveau système ne trouve pas. La validation peut être embarrassamment simple : un NB.SI pour les codes-barres en double dans Excel, un RECHERCHEV contre la carte des emplacements. Simple, ça marche.
Deuxième passage, volume complet, chronomètre en main : 12 000 SKU plus 8 000 emplacements - combien de temps prend l'import, combien une restauration ? Ces deux chiffres définissent la fenêtre de temps de votre nuit de go-live. Ma barre : import complet plus validation en moins de quatre heures. Plus long que ça signifie que les données ou le script ont besoin de travail avant de fixer une date de go-live.
Après le gel à T moins 2, l'ancien système n'expédie que - pas de nouveaux SKU, pas de changements d'emplacements. Deux semaines de nouvelles réceptions passent sur un registre manuel et sont saisies le premier jour après le go-live. L'avis de gel est diffusé à chaque personne concernée, et la signature papier est ce qu'il y a de mieux. Ce que vous craignez le plus dans un gel, c'est que quelqu'un modifie discrètement l'ancien système - une modification là-bas, c'est un écart dans le nouveau système.
Une chose que vous pouvez faire demain : exportez votre table SKU de l'ancien système et filtrez-la de trois façons - pas de code-barres, pas de poids, unités multiples. Comptez les lignes rouges. Ce nombre est l'exposition réelle au risque de votre projet WMS. Nettoyez d'abord cette table, puis parlez des dates de go-live.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.