Le téléphone a sonné à 2 h du matin. Un superviseur de quart d'un DC e-commerce à Riverside criait presque : « Lao Mi, le trieur est devenu fou ! Le même carton vient d'être scanné trois fois, les chutes débordent, le convoyeur va bientôt se bloquer ! »
Je lui ai dit de garder les mains loin de l'équipement et de sortir plutôt deux fichiers de log. Une demi-heure plus tard, il a rappelé, l'air gêné : « Vous aviez raison... le WES a libéré la même vague deux fois. »
J'ai vu ce film trop de fois. Sur le terrain, on dit toujours « le système fait des bugs ». D'après mon expérience, neuf fois sur dix, ce qui ressemble à un bug, c'est le WES et le WCS qui se battent — et la cause racine est presque toujours l'interface entre les deux. Voici la chaîne de dépannage que j'utilise réellement, du symptôme à la cause racine.
Ne touchez pas à la ligne. Faites d'abord parler les deux journaux.
Les conflits de commandes meurent généralement de deux façons : double expédition d'une tâche, ou rappel de statut perdu. Le WES envoie une commande de libération, le réseau hoquette, l'accusé de réception ne revient jamais, alors le WES renvoie la même commande après son timeout configuré. Le WCS accepte les deux avec plaisir — parce que personne n'a intégré de déduplication par numéro de tâche dans l'interface. Une tâche entre deux fois dans la file de tri, et le même colis est demandé par la chute deux ou trois fois.
La première étape est toujours la même : mettez côte à côte le journal d'expédition du WES et le journal de réception de commandes du WCS, et alignez les numéros de tâche un par un. Mais il y a un piège qui attrape huit entrepôts sur dix : les horloges des deux serveurs ne sont pas synchronisées. Le journal du WES dit que la commande est partie à 02:14:03 ; celui du WCS dit qu'elle a été reçue à 02:13:47. Quand les horodatages ne concordent pas, on ne peut jamais établir la cause et l'effet. Avant de toucher un log, vérifiez que les deux côtés sont sur NTP — et vérifiez le fuseau horaire. J'ai vu plus d'un site où un côté loguait en UTC et l'autre en heure locale.
Je me suis moi-même fait piéger en 2021, dans un DC à Ontario, de plus de cent mille pieds carrés, avec un trieur à courroies croisées. En pleine saison, au milieu de la nuit : le même colis est apparu trois fois dans le système. Avec les deux logs sur la table, c'était limpide — le WES avait libéré la vague deux fois, espacées d'exactement un intervalle de timeout, et le journal d'exécution du WCS montrait deux numéros de tâche identiques, tous deux honorés. Cause racine en une phrase : réémission sur timeout frappant une interface sans idempotence.
Un vrai compromis se cache dans cette valeur de timeout. Trop court, et chaque microcoupure réseau déclenche une fausse réémission ; trop long, et les changements de vague et les commandes urgentes restent plantés là. Ce nombre ne peut pas être une devinette — il doit sortir de la latence mesurée sur votre réseau réel, et le nombre de tentatives avec la politique de backoff appartient à la spec d'interface, par écrit. Trop d'intégrateurs en restent à un accord verbal, et l'accord sort par la porte avec l'ingénieur.
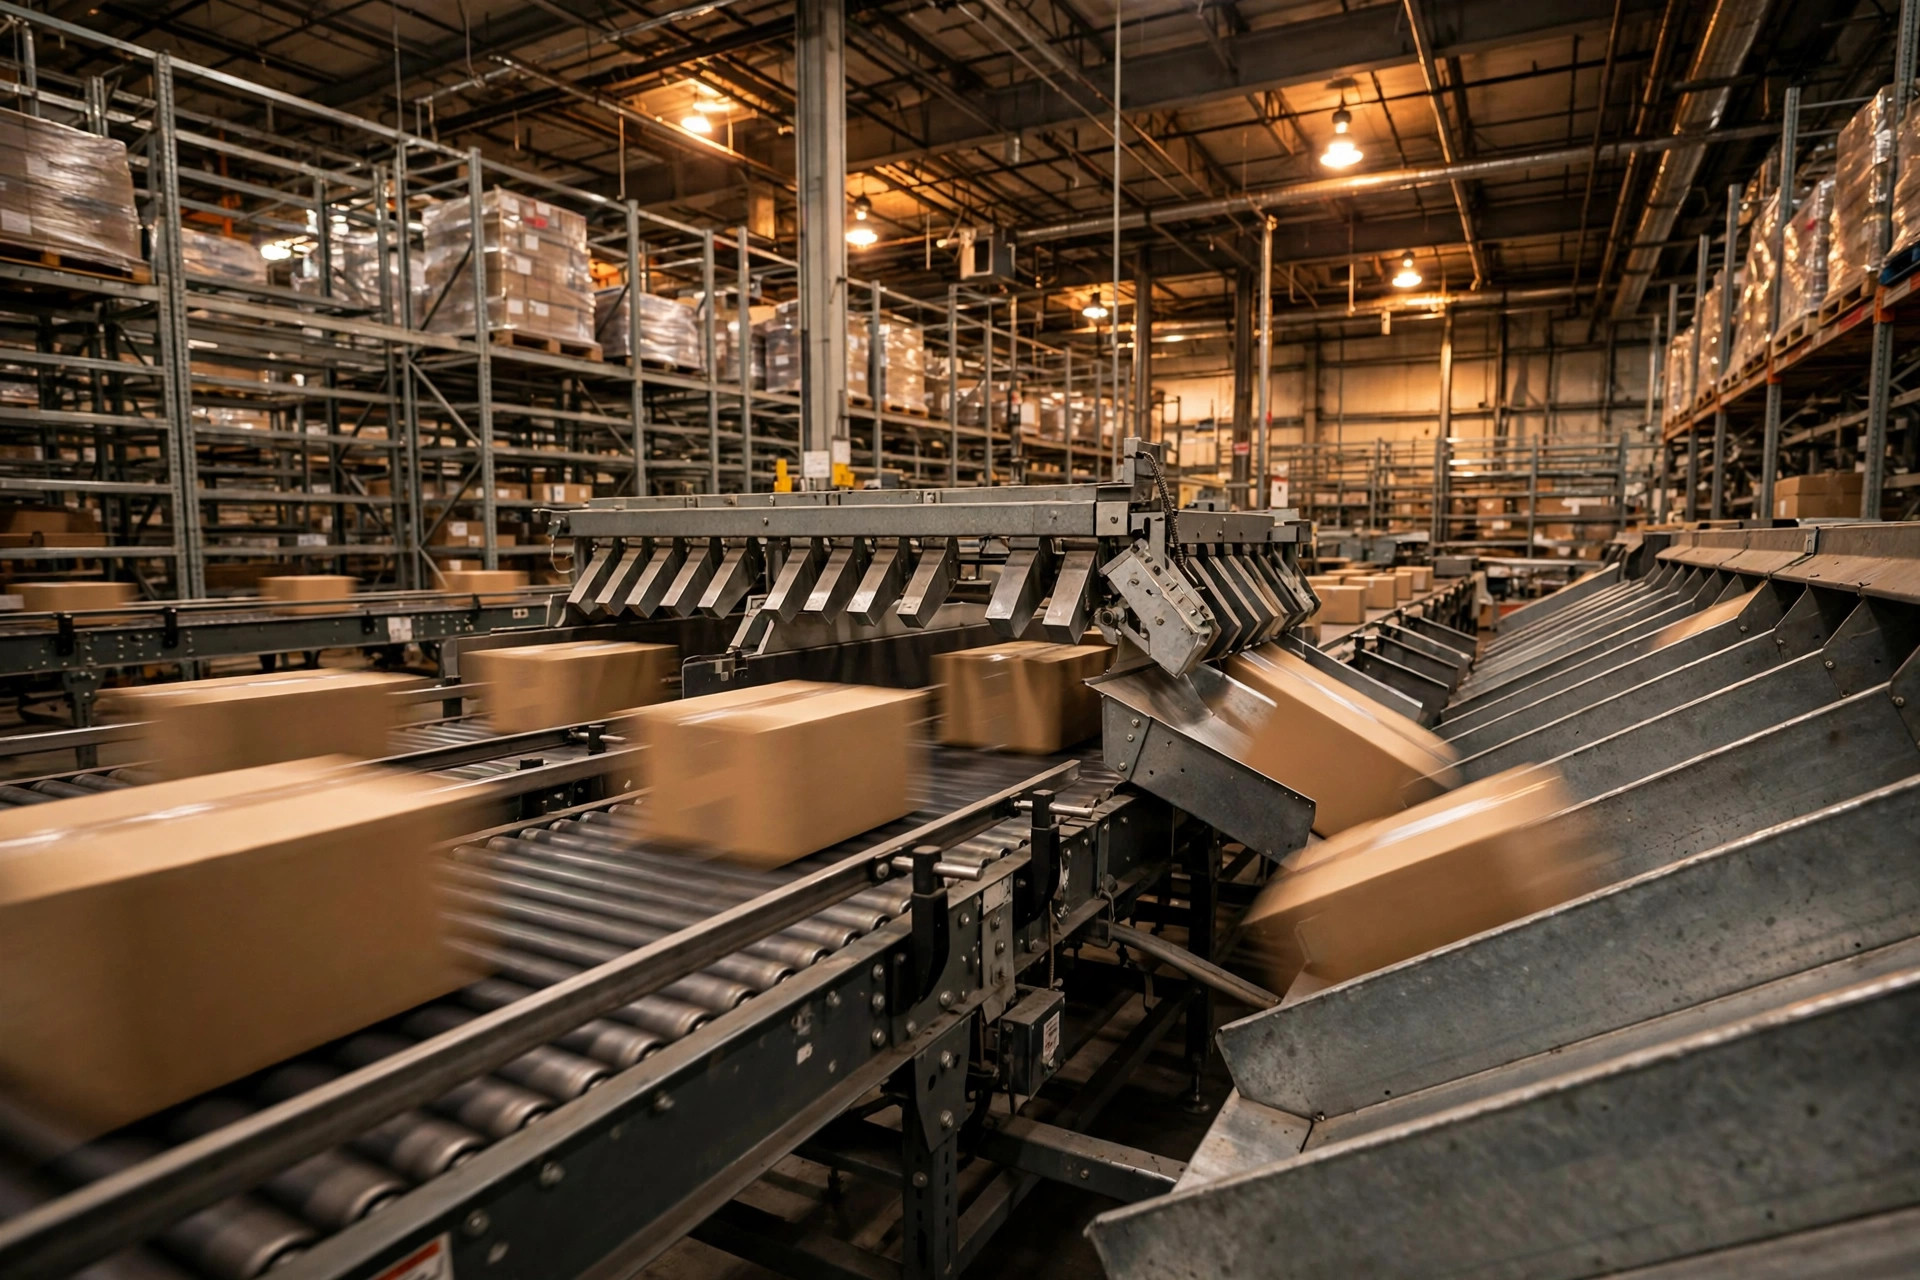
Quand une commande urgente éjecte une tâche en cours, où va l'ancienne tâche ?
La préemption par commande urgente est la zone de conflit la plus vicieuse, et la logique est plus retorse qu'une simple duplication. Le WES reçoit une commande urgente, marque une partie des tâches de la vague en cours comme annulées, et glisse les nouvelles tâches dedans. Mais le WCS a déjà poussé ces commandes vers l'automate — l'annulation arrive trop tard pour arrêter un aiguillage déjà en mouvement. Maintenant le même colis est appelé à la chute A par l'ancienne tâche et à la chute B par la nouvelle. À laquelle l'équipement obéit-il ?
Le dépannage consiste à suivre deux fils : la machine à états des tâches du WES (l'annulation est-elle vraiment partie, et exactement quand ?) et la file de commandes du WCS (où en était cette commande dans son exécution quand l'annulation est arrivée ?). La preuve décisive reste l'écart d'horodatage — quand l'annulation a été émise contre quand la commande a réellement fini de s'exécuter. Faites le calcul et vous saurez si l'annulation avait une chance de rattraper.
Il y a un piège plus subtil en dessous : les deux côtés ne parlent même pas les mêmes numéros de tâche. Le WES utilise ses propres IDs de tâche ; le WCS les traduit en numéros de commande d'équipement, avec une table de correspondance au milieu. Perdez cette table et les deux systèmes se parlent à côté. Je l'ai vu en 2023 dans un entrepôt près de Chicago — la table de correspondance vivait en mémoire, le service WCS a redémarré dans la nuit, et elle a disparu. L'ingénieur de nuit a fixé les deux logs sans trouver une seule tâche correspondante. Non parce que rien n'était logué, mais parce que les numéros ne s'alignaient pas. Le remède n'a rien de glamour mais il est efficace : persistez la table de correspondance sur disque, et faites en sorte que le log du WCS porte le numéro de tâche WES d'origine jusqu'au bout.
Et voici mon verdict sur les commandes urgentes : pas de préemption dure sauf si votre volume l'exige. Donnez aux commandes urgentes leur propre chute ou leur propre vague — ne touchez pas aux tâches déjà en cours d'exécution. Les quelques minutes gagnées par la préemption ne couvriront pas le coût d'un bourrage de ligne. S'il faut préempter, l'annulation doit être en deux phases : une pré-annulation qui verrouille les commandes non exécutées côté WCS, puis une annulation formelle ; tout ce qui est déjà en mouvement passe par un flux de compensation après exécution. S'attendre à ce qu'une seule commande d'annulation batte la physique, c'est juste manquer de respect à la vitesse de la lumière.
Arrêtez de demander pourquoi. Rendez-le idempotent.
Les deux modes de défaillance ci-dessus partagent une cause racine : l'interface n'est pas idempotente. Ce qu'il faut côté WES est simple — chaque tâche porte un numéro de tâche globalement unique, et les réémissions gardent le même numéro. Côté WCS : à la réception, vérifier « ai-je déjà vu ce numéro de tâche ? » ; si oui, répondre succès et ne pas réexécuter. Les rappels de statut fonctionnent pareil — joignez un numéro de séquence strictement croissant pour que le WES puisse trier lui-même les rappels hors ordre ou en double.
À la réception, je remets à l'intégrateur trois phrases, et elles entrent en annexe du contrat : premièrement, coupez le réseau quelques secondes et reconnectez — aucune tâche ne doit s'exécuter deux fois. Deuxièmement, redémarrez le WCS — les correspondances de tâches historiques doivent survivre. Troisièmement, annuler une commande urgente contre une tâche en cours d'exécution doit déclencher une action de compensation définie, pas juste « l'annulation a été envoyée ». Passez ces trois tests et quatre-vingt-dix pour cent des histoires de fantômes de la couche d'exécution n'arrivent jamais.
Mon verdict tient : neuf fois sur dix, les « bugs du système » sont des interfaces sans idempotence. Du dixième restant, moitié d'horloges non synchronisées, moitié d'une main tremblante sur un bouton à 2 h du matin.
Avant votre prochaine mise en production, débranchez vous-même le câble réseau quelques secondes et rebranchez-le. Seul un système qui survit à ces quelques secondes mérite votre saison de pointe.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.