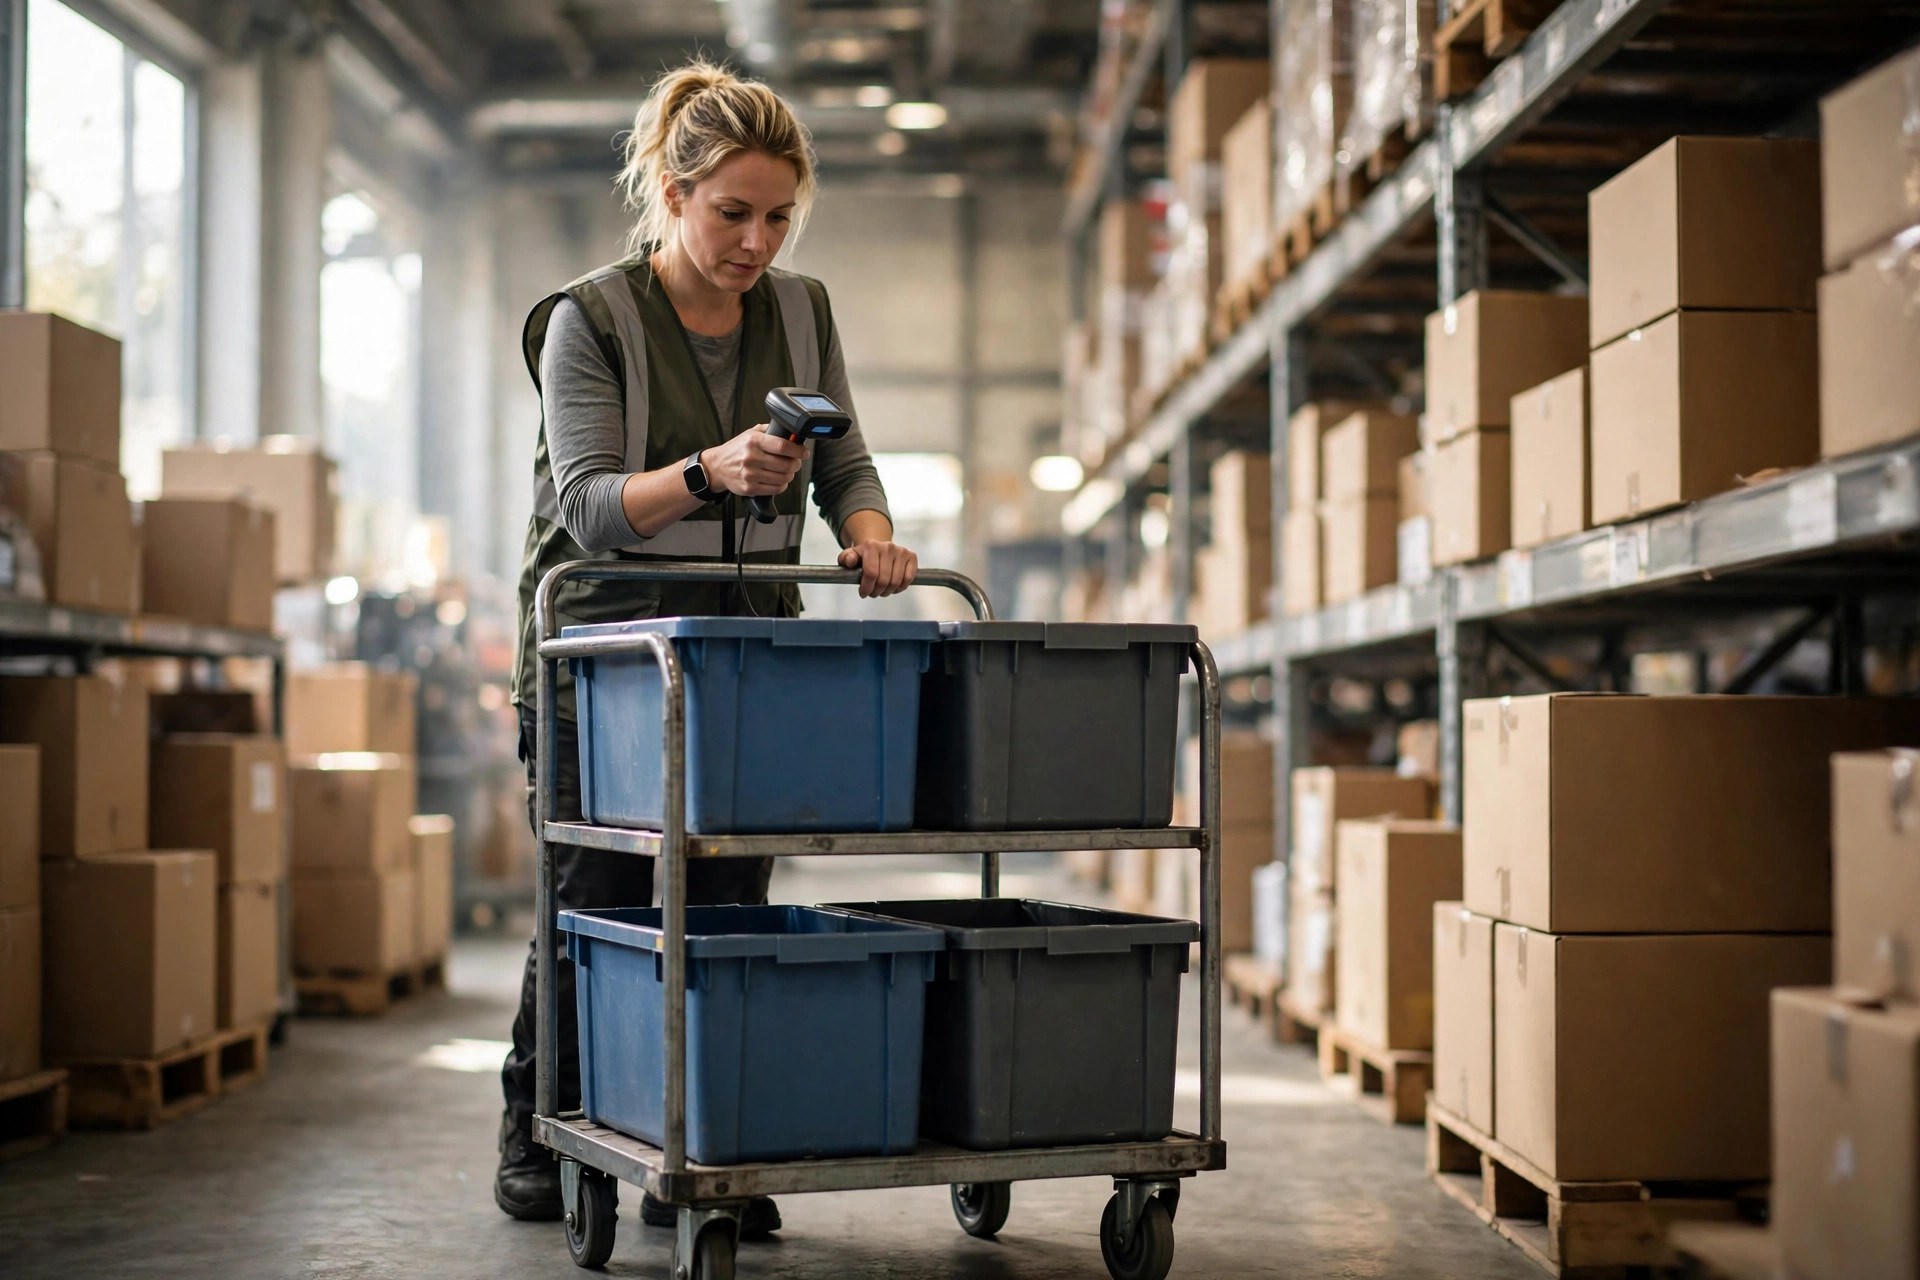
C'était un mercredi matin de mars 2024, et je me tenais dans un entrepôt 3PL de 120 000 pieds carrés à Ontario, en Californie, à regarder leur WES fraîchement installé traiter sa première vague d'un jour de pic. Un préparateur poussait son chariot dans l'allée C-07, s'est arrêté devant un emplacement et a fixé son scanner RF. La tâche disait douze unités. L'emplacement en avait sept, et les étiquettes ne correspondaient pas à ce qui s'y trouvait. Il a saisi "short pick" et a renvoyé la tâche au système.
Cette partie-là était normale. Ce qui a suivi, non.
Le système, tout "obligeant", a remis la tâche directement dans le pool de la vague. Vingt minutes plus tard, un autre préparateur a reçu la même tâche, a marché jusqu'au même emplacement et s'est heurté au même mur. À midi, la tâche avait rebondi entre trois ou quatre préparateurs, un short pick à chaque fois, et le voyant de consolidation de la vague refusait de passer au vert. Tout le lot de sortie attendait sur le quai pendant que le camion du transporteur klaxonnait dehors — tout ça pour une unité que personne ne trouvait.
Le responsable de l'entrepôt, debout à côté de moi sur le quai, m'a dit quelque chose que je n'ai jamais oublié : « On a dépensé une fortune dans ce système, et ce qu'il fait de mieux, c'est renvoyer des problèmes qu'il ne peut pas résoudre. »
La plupart des entrepôts se débrouillent bien pour dispatcher des tâches via leur WES. Ce qui fait vraiment la différence, c'est ce qui se passe après qu'une tâche a mal tourné — comment le système la récupère, la renvoie, la réassigne et boucle la boucle. C'est de ça que parle cet article : la mécanique du reflow pour les tâches d'exception.
La tâche est retournée dans la vague. Et ensuite ?
Commencez par classer les exceptions en catégories. En vingt ans, j'ai vu toujours les mêmes cinq, encore et encore : les short picks (stock insuffisant), les ruptures (rien du tout), les unités endommagées ou marquées qualité, les écarts de scan (mauvaise étiquette, mauvais emplacement) et les retenues qualité en attente de libération QC. Cette étape paraît triviale, mais c'est là que beaucoup d'entrepôts meurent — ils configurent trente codes de motif, les préparateurs pressés tapent le premier, et tous les rapports suivants sont à jeter.
Pour les chemins de reflow, j'en garde trois. Pas plus.
Premièrement, retour dans le pool de la vague. Ça convient aux exceptions qu'un autre préparateur ou un autre moment peut résoudre — par exemple, un short pick dont le réassort est déjà en route. Mais plafonnez le nombre de fois. Sur ce site d'Ontario, la même tâche a fait reflow quatre fois en une matinée. Ma règle : après trois reflows, la tâche se convertit automatiquement en tâche manuelle. Ne vous tracassez pas avec la configuration. Une vague qui ne peut pas se consolider coûte bien plus cher.
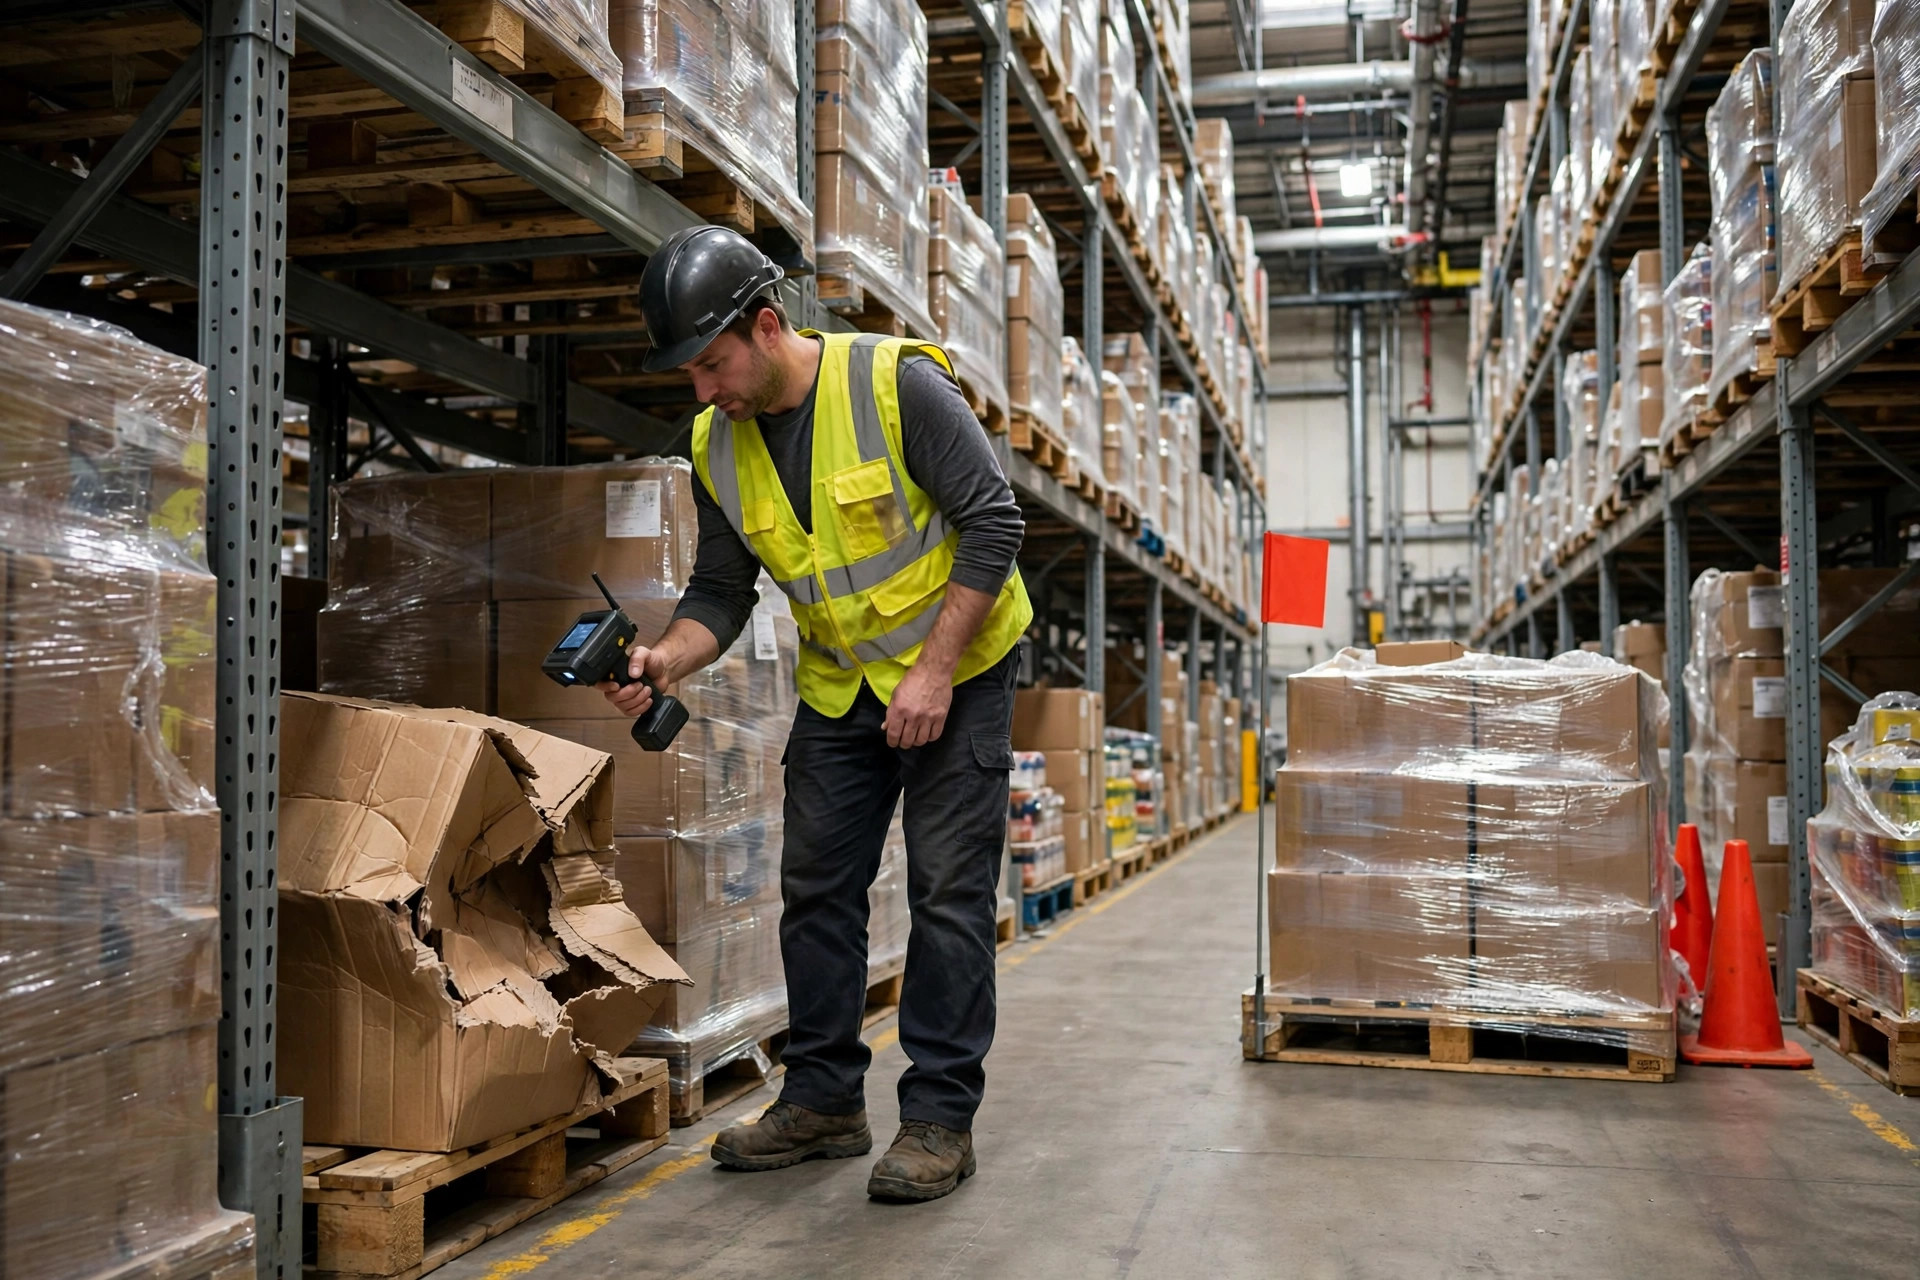
Deuxièmement, conversion en tâche manuelle. C'est pour les exceptions qui demandent du jugement humain — dommages, retenues qualité. Le point clé : « manuel » ne doit pas signifier « jeté dans une file que personne ne regarde ». Routez-la vers une équipe — les dommages vont au QC, les écarts d'emplacement à l'équipe d'audit — et gardez-la visible sur le RF, pas invisible dans le système.
Troisièmement, suspension. C'est pour ce qui est temporairement insoluble — un problème de lot en attente de confirmation fournisseur, par exemple — sans pouvoir laisser ça bloquer la vague. La suspension n'est pas une suppression : il faut une condition de réveil claire et un temps de suspension maximum, après quoi l'escalade est automatique.
Le compromis est réel. Le reflow dans la vague est le moins cher mais risque le jeu de la patate chaude. Les tâches manuelles sont les plus fiables mais la file manuelle ne cesse de grossir. La suspension est la plus propre mais facile à oublier. Mon approche : pré-régler le chemin par défaut par motif d'exception, pour que le préparateur sélectionne seulement un code de motif et que le système route par règle. Laissez le jugement aux règles, le travail de terrain aux gens.
Combien de temps peut-elle rester sans être touchée avant de devenir un vrai problème ?
Le reflow n'est que l'étape un. Le vrai trou noir, c'est une exception qui traîne dans le système sans que personne la regarde.
Je recommande deux niveaux d'escalade — pas cinq, personne ne retient cinq. Niveau un : trente minutes après la création de l'exception sans que personne ne la prenne, escalade au chef d'équipe — pop-up RF plus alerte sur le terminal du chef. Niveau deux : si l'exception bloque la consolidation de la vague, avec d'autres tâches en attente dessus, escalade en quinze minutes, directement au superviseur.
Notez que j'ai dit pop-up et alerte terminal, pas e-mail. Je me suis brûlé là-dessus : un entrepôt avait de magnifiques règles d'escalade qui envoyaient un e-mail au superviseur à chaque dépassement. Le superviseur recevait plus de quarante e-mails système par jour et avait depuis longtemps mis en place une règle d'archivage automatique. Un carton endommagé est resté dans la cage des exceptions pendant trois jours, jusqu'à ce qu'un client se plaigne d'un manquant. Escalader, c'est voler l'attention de quelqu'un. L'e-mail ne peut pas la voler, donc il faut quelque chose de plus bruyant.
Il y a aussi un compromis ici. Un seuil trop serré, et c'est la fatigue des alarmes — les chefs deviennent insensibles. Trop lâche, et les exceptions expirent en silence. Ma pratique : commencer serré les deux premiers mois pour faire remonter les vrais problèmes de processus, puis desserrer quand ça se stabilise. Et une chose de plus : journalisez qui a reconnu ou pris l'exception, et quand. Sans ça, chaque post-mortem finit en jeu de blâmes sans tableau de score.
Vous avez journalisé toutes ces données d'exception. Qu'est-ce que vous regardez vraiment ?
Beaucoup d'entrepôts journalisent des montagnes de données d'exception du WES, puis ouvrent le rapport et trouvent « 312 short picks » — techniquement vrai, totalement inutile. Journalisez les données, mais journalisez les bonnes.
Enregistrez au moins huit champs par exception : numéro de tâche, SKU, emplacement, code de motif, horodatage, responsable, compteur de reflows, disposition finale. Gardez les codes de motif entre huit et dix. Plus, et personne ne sélectionne avec soin ; moins, et le post-mortem ne montre rien. Mon jeu habituel : short pick, rupture, endommagé, écart d'étiquette, confusion d'emplacement, retenue qualité, panne d'équipement, autre. Si « autre » dépasse quinze pour cent, votre liste de codes est incomplète — ajoutez des codes.
Trois chiffres suffisent pour la revue. Oubliez le deck de vingt diapos.
Premièrement, les cinq SKU avec le plus de reflows répétés. Un SKU qui fait short pick encore et encore est presque toujours un problème de slotting ou de réassort, pas un problème de préparateur. Sur ce site d'Ontario, le SKU patate chaude s'est avéré avoir un stock de sécurité inférieur à son volume moyen de picks par jour. Le réassort ne rattrapait jamais.
Deuxièmement, la part des exceptions qui expirent sans être clôturées — regardez la tendance. Si elle grimpe, votre capacité de traitement manuel ne suit plus le volume des exceptions. Ajoutez des gens ou réparez le processus.
Troisièmement, les évolutions dans le mix des codes de motif. Si « écart d'étiquette » double en un mois, il y a de fortes chances que le fournisseur d'étiquettes ait changé ou que la formation des nouveaux embauchés ait glissé. Les données sont le symptôme ; le processus est la cause.
Voici une checklist à passer au crible de votre go-live WES ou de votre révision : y a-t-il plus de dix codes de motif ? Y a-t-il un plafond de reflows ? Les exceptions bloquant la vague ont-elles leur propre horloge d'escalade ? L'escalade repose-t-elle sur le seul e-mail ? Les tâches suspendues ont-elles un âge maximum et une condition de réveil ? Vos rapports peuvent-ils sortir les cinq SKU avec le plus de reflows répétés ? Si tout ça est bon, votre reflow d'exceptions est globalement solide.
Revenons à ce mercredi. L'entrepôt d'Ontario a ensuite plafonné les reflows à trois, avec conversion automatique en tâche manuelle d'audit au quatrième — et ce type de problème a chuté fortement en deux mois. Mais voici la question que je vous laisse : sortez les données d'exception du mois dernier de votre entrepôt — quelle part des tâches a fait reflow plus de deux fois ? Si vous ne pouvez même pas sortir ce chiffre, alors aussi élégant que soit votre design de reflow, c'est de la décoration.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.