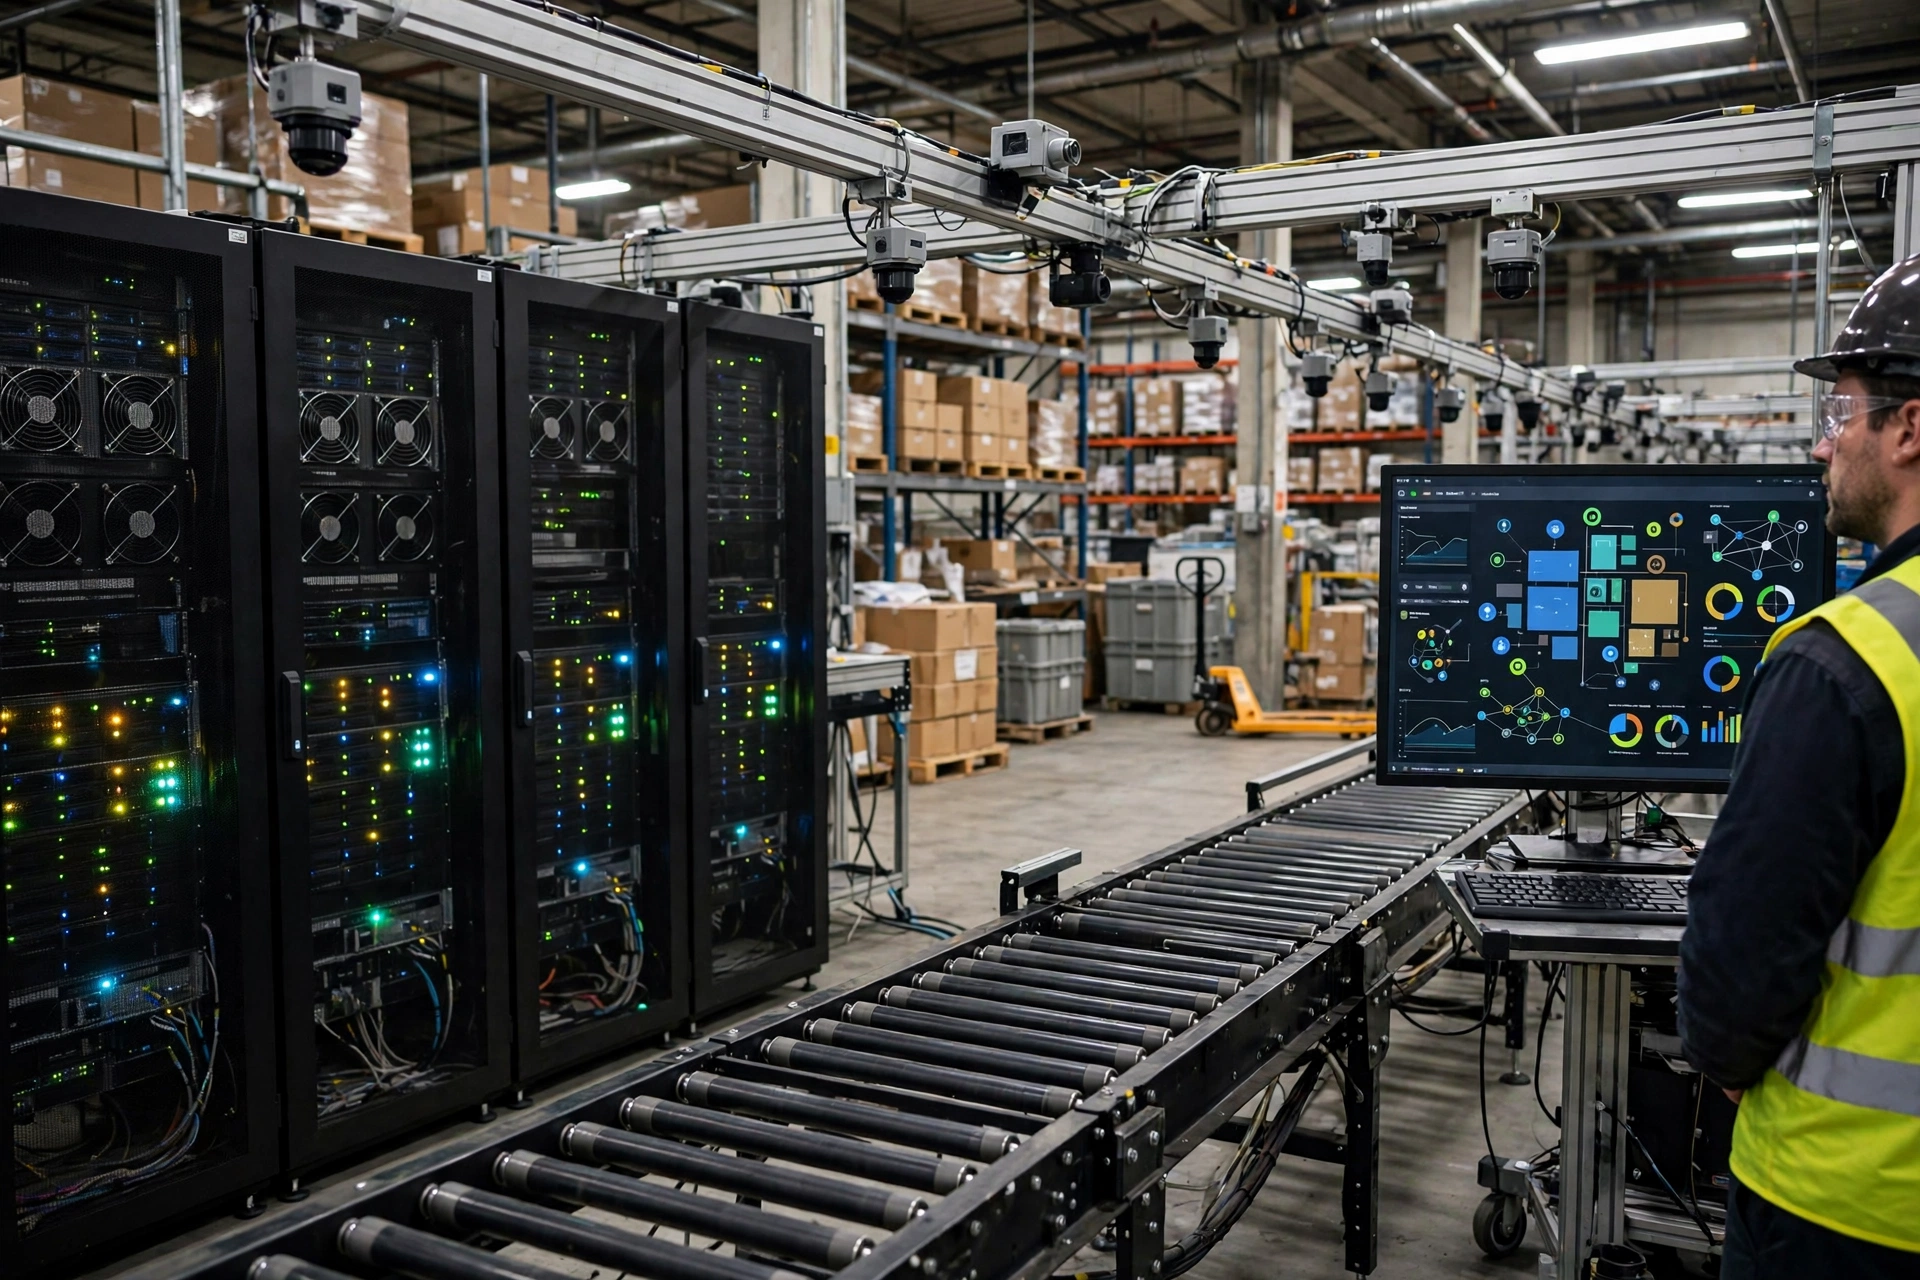
La question de l'edge computing ou du cloud pour l'IA d'entrepôt se pose aujourd'hui dans presque tous les projets de digitalisation d'entrepôt. Un camp place la puissance de calcul sur le sol de l'entrepôt ; l'autre envoie l'inférence dans le cloud. Les deux camps peuvent présenter un argument convaincant, et les deux ont leur lot de leçons douloureuses. La vraie question n'est pas de savoir quelle technologie est la plus avancée. C'est ce que l'inférence IA d'entrepôt exige réellement en matière de latence, de coût et de tolérance aux pannes de réseau. Si l'on sépare ces trois exigences, la réponse s'avère souvent différente de la première impression.
Le même entrepôt, deux résultats très différents
Prenons un cas réel. En 2024, un entrepôt logistique tiers dans l'est de la Chine, qui traite de l'électronique grand public, a introduit l'inspection visuelle : des caméras photographiaient les étiquettes des colis, l'IA lisait les informations de l'étiquette et les comparait aux commandes du système, et les colis non conformes étaient arrêtés sur la ligne. Au départ, le système fonctionnait dans le cloud. Une photo montait, le résultat redescendait. Un jour normal, tout fonctionnait. Puis une grande soirée de promotion a multiplié le volume de commandes plusieurs fois, et les problèmes sont arrivés ensemble. La reconnaissance d'étiquettes, qui revenait auparavant en moins d'une seconde, s'est étirée à plusieurs secondes. Les colis sur le convoyeur ne pouvaient pas attendre, alors ils étaient libérés sans contrôle, et le taux d'interception a chuté de façon notable. Pire encore, une brève panne de haut débit dans le parc industriel a mis toute la ligne d'inspection hors service pendant plus de dix minutes, obligeant l'équipe à revenir à des contrôles manuels par échantillonnage.
Le même entrepôt a ensuite déplacé l'inférence d'inspection visuelle vers des serveurs edge sur site. Les caméras envoyaient les images directement au calcul local, les résultats arrivaient sur place, et le cloud ne gardait que les mises à jour de modèles et l'agrégation des données. Les temps de réponse sont revenus dans la plage des millisecondes, et une panne de réseau n'arrêtait plus l'inspection elle-même. La leçon est simple : l'endroit où l'inférence IA d'entrepôt doit s'exécuter dépend d'abord de la latence que la tâche peut tolérer. L'inspection visuelle, la vérification de picking et les alertes d'anomalies perdent leur valeur si la réponse arrive un demi-temps trop tard. Elles appartiennent à l'edge. La prévision de la demande, la stratégie de réapprovisionnement et l'analyse mensuelle de performance, en revanche, ne perdent rien si la réponse arrive quelques minutes plus tard. Le cloud est le meilleur endroit pour elles.
Un deuxième cas vient d'une entreprise d'entreposage de vêtements. En 2023, elle a adopté l'IA dans le cloud pour les questions du service client et l'analyse des exceptions de commandes, et les résultats ont été bons. L'année suivante, l'équipe a voulu déplacer aussi l'optimisation des chemins de picking vers le cloud. Le problème était le volume d'appels. L'optimisation des chemins de picking doit lire en permanence les données de localisation, de stock et de commandes. Chaque appel est petit, mais les appels sont fréquents, et la facturation du cloud est à l'appel. En quelques mois, les frais d'appels d'inférence ont discrètement dépassé le budget initial. L'examen a trouvé le décalage : les tâches à haute fréquence dans le cloud produisent une facture qui grimpe plus vite qu'un achat unique de matériel. Le cloud n'était pas le problème. C'était l'inadéquation entre le modèle de facturation et le profil de la tâche.
Edge computing ou cloud : trois calculs distincts
La latence, le coût et la résilience aux pannes doivent être calculés séparément avant que toute comparaison ait un sens.
| Dimension | Edge computing | Inférence dans le cloud |
|---|---|---|
| Latence d'inférence | Calcul local, généralement dans la plage des millisecondes, à peine affecté par le réseau | Dépend des allers-retours réseau, des centaines de millisecondes quand c'est stable, des secondes en cas de congestion |
| Impact d'une panne | L'inférence locale continue de fonctionner ; seules les mises à jour de modèles et l'agrégation sont perdues | Les tâches dépendantes s'arrêtent entièrement jusqu'au retour du réseau |
| Investissement initial | Serveurs edge et accélérateurs requis, coût unique plus élevé | Coût matériel quasi nul, paiement à l'usage, faible barrière à l'entrée |
| Coût à long terme | Coût majoritairement fixe, mieux amorti à mesure que l'usage croît | Croît linéairement avec le volume d'appels, peut dépasser le matériel edge à haute fréquence |
| Maintenance | Besoin de quelqu'un sur place qui comprend le matériel ; mises à jour de modèles poussées point par point | Opérations gérées par le fournisseur ; une mise à jour de modèle atteint partout à la fois |
| Mise à l'échelle | Ajouter des machines prend des semaines | La capacité s'adapte à la demande, en quelques minutes |
Le coût est le calcul le plus souvent mal fait. Les gens comparent le prix d'un serveur edge à un mois de factures cloud, c'est-à-dire un coût unique à un coût mensuel. La comparaison n'a aucun sens. La bonne façon est de calculer le coût total de possession sur trois ans : à l'edge, cela signifie matériel plus électricité plus main-d'œuvre de maintenance sur site ; dans le cloud, cela signifie frais d'appels plus transfert de données plus éventuellement une ligne dédiée. Prenons un entrepôt de taille moyenne en illustration. Si l'inspection visuelle exécute des centaines de milliers d'inférences par jour, trois ans de frais d'appels cloud peuvent facilement dépasser le coût unique du matériel edge. Si elle n'en exécute que quelques milliers par jour, le matériel edge reste sous-utilisé et le cloud en paiement à l'usage est moins cher. La ligne de partage n'est pas la technologie. C'est le volume d'appels.
La résilience aux pannes est le calcul le plus souvent sous-estimé. Les réseaux d'entrepôt ne sont pas des réseaux de bureau. Le haut débit du parc, le Wi-Fi interne et les lignes des opérateurs peuvent chacun tomber en panne. La question clé est de savoir quels processus doivent continuer à fonctionner quand le réseau tombe. La vérification de picking, l'inspection des étiquettes et l'interception en sortie ne peuvent pas s'arrêter dix minutes, car les colis erronés expédiés dans cette fenêtre coûtent bien plus cher à récupérer qu'à prévenir. Les placer à l'edge, c'est assurer le chemin critique. Les rapports, la prévision et l'analyse peuvent attendre une panne de plusieurs heures sans dommage réel, donc ils peuvent rester dans le cloud.
Voici le jugement contre-intuitif : la plus grande valeur de l'edge computing n'est souvent pas la vitesse, mais la stabilité. Beaucoup d'équipes adoptent l'edge pour gagner quelques centaines de millisecondes, pourtant dans la plupart des scénarios d'entrepôt, personne ne remarque quelques centaines de millisecondes. Ce qui réveille un responsable d'entrepôt la nuit, c'est une instabilité réseau qui fait tomber tout le pipeline IA. L'edge computing est précieux d'abord parce que le travail continue quand le réseau ne fonctionne pas, et seulement ensuite parce qu'il est plus rapide. À l'inverse, la plus grande valeur du cloud n'est souvent pas le coût plus bas, mais le moindre souci. L'itération des modèles, la capacité élastique et les opérations externalisées sont invisibles sur la facture, mais elles consomment discrètement du budget sur trois ans.
Routage par scénario : edge ou cloud pour chaque charge de travail
En réunissant les trois calculs, la décision entre l'edge computing et le cloud pour l'IA d'entrepôt devient simple une fois que les tâches sont routées selon leurs caractéristiques :
- Edge : inspection visuelle, reconnaissance d'étiquettes, vérification de picking, alertes d'anomalies, surveillance de l'état des équipements. Ces tâches partagent trois traits : haute fréquence, temps réel et tolérance zéro aux temps d'arrêt dépendant du réseau.
- Cloud : prévision de la demande, stratégie de réapprovisionnement, analyse de santé des stocks, rapports mensuels de performance. Elles sont à basse fréquence, peuvent attendre, impliquent de grands volumes de données et bénéficient d'une itération rapide des modèles.
- Hybride : optimisation des chemins de picking, planification des vagues, planification de la main-d'œuvre. Elles peuvent exécuter une version légère à l'edge pendant la journée pour une réponse en temps réel, et un recalcul plus lourd dans le cloud la nuit pour l'optimisation globale.
Le déploiement hybride semble idéal, mais il comporte un piège : la dérive des versions de modèles. L'edge exécute un modèle léger poussé il y a trois mois, tandis que le cloud exécute un grand modèle mis à jour la semaine dernière, et les deux peuvent être en désaccord sur la même tâche. La solution est une gestion unifiée des versions de modèles, avec des mises à jour de modèles edge synchronisées avec le cloud et une règle claire pour savoir quel côté l'emporte en cas de conflit. Ce coût de gestion doit être budgété à l'approbation du projet, sinon les économies du déploiement hybride seront remboursées plusieurs fois en litiges ultérieurs.
Une dimension de plus est facile à négliger : la capacité de maintenance. Les serveurs edge se trouvent sur le sol de l'entrepôt, où la poussière, la température et les fluctuations de tension sont réelles. Les pannes matérielles ont besoin de quelqu'un sur place. Si l'entrepôt n'a personne qui comprend le matériel, le coût caché de maintenance d'un déploiement edge sera élevé. Le cloud externalise les opérations au fournisseur, et l'entrepôt ne gère que son réseau et ses comptes. Pour les entrepôts petits et moyens, ce point décide souvent du succès plus que n'importe quelle métrique technique.
La chaîne de décision : d'abord la tâche, ensuite l'emplacement
La question de savoir si l'inférence IA d'entrepôt va à l'edge ou dans le cloud n'a pas de réponse standard, seulement une chaîne de décision : d'abord, quelle latence et quelles pannes la tâche peut-elle tolérer ; ensuite, ce que le volume d'appels fait à la courbe de coût ; enfin, si l'équipe peut maintenir le matériel edge. Répondez à ces trois questions, et l'emplacement de déploiement en découle.
Une tendance à surveiller est que les deux côtés de la frontière continuent de bouger. Le matériel edge continue de devenir moins cher, et l'inférence dans le cloud continue aussi de devenir moins chère, donc la ligne de partage se déplace chaque année. Une tâche qui appartient au cloud aujourd'hui peut appartenir à l'edge l'année prochaine ; une tâche qui doit être à l'edge aujourd'hui peut être couverte l'année prochaine par une ligne dédiée cloud plus un cache local. Ce n'est pas une décision unique, mais une décision dynamique, à revoir chaque année. Ce dont les responsables d'entrepôt ont vraiment besoin, ce n'est pas la capacité de bien choisir une fois, mais l'habitude de recalculer les trois comptes chaque année. Les tarifs spécifiques doivent être vérifiés par rapport à la dernière politique publiée de chaque fournisseur, et tout projet doit être recalculé par rapport à son propre volume d'appels avant approbation.
Par Dr. Chen, Chercheur en chaîne d'approvisionnement Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.